Gemini 4 Argon vs GPT-6 Astra vs Opus 5.5 ベンチマーク比較
Gemini 4 Argon・GPT-6 Astra・Claude Opus 5.5 を Google の表にある全18ベンチマークで比較。出力上限、料金、用途別にどのモデルを選ぶべきかも解説します。
Gemini 4 Argon は Google 自身のベンチマーク表で首位に立っていますが、すべての項目でというわけではありません。2026年9月30日の発表とともに Google が公開した19行の表では、Argon は自身、GPT-6 Astra、Claude Opus 5.5 の中で13行で最高スコアを記録し、1行で同率、5行で負けています。内訳は Astra に3つ、Opus 5.5 に2つです[1]。負けはターミナル作業、より難しいソフトウェアベンチマーク、コンピューター操作に集中しており、まさに多くの開発者が評価の基準にする領域です。
この比較では、Google の表にあるすべての数値を並べ、各提供元が公表している仕様と価格を加え、Google の評価方法に関する注意点を説明します。発表後の検索関心も同じことを尋ねていました。"gemini 4 argon benchmarks"、"gemini 4 argon performance relative to other models"、"gemini 4 vs gpt 6 astra"、"gemini 4 vs claude" などです。どのスコアよりも上に来る実務上の違いが1つあります。Astra と Opus 5.5 は一般提供されていますが、Argon はされていません[1]。
要点まとめ
- 総合: 3モデルの中で、Google の表の19行のうち Gemini 4 Argon が13行、GPT-6 Astra が3行、Claude Opus 5.5 が2行で最高スコア、1行が同率です[1]。
- Argon が最もはっきりリードする項目: Harvey's Legal Agent Benchmark(19.6%に対し5.4%と3.8%)、長コンテキストの GraphWalks 256K–1M(84.2%に対し71.8%と66.8%)、長尺動画の LVBench(91.7%)[1]。
- Argon が劣る項目: Opus 5.5 は Terminal-bench 4.0(66.4%対57.4%)と PostTrainBench でリード。Astra は FrontierSWE v2、Terminal-Bench Science、OSWorld-2.0 でリードしています[1]。
- 出力: Argon は1回の応答で1Mトークンを返せます。Astra と Opus 5.5 は標準 API で128Kが上限です[1][2][4]。
- 1Mトークンあたりの価格: Argon は導入価格$2/$10、その後$4/$20。Opus 5.5 は$4/$20。Astra は$10/$50です[1][2][3]。
Gemini 4 Argon のベンチマーク:全表
以下は Google の発表にあるベンチマーク表の数値です。Google の表には Claude Fable 5.1 も含まれているので、「Fable と比べてどうか」という疑問にも答えられるよう独立した列で示しています。Argon、Astra、Opus 5.5 の中で最も高いスコアを太字にしています。ダッシュは Google が結果を報告していないことを示します[1]。
| 分野 | ベンチマーク | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| ナレッジワーク | Vals Index | 68.9% | 63.1% | 67.0% | 65.8% |
| ナレッジワーク | AutomationBench | 51.3% | 41.4% | 42.5% | 31.4% |
| ナレッジワーク | Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% | 58.9% |
| ナレッジワーク | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 3.8% | 6.7% |
| エージェント型コーディング | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% | 67.4% |
| エージェント型コーディング | FrontierSWE v2 | 55.0% | 65.5% | 62.3% | 56.3% |
| エージェント型コーディング | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| エージェント型コーディング | Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% | 57.9% |
| ML エンジニアリング | PostTrainBench | 45.3% | 44.3% | 49.3% | 40.2% |
| 科学・数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 63.3% | 52.6% |
| 科学・数学 | LABBench 2 | 88.8% | 85.4% | 73.1% | 68.6% |
| 科学・数学 | RiemannBench | 76.0% | 72.0% | 69.6% | 65.6% |
| 長コンテキスト | GraphWalks、128Kまで | 99.7% | 98.7% | 90.6% | 91.4% |
| 長コンテキスト | GraphWalks、256K〜1M | 84.2% | 71.8% | 66.8% | 65.0% |
| コンピューター操作 | Agent's Last Exam | 39.5% | 34.2% | 38.2% | — |
| コンピューター操作 | OSWorld-2.0(オフラインサブセット) | 69.2% | 72.6% | — | — |
| マルチモーダル | Chartography | 71.6% | 71.0% | 66.3% | 46.2% |
| マルチモーダル | LVBench | 91.7% | 87.5% | 83.7% | 79.7% |
| サイバーセキュリティ | CWE-bench v1 | 68.0% | 68.0% | 67.0% | 58.0% |
Claude Opus 5.5 だけと1対1で比べると、両方にスコアがある18行のうち Gemini 4 Argon は14行で上回り、4行で下回っています。FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science です[1]。
Google の評価方法を踏まえて表を読む
表のスコアはすべて Google の発表によるもので、Google の評価方法ページに各数値の出どころが説明されています。差をどれだけ重く見るべきかを左右する点が3つあります[5]:
- 競合モデルのスコアの大半は自己申告です。 Google によると、Gemini 以外のモデルの結果は「特に記載がない限り、各提供元の自己申告の数値に基づく」もので、報告がある場合は各競合の利用可能な最大の推論設定を使っています。
- Argon のスコアの一部は Google 自身が計測しています。 Argon の DeepSWE v1.1 と Terminal-bench 4.0 の結果は Google が実行したもので、Astra、Fable、Opus の数値は公開リーダーボードやシステムカードによるものです。これは一般的な慣行ですが、評価環境が常に同一とは限らないことを意味します。
- 入力条件が常に同じだったわけではありません。 LVBench では、Google は Gemini に毎秒1フレームを使った一方、「API の制限により」Astra には800フレーム、Opus 5.5 には600フレーム、Fable 5.1 には300フレームを使いました。各モデルが見たフレーム数は同じではないので、長尺動画の差はある程度割り引いて見てください。
これで表が間違っているということにはなりません。ただし、Vals Index や CWE-bench のような1ポイントの差は実用上は同等で、Harvey's Legal Agent Benchmark や256K〜1M の GraphWalks のような12〜17ポイントの差は本物のシグナルだということです。
仕様と価格の比較
ベンチマークは判断材料の半分にすぎません。各提供元が上限と価格について公表している内容は次のとおりです。
| Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | |
|---|---|---|---|
| 提供状況 | Fairwind Program のパートナーのみ。開発者には「できるだけ早く」[1] | 一般提供[2] | 一般提供[4] |
| コンテキストウィンドウ | 未公表 | 1,050,000トークン[2] | 1Mトークン[4] |
| 1回の応答の最大出力 | 1Mトークン[1] | 128,000トークン[2] | 128K(Batch API ベータで300K)[4] |
| 入力の種類 | テキストに加え、チャート、ドキュメント、長尺動画(Google による)[1] | テキスト、画像[2] | テキスト、画像[4] |
| 1Mトークンあたりの入力 / 出力 | 導入価格$2 / $10、その後$4 / $20[1] | $10 / $50、入力272K超はさらに高額[2] | $4 / $20[3] |
| 1Mトークンあたりのキャッシュ入力 | 導入期間中は$0.10[1] | $1[2] | キャッシュヒット$0.20[3] |
トークンあたりの価格とタスクあたりの価格は別物です。Gemini 4 Argon の料金解説 では、3モデルすべてで4つのタスク形態を計算しています。
Gemini 4 Argon vs GPT-6 Astra
Astra に対して、Argon はナレッジワークと長コンテキストの行の大半で勝ち、法務・金融のエージェントテストでは大差をつけています。Harvey's のベンチマークで19.6%対5.4%、Vals Finance Agent v2 で65.4%対53.5%です[1]。価格も、導入期間中は Astra の定価の5分の1、その後は5分の2です[1][2]。
コンピューター操作やより難しいソフトウェアベンチマークでは Astra のほうが有力です。OSWorld-2.0(72.6%対69.2%)、FrontierSWE v2(65.5%対55.0%)、Terminal-Bench Science(68.1%対57.6%)でリードしています[1]。FrontierSWE v2 と Terminal-Bench Science の10.5ポイントの差は、Argon が自身の発表表で喫した最大の負けなので、業務がこれらのベンチマークに近いチームは切り替える前にテストすべきです。Astra は Terminal-bench 4.0 でも58.2%対57.4%でわずかに Argon を上回っています。
Gemini 4 Argon vs Claude Opus 5.5
コーディングでは最も接戦の組み合わせです。Argon は DeepSWE v1.1(77.9%対74.2%)と Vibe Code Bench(91.9%対90.3%)で Opus 5.5 をわずかに上回り、Opus 5.5 は Terminal-bench 4.0 で9ポイント差(66.4%対57.4%)、PostTrainBench で4ポイント差(49.3%対45.3%)で勝っています[1]。エージェントがシェル上で動くなら、Opus 5.5 は新しいモデルに対しても十分に持ちこたえます。
コーディング以外では Argon が引き離します。法務ベンチマークの差は15.8ポイント、256K〜1M の長コンテキスト GraphWalks は17.4ポイント、LABBench 2 は15.7ポイントです[1]。Argon の導入期間が終われば、両モデルの定価は100万トークンあたり同じ$4と$20になる[1][3]ので、選択は価格ではなく作業内容で決まります。
用途別にどのモデルを使うか
- 法務・金融リサーチ、長いドキュメント群、長尺動画: 使えるようになれば Gemini 4 Argon。最も差が大きい領域です。
- 1回で非常に長い出力が必要な作業(全体の移行や128Kトークンを超えるレポートなど): 1回の応答でこれをこなせるのは3モデルのうち Gemini 4 Argon だけです。
- ターミナル中心のコーディングエージェント: Terminal-bench 4.0 ではっきりリードしている Claude Opus 5.5。
- コンピューター操作と最も難しい SWE タスク: OSWorld-2.0 と FrontierSWE v2 でリードしている GPT-6 Astra。
- 今月中にリリースする必要があるもの: Astra か Opus 5.5。Gemini 4 Argon にはまだ公開 API がないからです[1]。
reAPI では、Claude Opus 5.5 と GPT-6 Astra の両方が1つの API キーと1つの chat completions エンドポイントで利用できます。今日から両方で同じ評価を実行し、Gemini 4 Argon が来たら追加できます。Gemini 4 Argon のモデルページ で提供状況を追っています。
よくある質問
Gemini 4 Argon は GPT-6 Astra より優れていますか?
Google の表の大半ではそうです。Astra に対して、Argon は19行中14行で高いスコアを記録し、1行が同率です。Astra は FrontierSWE v2、Terminal-Bench Science、OSWorld-2.0、そしてわずかな差で Terminal-bench 4.0 でリードしています[1]。
Gemini 4 Argon は Claude Opus 5.5 より優れていますか?
Google の表で比較可能な18行のうち14行では上回っています。Opus 5.5 は Terminal-bench 4.0、PostTrainBench、FrontierSWE v2、Terminal-Bench Science でリードしています[1]。
Gemini 4 Argon は Claude Fable 5.1 と比べてどうですか?
Google が両方を報告している17行のうち15行で、Argon が Fable 5.1 を上回っています。Fable 5.1 は FrontierSWE v2(56.3%対55.0%)と Terminal-bench 4.0(57.9%対57.4%)でわずかにリードしています[1]。
Gemini 4 Argon の最も良いベンチマーク結果は?
128Kまでの GraphWalks で99.7%です。より意味のある勝ちは大差のついた項目で、Harvey's Legal Agent Benchmark の19.6%(Astra は5.4%、Opus 5.5 は3.8%)と、256K〜1M の GraphWalks の84.2%です[1]。
これらのベンチマークスコアは独立したものですか?
完全にではありません。スコアは Google の発表によるもので、Google によると競合のスコアの大半は各提供元の自己申告であり、Argon のテストの一部は Google 自身が実行しています[5]。
Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5 で最も安いのは?
導入価格$2/$10の Gemini 4 Argon です。その後は Argon と Opus 5.5 がともに$4/$20、Astra が1Mトークンあたり$10/$50です[1][2][3]。
Argon、Astra、Opus 5.5 の選び方
Google の表は、Gemini 4 Argon が3モデルの中で最も優れた汎用モデルであることを強く示しています。最大のリードは法務、金融、長コンテキスト、長尺動画にあり、1Mトークンの出力は他のどのモデルも及びません。同時に、その主張が最も弱い部分も示しています。ターミナルとコンピューター操作のエージェントでは、Opus 5.5 と Astra がまだ勝っています。
これを最終的な結論にしない注意点が2つあります。スコアは、その大半で勝っているモデルのベンダー自身が出したものであり、Argon は比較の中で唯一まだ呼び出せないモデルです。今は Astra と Opus 5.5 で評価を組み立て、Gemini 4 Argon が開発者に開放されたら再実行してください。
参考文献
- Google. Gemini 4 Argon: our next era of frontier intelligence (including benchmark table). 2026年10月取得:blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- OpenAI. GPT-6 Astra model page. 2026年10月取得:developers.openai.com/api/docs/models/gpt-6-astra
- Anthropic. Pricing. 2026年10月取得:platform.claude.com/docs/en/about-claude/pricing
- Anthropic. Models overview. 2026年10月取得:platform.claude.com/docs/en/about-claude/models/overview
- Google DeepMind. Gemini 4 Argon model evaluation: approach, methodology and results. 2026年10月取得:deepmind.google/models/evals-methodology/gemini-4-argon
著者

カテゴリ
他の記事
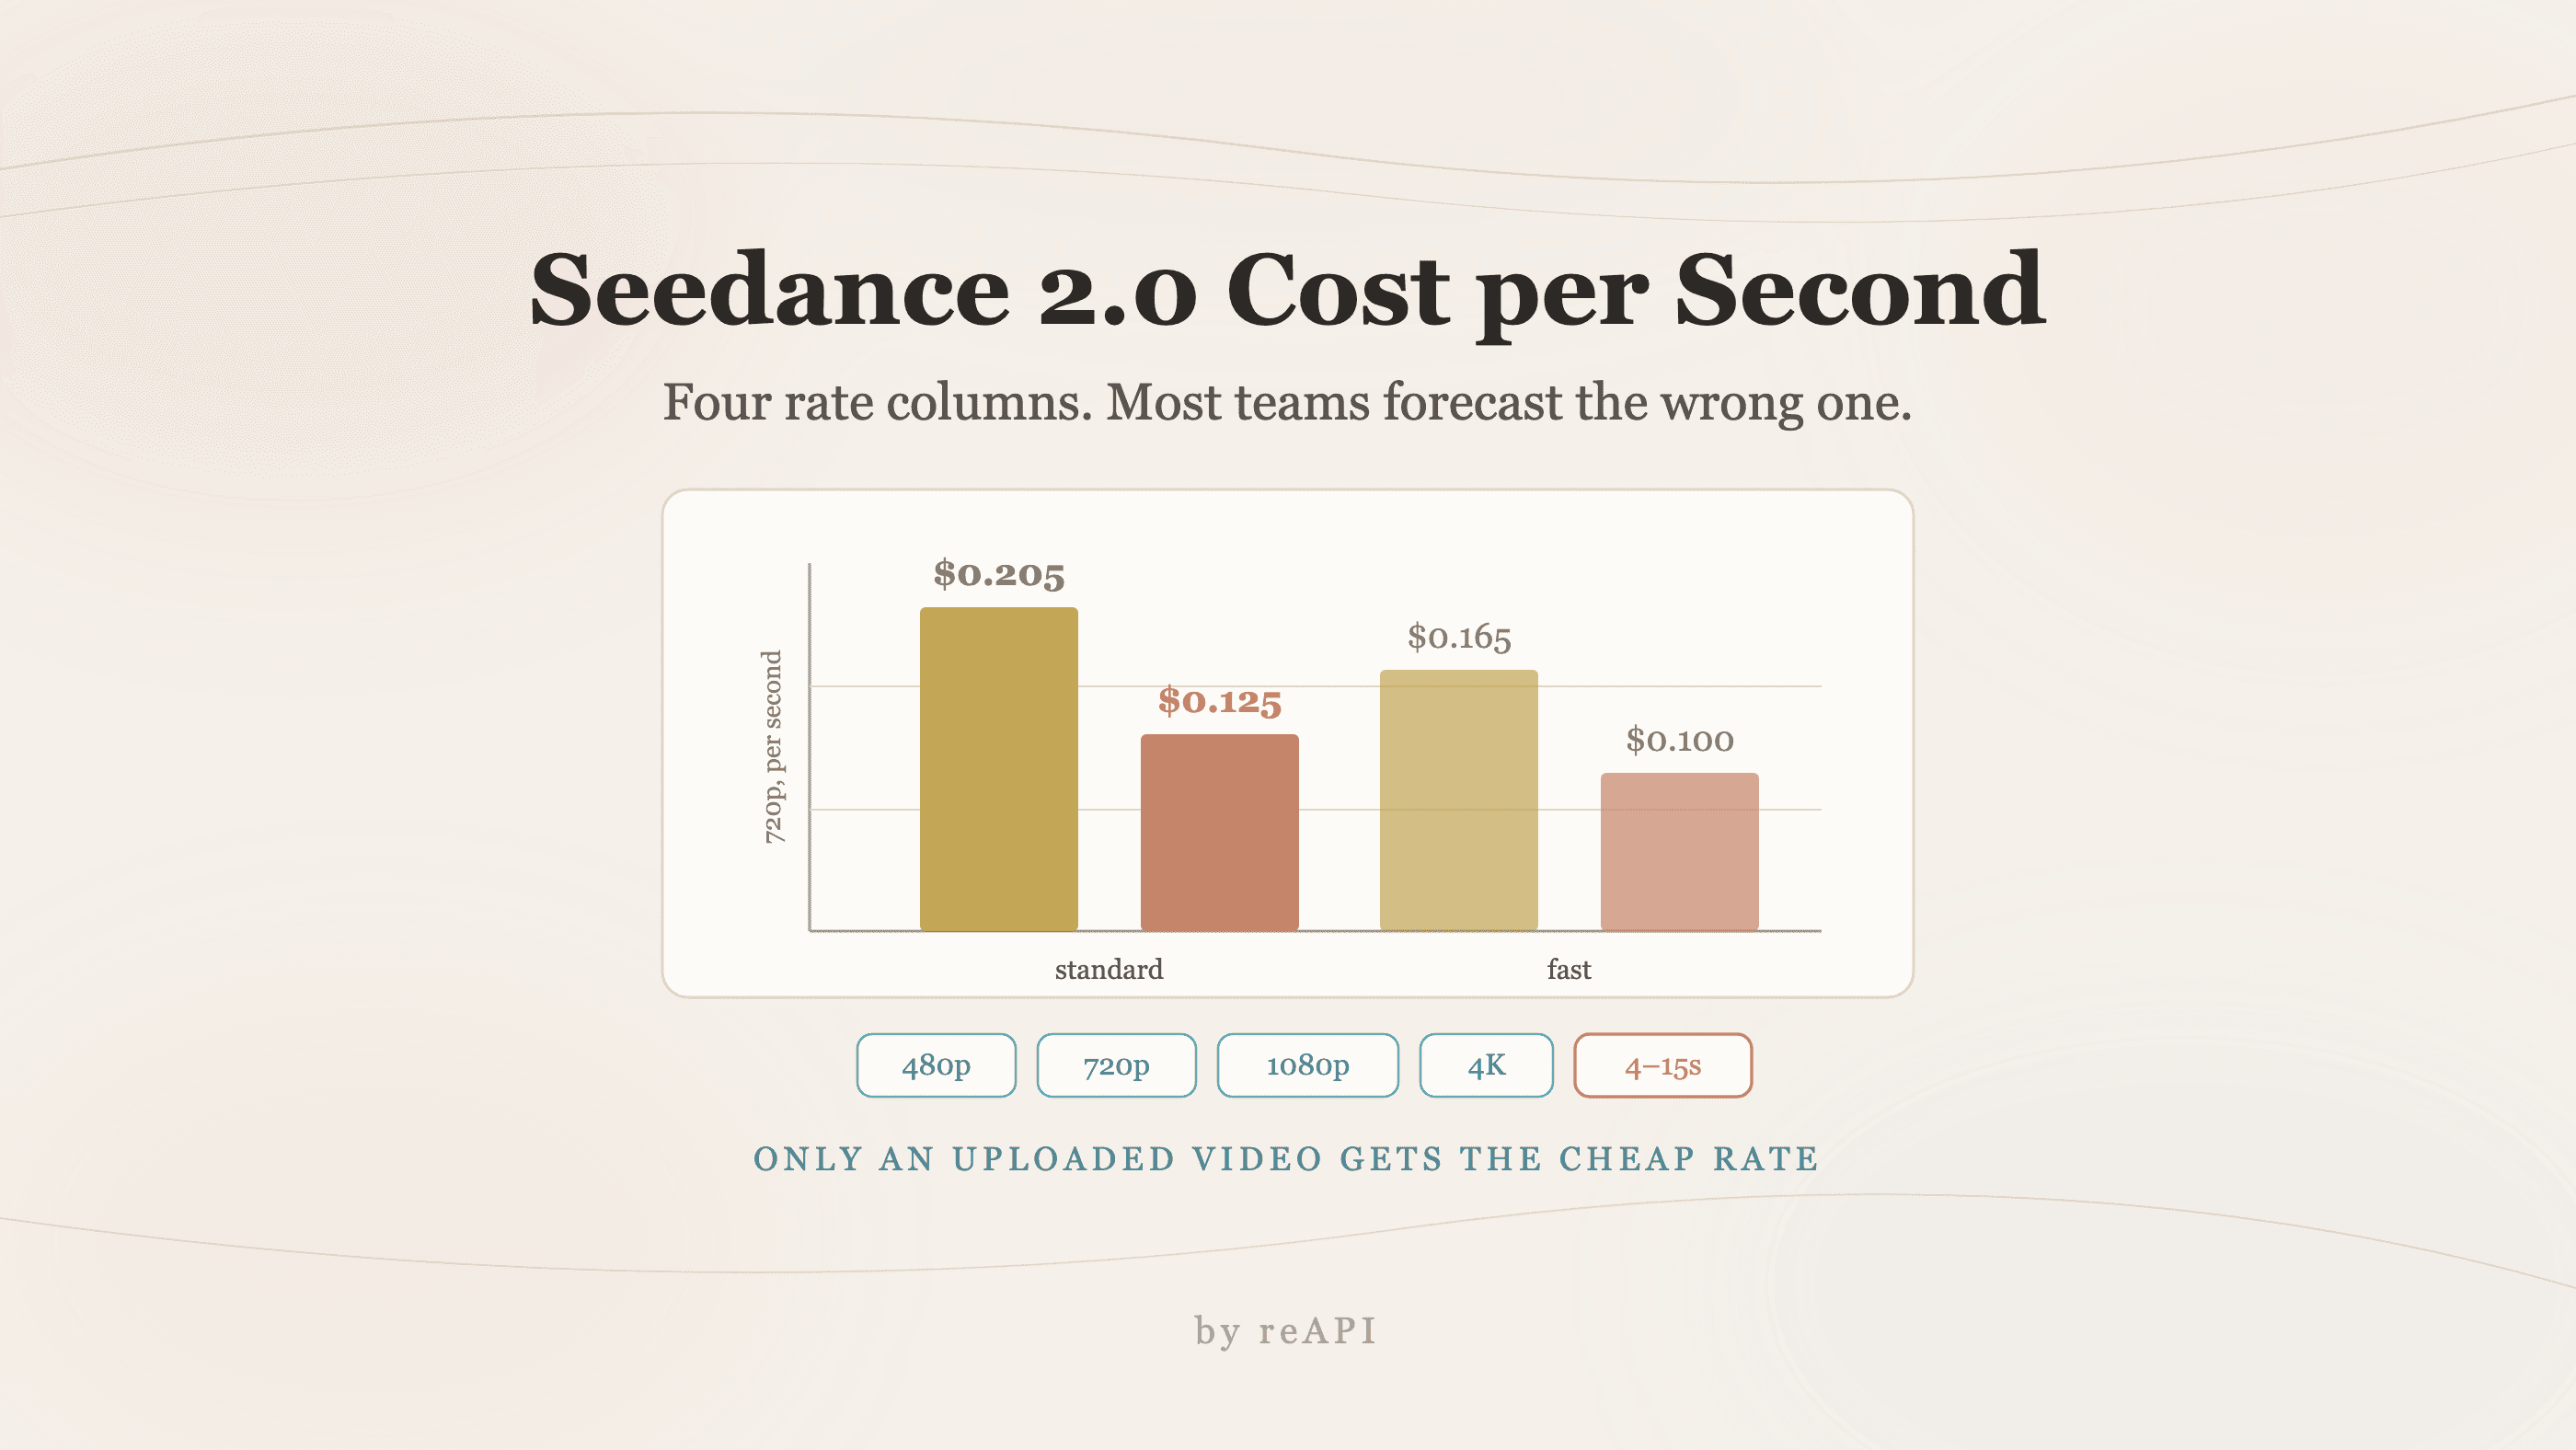
Seedance 2.0の1秒あたり料金:実際の課金方式
Seedance 2.0の解像度・価格帯別の秒単価、動画アップロード時だけ使える割引料金、予算予測で起きやすい間違いを解説します。
GPT Image 2.5 モデル見つからないエラーの修正
GPT Image 2.5「モデルが見つかりません」エラーを修正。モデル ID、Image API、Codex、アカウント確認の方法を解説します。
Compilatio 代替ツール5選を比較【2026年版】
Compilatio の代替ツールを2026年に検討中ですか。Turnitin、Copyleaks、GPTZero、Originality.ai、reAPI が検出対象・API の提供有無・対応言語でどう違うのかを比較します。