Tarifs de GPT-6 Sol : prix de l'API, coût par token et tarifs de cache
Tarifs de GPT-6 Sol par million de tokens : input, output, lectures et écritures de cache, la règle de contexte long à 272K, Batch, Flex et Fast mode, avec des exemples de coût chiffrés.
Les tarifs de GPT-6 Sol dans l'API d'OpenAI commencent à $2 par million de tokens d'input et $10 par million de tokens d'output, pour des prompts jusqu'à 272K tokens d'input[1]. Ces deux chiffres ne sont qu'une partie de la facture. OpenAI facture aussi séparément l'input en cache et les écritures de cache, double le tarif d'input lorsqu'un prompt dépasse 272K tokens, et propose Batch, Flex et Fast mode avec des multiplicateurs différents[2].
Cet article recense tous les tarifs qu'OpenAI publie pour GPT-6 Sol au 7 octobre 2026, détaille quatre exemples de coût avec leurs hypothèses explicites, et répond à la question que nous voyons souvent recherchée avec le sujet : le prix actuel est-il promotionnel ?
TL;DR
- Tarifs standard : $2 d'input, $0.20 d'input en cache, $2.50 d'écriture de cache et $10 d'output par million de tokens, pour des prompts jusqu'à 272K tokens d'input[1].
- Prompts longs : au-delà de 272K tokens d'input, toute la requête passe à $4 d'input, $0.40 en cache, $5 d'écriture de cache et $15 d'output[1][2].
- Les tokens de raisonnement sont facturés comme de l'output. Le niveau d'effort choisi modifie le volume d'output, et donc le coût[3].
- Niveaux de traitement : Batch et Flex coûtent 50% du Standard, Fast mode coûte 2x, et le traitement régional ajoute 10%[2].
- Aucune promotion trouvée : le prix promotionnel affiché sur les pages d'OpenAI concerne GPT-5.6 Sol, pas GPT-6 Sol[1][4].
- Sur reAPI : facturation au token sur les mêmes quatre dimensions, avec les tarifs indiqués sur la page du modèle GPT-6 Sol.
Tarifs de GPT-6 Sol par million de tokens
La page de tarifs d'OpenAI répartit chaque tarif entre une colonne contexte court (jusqu'à 272K tokens d'input) et une colonne contexte long (au-delà de 272K)[1] :
| GPT-6 Sol, Standard, par 1M tokens | Jusqu'à 272K d'input | Au-delà de 272K d'input |
|---|---|---|
| Input | $2.00 | $4.00 |
| Input en cache | $0.20 | $0.40 |
| Écritures de cache | $2.50 | $5.00 |
| Output | $10.00 | $15.00 |
La page du modèle explique les ratios. L'input en cache coûte 10% du tarif d'input hors cache, les écritures de cache 1.25 fois ce tarif, et les prompts au-delà de 272K sont « facturés à 2x les tarifs d'input et de cache et à 1.5x l'output pour l'ensemble de la requête »[2]. Les mots importants sont « pour l'ensemble de la requête ». Franchir le seuil refacture chaque token de la requête, pas seulement ceux au-delà de 272K.
Deux limites encadrent ce que peut coûter une seule requête. GPT-6 Sol accepte jusqu'à 922,000 tokens d'input et renvoie jusqu'à 128,000 tokens d'output, dans une fenêtre de contexte de 1,050,000 tokens[2].
Ce qui fait varier une facture GPT-6 Sol
Tokens de raisonnement. GPT-6 Sol est un modèle de raisonnement. Le guide de raisonnement d'OpenAI précise que les tokens de raisonnement ne sont pas visibles via l'API mais « sont facturés comme des tokens d'output »[3]. Le réglage d'effort va de none à max, avec medium par défaut[2] : une requête qui ne définit pas l'effort paie donc quand même une passe de raisonnement au tarif d'output de $10.
Cache. Pour GPT-5.6 et les modèles ultérieurs, OpenAI facture une écriture de cache à 1.25x le tarif d'input et une lecture de cache à 0.1x. Un préfixe en cache reste disponible au moins 30 minutes après sa dernière écriture ou réutilisation, et le préfixe minimal mis en cache est de 1,024 tokens d'input[5]. Les écritures de cache remplacent le tarif d'input normal pour ces tokens au lieu de s'y ajouter[5]. En pratique, écrire un préfixe une fois et le réutiliser une fois coûte 1.35x son prix hors cache, contre 2x sans cache[5].
Niveau de traitement. Les mêmes tokens coûtent des montants différents selon la façon dont vous les envoyez[1] :
| GPT-6 Sol, par 1M tokens, jusqu'à 272K | Input | Input en cache | Écritures de cache | Output |
|---|---|---|---|---|
| Standard | $2.00 | $0.20 | $2.50 | $10.00 |
| Batch | $1.00 | $0.10 | $1.25 | $5.00 |
| Flex | $1.00 | $0.10 | $1.25 | $5.00 |
| Fast mode | $4.00 | $0.40 | $5.00 | $20.00 |
Flex applique les tarifs Batch en échange de réponses plus lentes et d'indisponibilités ponctuelles des ressources, et OpenAI le présente comme une bêta[6]. Le traitement régional (résidence des données) ajoute 10% là où il est disponible, et Fast mode n'est pas disponible avec la résidence des données dans l'UE pour GPT-6 Sol[2][7].
Exemples de coût de GPT-6 Sol
Les quatre exemples utilisent les prix catalogue d'OpenAI ci-dessus. Ce sont des illustrations aux hypothèses explicites, pas des mesures de trafic réel. Le nombre de tokens de vos prompts sera différent, et les volumes d'output incluent les tokens de raisonnement.
Exemple A : une requête de chat. 2,000 tokens d'input et 800 tokens d'output, Standard, sans cache. 2,000 × $2 / 1M = $0.004 pour l'input et 800 × $10 / 1M = $0.008 pour l'output, soit $0.012 par requête, ou $12 pour 1,000 requêtes.
Exemple B : un préfixe partagé avec cache. 40 requêtes réutilisent le même bloc de 50,000 tokens d'instructions et de documents de référence, chacune ajoute 2,000 nouveaux tokens d'input et reçoit 1,000 tokens d'output. On suppose un breakpoint de cache explicite après le bloc partagé et les 40 requêtes dans la durée de vie du cache. Le nouvel input après le breakpoint est facturé au tarif d'input normal, sans frais d'écriture[5].
| Poste | Calcul | Coût |
|---|---|---|
| Première écriture de cache | 50,000 × $2.50 / 1M | $0.125 |
| 39 lectures de cache | 39 × 50,000 × $0.20 / 1M | $0.390 |
| Nouvel input | 40 × 2,000 × $2 / 1M | $0.160 |
| Output | 40 × 1,000 × $10 / 1M | $0.400 |
| Total avec cache | $1.075 | |
| Total sans cache | 40 × 52,000 × $2 / 1M + $0.40 | $4.56 |
Dans ce scénario, le cache réduit la facture d'environ trois quarts, car l'essentiel de chaque prompt est le bloc répété.
Exemple C : franchir les 272K. Une requête de 300,000 tokens d'input et 5,000 tokens d'output passe aux tarifs de contexte long : 300,000 × $4 / 1M = $1.20, plus 5,000 × $15 / 1M = $0.075, soit $1.275. Ramenez la même requête à 270,000 tokens d'input et elle coûte 270,000 × $2 / 1M = $0.54 plus 5,000 × $10 / 1M = $0.05, soit $0.59. Retirer 10% de l'input divise le coût par plus de deux : vérifiez donc la longueur du prompt avant d'envoyer des dépôts ou des ensembles de documents entiers.
Exemple D : le même travail sur chaque niveau. L'exemple A exécuté 10,000 fois coûte $120 en Standard, $60 en Batch ou Flex et $240 en Fast mode (2,000 × $4 / 1M + 800 × $20 / 1M = $0.024 par requête).
Pour estimer votre propre charge, multipliez chaque type de token par son tarif : input hors cache × tarif d'input, lectures de cache × tarif en cache, écritures de cache × tarif d'écriture et output (raisonnement compris) × tarif d'output. Utilisez la colonne contexte long dès qu'une requête dépasse à elle seule 272K tokens d'input.
GPT-6 Sol bénéficie-t-il d'un prix promotionnel ?
Nous n'avons trouvé aucun indice en ce sens. La page de tarifs d'OpenAI contient une seule mention promotionnelle : « Le prix promotionnel de GPT-5.6 Sol est disponible au moins jusqu'au 21 novembre 2026 »[1]. La page du modèle GPT-6 Sol, l'entrée du changelog du 22 septembre qui a annoncé GPT-6 Sol à $2 d'input et $10 d'output, et l'article de lancement ne contiennent ni mention promotionnelle ni date de fin pour GPT-6 Sol[2][4][8]. L'article de lancement n'emploie « promotional » que pour décrire le point de comparaison de GPT-6 Sol : les prix de Sol et Luna ont baissé « de 50% par rapport à leur prix promotionnel GPT‑5.6 »[8].
Si OpenAI limite un jour le prix de GPT-6 Sol dans le temps, cela apparaîtrait très probablement sur la même page de tarifs et dans le même changelog cités ici.
Comparaison des tarifs de GPT-6 Sol avec les autres modèles OpenAI
Tarifs Standard en contexte court par million de tokens, d'après la page de tarifs d'OpenAI[1] :
| Modèle | Input | Input en cache | Écritures de cache | Output |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-5.6 Sol | $4.00 | $0.40 | $5.00 | $20.00 |
GPT-6.1 Sol, sorti le 29 septembre 2026, a les mêmes tarifs d'input, d'output et d'écriture de cache que GPT-6 Sol, mais un tarif d'input en cache deux fois plus bas : 5% de l'input au lieu de 10%[4][5]. Dans les boucles d'agents très consommatrices de cache, cet écart s'accumule, même si GPT-6.1 Sol supprime aussi l'effort none et l'appel d'outils dans Chat Completions[9]. Notre comparatif GPT-6 Sol vs 5.6 Sol couvre l'aspect migration.
Tarifs de GPT-6 Sol sur reAPI
reAPI sert GPT-6 Sol via son endpoint Chat Completions avec l'ID de modèle gpt-6-sol, facturé au token sur votre solde de crédits reAPI. Les dimensions de facturation suivent celles d'OpenAI : input, output, lecture de cache et écriture de cache ont chacun leur propre tarif, les tokens de raisonnement sont facturés comme de l'output, et les prompts au-delà de 272K tokens d'input refacturent toute la requête aux tarifs de contexte long[10]. La documentation de reAPI indique que chaque tarif est inférieur au tarif par token publié par OpenAI[10]. Les chiffres actuels, ainsi qu'un estimateur de coût, figurent sur la page du modèle GPT-6 Sol.
FAQ
GPT-6 Sol : combien de temps dure le prix promotionnel ?
Nous n'avons trouvé aucune période promotionnelle pour GPT-6 Sol sur la page de tarifs d'OpenAI, la page du modèle, le changelog ou l'article de lancement[1][2][4][8]. La promotion documentée par OpenAI concerne GPT-5.6 Sol, à $4 d'input et $20 d'output, disponible au moins jusqu'au 21 novembre 2026[1].
Combien coûte chat gpt 6 ?
Dans l'API, GPT-6 Sol coûte $2 par million de tokens d'input et $10 par million de tokens d'output en traitement Standard. GPT-6 Astra coûte $10 et $50, et GPT-6 Luna $0.10 et $0.50[1]. Dans ChatGPT, GPT-6 Sol est disponible dans ChatGPT Work et Codex sur les offres Plus, Pro, Business, Enterprise et Edu[8] ; le prix des offres sort du cadre de cet article.
Tarif fast de GPT-6 Sol
Fast mode pour GPT-6 Sol coûte 2x le Standard : $4 d'input, $0.40 d'input en cache, $5 d'écriture de cache et $20 d'output par million de tokens jusqu'à 272K, et $8, $0.80, $10 et $30 au-delà[1][2].
Coût par token de GPT-6 Sol
Au token, GPT-6 Sol coûte $0.000002 par token d'input et $0.00001 par token d'output aux tarifs Standard en contexte court, soit $2 et $10 par million[1]. Les tokens d'input en cache coûtent un dixième du tarif d'input[2].
Calculateur de prix GPT-6 Sol
Multipliez chaque type de token par son tarif et additionnez : input × $2, input en cache × $0.20, écritures de cache × $2.50 et output × $10, le tout par million de tokens. Passez à $4, $0.40, $5 et $15 lorsqu'une requête dépasse 272K tokens d'input[1]. La page du modèle GPT-6 Sol propose un estimateur aux tarifs reAPI.
Prix GPT 5.6 Sol vs 6 Sol
GPT-6 Sol coûte moitié moins que GPT-5.6 Sol sur chaque ligne : $2 contre $4 pour l'input, $10 contre $20 pour l'output, $0.20 contre $0.40 pour l'input en cache et $2.50 contre $5 pour les écritures de cache[1]. Les $4 et $20 de GPT-5.6 Sol sont un prix promotionnel valable au moins jusqu'au 21 novembre 2026[1].
Combien coûte une API GPT ?
Cela dépend du modèle. Sur la page de tarifs actuelle d'OpenAI, les tarifs Standard d'input par million de tokens vont de $0.10 pour GPT-6 Luna à $10 pour GPT-6 Astra parmi les modèles GPT-6, l'output étant plus cher que l'input pour chacun d'eux[1].
Budgéter GPT-6 Sol
Pour la plupart des charges de travail, le premier levier est le volume d'output, car l'output coûte cinq fois plus que l'input et inclut le raisonnement. Choisissez l'effort le plus bas qui passe vos contrôles de qualité. Le deuxième levier consiste à mettre en cache tout bloc d'instructions ou de documents que vous envoyez de façon répétée ; dans l'exemple B, cela a réduit le coût d'environ trois quarts. Le troisième est de rester sous 272K tokens d'input par requête. Si les résultats peuvent attendre, Batch divise la facture par deux. Le prix catalogue de GPT-6 Sol chez OpenAI est de $2 d'input et $10 d'output par million de tokens, sans date de fin promotionnelle publiée, et les tarifs actuels par token de reAPI figurent sur la page du modèle GPT-6 Sol.
References
- OpenAI. API pricing. Consulté en octobre 2026 sur developers.openai.com/api/docs/pricing
- OpenAI. GPT-6 Sol model page. Consulté en octobre 2026 sur developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI. Reasoning models. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/reasoning
- OpenAI. API changelog. Consulté en octobre 2026 sur developers.openai.com/api/docs/changelog
- OpenAI. Prompt caching. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/prompt-caching
- OpenAI. Flex processing. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/flex-processing
- OpenAI. Fast mode. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/fast-mode
- OpenAI. Introducing GPT-6 Sol and Luna. Consulté en octobre 2026 sur openai.com/index/introducing-gpt-6-sol-and-luna
- OpenAI. GPT-6.1 Sol model page. Consulté en octobre 2026 sur developers.openai.com/api/docs/models/gpt-6.1-sol
- reAPI. GPT-6 Sol API docs. Consulté en octobre 2026 sur reapi.ai/docs/gpt-6-sol
Auteur

Catégories
Plus d'articles
API GLM-5.2 : contexte d'un million, tarifs et codage
Utilisez l'API GLM-5.2 avec du code compatible OpenAI. Apprenez son contexte d'un million, ses tarifs officiels 1,40 $/4,40 $ et ses limites.
Prix de Pollo AI : abonnements, crédits gratuits et une alternative API moins chère
Les prix de Pollo AI expliqués : abonnements, crédits gratuits et quotidiens, la recharge minimale de $80 de l'API Pollo, Pollo AI est-il fiable, et où reAPI coûte moins cher.
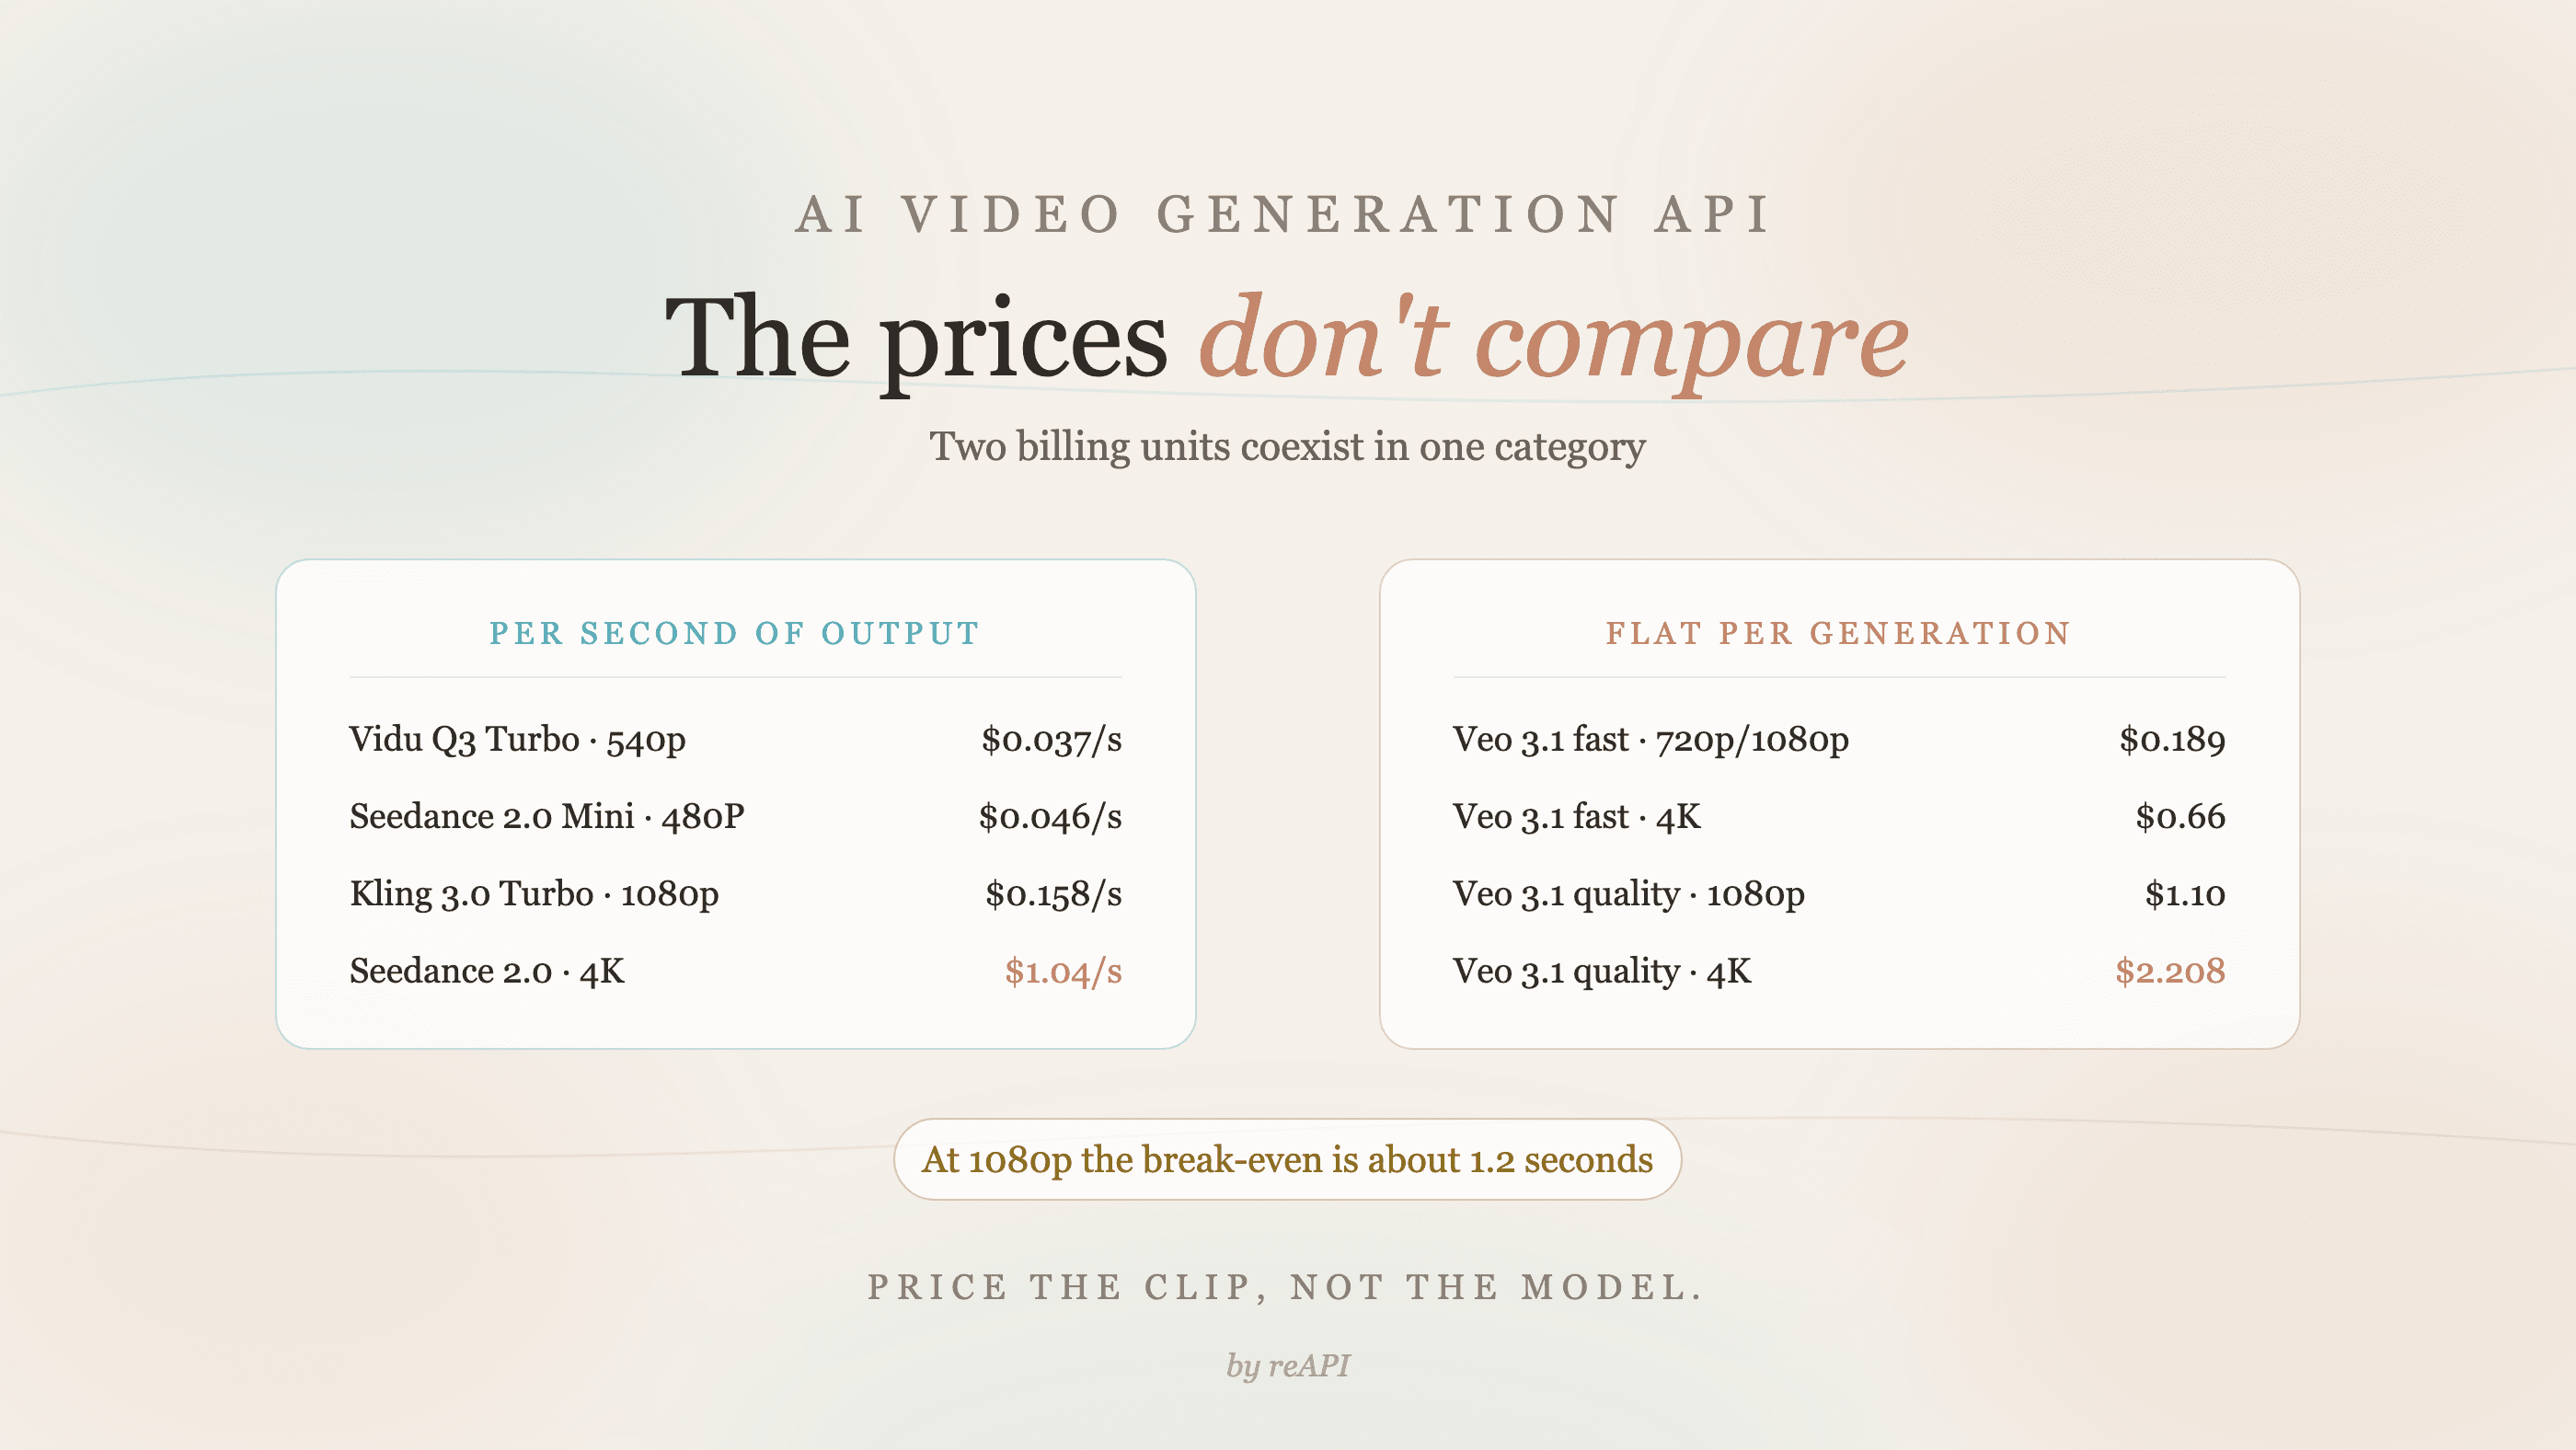
Génération vidéo IA : deux unités de facturation incomparables
Deux unités de facturation coexistent dans les API vidéo IA : à la seconde et forfaitaire. Où se situe le point d'équilibre et comment tarifer un clip réel.