Claude Opus 5 vs GPT-5.6 Sol: Welcher ist besser? (2026)
Claude Opus 5 vs GPT-5.6 Sol zum Programmieren: offizielle Benchmarks, API-Preise, Reasoning-Kontrolle und welches Modell zu deinem Workflow passt.
Claude Opus 5 ist die bessere Standardwahl für langfristige Software-Arbeit, während GPT-5.6 Sol bessere Ergebnisse bei einem wichtigen agentengesteuerten Code-Benchmark liefert und einen ehrgeizigeren Orchestrierungs-Stack hat. Das ist die praktische Antwort auf Claude Opus 5 vs GPT-5.6 Sol. Sie ist auch weniger eindeutig als die Launch Pages beider Anbieter.
Anthropics eigener Vergleich zeigt Opus 5 vorne bei Frontier-Bench, Computer-Einsatz, Knowledge Work und Business Automation. Dieselbe Tabelle zeigt GPT-5.6 Sol vorne bei DeepSWE v1.1. Die Preise unterscheiden sich je nach Aufrufort: Zu offiziellen Listenpreisen ist Sol durch eine OpenAI-Promotion aktuell günstiger auf beiden Seiten; auf reAPI ist Opus 5 in beiden Dimensionen 25% günstiger.[1][2]
TL;DR
- Wähle Claude Opus 5 für langfristige Codierung, Code-Review, Computer-Einsatz, und Workflows, die von sorgfältiger Selbstverifikation profitieren.
- Wähle GPT-5.6 Sol wenn DeepSWE-ähnliche Repository-Arbeit, OpenAIs Responses API Tools oder native Multi-Agent-Orchestrierung am wichtigsten sind.
- Das Benchmark-Ergebnis ist gespalten. Opus 5 führt Frontier-Bench 43,3% zu 34,4%; Sol führt DeepSWE v1.1 72,7% zu 68,8%.[1]
- Offizielle Preise: Opus 5 kostet $5 Input / $25 Output; Sol kostet $4 / $20 pro Million Token (OpenAI-Promotion bis mindestens 21. November 2026).[2][3]
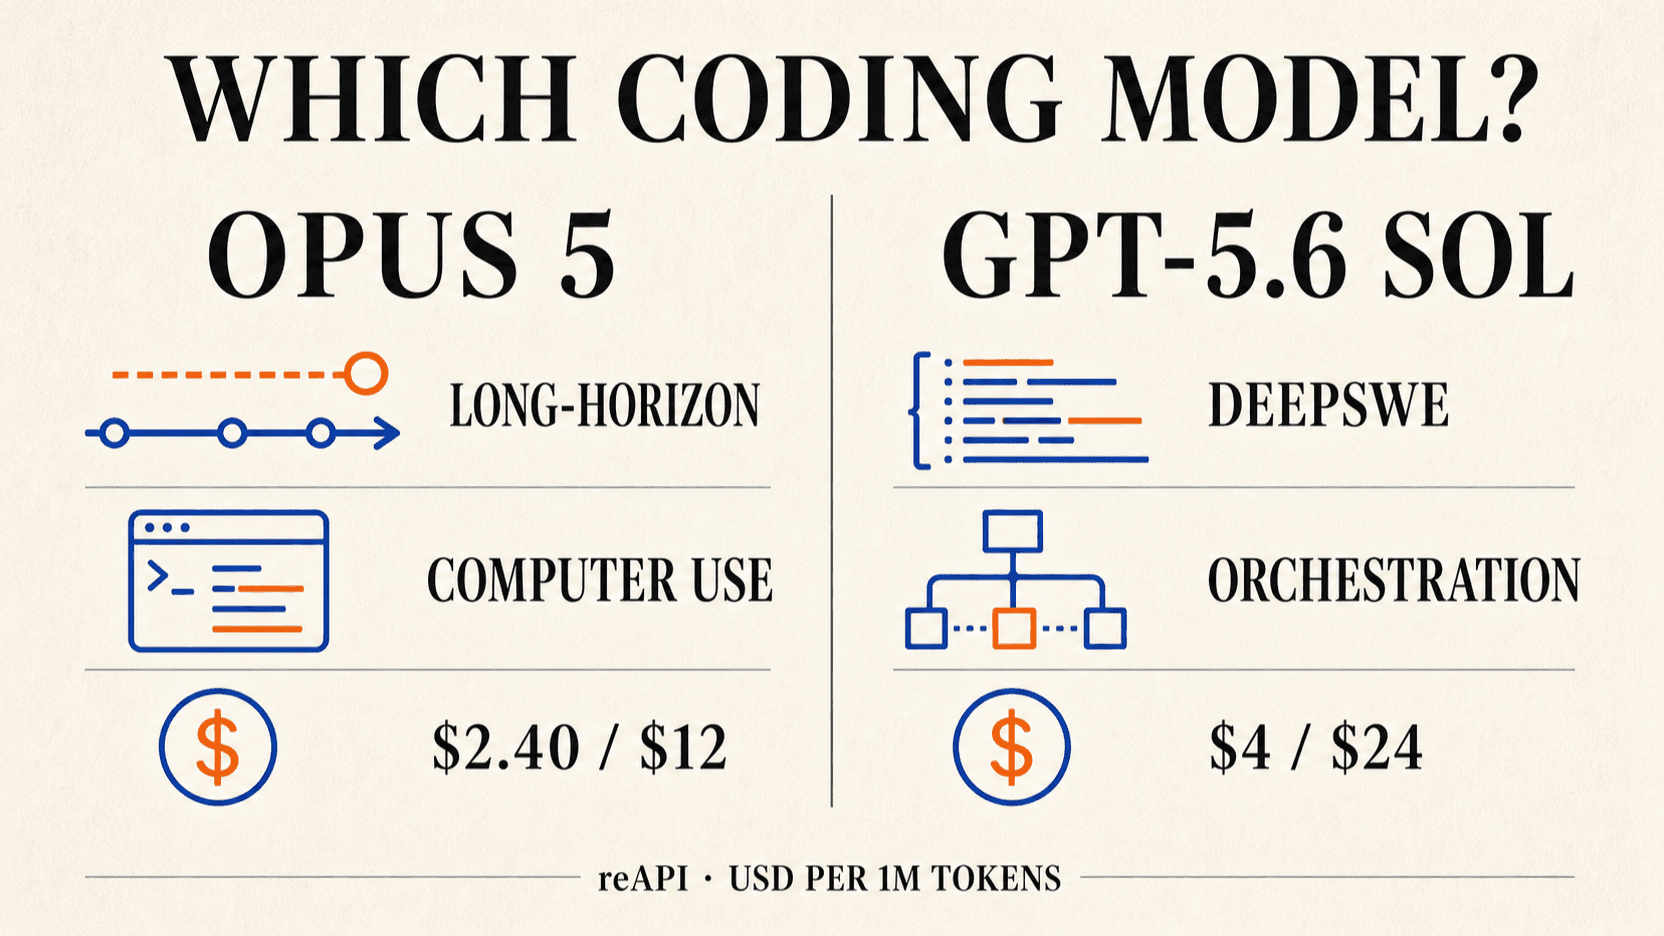
- Aktuelle reAPI-Preise: Opus 5 kostet $2,40 / $12; Sol kostet $3,20 / $16 pro Million Token (überprüft 22. Oktober 2026).
- Wähle nicht nach einem Score. Führe dieselben Repository-Aufgaben auf demselben Effort-Level aus und vergleiche akzeptierte-Ergebnis-Kosten, nicht nur Token-Rate.
Claude Opus 5 vs GPT-5.6 Sol auf einen Blick
| Kategorie | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|
| Beste Nutzung | Langfristige Codierung, Review, Enterprise-Workflows | Frontier-Codierung, Tool-schwere Agenten, Orchestrierung |
| Context Window | 1M Token | 1,05M Token |
| Max Output | 128K Token | 128K Token |
| Reasoning-Kontrolle | low bis max; Standard high | none bis max; Pro Mode und Multi-Agent in Responses |
| Thinking Standard | Adaptives Thinking an | Mittleres Reasoning wenn weggelassen |
| Offizieller Input/Output | $5 / $25 pro MTok | $4 / $20 pro MTok (Promotion) |
| reAPI Input/Output | $2,40 / $12 pro MTok | $3,20 / $16 pro MTok |
| Klarer Benchmark-Sieg | Frontier-Bench, OSWorld, AutomationBench | DeepSWE v1.1 |
Beide akzeptieren Text- und Bild-Input und stellen Tool-Aufrufe bereit. Beide haben auch ein Million-Token-Klasse Context Window, sodass Context-Größe nicht allein hilfreich als Tie-Breaker ist.[3][4]
Was die offiziellen Code-Benchmarks wirklich zeigen
Anthropic veröffentlichte eine direkte Tabelle, die beide Modelle enthält. Sie ist vom Anbieter durchgeführt, und mehrere Zeilen verwenden unterschiedliche Harnesses oder Fallback-Verhalten, sodass die Zahlen Beweise sind – nicht ein neutraler Schlusspunkt.[1]
| Auswertung | Opus 5 | GPT-5.6 Sol | Führung |
|---|---|---|---|
| Frontier-Bench v0.1 | 43,3% | 34,4% | Opus 5 |
| GDPval-AA v2 | 1861 Elo | 1736 Elo | Opus 5 |
| ARC-AGI-3 | 30,2% | 7,8% | Opus 5 |
| BrowseComp | 90,8% | 90,4% | Fast gleich |
| OSWorld 2.0 | 70,6% | 62,6% | Opus 5 |
| DeepSWE v1.1 | 68,8% | 72,7% | GPT-5.6 Sol |
| AutomationBench | 26,0% | 18,1% | Opus 5 |
| HealthBench Professional | 59,8% | 60,5% | GPT-5.6 Sol |
Die Aufspaltung ist nützlich. Frontier-Bench misst lange, offene Engineering-Aufgaben; Opus 5s Führung unterstützt Anthropics Positionierung um Ausdauer und Selbstverifikation. DeepSWE ähnelt mehr autonomer Repository-Level-Software-Entwicklung, wo Sol einen 3,9-Punkte-Vorsprung hält.
BrowseComp unterscheidet sich um 0,4 Punkte und sollte als Tie behandelt werden. Eine Kaufentscheidung, die auf dieser Marge gebaut wird, wäre falsche Präzision.
Welches Modell ist besser für echte Code-Arbeit?
Feature-Entwicklung und schwierigiges Debugging: Opus 5
Opus 5 ist die sicherere erste Wahl, wenn die Arbeit viele Turns dauert und das Modell seine eigene Arbeit weiterhin überprüfen muss. Anthropic hat es speziell für komplexe agentengesteuerte Codierung und langfristige Aufgaben entworfen, und seine größten offiziellen Gewinne erscheinen bei Auswertungen, die Ausdauer über eine einzelne Antwort belohnen.[1]
Das macht es gut geeignet für Code-Review, Root-Cause-Debugging, Migrationen,
und Feature-Arbeit, wo sich Anforderungen während der Implementierung ändern. Thinking ist
standardmäßig an, und Effort ist das Haupt-Kostenregler. Starte bei high, vergleiche dann
medium und xhigh gegen deine eigenen Akzeptanztests.
Repository-Agenten und OpenAI-natives Tool-Satz: GPT-5.6 Sol
Sol verdient den ersten Test, wenn DeepSWE-ähnliche Performance oder das Responses API Ökosystem Priorität ist. GPT-5.6 fügt Programmatic Tool Calling, persistierte Reasoning-Kontrolle, Pro Mode und Beta-Multi-Agent-Orchestrierung hinzu.[3]
Diese Features zählen, wenn ein Agent Suchen, Shell-Arbeit, Datei-Operationen und Sub-Agenten koordinieren muss, ohne einen Orchestrierungs-Layer, der vollständig im Anwendungscode gebaut ist. Sie machen nicht jede Coding-Antwort besser, aber sie ändern, was eine API-Anfrage koordinieren kann.
Frontend und Computer-Einsatz: Opus 5
Opus 5 führt OSWorld 2.0 um acht Punkte in Anthropics Tabelle an und ist auch vorne bei Frontier-Bench und Automation-Ergebnissen des Anbieters. Für Browser-basierte QA, visuelles Debugging und Workflows, die zwischen Code und UI-Inspektion wechseln, deuten die Beweise auf Opus 5 hin.[1]
Teste deineSoftware trotzdem. Browser-Harnesses, Screenshot-Auflösung, Tool-Latenz und Retry-Regeln können das Ergebnis mehr bewegen als ein kleines Modell-Upgrade.
Preisvergleich: offizielle API und reAPI
| Route | Input / MTok | Output / MTok |
|---|---|---|
| Anthropic Claude Opus 5 | $5,00 | $25,00 |
| OpenAI GPT-5.6 Sol | $4,00 | $20,00 |
| reAPI Claude Opus 5 | $2,40 | $12,00 |
| reAPI GPT-5.6 Sol | $3,20 | $16,00 |
Preise überprüft 22. Oktober 2026. Zu offiziellen Listenpreisen ist Sol um 20% günstiger auf Input und Output, da OpenAIs GPT-5.6 Sol Rate eine Promotion ist, die OpenAI sagt, sie dauert mindestens bis 21. November 2026. Auf reAPI ist das umgekehrt: Opus kostet 25% weniger als Sol auf Input und Output. Das ändert den Standard für hochvolumige Agent-Schleifen, wo Reasoning und Tool-Transkripte eine große Output-Rechnung erzeugen.
Preis pro Token ist nur die erste Schicht. Die aussagekräftige Metrik ist:
Kosten pro akzeptierte Aufgabe
= Token-Kosten × Versuche + Tool-Gebühren + Human-Review
Wenn Sol eine Repository-Aufgabe einmal löst und Opus zwei Versuche braucht, verliert die günstigere Rate. Wenn beide bestehen, hat Opus den klaren Kosten-Vorteil.
Reasoning-Kontrolle sind nicht austauschbar
Claude Opus 5 stellt low, medium, high, xhigh und max zur Verfügung,
mit Standard high. Thinking ist adaptiv und standardmäßig an. Es auszuschalten
während du xhigh oder max fragst, gibt einen Fehler zurück, und max_tokens
muss verstecktes Thinking plus sichtbaren Text abdecken.[4]
GPT-5.6 unterstützt none, low, medium, high, xhigh und max, mit
medium als Standard. OpenAI empfiehlt, das aktuelle Effort während Migration
beizubehalten und eine Stufe niedriger zu testen, da die neue Familie
Qualität mit weniger Output-Token halten kann.[3]
Für eine faire Auswertung, gleiche nach Kosten oder Latenz ab – nicht nach
identischen Einstellungsnamen. high bei einem Anbieter ist keine standardisierte
Compute-Menge bei dem anderen.
Beide Modelle über eine API aufrufen
reAPI stellt beide Modelle über einen OpenAI-kompatiblen Chat Completions Endpoint zur Verfügung. Der Integrations-Unterschied ist der Model-String:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://api.reapi.ai/v1",
)

def run(model: str, prompt: str):
    return client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=16000,
    )

opus = run("claude-opus-5", "Review this migration for rollback risks.")
sol = run("gpt-5.6-sol", "Review this migration for rollback risks.")
Nutze denselben Prompt, Repository-Snapshot, Tools, Timeout und Akzeptanz-Kriterium. Erfasse Gesamt-Token und Versuche, statt zwei attraktive Outputs mit Auge zu vergleichen.
FAQ
Ist Claude Opus 5 besser als GPT-5.6 Sol zum Programmieren?
Für langfristige Codierung und Computer-Einsatz, die offizielle Beweise favorisieren Opus 5. Für DeepSWE v1.1 Repository-Aufgaben führt GPT-5.6 Sol. Das bessere Production-Modell hängt von deiner Task-Verteilung und dem Agent-Harness ab.
Welches Modell ist billiger?
Auf reAPI, Opus 5: $2,40/$12 und Sol kostet $3,20/$16 pro Million Input/Output Token, 25% günstiger auf beiden (überprüft 22. Oktober 2026). Zu offiziellen Listenpreisen ist es umgekehrt während OpenAIs Promotion läuft: Sol kostet $4/$20, Opus 5 kostet $5/$25.
Unterstützen beide Modelle einen Million-Token-Context?
Ja. Opus 5 hat ein 1M-Fenster und Sol hat ein 1,05M-Fenster. Long-Context-Preise und Performance hängen trotzdem von der Route und Anfragegröße ab.
Welches Modell ist besser für Multi-Agent-Workflows?
Sol hat native Beta-Multi-Agent-Orchestrierung in OpenAIs Responses API. Opus 5 kann in Multi-Agent-Systemen arbeiten, aber Orchestrierung wird im Allgemeinen von der Anwendung oder Claude-Tooling bereitgestellt.
Kann ich zwischen ihnen wechseln, ohne meine App umzuschreiben?
Auf reAPI, ja für Standard-Chat-Completions-Workloads. Behalte einen OpenAI-SDK-Client
und ändere model zwischen claude-opus-5 und gpt-5.6-sol. Anbieter-spezifische
Reasoning- und Tool-Features brauchen trotzdem konditionelle Request-Felder.
Fazit
Die Claude Opus 5 vs GPT-5.6 Sol Entscheidung ist konditionell, aber sie ist nicht vage. Starte mit Opus 5 für langfristige Entwicklung, Review, Computer-Einsatz und niedrigere Token-Kosten. Starte mit Sol für DeepSWE-ähnliche Repository-Agenten und Workflows, die von OpenAis nativen Orchestrierungs-Features profitieren. Behalte dann den Gewinner nur, wenn er die Kosten pro akzeptierte Aufgabe auf deinem eigenen Code reduziert.
References
- Anthropic. Introducing Claude Opus 5 — official benchmark table and methodology notes. anthropic.com/news/claude-opus-5
- Anthropic. Claude model pricing. platform.claude.com/docs/en/about-claude/pricing
- OpenAI. GPT-5.6 model guidance, pricing, and Responses API features. developers.openai.com/api/docs/guides/latest-model
- Anthropic. What's new in Claude Opus 5. platform.claude.com/docs/en/about-claude/models/whats-new-opus-5
Further reading
- reAPI. How to use Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. How to use GPT-5.6. reapi.ai/blog/how-to-use-gpt-5-6
- reAPI. Claude Opus 5 model page. reapi.ai/models/claude-opus-5
Autor

Kategorien
Weitere Beiträge
Maximale LLM-Ausgabetokens: API-Limits und Kontextbudgets
Vergleiche LLM-Ausgabelimits, Denkbudgets und API-Parameter. Trenne Kontextfenster, Anfragegrenzen, Standardwerte und Claudes spezielle Batch-Erweiterung.
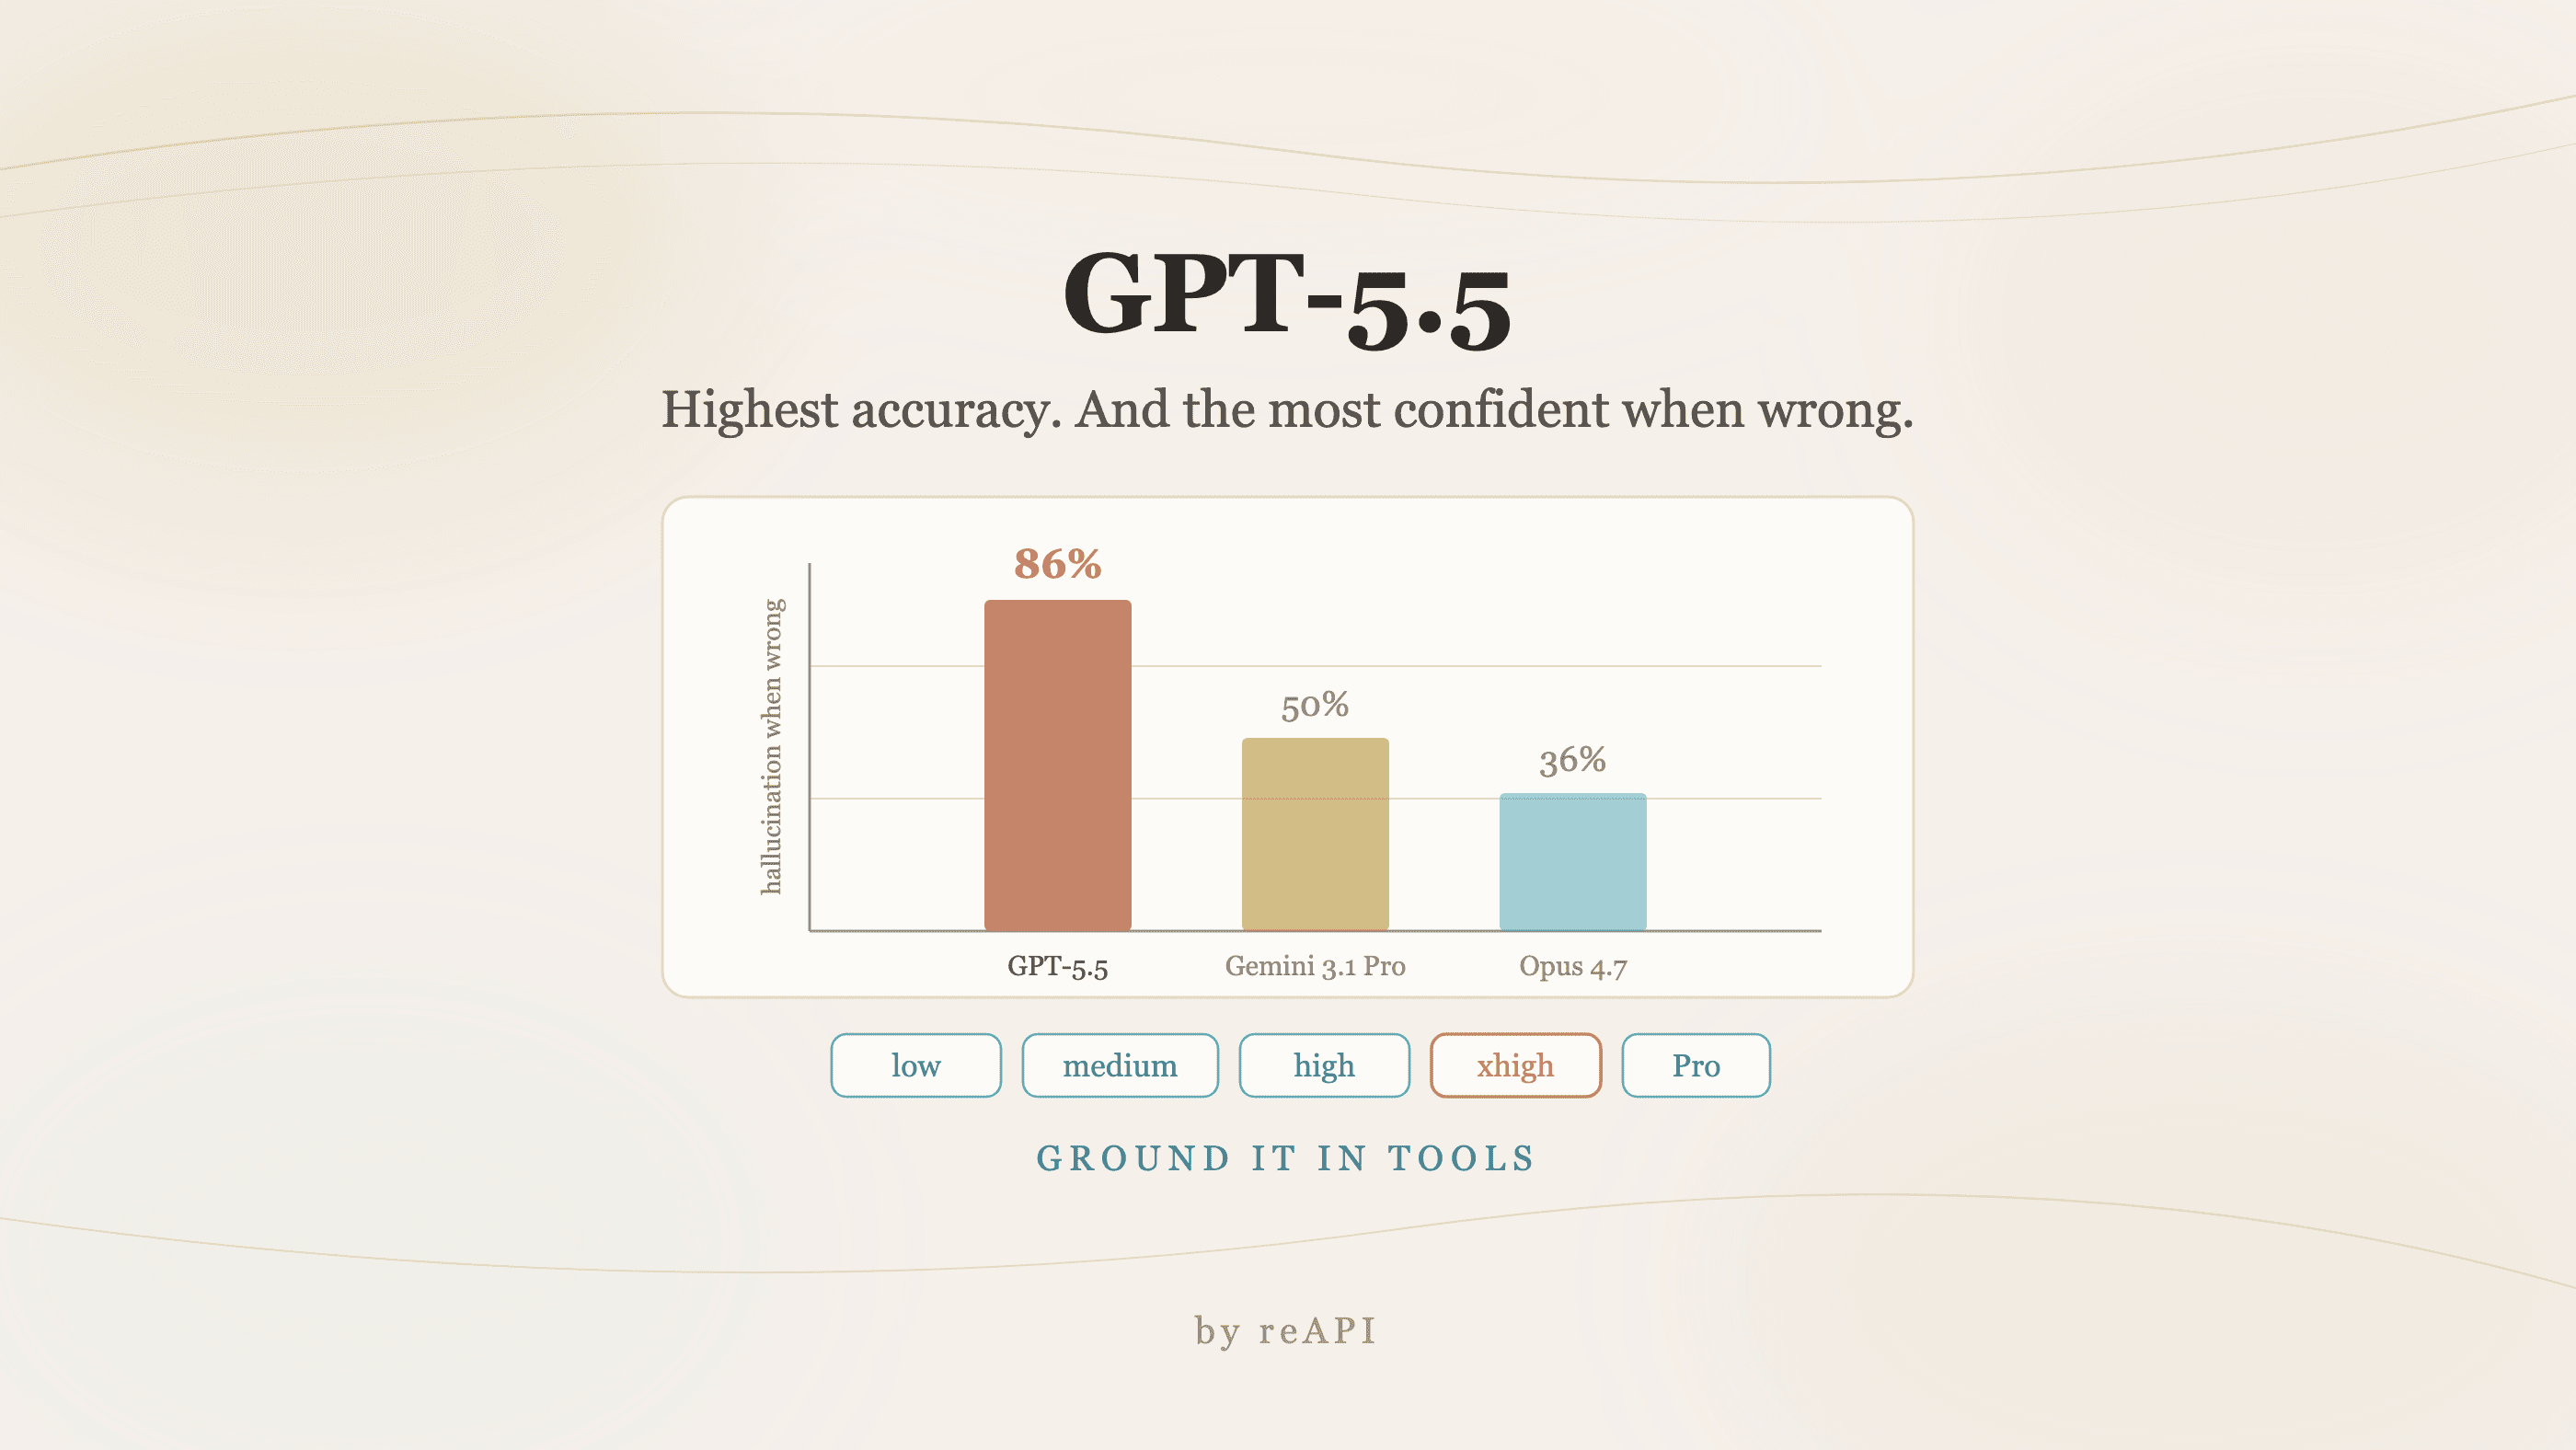
GPT-5.5 nutzen: Agent-Stärken und sein einziger Schwachpunkt
GPT-5.5 nutzen: Terminal-Bench-Führend, Preiserhöhung echte 20%, 86%-Halluzinationsrate die keiner zitiert, Einsatz mit Verifikations-Schleife.
FLUX 3 vs Seedance 2.5: Keyframes, Dauer und API-Kosten
Wähle FLUX 3 für Keyframes, FHD-Ausgabe oder Fortsetzung. Wähle Seedance 2.5 für 21–30-Sekunden-Takes, Referenzmaterial oder Video-Bearbeitung.