GPT-5.6 Anleitung: Sol, Terra und Luna im Vergleich
GPT-5.6-Anleitung: Sol-, Terra- und Luna-Kosten, Terminal-Bench mit vier Sternen, neue max- und ultra-Einstellungen und die beste Tier-Wahl.
Bei der Entscheidung GPT-5.6 Sol vs Terra vs Luna solltest du mit der günstigsten Stufe beginnen, die deine Qualitätsprüfungen besteht: Luna für kostenempfindliche Massenverarbeitung, Terra, wenn Lunas Fehler oder Wiederholungen ein Upgrade rechtfertigen, und Sol für anspruchsvolle professionelle Aufgaben, bei denen sich die zusätzliche Leistung bezahlt macht. Die aktuellen Standardpreise von OpenAI für Eingabe/Ausgabe betragen bei Prompts bis 272K Eingabetokens $0.20/$1.20 für Luna, $2/$12 für Terra und $4/$20 für Sol je Million Tokens. Alle drei haben dieselben dokumentierten Kontext- und Ausgabegrenzen; ein höherer Preis kauft kein größeres Fenster.[3][4][5]
Die folgenden Preise und aktuellen API-Grenzen wurden am 23. Oktober 2026 geprüft. Die Beschreibung der Einführung und von Terminal-Bench bleibt als historischer Kontext erhalten. Sie ist weder ein neuer Benchmark-Lauf noch ein Versprechen, dass jeder damalige Evaluierungsmodus als API-Parameter verfügbar ist.
OpenAI startete eine begrenzte Vorschau von GPT-5.6 am 26. Juni 2026, und das Seltsamste am Launch war, dass so gut wie niemand ihn nutzen konnte. Der Zugang beschränkte sich auf etwa zwanzig ausgewählte Partner über die API und Codex, in einem gestaffelten Rollout, den OpenAI zufolge die US-Regierung gefordert hatte[1].
Diese Beschränkung fiel inzwischen weg. Wie man GPT-5.6 einsetzt, ist jetzt eine praktische Frage statt Wartespiel, und die Antwort dreht sich vor allem um die Wahl eines von drei Tiers: Sol das Flaggschiff, Terra der vielseitige Allrounder, und Luna das Budget-Modell. Jedes ist ein stabiles Capability-Tier unter einer Generationsnummer, keine vorübergehende Variante.
Dieser Leitfaden behandelt die aktuelle Wahl zwischen den drei Stufen, Preise und Grenzen sowie den damaligen Benchmark mit seinen vier Einschränkungen, die historische ultra-Evaluierungseinstellung und die Cybersicherheitsprüfung, die die Einführung geprägt hat.
TL;DR
- Drei Stufen mit gemeinsamen Grenzen. Sol ist das Flaggschiff, Terra verbindet Leistung und Kosten, Luna zielt auf kostenempfindliche Massenverarbeitung. Alle drei unterstützen die Reasoning-Stufe
max.[3][4][5] - In der Terminal-Bench-2.1-Tabelle zur Einführung erreicht Sol 88.8% mit einem einzelnen Agenten beziehungsweise 91.9% im
ultra-Modus. Der Vorsprung gegenüber Claude Mythos 5 mit einem Agenten beträgt 0.8 Punkte und liegt innerhalb der Schwankungsbreite[1]. ultraist kein Single Agent. Es orchestriert Sub-Agenten parallel, daher lässt sich sein Score nicht eins-zu-eins mit Single-Agent-Baselines vergleichen[1].- Entscheide nach akzeptierter Aufgabe, nicht nach Stufenname. Teste Luna zuerst für Routineaufgaben in großer Zahl, vergleiche Terra bei dessen Fehlversuchen und nutze Sol, wenn die Verbesserung die höheren Kosten aufwiegt.
- Bei reAPI betragen die Eingabe-/Ausgabepreise für kurzen Kontext 80% der aktuellen OpenAI-Standardpreise: Sol $3.20 / $16.00, Terra $1.60 / $9.60 und Luna $0.16 / $0.96 je Million Tokens, geprüft am 23. Oktober 2026. Dieser Prozentsatz gilt nicht für jeden Langkontextpreis.[8]
- Das Evaluierungs-Fenster war absichtlich eng. OpenAI veröffentlichte nur Coding, Biologie und Cybersecurity, behielt aber SWE-Bench, GDPval, Mathematik und Halluzinations-Zahlen zurück[1].
gpt 5.6 sol vs terra vs luna
GPT-5.6 folgt auf GPT-5.5, das im April 2026 komplett neu trainierte agentische Modell. Während GPT-5.5 ein einzelnes Modell mit verschiedenen Reasoning-Effort-Stufen war, ist GPT-5.6 eine Familie mit drei Tiers unter einer Generationsnummer. OpenAIs Ansage ist eindeutig: Die Nummer kennzeichnet eine Generation, Sol, Terra und Luna bezeichnen hingegen dauerhafte Capability-Tiers, die sich unabhängig voneinander weiterentwickeln können[1].
Dieser Satz ist die wichtigste Design-Entscheidung des Releases. Er entkoppelt „wie intelligent" von „wie neu". Eine künftige Generation könnte ein neues Luna ausliefern, ohne Sol anzutasten, und ein Sol-Update zwingt niemanden auf Terra, seine Pipelines neu zu testen.
| Tier | Positionierung |
|---|---|
| GPT-5.6 Sol | Flaggschiff für komplexe professionelle Arbeit; prüfen, wo schwierigere Aufgaben den höheren Preis rechtfertigen |
| GPT-5.6 Terra | Balance zwischen Leistung und Kosten; prüfen, wenn Luna die Aufgabenanforderungen nicht erfüllt |
| GPT-5.6 Luna | Schnell und preiswert, ausgelegt für Hochvolumen-Routineaufgaben |
gpt 5.6 context window
OpenAI dokumentiert mittlerweile dieselben Grenzen für alle drei GPT-5.6-Stufen: ein gesamtes Kontextfenster von 1,050,000 Tokens, höchstens 922,000 Eingabetokens und höchstens 128,000 Ausgabetokens. Die Eingabegrenze ist nicht das gesamte Kontextfenster. Alle akzeptieren Text und Bilder als Eingabe und erzeugen Text; ihre Modellseiten nennen Streaming, strukturierte Ausgaben und Function Calling. Die Listen gehosteter Tools sind ausdrücklich für die Responses API gekennzeichnet. Daraus folgt keine Garantie, dass jeder kompatible Endpunkt dieselben Tools bereitstellt.[3][4][5]
Alle drei unterstützen none, low, medium, high, xhigh und max; der Standard ist medium. Die aktuellen Modellreferenzen führen weder minimal noch ultra als Effort-Werte auf. Reasoning-Tokens belegen Kontextplatz und werden als Ausgabe berechnet. Ein Ausgabebudget muss deshalb sowohl die verborgenen Überlegungen als auch die sichtbare Antwort abdecken.[6]
Terminal-Bench 2.1 und seine vier Sternchen
OpenAI veröffentlichte zur Preview nur drei Benchmark-Bereiche: Coding, Biologie und Cybersecurity, den Rest behielt es sich für GA vor[1]. Die eine, die wichtig ist, heißt Terminal-Bench 2.1 – sie testet agentische Command-Line-Workflows, die Planung, Iteration und Tool-Koordination brauchen.
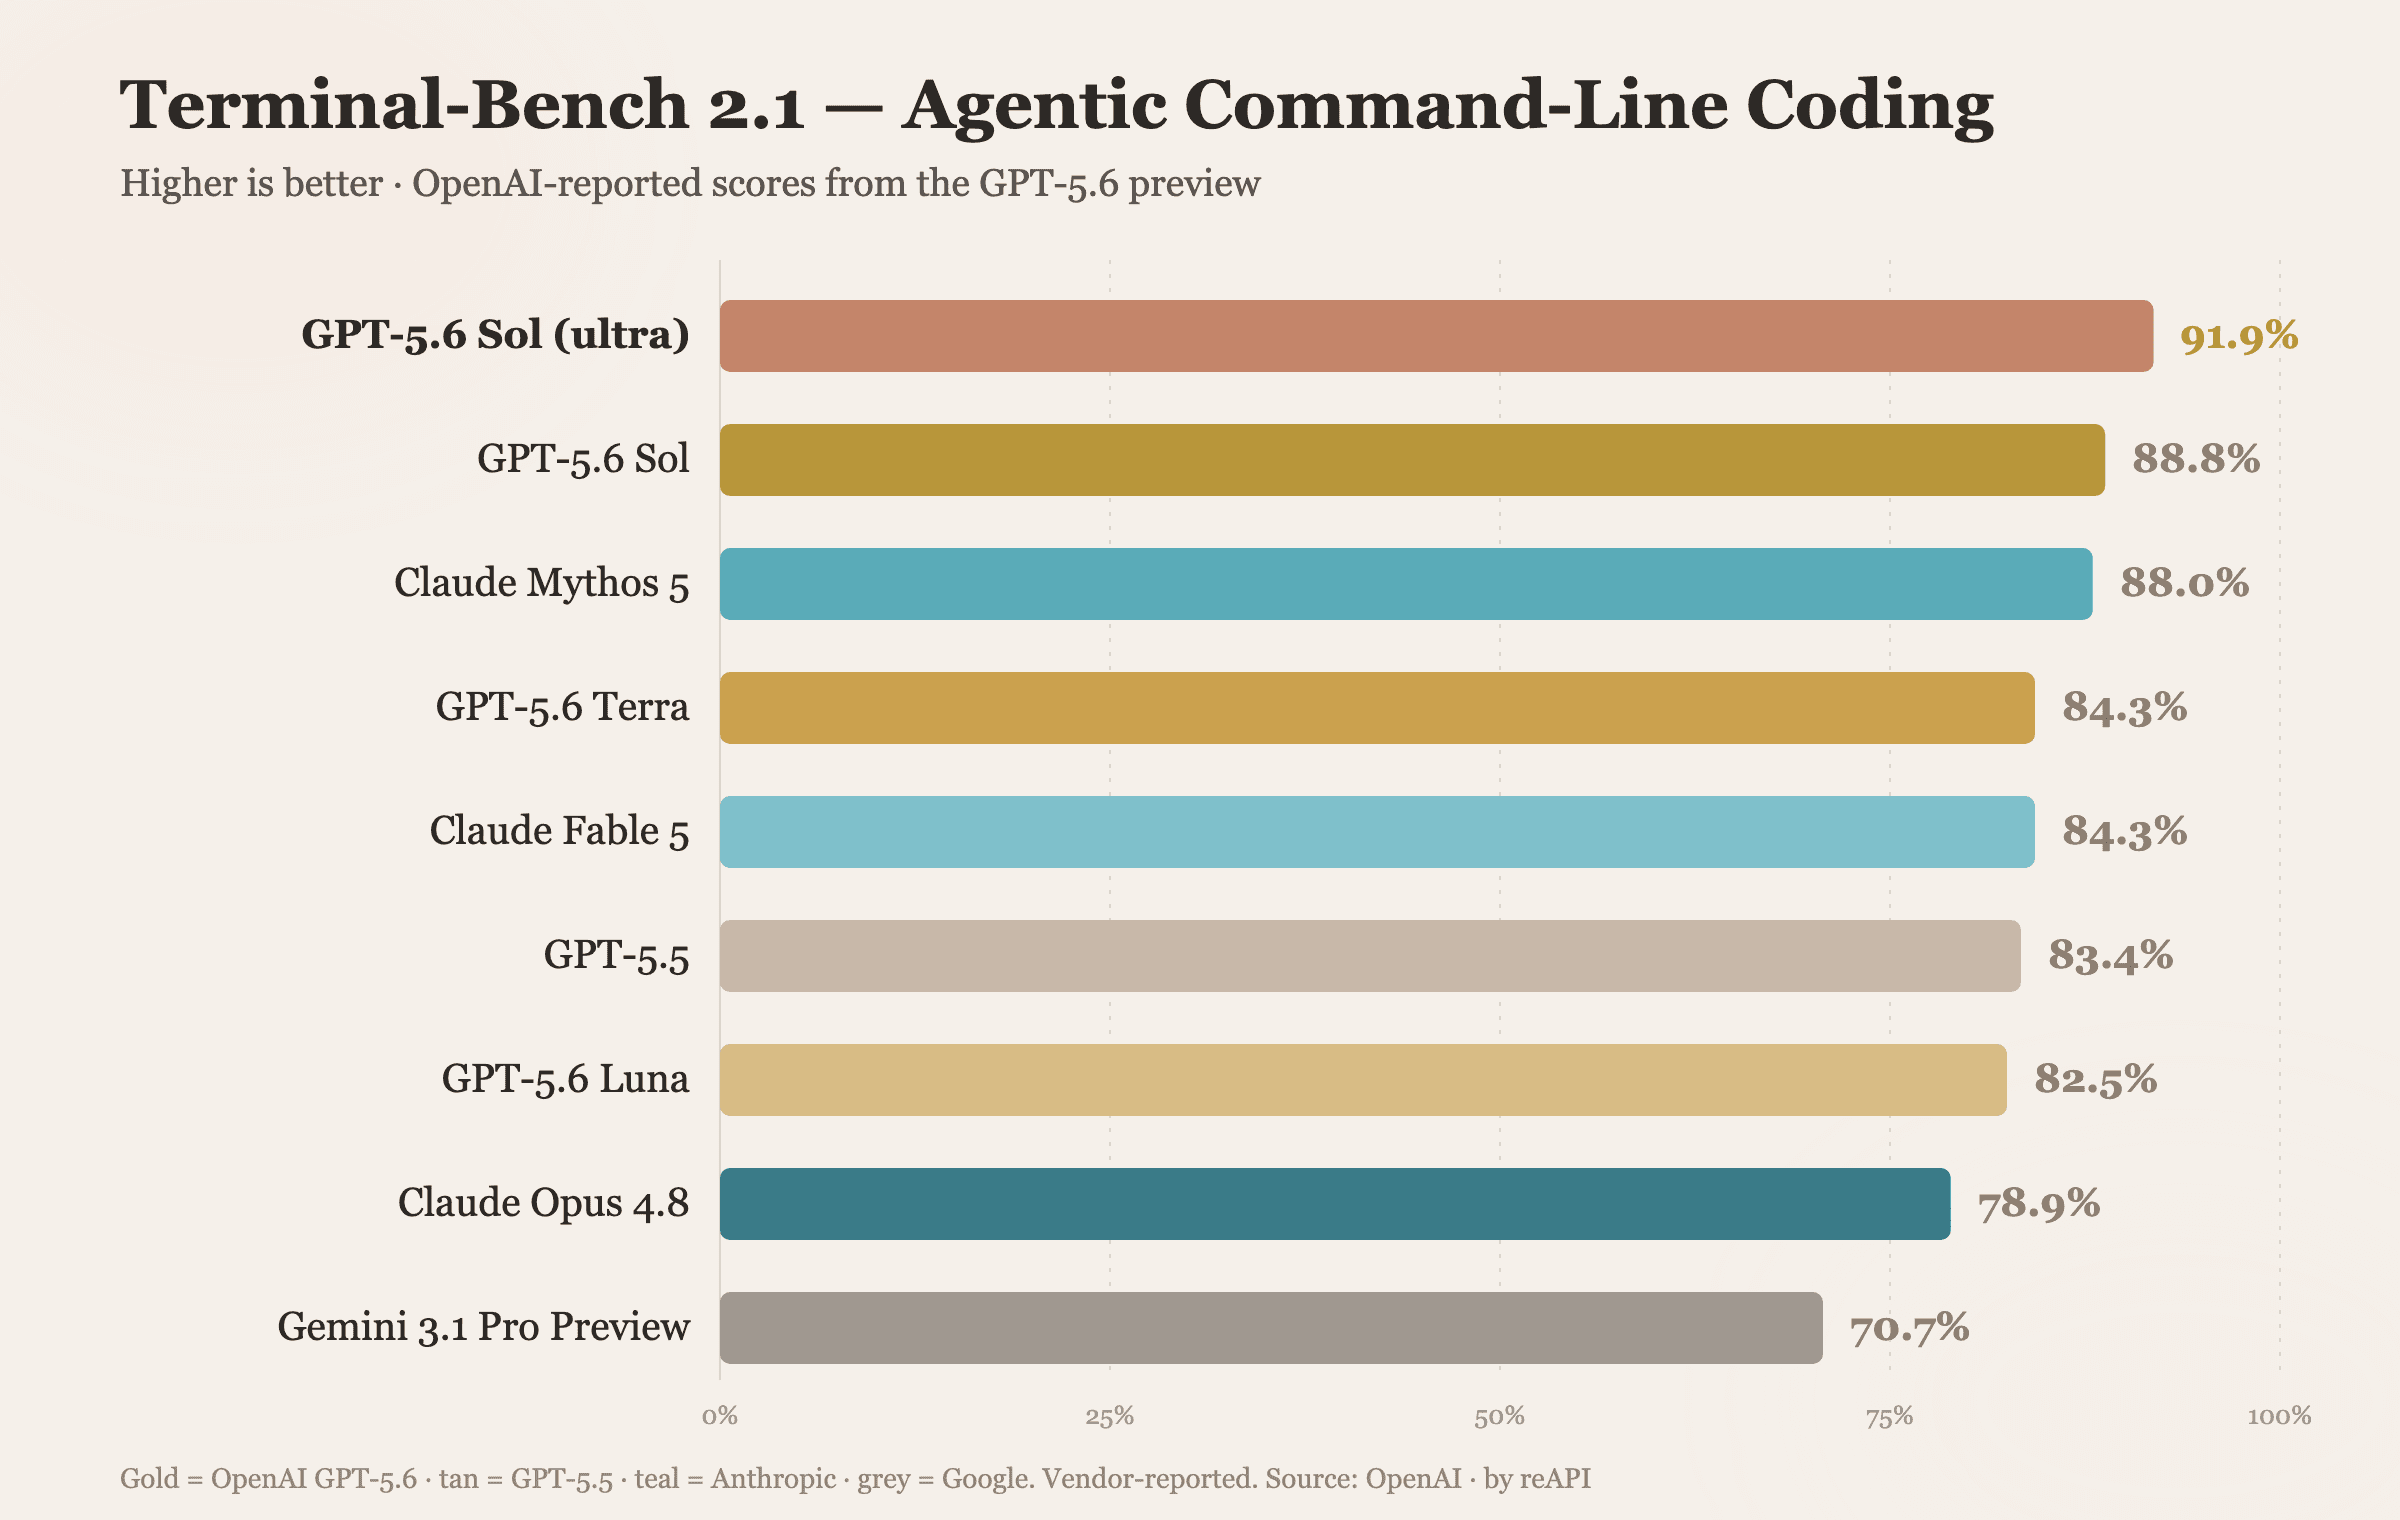
| Modell | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (ultra-Modus) | 91,9% |
| GPT-5.6 Sol | 88,8% |
| Claude Mythos 5 | 88,0% |
| GPT-5.6 Terra | 84,3% |
| Claude Fable 5 | 84,3% |
| GPT-5.5 | 83,4% |
| GPT-5.6 Luna | 82,5% |
| Claude Opus 4.8 | 78,9% |
| Gemini 3.1 Pro Preview | 70,7% |
Lest du genau, wird die Tabelle ehrlicher, als die Schlagzeile „neuer Stand der Technik" vermuten lässt – vier Punkte sprechen dafür[1].
Die 91,9%-Marke nutzt ultra, aber das ist kein Single Agent. Das Ergebnis kommt von Sol, das Sub-Agenten orchestriert. Gegen Single-Agent-Baselines ist das kein Vergleich äpfel-zu-äpfel. Die faire Vergleichbarkeit ist Sols 88,8%.
Single-Agent-Sol schlägt Claude Mythos 5 um 0,8 Punkte. Zwei Läufe desselben Modells können um mehr divergieren. OpenAI hält einen echten Vorteil an der Spitze der Coding-Kurve, aber bei diesem Benchmark ist er eng, nicht überwältigend.
Terra liegt gleichauf mit Claude Fable 5 und knapp vor GPT-5.5. 84.3% entspricht exakt Fable 5 und liegt weniger als einen Punkt über dem Vorgängermodell. Zusammen mit dem niedrigeren Preis ist das die wirtschaftliche Aussage: ein ähnliches gemeldetes Terminal-Bench-Ergebnis zu einem niedrigeren Einführungspreis, kein Beleg für gleichwertige Coding-Fähigkeiten über alle Aufgaben hinweg.
Gemini 3.1 Pro Preview hinkt um rund 21 Punkte hinterher. Der Abstand ist real, aber Benchmark-spezifisch. Gemini führt anderswo bei Long-Context-Abruf und Multimodal-Aufgaben, die hier nicht gemessen werden.
Bei Biologie meldet OpenAI, dass Sol stärkere GeneBench-v1-Ergebnisse erreicht als GPT-5.5, während weniger Tokens verbraucht werden – ohne Rohdaten zu zeigen. Das ist eine Richtungs-Aussage, keine verifiable Kenngröße[1].
max und ultra
Der Vergleich zur Einführung verwendete max und eine Multi-Agenten-Evaluierungseinstellung namens ultra. Trenne dieses historische Etikett bei der aktuellen API-Integration vom dokumentierten Parametervertrag: max wird von Sol, Terra und Luna unterstützt, und ultra gehört nicht zu ihren sechs aktuellen Reasoning-Effort-Werten.[3][4][5]
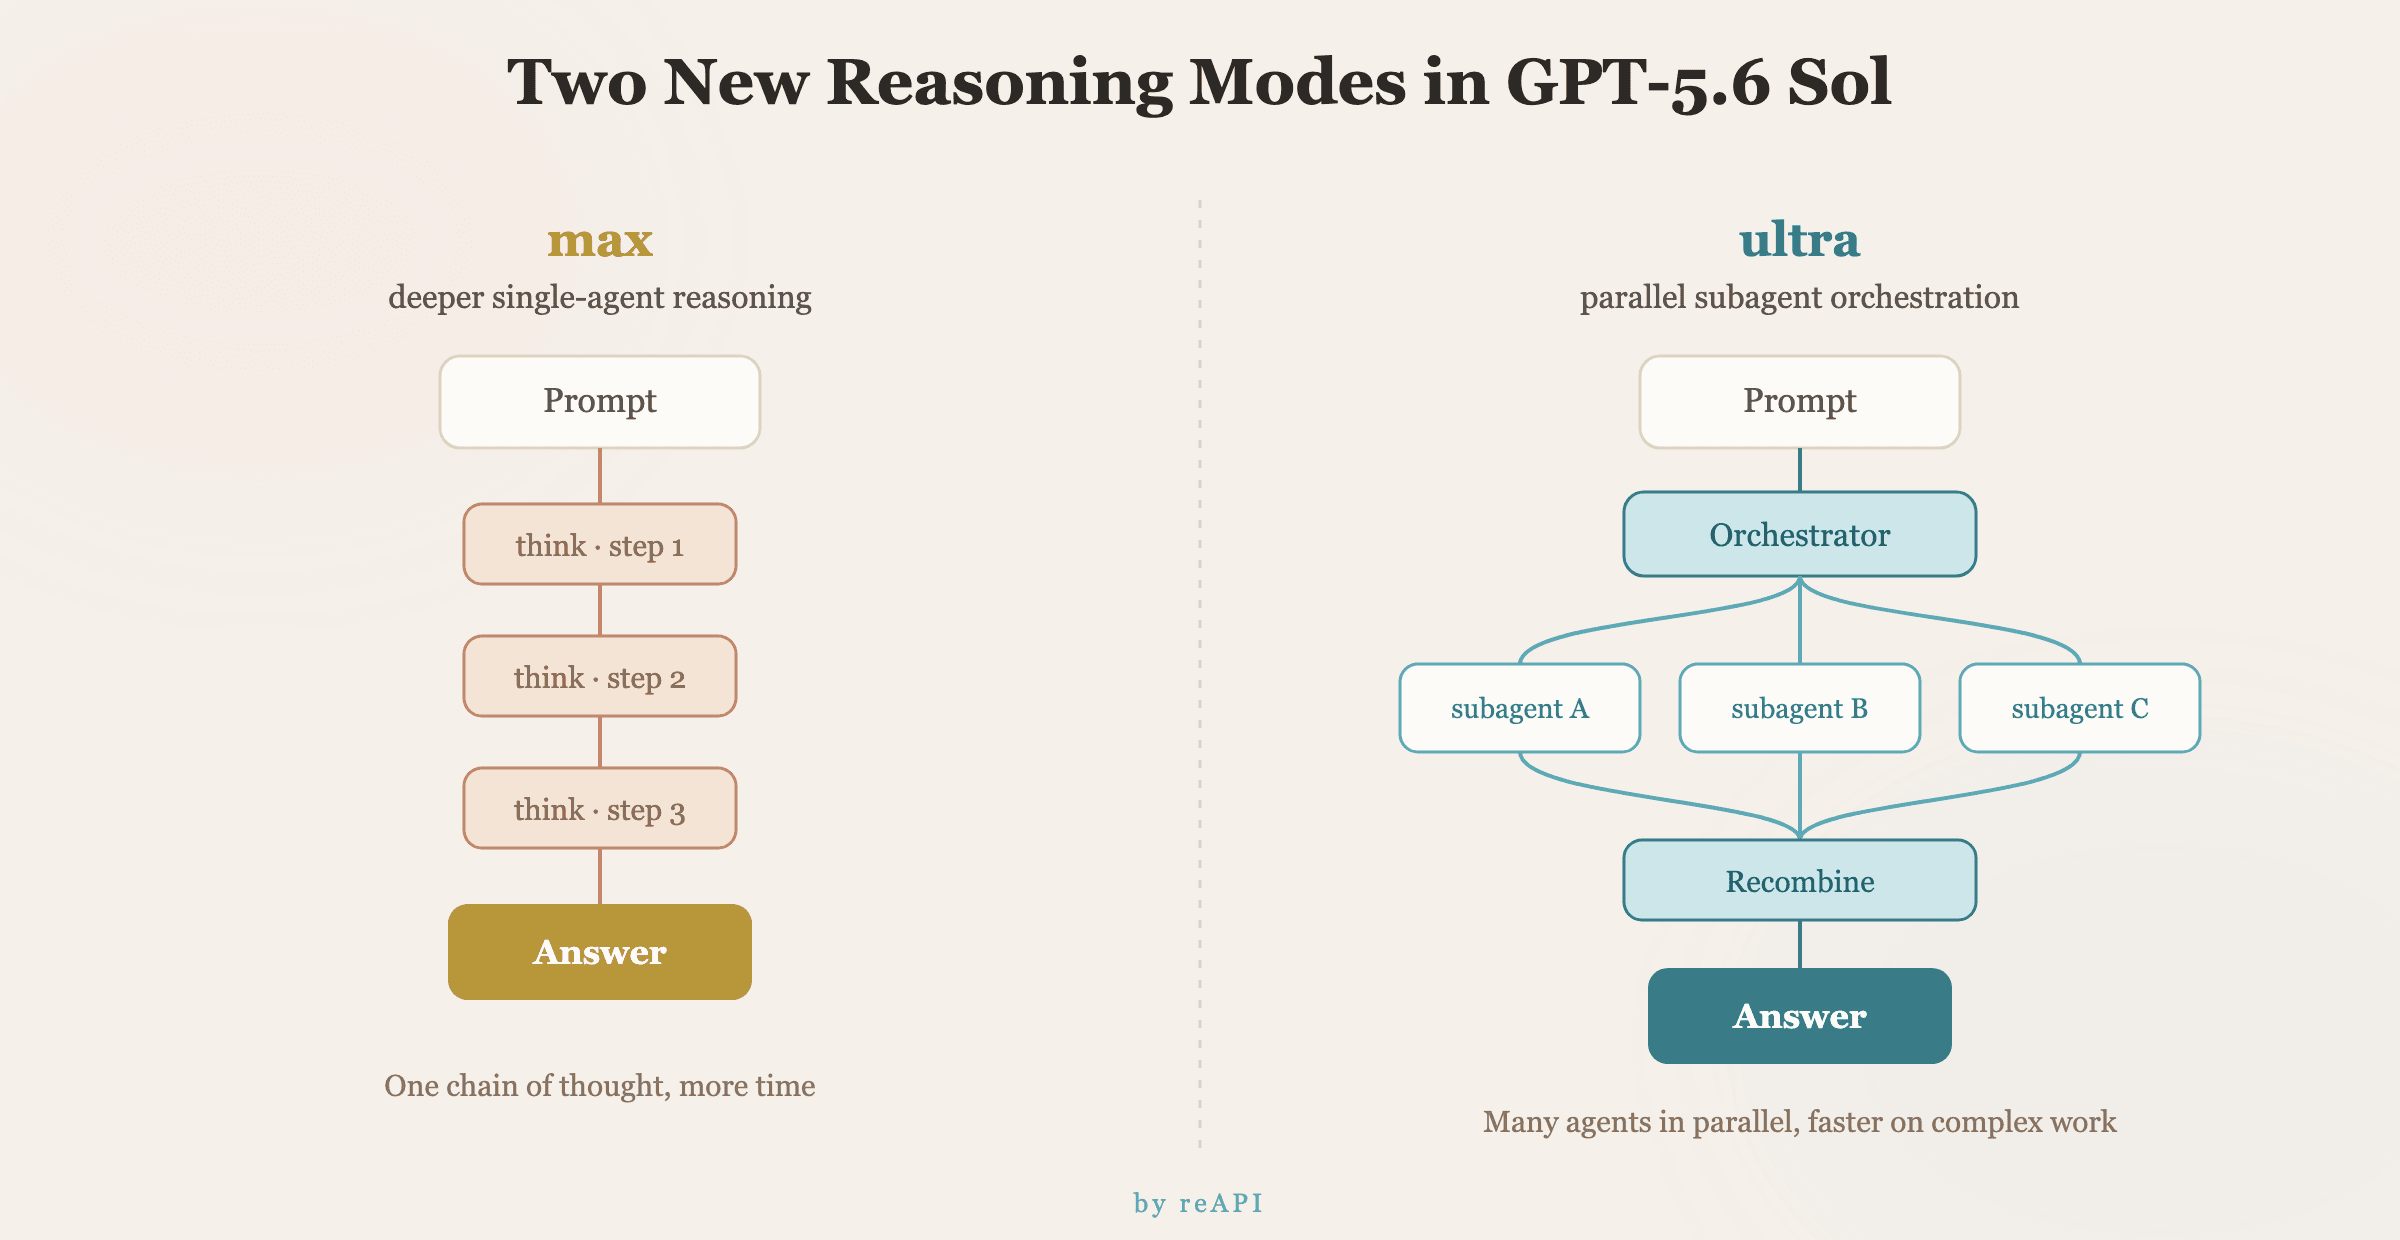
Die Abbildung beschreibt den Vergleich zur Einführung. Das ultra-Ergebnis nutzt Unteragenten und ist kein Einzelagenten-Ergebnis unter identischen Bedingungen. Es belegt weder einen aufrufbaren ultra-Parameter noch eine in reAPI integrierte Orchestrierung.
OpenAIs aktuelle Responses API dokumentiert stattdessen unabhängige Regler für Reasoning Effort und Reasoning Mode. reasoning.mode wählt standard oder pro. Der Pro-Modus lässt das Modell mehr Arbeit erledigen und berechnet die dabei entstehenden Tokens zu den normalen Tokenpreisen des gewählten Modells. Auch bei gleichem Preis pro Token kann er deshalb insgesamt mehr kosten. Bei GPT-5.6 ist der Standard-Effort in beiden Modi medium.[6]
reAPIs öffentliche Route für diese Modelle ist Chat Completions und verwendet reasoning_effort. Gehe nicht davon aus, dass OpenAIs Responses-spezifische Modi, fortgeführtes Reasoning oder gehostete Agentenfunktionen durch das Kopieren von Feldern in diese Anfrage aktiviert werden.
gpt 5.6 pricing
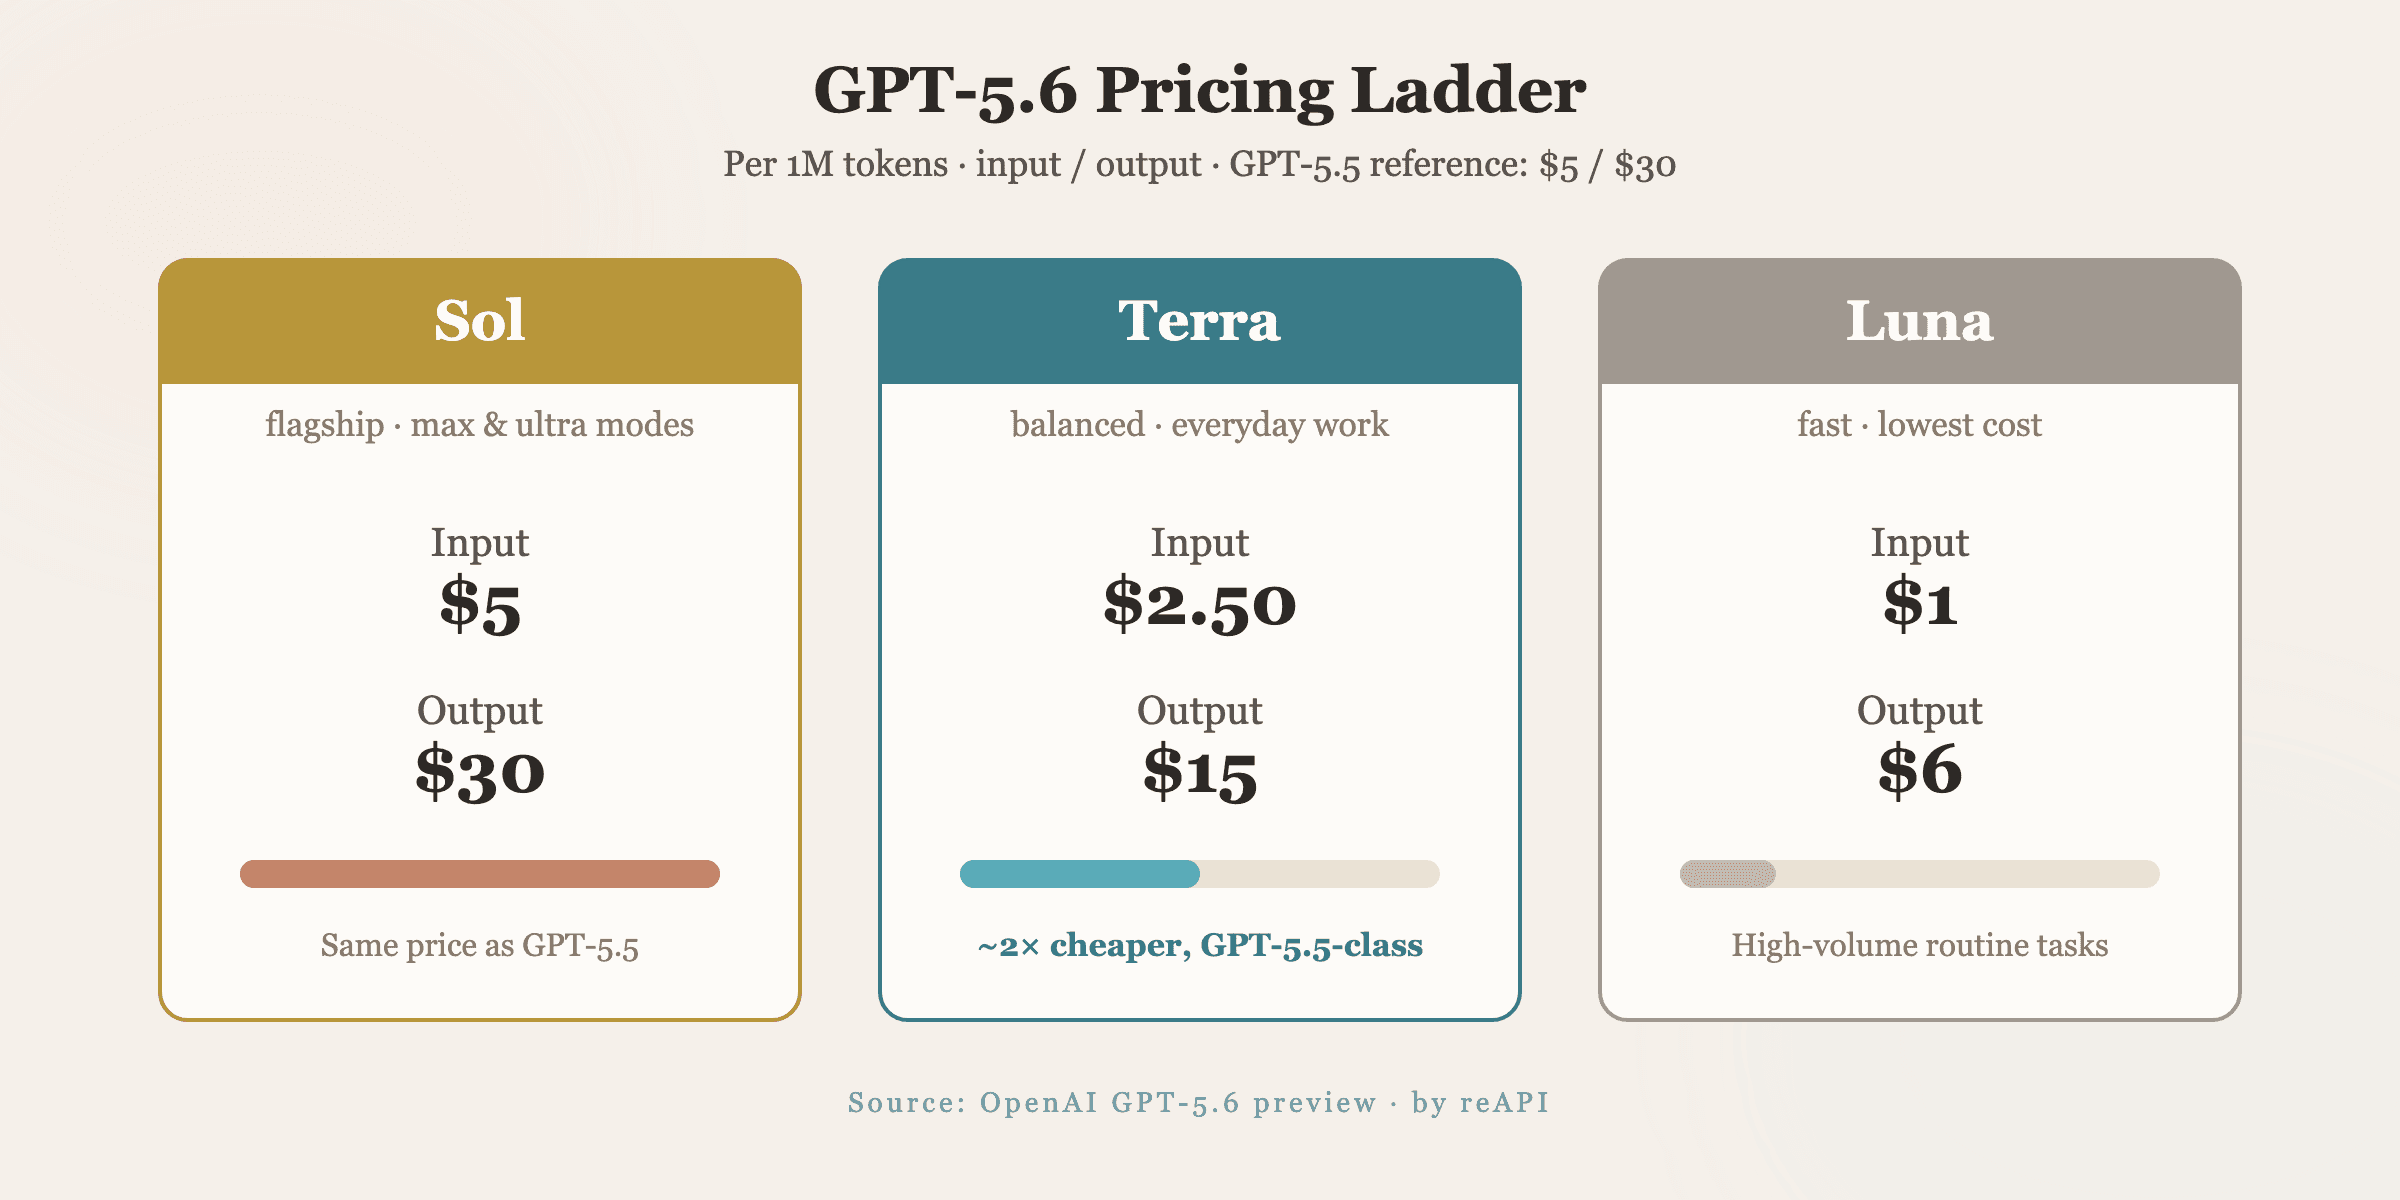
Das Bild bewahrt die Einführungspreise. Die aktuellen Spalten unten zeigen Eingabe-/Ausgabepreise für kurzen Kontext je Million Tokens, keine universellen Preise für jede Promptgröße oder jeden Verarbeitungsmodus.[2][8]
| Tier | OpenAI-Listenpreis bei Einführung (Input/Output pro 1M) | OpenAI-Listenpreis, 23. Oktober 2026 | Bei reAPI, 23. Oktober 2026 |
|---|---|---|---|
| GPT-5.6 Sol | $5 / $30 | $4 / $20 | $3,20 / $16,00 |
| GPT-5.6 Terra | $2,50 / $15 | $2 / $12 | $1,60 / $9,60 |
| GPT-5.6 Luna | $1 / $6 | $0,20 / $1,20 | $0,16 / $0,96 |
Zwei Punkte fielen bei OpenAIs Einführungspreisen auf. Sol behielt GPT-5.5s exakte $5 / $30 bei und fügte Leistung und neue Modi hinzu – mehr zum gleichen Preis. Terra meldete bei niedrigeren Einführungspreisen ein ähnliches Terminal-Bench-Ergebnis wie GPT-5.5 und war damit eine Evaluierung wert[1]. Hinzu kommen Sols Verbesserungen bei der Tokeneffizienz: Vergleichbare Ergebnisse benötigen weniger Ausgabetokens, sodass der effektive Rückgang der Kosten pro Aufgabe größer ausfällt, als die reinen Tokenpreise vermuten lassen.
OpenAI hat inzwischen alle drei Listenpreise gesenkt. Für Sol handelt es sich um eine Aktion, die laut OpenAI mindestens bis zum 21. November 2026 gilt[2]. Sol liegt damit unter GPT-5.5s $5 / $30 statt auf demselben Niveau. Die aktuellen reAPI-Eingabe-/Ausgabepreise für kurzen Kontext betragen 80% von OpenAI Standard, doch die Preisverhältnisse zwischen den Stufen haben sich verändert: Lunas $0.20/$1.20 sind ein Zehntel von Terras $2/$12; bei der Einführung bestand dieses Verhältnis nicht. Verstehe Sols Novemberdatum als Mindestdauer der Aktion, nicht als garantierte Preiserhöhung am nächsten Tag. Wähle die günstigste Stufe, die deine gemessenen Qualitätsanforderungen erfüllt, statt Terra automatisch zum Standard zu machen.
Bei mehr als 272K Eingabetokens berechnet OpenAI den 2-fachen Eingabe- und 1.5-fachen Ausgabepreis für die gesamte Anfrage, nicht nur für Tokens oberhalb der Schwelle. Die aktuellen Standardpreise für Cache und langen Kontext lauten:[2]
| Stufe | Kurzer Kontext: Cache-Lesen / 30m-Schreiben / 12h-Schreiben | Langer Kontext: Eingabe / Ausgabe | Langer Kontext: Cache-Lesen / 30m-Schreiben / 12h-Schreiben |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI unterstützt implizites und explizites Caching. Schreibvorgänge mit der standardmäßigen Mindestdauer von 30 Minuten kosten das 1.25-Fache normaler Eingabe; die Responses API bietet auch mindestens 12 Stunden zum 2.5-fachen Preis. Das sind vollständige Schreibpreise, keine Zuschläge auf normale Eingabe. Lesen kostet bei diesen drei Modellen das 0.1-Fache. Ein cachebarer Präfix muss mindestens 1,024 Tokens lang sein. Die Einstellung von 12 Stunden ist eine Mindestlebensdauer, keine Löschfrist.[7]
Für beispielhafte 20,000 nicht gecachte Eingabetokens und 5,000 berechnete Ausgabetokens ergibt OpenAI Standard nach (20,000 × input rate + 5,000 × output rate) / 1,000,000: Sol $0.18, Terra $0.10, Luna $0.01. Mit reAPIs Eingabe-/Ausgabepreisen für kurzen Kontext ergeben sich $0.144, $0.08 und $0.008. Die festen Tokenzahlen umfassen Reasoning in der berechneten Ausgabe und schließen Tools, Steuern und Cache-Vorgänge aus. Das sind Berechnungen, keine gemessenen Kosten abgeschlossener Aufgaben.
Bei 300,000 nicht gecachten Eingabetokens und 5,000 berechneten Ausgabetokens ergeben OpenAIs Langkontextpreise für die gesamte Anfrage Sol $2.55, Terra $1.29 und Luna $0.129. Die niedrigeren Kurzkontextpreise gelten dann nicht mehr. Trenne bei gecachten Anfragen normale Eingabe, Cache-Lese- und Cache-Schreibvorgänge, bevor du sie mit ihren jeweiligen Preisen multiplizierst. Wenn du gecachte Tokens nochmals als normale Eingabe zählst, überschätzt du die Rechnung.
reAPIs angezeigte Langkontextpreise für Eingabe/Ausgabe am 23. Oktober betrugen Sol $6.40/$24.00, Terra $3.20/$14.50 und Luna $0.320/$1.440 je Million Tokens. Terras angezeigter Preis für lange Ausgabe ist $14.50; eine pauschale „80%“-Aussage wäre deshalb falsch. Prüfe die genaue Kategorie auf der Modellseite. Diese Tabelle verspricht keine über reAPI wählbaren Cache-Laufzeiten nach OpenAIs Schema.[8]
Die OpenAI-Zahlen oben verwenden Standardverarbeitung und enthalten weder separat berechnete Tools noch Aufschläge für regionale Verarbeitung. Batch, Flex und Fast Mode haben eigene Preistabellen. Vergleiche nicht den alternativen Verarbeitungsmodus eines Modells mit dem Standardpreis eines anderen, als wären die Servicebedingungen identisch.[2]
Die Bewertung, die den Rollout geprägt hat
Das ist auch jetzt noch wert zu verstehen – es ist ein Präzedenzfall, keine Fußnote.
OpenAI beschränkte das initiale Release nach Anfrage der US-Regierung auf etwa zwanzig überprüfte Partner, nachdem es die Capabilities der Modelle vorher demonstriert hatte[1]. Auslöser war Cybersecurity-Capability: Sol erweitert Vulnerability-Research erheblich, und bei Tests mit Chromium und Firefox identifizierte es Bugs und Exploitation-Primitives – Bausteine für Exploits – ohne autonome funktionsfähige Full-Chain-Exploits unter den getesteten Bedingungen zu erzeugen. OpenAI sagt, Sol überschreitet die Cyber-Critical-Schwelle im Preparedness Framework nicht, und genau das ist die Grundlage für das Release[1].
Bemerkenswerterweise endorset OpenAI das Arrangement nicht als Dauerlösung und sagt, solche Regierungs-Zugriffs-Prozesse sollten nicht zum Long-Term-Standard werden, weil sie die besten Tools von den Verteidigern fernhalten, die sie brauchen[1].
Der mitgelieferte Security-Stack ist wichtig zu kennen, weil er zeigt, wie High-Capability-Modelle künftig ausgeliefert werden: trainiert-in Refusals, Real-Time Cyber- und Biologie-Klassifizierer, die Generation pausieren können für Überprüfung durch größere Modelle, Account-Level Review von markierten Aktivitäten, differenzierter Zugriff auf sensitivste Capabilities. OpenAI setzte über 700.000 A100-GPU-äquivalente Stunden für automatisiertes Red-Teaming gegen universelle Jailbreaks an[1].
OpenAI ist offen: Diese Safeguards schlagen manchmal fehl – legitime Security-Researcher können auf Refusals bei Dual-Use-Anfragen treffen.
Wo das Argument stark ist und wo es schwach ist
Stark. Agentisches Kommandozeilen-Coding, bei dem Sol als einzelner Agent den Benchmark anführt und ultra das Ergebnis erweitert. Tokeneffizienz, die sich bei Agenten mit hohem Volumen aufsummiert. Der Wert der mittleren Stufe, bei der Terras Preissenkung die breiteste praktische Wirkung der Einführung hat. Das damalige ultra-Ergebnis umfasst Multi-Agenten-Orchestrierung und ist als Evaluierungsaufbau zu lesen, nicht als Versprechen einer aktuellen reAPI-Funktion[1].
Schwach. Die Schlagzeile ist ein 0,8-Punkte-Sieg bei einem Benchmark. Das Evaluierungs-Fenster war bewusst klein – keine SWE-Bench, GDPval, Mathematik oder Halluzinations-Zahlen – daher bleibt ungeklärt, ob GPT-5.6 das Confident-Hallucination-Problem gelöst hat, das GPT-5.5 plaggte. Alles ist Vendor-Report unter OpenAIs eigener Zählung[1].
Bis eine größere Test-Suite und unabhängiges Scoring vorliegen, sollte das Urteil zu General-Purpose-Capabilities reserviert bleiben.
Wie man GPT-5.6 nutzt: welches Tier
Luna für kostenempfindliche Routineverarbeitung in großer Zahl, wenn es deine Prüfungen besteht. Beginne mit repräsentativen Klassifizierungs-, Extraktions- oder Kurzantwortaufgaben und erfasse akzeptierte Ausgaben, Wiederholungen und Prüfaufwand. Der niedrigere Tokenpreis nützt nur, wenn die Ausgabe die Anforderungen erfüllt.
Terra, wenn die zusätzliche Leistung das Ergebnis ausreichend verbessert, um den Preis zu rechtfertigen. Vergleiche es bei Lunas tatsächlichen Fehlerfällen, statt jede Produktionsanfrage pauschal der mittleren Stufe zuzuweisen. Der Coding-Benchmark zur Einführung ist ein Beleg für diese Evaluierung, nicht für gleichwertige Fähigkeiten bei jeder Aufgabe.
Sol für anspruchsvolle professionelle Arbeit, bei der die Verbesserung die Zusatzkosten aufwiegt. Teste schwieriges Coding oder lang laufende Aufgaben mit denselben Tools und Abnahmekriterien. Alle drei Stufen unterstützen max; weder dieser höhere Effort noch ein größeres Kontextfenster ist Sol vorbehalten. Wähle keine reAPI-Stufe in der Annahme, dass ultra ein unterstützter Request-Wert sei.
GPT-5.6 auf reAPI aufrufen
Alle drei Stufen sind auf reAPIs OpenAI-kompatiblem Endpunkt https://reapi.ai/api/v1/chat/completions registriert. Verwende den Schlüssel deines aktuellen reAPI-Workspaces und die exakte Wire-ID mit Stufensuffix; OpenAIs Punkte bleiben erhalten:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)
Ersetze gpt-5.6-terra durch gpt-5.6-sol oder gpt-5.6-luna, um die Stufen mit demselben Chat-Completions-Format zu vergleichen. OpenAI dokumentiert einen Alias gpt-5.6 ohne Suffix. reAPIs aktuelle Registrierung verwendet jedoch die drei IDs mit Suffix; nutze hier diese exakten Zeichenfolgen. Die konfigurierte reAPI-Ausgabegrenze beträgt für jedes Modell 128,000 Tokens, und die dokumentierten Effort-Werte sind none, low, medium, high, xhigh und max.[8]
OpenAI unterstützt für diese Familie sowohl Chat Completions als auch Responses und empfiehlt Responses für Reasoning-Workflows. reAPI veröffentlicht keine /v1/responses-Route. Die Weiterleitung von Parametern belegt keine Funktionsgleichheit: Gehe nicht davon aus, dass OpenAIs gehostete Tools, Pro-Reasoning-Modus oder Vertrag für fortgeführtes Reasoning von diesem Chat-Endpunkt nachgebildet werden. Die verlinkten reAPI-Endpunktreferenzen beschreiben die Integration; für diese Artikelaktualisierung wurde keine Generierung in der Produktionsumgebung durchgeführt.[6][8]
Aktuelle Sätze auf reapi.ai/models/gpt-5-6-sol, reapi.ai/models/gpt-5-6-terra, und reapi.ai/models/gpt-5-6-luna.
FAQ
Was ist der Unterschied zwischen max- und ultra-Modus?
max ist ein aktueller Reasoning-Effort-Wert für alle drei GPT-5.6-Stufen. Das historische ultra-Benchmark-Ergebnis nutzte Unteragenten und lieferte die Terminal-Bench-Schlagzeile von 91.9%; es gehört nicht zu den aktuellen sechs Effort-Werten. OpenAIs separates reasoning.mode: "pro" gehört zu Responses und darf nicht mit einem ultra-Feld oder einer reAPI-Chat-Funktion verwechselt werden.[1][3][6]
Ist GPT-5.6 Sol besser als Claude beim Codieren?
Bei Terminal-Bench 2.1 schlägt Single-Agent-Sol bei 88,8% Claude Mythos 5 (88,0%) um 0,8 Punkte – real, aber eng. Mit ultra erreicht Sol 91,9%, nutzt aber Sub-Agenten und ist nicht eins-zu-eins vergleichbar[1].
Welches GPT-5.6-Tier sollte ich nutzen?
Prüfe Luna für Routineverarbeitung in großer Zahl, Terra, wenn Luna deine Anforderungen nicht erfüllt, und Sol für schwierige Arbeit, bei der die zusätzliche Qualität den Preis rechtfertigt. Alle drei teilen das dokumentierte Kontextfenster, die Ausgabegrenze und die Effort-Stufen. Entscheide anhand der Kosten pro akzeptierter Aufgabe und eigener Tests, nicht aufgrund einer angenommenen ultra-Integration.
Warum war die US-Regierung am Release beteiligt?
Sol erweitert Cybersecurity-Capability erheblich, einschließlich Vulnerability-Forschung, ohne OpenAIs Cyber-Critical-Schwelle zu überschreiten. Auf Regierungs-Anfrage führte OpenAI ein gestaffeltes Preview für etwa zwanzig überprüfte Partner durch, während ein Cyber-Framework entwickelt wurde[1].
Behebt GPT-5.6 GPT-5.5s Halluzinations-Problem?
Ungeklärt. OpenAI veröffentlichte zur Preview nur Coding-, Biologie- und Cybersecurity-Tests, behielt Halluzinations- und Knowledge-Work-Zahlen zurück[1]. Verbinde das Modell mit Source-Grounded-Verifikation für High-Stakes-Output.
Wie groß ist GPT-5.6 Sols Kontext-Fenster?
OpenAI dokumentiert mittlerweile ein gesamtes Kontextfenster von 1,050,000 Tokens, höchstens 922,000 Eingabetokens und höchstens 128,000 Ausgabetokens. Terra und Luna haben dieselben Grenzen. Die ältere Angabe von 1.5 Millionen Tokens ist nicht die aktuelle offizielle Spezifikation.[3][4][5]
Was änderte sich bei Prompt Caching?
OpenAI unterstützt implizites Caching und explizite Cache-Breakpoints, mit standardmäßigen 30-Minuten-Schreibvorgängen zum 1.25-Fachen normaler Eingabe und einer optionalen Mindestdauer von 12 Stunden in der Responses API zum 2.5-Fachen. Lesen kostet bei diesen drei Modellen das 0.1-Fache. Schreibpreise sind Gesamtpreise, und eine Mindestlebensdauer ist keine Löschfrist. reAPIs Chat-Route verspricht nicht dieselben konfigurierbaren Cache-Regler.[7]
Wie rufe ich GPT-5.6 mit dem OpenAI SDK auf?
Richte den OpenAI-Client auf https://reapi.ai/api/v1, nutze den Schlüssel deines reAPI-Workspaces und setze model auf gpt-5.6-sol, gpt-5.6-terra oder gpt-5.6-luna. Behalte Punkte und Stufensuffix bei; OpenAIs Alias ohne Suffix ist hier nicht registriert.[8]
Ein Drei-Tier-Release lesen
GPT-5.6 vereint zwei Veröffentlichungen in einer Ankündigung. Die eine ist ein ordentliches Familienupdate: eine sinnvolle neue Benennung, eine mittlere Stufe mit niedrigeren Einführungspreisen und einem ähnlichen gemeldeten Terminal-Bench-Ergebnis wie GPT-5.5 sowie ein ultra-Benchmark zur Einführung, der Multi-Agenten-Orchestrierung nutzte. Die andere ist ein Frontier-Modell, dessen anfängliche Verfügbarkeit mit einer Regierung abgestimmt und durch einen Sicherheitsaufwand von 700,000 GPU-Stunden abgesichert wurde.
Beginne für eine aktuelle Integration mit der günstigsten Stufe, die deine Prüfungen besteht. Plane Reasoning und die Langkontextschwelle ein und prüfe die API-Funktionen, die dein Workflow braucht. Der Benchmark zur Einführung bleibt ein hilfreicher historischer Beleg; die aktuellen Modellreferenzen und Preisbedingungen bestimmen jedoch, was du anfragst und budgetierst.
Für einen generationsübergreifenden Vergleich lies GPT-6 Sol vs Luna und GPT-6 Luna vs GPT-5.6 Luna. Diese Artikel beantworten die Frage nach einer GPT-6-Migration; dieser Leitfaden behandelt die Wahl zwischen den drei GPT-5.6-Stufen getrennt davon.
Referenzen
-
OpenAI. Modelle – die GPT-5.6-Familie, Reasoning-Modi und Spezifikationen. Abgerufen Juli 2026 von platform.openai.com/docs/models
-
OpenAI. Pricing — per-token rates by model and tier. Retrieved July 2026 and re-checked October 23, 2026. https://developers.openai.com/api/docs/pricing
-
OpenAI. GPT-5.6 Sol model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI. GPT-5.6 Terra model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI. GPT-5.6 Luna model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI. Reasoning models: effort, mode and token accounting. Checked October 23, 2026. https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI. Prompt caching: minimum lifetime and write/read pricing. Checked October 23, 2026. https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI. Rendered model-page prices and endpoint references, checked October 23, 2026. https://reapi.ai/models/gpt-5-6-sol — https://reapi.ai/models/gpt-5-6-terra — https://reapi.ai/models/gpt-5-6-luna — https://reapi.ai/docs/gpt-5-6-sol — https://reapi.ai/docs/gpt-5-6-terra — https://reapi.ai/docs/gpt-5-6-luna
Weitere Lektüre
- reAPI. Wie man Claude Opus 5 nutzt. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. Wie man Claude Fable 5 nutzt. reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Modellkatalog. reapi.ai/models
Autor

Kategorien
max und ultragpt 5.6 pricingDie Bewertung, die den Rollout geprägt hatWo das Argument stark ist und wo es schwach istWie man GPT-5.6 nutzt: welches TierGPT-5.6 auf reAPI aufrufenFAQWas ist der Unterschied zwischen max- und ultra-Modus?Ist GPT-5.6 Sol besser als Claude beim Codieren?Welches GPT-5.6-Tier sollte ich nutzen?Warum war die US-Regierung am Release beteiligt?Behebt GPT-5.6 GPT-5.5s Halluzinations-Problem?Wie groß ist GPT-5.6 Sols Kontext-Fenster?Was änderte sich bei Prompt Caching?Wie rufe ich GPT-5.6 mit dem OpenAI SDK auf?Ein Drei-Tier-Release lesenReferenzenWeitere LektüreWeitere Beiträge
DeepSeek V4 Flash 0731 mit Agent- und Codex-Support
DeepSeek V4 Flash 0731 ist live mit besseren Agent-Benchmarks, nativem Responses API Support und Codex-Integration unter der gleichen Model-ID.
GPT-5.6 ist veröffentlicht: Hier ist was ausgeliefert wurde
GPT-5.6 ist veröffentlicht in drei Stufen. Der Rollout war begrenzt, darum gibt es widersprüchliche Antworten. Terra ist die beste Tier für die Migration.
Gemini Omni API: Preisgestaltung und Spezifikationen
Google Gemini Omni API Preview: Modell-ID, Interactions API, 720p-Ausgabe, Preisgestaltung, Eingabelimits, Multi-Turn-Bearbeitung und reAPI-Unterschiede.