Prix de Gemini 4 Argon : tarif de lancement et coût réel
Prix de Gemini 4 Argon : le tarif de lancement $2/$10, le tarif standard $4/$20, l'entrée en cache et le coût de vraies tâches face à GPT-6 Astra et Opus 5.5.
Le prix de Gemini 4 Argon tient en deux chiffres, et la plupart des articles ne citent que le premier. Google a lancé le modèle à un tarif de lancement de $2 par million de tokens en entrée et $10 par million de tokens en sortie, avec une entrée en cache 95 % moins chère que l'entrée normale[1]. Une note de bas de page de la même annonce précise qu'« après l'expiration de la période de lancement, le prix de $4 par million de tokens en entrée et de $20 par million de tokens en sortie s'appliquera »[1]. Google n'a pas dit combien de temps dure la période de lancement.
Tout budget bâti sur Gemini 4 Argon doit donc intégrer les deux tarifs. Cet article présente la grille tarifaire complète, calcule quatre formes de tâches réelles et compare la facture avec deux des trois modèles du tableau de benchmarks de Google : GPT-6 Astra et Claude Opus 5.5.
En bref
- Tarif de lancement : $2 par million de tokens en entrée, $10 par million de tokens en sortie, entrée en cache à 95 % de moins que le prix d'entrée, soit $0.10 par million[1].
- Tarif standard après la période de lancement : $4 en entrée et $20 en sortie par million de tokens. Google n'a pas publié le tarif de l'entrée en cache pour cette phase[1].
- Face à GPT-6 Astra : Astra est affiché à $10 en entrée et $50 en sortie par million de tokens, avec des tarifs plus élevés au-delà de 272K tokens en entrée[2]. Le tarif de lancement d'Argon en représente un cinquième.
- Face à Claude Opus 5.5 : Opus 5.5 est affiché à $4 en entrée et $20 en sortie[3], exactement le tarif standard d'Argon.
- Pas d'offre gratuite ni d'accès développeur pour l'instant : la première vague développeurs est réservée aux « clients payants de l'API », et Google n'a donné aucune date[1].
La grille tarifaire complète de Gemini 4 Argon
Tout ce que Google a publié sur le prix de Gemini 4 Argon tient dans un tableau. Les cases « Non publié » correspondent à ce que Google n'a pas dit, pas à des zéros.
| Élément | Tarif de lancement | Tarif standard (après le lancement) |
|---|---|---|
| Entrée, par million de tokens | $2.00 | $4.00 |
| Sortie, par million de tokens | $10.00 | $20.00 |
| Entrée en cache, par million de tokens | $0.10 (95 % de moins que l'entrée) | Non publié |
| Surcoût contexte long | Non publié | Non publié |
| Remise batch | Non publié | Non publié |
| Durée de la période de lancement | Non publié |
Sources : l'annonce de Google et sa note de bas de page[1].
Deux points ressortent. D'abord, la sortie coûte cinq fois le prix de l'entrée, le même ratio que GPT-6 Astra et Claude Opus 5.5[2][3]. Ensuite, la remise sur le cache est forte. À $0.10 par million, relire une grosse codebase en cache à chaque tour d'agent coûte un vingtième d'une lecture à neuf.
Combien coûte 1 million de tokens sur Gemini 4 Argon ?
Tout dépend du sens des tokens. Un million de tokens en entrée coûte $2 au tarif de lancement et $4 ensuite. Un million de tokens en sortie coûte $10 au tarif de lancement et $20 ensuite[1].
Le cas de la sortie compte davantage pour Argon que pour les autres modèles, parce qu'Argon peut réellement produire un million de tokens en une seule réponse. Google a porté la limite de sortie à 1M tokens, contre 64K auparavant[1]. GPT-6 Astra s'arrête à 128 000 tokens en sortie[2], et Claude Opus 5.5 à 128K sur son API synchrone standard, ou 300K via sa Batch API avec un en-tête bêta[4]. Une réponse Argon de longueur maximale coûte donc $10 rien qu'en sortie au tarif de lancement, et $20 au tarif standard.
Ce que coûtent de vraies tâches : Argon vs GPT-6 Astra vs Claude Opus 5.5
Les prix catalogue masquent la forme du travail, alors voici quatre formes de tâches avec le calcul fait. Tous les chiffres utilisent le prix catalogue de l'API standard publié par chaque fournisseur pour une requête unique, sans remise batch. Les tarifs d'Astra doublent en entrée et augmentent de 1,5x en sortie dès qu'un prompt dépasse 272K tokens en entrée[2], et cette règle est appliquée là où elle se déclenche.
| Tâche | Argon lancement | Argon standard | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| Revue de code : 100K en entrée, 20K en sortie | $0.40 | $0.80 | $0.80 | $2.00 |
| Tour d'agent : 100K nouveaux + 400K en cache en entrée, 50K en sortie | $0.74 | Non publié | $1.48 | $6.55 |
| Long rapport : 200K en entrée, 600K en sortie | $6.40 | $12.80 | Impossible en une seule réponse | Impossible en une seule réponse |
| Sortie maximale : 100K en entrée, 1M en sortie | $10.20 | $20.40 | Impossible en une seule réponse | Impossible en une seule réponse |
Calcul de la ligne agent : Argon au tarif de lancement, c'est 100K × $2 + 400K × $0.10 + 50K × $10 par million. Opus 5.5 utilise son tarif de cache hit à $0.20[3]. Le prompt de 500K tokens d'Astra dépasse 272K, donc l'entrée passe à $20, l'entrée en cache à $2 et la sortie à $75 par million[2]. Le tableau ignore le coût ponctuel d'écriture du cache, que chaque fournisseur facture à part.
Le schéma est simple. Au tarif de lancement, Gemini 4 Argon coûte moitié moins que Claude Opus 5.5 et un cinquième de GPT-6 Astra sur des requêtes ordinaires. Après la période de lancement, Argon et Opus 5.5 coûtent le même prix par token, et Astra reste deux fois et demie plus cher. Les deux dernières lignes ne sont pas du tout une comparaison de prix : seul Argon peut renvoyer autant de texte en un seul appel.
Quand le tarif de lancement prend fin
Google dit seulement que les tarifs de $4 et $20 s'appliquent « après l'expiration de la période de lancement »[1]. Il n'y a pas de date, et l'API développeurs n'est pas encore ouverte, donc il est possible qu'une partie de la période de lancement s'écoule avant que la plupart des développeurs puissent envoyer une requête.
Planifie avec le tarif standard. Si une charge de travail n'a de sens qu'à $2 et $10, elle cassera à une date que personne n'a annoncée. Si elle tient à $4 et $20, la période de lancement est une remise en plus.
Ce que signifie en pratique un budget de sortie de 1M tokens
Les sorties longues sont là où la tarification de Gemini 4 Argon devient intéressante, et aussi là où elle peut te surprendre. Google dit qu'Argon peut « générer des centaines de milliers de tokens en une seule trajectoire »[1]. C'est cette capacité qui a permis à des agents Argon de réécrire 32K lignes de code SIMD dans libgav1 et de travailler sur une migration de noyau de plus de 800K lignes[1].
Cela veut aussi dire qu'une seule requête sans surveillance peut dépenser $20 au tarif standard. Trois habitudes permettent de garder le contrôle :
- Fixe un budget de sortie maximal sur chaque requête. Considère la limite de 1M comme une marge, pas comme une valeur par défaut.
- Mets en cache le contexte stable. Un dépôt ou un ensemble de documents relu à chaque tour doit être en cache à $0.10 par million, pas en entrée fraîche à $2.
- Mesure la sortie par tâche, pas par token. Un modèle qui termine en une longue réponse peut coûter moins cher qu'un modèle qui a besoin de cinq relances plus courtes, même avec un prix par token plus élevé.
La place de reAPI
Gemini 4 Argon n'est pas encore disponible sur reAPI, car Google n'a pas ouvert l'accès aux développeurs[1]. Nous publierons le tarif reAPI sur la page modèle Gemini 4 Argon quand il sera lancé ici.
Si tu veux commencer à construire dès maintenant, Claude Opus 5.5 est disponible sur reAPI et affiche, sur la plateforme d'Anthropic, le même prix par token que le tarif standard d'Argon[3]. Les tarifs reAPI en vigueur figurent sur chaque page modèle. Pour comprendre pourquoi les plafonds de sortie pèsent sur le coût, lis notre guide sur les max output tokens des LLM.
FAQ
Combien coûte Gemini 4 Argon ?
Au lancement, $2 par million de tokens en entrée et $10 par million de tokens en sortie, avec une entrée en cache à $0.10 par million. Après la période de lancement, $4 en entrée et $20 en sortie par million de tokens[1].
Gemini 4 Argon est-il gratuit ?
Non. Google n'a annoncé qu'une tarification payante, et le premier accès développeurs va aux clients payants de l'API[1].
Combien de temps dure le prix de lancement de Gemini 4 Argon ?
Google ne l'a pas dit. L'annonce indique seulement que le tarif standard s'applique après l'expiration de la période de lancement[1].
Gemini 4 Argon est-il moins cher que GPT-6 Astra ?
Oui, au prix catalogue. Astra coûte $10 en entrée et $50 en sortie par million de tokens[2], soit cinq fois le tarif de lancement d'Argon et deux fois et demie son tarif standard.
Gemini 4 Argon est-il moins cher que Claude Opus 5.5 ?
Pendant la période de lancement, oui, de moitié. Ensuite, les deux sont affichés à $4 en entrée et $20 en sortie par million de tokens[1][3].
Faut-il un abonnement Google AI Ultra pour Gemini 4 Argon ?
Pas pour l'API, qui est facturée au token. Google AI Ultra est l'offre grand public que Google a désignée pour le premier accès grand public[1].
Comment estimer une facture Gemini 4 Argon ?
Multiplie les tokens en entrée par le tarif d'entrée, les tokens d'entrée en cache par le tarif du cache et les tokens en sortie par le tarif de sortie, chacun par million. Refais ensuite le même calcul au tarif standard, puisque la période de lancement n'a pas de fin publiée.
Budgéter Gemini 4 Argon
Le chiffre phare est réel : à $2 et $10, Gemini 4 Argon passe sous tous les modèles du tableau comparatif de Google. Mais c'est un prix promotionnel sur un modèle que la plupart des développeurs ne peuvent pas encore appeler, avec une date de fin que personne n'a publiée. Bâtis ton business case sur $4 et $20, ce qui place Argon au niveau de Claude Opus 5.5 et bien en dessous de GPT-6 Astra, et compte la période de lancement comme un bonus.
Le vrai sujet tarifaire, c'est la longueur de sortie. Aucun autre modèle de ce comparatif ne peut te facturer un million de tokens en sortie en une seule réponse : le prix de Gemini 4 Argon est donc le plus avantageux précisément là où le modèle est le plus capable, et le plus coûteux quand une longue exécution part sans contrôle.
Références
- Google. Gemini 4 Argon: our next era of frontier intelligence. Consulté en octobre 2026 sur blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- OpenAI. GPT-6 Astra model page. Consulté en octobre 2026 sur developers.openai.com/api/docs/models/gpt-6-astra
- Anthropic. Pricing. Consulté en octobre 2026 sur platform.claude.com/docs/en/about-claude/pricing
- Anthropic. Models overview. Consulté en octobre 2026 sur platform.claude.com/docs/en/about-claude/models/overview
Auteur

Catégories
Plus d'articles
H3 Max est-il open source ? Poids et utilisation locale
MiniMax H3 a des poids publics, mais H3 Max est une variante post-entraînée distincte par fal. Découvrez ce qui est téléchargeable, hébergé et vérifié.
API Seedance 2.0 en 2026 : prix et meilleur rapport qualité-prix
Comparaison d'une même requête Seedance 2.0 sur reAPI, Replicate, fal, Atlas Cloud et WaveSpeed, règles de facturation comprises.
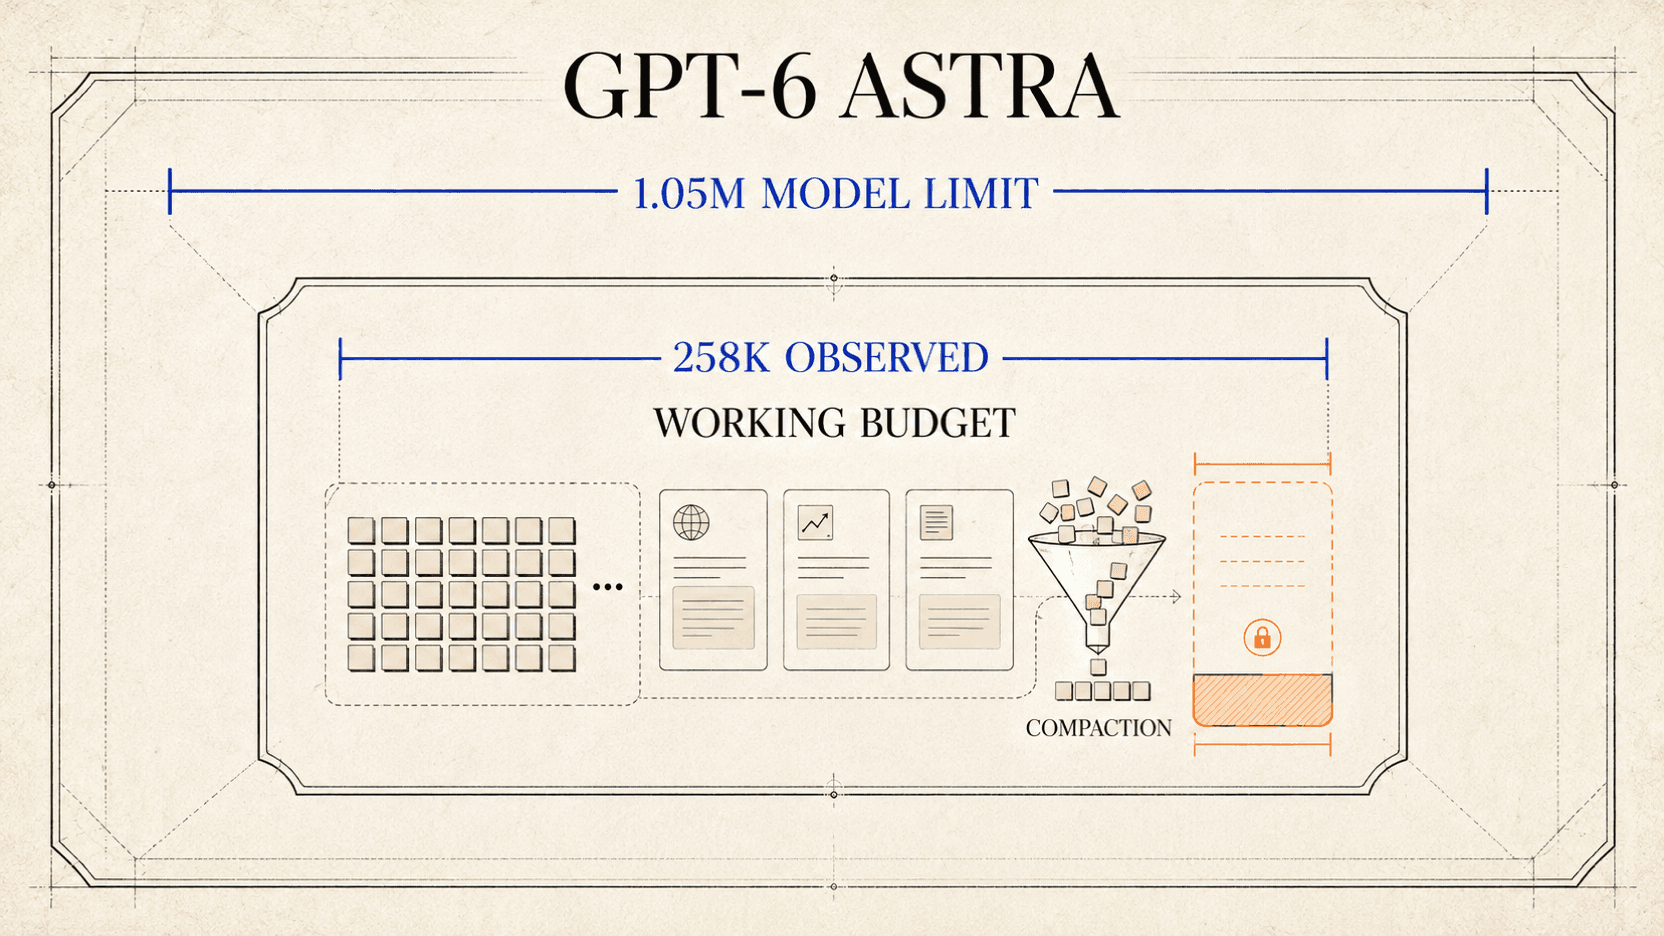
Fenêtre contexte GPT-6 Astra : pourquoi Codex affiche 258K
Comprenez la fenêtre contexte API de 1,05M jetons de GPT-6 Astra, pourquoi une session Codex affiche 258K, et comment mesurer la compaction.