GPT-6 Luna API Temperature setzen: Warum 400 kommt und was Sie senden sollten
Temperature bei der GPT-6 Luna API setzen? Warum GPT-6 Luna und Sol auf temperature und top_p mit 400 antworten, die exakte Modell-ID und ein korrekter Request.
Wer bei der GPT-6 Luna API die Temperature setzen will, bekommt in der Regel ein HTTP 400 statt einer kühleren Antwort. OpenAIs Migrationsleitfaden zu GPT-6 weist Entwickler an, temperature, top_p und top_logprobs zu entfernen, sobald der Reasoning Effort einen anderen Wert als none hat, und bei Chat Completions zusätzlich logprobs wegzulassen[1]. GPT-6 Luna verwendet standardmäßig den Effort medium[2]. Ein Request, der temperature: 0.2 mitschickt und den Effort unverändert lässt, landet also auf der falschen Seite dieser Regel.
Dieser Artikel erklärt, was die Regel besagt, welche exakten Fehlermeldungen Entwickler aus Amazon Bedrock, Azure und OpenAI-Clients gepostet haben, wie die korrekte Modell-ID lautet, und zeigt einen Request für den Chat-Completions-Endpunkt von reAPI vorher und nachher. Für GPT-6 Sol gelten dieselben Regeln.
Kurzfassung
- Entfernen Sie
temperatureundtop_p. Laut OpenAIs Leitfaden sind sie, zusammen mittop_logprobs, zu entfernen, wenn der Reasoning Effort nichtnoneist[1]. Der Standard-Effort von Luna istmedium[2]. - Bei reAPI ist die Regel einfacher:
temperature,top_p,frequency_penaltyundpresence_penaltyliefern sowohl beigpt-6-lunaals auch beigpt-6-soleinen400. Lassen Sie sie in jedem Request weg[3][4]. - Selbst
temperature: 1kann scheitern. Ein Bug-Report bei Langflow hat festgestellt, dass die Converse API von Amazon Bedrock das Feld bei jedem Wert ablehnt, auch bei 1[5]. - Die Stellschraube, die Ihnen bleibt, ist
reasoning_effort:none,low,medium,high,xhighodermax[2]. Einen Wertautogibt es nicht. - Die Modell-ID lautet
gpt-6-luna(bzw.gpt-6-sol), genau so geschrieben[2][3]. - Das oberste Ergebnis auf Microsoft Q&A betrifft einen anderen Bug. Dort geht es darum, dass
reasoning.effortin Azure AI Foundry abgelehnt wird, nicht um Temperature[6].
Warum GPT-6 Luna temperature ablehnt
GPT-6 Luna ist ein Reasoning-Modell. OpenAIs Modellseite nennt "Reasoning token support" und sechs Effort-Stufen, mit medium als Standard[2]. Die Checkliste "Update API and model parameters" in OpenAIs GPT-6-Leitfaden führt die Sampling-Parameter unter einer eigenen Überschrift[1]:
Unsupported parameters: When reasoning effort is not none, remove temperature, top_p, and top_logprobs. For Chat Completions, also remove logprobs.
Achten Sie genau auf die Bedingung. Der Leitfaden knüpft das Entfernen an den Reasoning Effort, nicht an den Modellnamen. Derselbe Leitfaden hält fest, dass GPT-6 Sol und GPT-6 Luna none unterstützen, GPT-6 Astra und GPT-6.1 Sol dagegen nicht[1]. In der Praxis laufen die meisten Requests mit dem Standard medium, also scheitern die meisten Requests, die temperature mitschicken.
reAPI dokumentiert ein strengeres Ergebnis. Die Parametertabelle für gpt-6-luna, am 2026-09-24 am Endpunkt gemessen, führt temperature, top_p, frequency_penalty und presence_penalty als "Not supported by this model — sending any of them returns 400. Leave them out of the request."[3] Die Seite zu gpt-6-sol enthält dieselbe Zeile[4]. Die Doku beschreibt keine Ausnahme für den Effort none. Verlassen Sie sich also nicht auf eine, sondern entfernen Sie die Felder.
Die 400-Meldungen, auf die Entwickler tatsächlich stoßen
Suchergebnisse zu diesem Problem vermischen mehrere verschiedene Fehler. Hier sind die Meldungen, die öffentlich gepostet wurden, woher jede stammt und was sie behebt.
| Fehlertext, wie gemeldet | Wo | Lösung |
|---|---|---|
| "Only the default (1) value is supported." | OpenAI-kompatibler Endpunkt von Bedrock, Langflow sendet temperature 0.1[5] | temperature entfernen |
| "This model doesn't support the temperature field. Remove temperature and try again." | Bedrock Converse, aus Langflow (Standard 0.7) und Phoenix (Standard 1)[5][7] | temperature entfernen, danach top_p, das Converse auf dieselbe Weise ablehnt[5] |
| "Unsupported parameter: 'reasoning.effort' is not supported with this model." | Azure-AI-Foundry-Agents und der Foundry-Projekt-Endpunkt[6][8] | Kein Temperature-Problem; siehe die Azure-Antwort in der FAQ |
| "Function tools with reasoning_effort are not supported for gpt-6-luna in /v1/chat/completions. To use function tools, use /v1/responses or set reasoning_effort to 'none'." | OpenAI Chat Completions, aus einem Ruby-Client, der Tools sendet[9] | Responses API oder Effort none verwenden, laut OpenAIs Modellseite[2] |
| "Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22" | Eine Foundry-Agent-Definition[10] | Für Azure gemeldet; kein Temperature-Problem |
Zwei dieser Reports zeigen, dass das Feld ankommt, ohne dass jemand es gewählt hat. Der AWS-Playground von Phoenix startet jeden Lauf mit temperature: 1 aus einer Standardkonfiguration, und der Schieberegler lässt sich nicht leeren[7]. Die Bedrock-Komponente von Langflow sendet standardmäßig Temperature 0.7 und Top P 0.9[5]. Wenn Ihr eigener Code temperature also nirgends erwähnt und der Fehler trotzdem auftritt, prüfen Sie die Standardwerte des Frameworks.
GPT-6 Luna API Temperature setzen bei reAPI: vorher und nachher
reAPI stellt GPT-6 Luna über POST https://reapi.ai/api/v1/chat/completions bereit, mit Ihrem reAPI-Key als Bearer-Token[3]. Dieser Request schleppt Gewohnheiten aus älteren Chat-Modellen mit und wird abgelehnt:
# Rejected: temperature and top_p return 400 on gpt-6-luna
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "temperature": 0.2,
    "top_p": 0.9
  }'
Die korrigierte Fassung lässt beide Felder weg und setzt die Parameter, die das Modell tatsächlich berücksichtigt. reasoning_effort akzeptiert bei reAPI alle sechs Stufen, und max_completion_tokens wird bis 128.000 angewendet[3]:
# Accepted: no sampling fields, explicit effort and output cap
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "reasoning_effort": "low",
    "max_completion_tokens": 1000
  }'
Reasoning-Tokens zählen zu max_completion_tokens und werden als Output abgerechnet. Ein Limit, das nur für die sichtbare Antwort bemessen ist, kann einen schwierigeren Prompt deshalb abschneiden[3]. Die aktuellen Preise pro Token finden Sie auf der GPT-6 Luna Modellseite.
Die übrigen Parameter bei reAPI, wie für beide GPT-6-Modelle dokumentiert[3][4]:
| Feld | Ergebnis bei gpt-6-luna und gpt-6-sol |
|---|---|
temperature, top_p, frequency_penalty, presence_penalty | 400, weglassen |
seed, stop, logprobs, verbosity | Akzeptiert (200), aber ohne Wirkung |
n | Nur 1; ein größerer Wert liefert 400 |
reasoning_effort | none, low, medium, high, xhigh, max; medium, wenn weggelassen |
response_format | Wird angewendet, einschließlich json_schema mit strict |
tools, tool_choice | tool_calls werden bei Effort medium ebenso zurückgegeben wie bei none |
Die Zeile zu tools weicht von OpenAIs eigener Regel für Chat Completions ab, die Function Calling nur bei reasoning_effort: "none" erlaubt[2]. Am Endpunkt von reAPI lieferten Tools in der Messung vom 2026-09-24 auch bei medium tool_calls zurück[3].
Was Sie statt temperature verwenden
Temperature steuerte die Zufälligkeit beim Sampling. GPT-6 Luna bietet dafür keinen direkten Ersatz. Wählen Sie also den Parameter, der zu dem passt, wofür Sie temperature eigentlich eingesetzt haben.
Sie wollten konsistente, parsebare Ausgaben. Verwenden Sie response_format mit einem JSON-Schema und strict: true. reAPI wendet das bei beiden GPT-6-Modellen an[3], und ein striktes Schema legt die Form der Antwort fest. Genau das wollten viele Einstellungen mit temperature: 0 erreichen.
Sie wollten schnellere oder günstigere Antworten. Senken Sie reasoning_effort. OpenAIs Reasoning-Leitfaden empfiehlt none für latenzkritische Aufgaben wie Klassifikation und schnelles Retrieval und low für Tool-Nutzung, Support-Workflows und Entwürfe[11]. Weniger Reasoning-Tokens bedeuten außerdem weniger abgerechnete Output-Tokens[3].
Sie wollten unterschiedliche Antworten. Weder seed noch n hilft hier bei reAPI. seed wird ohne Wirkung akzeptiert, und n ist auf 1 begrenzt[3]. Senden Sie separate Requests oder bitten Sie in einem Prompt um mehrere Alternativen.
Sie wollten einen anderen Stil. Schreiben Sie das in die System- oder Developer-Message. Sampling-Einstellungen waren schon immer ein grobes Werkzeug für den Tonfall, und die Anweisungen sind der einzige Hebel, der bleibt.
Die Felder in Python entfernen
Wenn ein gemeinsamer Helper oder eine Konfiguration Sampling-Standardwerte einschleust, entfernen Sie diese vor dem Aufruf, statt jeden Aufrufer anzupassen. Das folgende Beispiel nutzt das offizielle OpenAI SDK mit reAPI als Ziel, wie im Python-Beispiel von reAPI[3]:
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://reapi.ai/api/v1")

REJECTED = {"temperature", "top_p", "frequency_penalty", "presence_penalty"}

def gpt6_params(params: dict) -> dict:
    """Drop fields that gpt-6-luna and gpt-6-sol answer with 400."""
    return {k: v for k, v in params.items() if k not in REJECTED}

params = {"temperature": 0.2, "top_p": 0.9, "max_completion_tokens": 1000}

resp = client.chat.completions.create(
    model="gpt-6-luna",
    messages=[{"role": "user", "content": "Summarize this refund policy in two sentences."}],
    reasoning_effort="low",
    **gpt6_params(params),
)
print(resp.choices[0].message.content)
Wenn Sie nicht erkennen können, woher ein Feld stammt, loggen Sie beim Testen die Keys des final serialisierten Request-Bodys. Die Reports zu Phoenix und Langflow oben sind beide Fälle eines Standardwerts, den der Aufrufer nie selbst geschrieben hat[5][7].
FAQ
GPT-6 Luna API Temperature setzen auf GitHub
Die GitHub-Issues zu diesem Thema sind überwiegend Bugs in Tools, die temperature standardmäßig mitsenden. Die Bedrock-Komponente von Langflow sendet 0.7 und 0.9 für temperature und top_p[5], und der AWS-Playground von Phoenix sendet bei jedem Lauf temperature: 1[7]. Beide Reports berichten, dass der Request funktioniert, sobald die Felder entfernt sind. Die Lösung im eigenen Code ist dieselbe: Senden Sie temperature oder top_p nicht an GPT-6 Luna.
GPT-6 Luna API Temperature setzen in Python
Sie können sie nicht setzen. Lassen Sie temperature und top_p in client.chat.completions.create(...) weg und übergeben Sie stattdessen reasoning_effort. Bei reAPI liefern beide Felder 400[3]. Der Python-Helper oben filtert sie heraus, falls sie aus einer gemeinsamen Konfiguration kommen.
GPT-6 Luna API Temperature setzen Beispiel
Der korrigierte cURL-Request oben ist das Beispiel: model auf gpt-6-luna gesetzt, das messages-Array, reasoning_effort: "low" und max_completion_tokens: 1000, ohne temperature oder top_p. Er folgt den Feldregeln in der GPT-6-Luna-Doku von reAPI[3].
GPT-6 Luna API Name
Die Modell-ID für die API lautet gpt-6-luna. OpenAI führt sie sowohl als Modell-ID als auch als einzigen Snapshot, mit der Anweisung "Use gpt-6-luna in your API requests."[2] reAPI verwendet denselben String und behandelt ihn als eigenes Modell, getrennt von gpt-5.6-luna und gpt-6-sol[3]. Fehlermeldungen von Azure nennen außerdem eine Modellversion, gpt-6-luna-2026-09-22[10].
GPT-6 Luna API Reasoning auto
Einen Reasoning Effort auto gibt es nicht. OpenAI nennt für GPT-6 Luna none, low, medium, high, xhigh und max, mit medium als Standard[2]. Um den Standard des Modells zu erhalten, lassen Sie reasoning_effort ganz weg. OpenAIs Reasoning-Leitfaden verwendet auto zwar, aber für andere Einstellungen: Reasoning-Zusammenfassungen und das Feld reasoning.context[11].
GPT-6 Luna Azure
Das am häufigsten zitierte Azure-Problem betrifft nicht temperature. Ein Post auf Microsoft Q&A vom 29. September 2026 berichtet von Foundry-Agents, die mit "Unsupported parameter: 'reasoning.effort' is not supported with this model" scheitern[6]. Ein GitHub-Issue reproduziert das am Foundry-Projekt-Endpunkt: Einfache Aufrufe liefern dort 500 und Aufrufe mit Effort 400, während der Ressourcen-Endpunkt mit Reasoning Effort funktioniert. Der Workaround des Meldenden ist, den Ressourcen-Endpunkt aufzurufen, und das Issue war bei unserer Prüfung am 7. Oktober 2026 noch offen[8].
GPT-6 Sol welcher Effort
GPT-6 Sol akzeptiert dieselben sechs Werte wie Luna, mit medium als Standard[4][12]. OpenAIs allgemeine Empfehlung lautet: none für latenzkritische Aufgaben, low für Tool-Nutzung und Entwürfe, medium für die meisten Workloads, high für schwieriges Debugging und Planung und xhigh nur dann, wenn Evals die zusätzliche Latenz und die Kosten rechtfertigen[11]. Sol lehnt temperature und top_p bei reAPI genauso ab wie Luna[4].
GPT-6-Luna-Requests, die beim ersten Mal durchgehen
Ein sauberer GPT-6-Luna-Request hat als model den Wert gpt-6-luna, ein messages-Array, einen bewusst gewählten reasoning_effort und ein Output-Limit mit Platz für das Reasoning. Er enthält kein temperature, kein top_p und keine Penalty-Felder. Wenn Sie hierhergekommen sind, um bei der GPT-6 Luna API die Temperature zu setzen, lautet die Antwort: Hören Sie damit auf. Steuern Sie Kosten und Latenz über den Effort, die Form der Antwort über ein striktes JSON-Schema, und prüfen Sie, was Ihr Framework standardmäßig hinzufügt. Dieselbe Request-Form funktioniert auch für GPT-6 Sol. Die Parameter finden Sie in der GPT-6 Luna Doku und der GPT-6 Sol Doku, die aktuellen Preise auf den Modellseiten zu GPT-6 Luna und GPT-6 Sol.
References
- OpenAI. Using GPT-6. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/guides/latest-model
- OpenAI. GPT-6 Luna model page. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/models/gpt-6-luna
- reAPI. gpt-6-luna API documentation. Abgerufen im Oktober 2026 von reapi.ai/docs/gpt-6-luna
- reAPI. gpt-6-sol API documentation. Abgerufen im Oktober 2026 von reapi.ai/docs/gpt-6-sol
- Langflow on GitHub. Amazon Bedrock Converse: OpenAI GPT-6 Sol/Luna/Astra calls fail with 400 because Temperature and Top P are sent by default (#15349). Abgerufen im Oktober 2026 von github.com/langflow-ai/langflow/issues/15349
- Microsoft Q&A. GPT-6-Luna agents fail with Unsupported parameter: 'reasoning.effort' error. Abgerufen im Oktober 2026 von learn.microsoft.com/en-us/answers/questions/6018360
- Arize Phoenix on GitHub. Playground can't run OpenAI GPT-6 Sol/Luna/Astra on AWS Bedrock: default temperature=1 is always sent and rejected with 400 (#16430). Abgerufen im Oktober 2026 von github.com/Arize-ai/phoenix/issues/16430
- Azure SDK for Python on GitHub. azure-ai-projects: gpt-6-luna returns 500 on project endpoint, works on resource endpoint (#49169). Abgerufen im Oktober 2026 von github.com/Azure/azure-sdk-for-python/issues/49169
- redmine_ai_helper on GitHub. Chat fails with gpt-6 models (gpt-6-luna, gpt-6-sol): "Function tools with reasoning_effort are not supported" (#480). Abgerufen im Oktober 2026 von github.com/haru/redmine_ai_helper/issues/480
- Microsoft Agent Framework on GitHub. Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22 (#8718). Abgerufen im Oktober 2026 von github.com/microsoft/agent-framework/issues/8718
- OpenAI. Reasoning models. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/guides/reasoning
- OpenAI. GPT-6 Sol model page. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/models/gpt-6-sol
Weiterführende Artikel
- reAPI. GPT-6 Sol vs GPT-6 Luna. reapi.ai/blog/gpt-6-sol-vs-luna
- reAPI. GPT-6 Luna API pricing. reapi.ai/blog/gpt-6-luna-api-pricing
Autor

Kategorien
Weitere Beiträge
AI-Videokontinuität über mehrere Clips hinweg bewahren
Lerne, KI-Videos über mehrere Clips mit Zustandsregister, Grenzrahmen, Fortsetzungsprompts, API-Aufrufen, Prüfungen und Reparaturregeln zu erweitern.
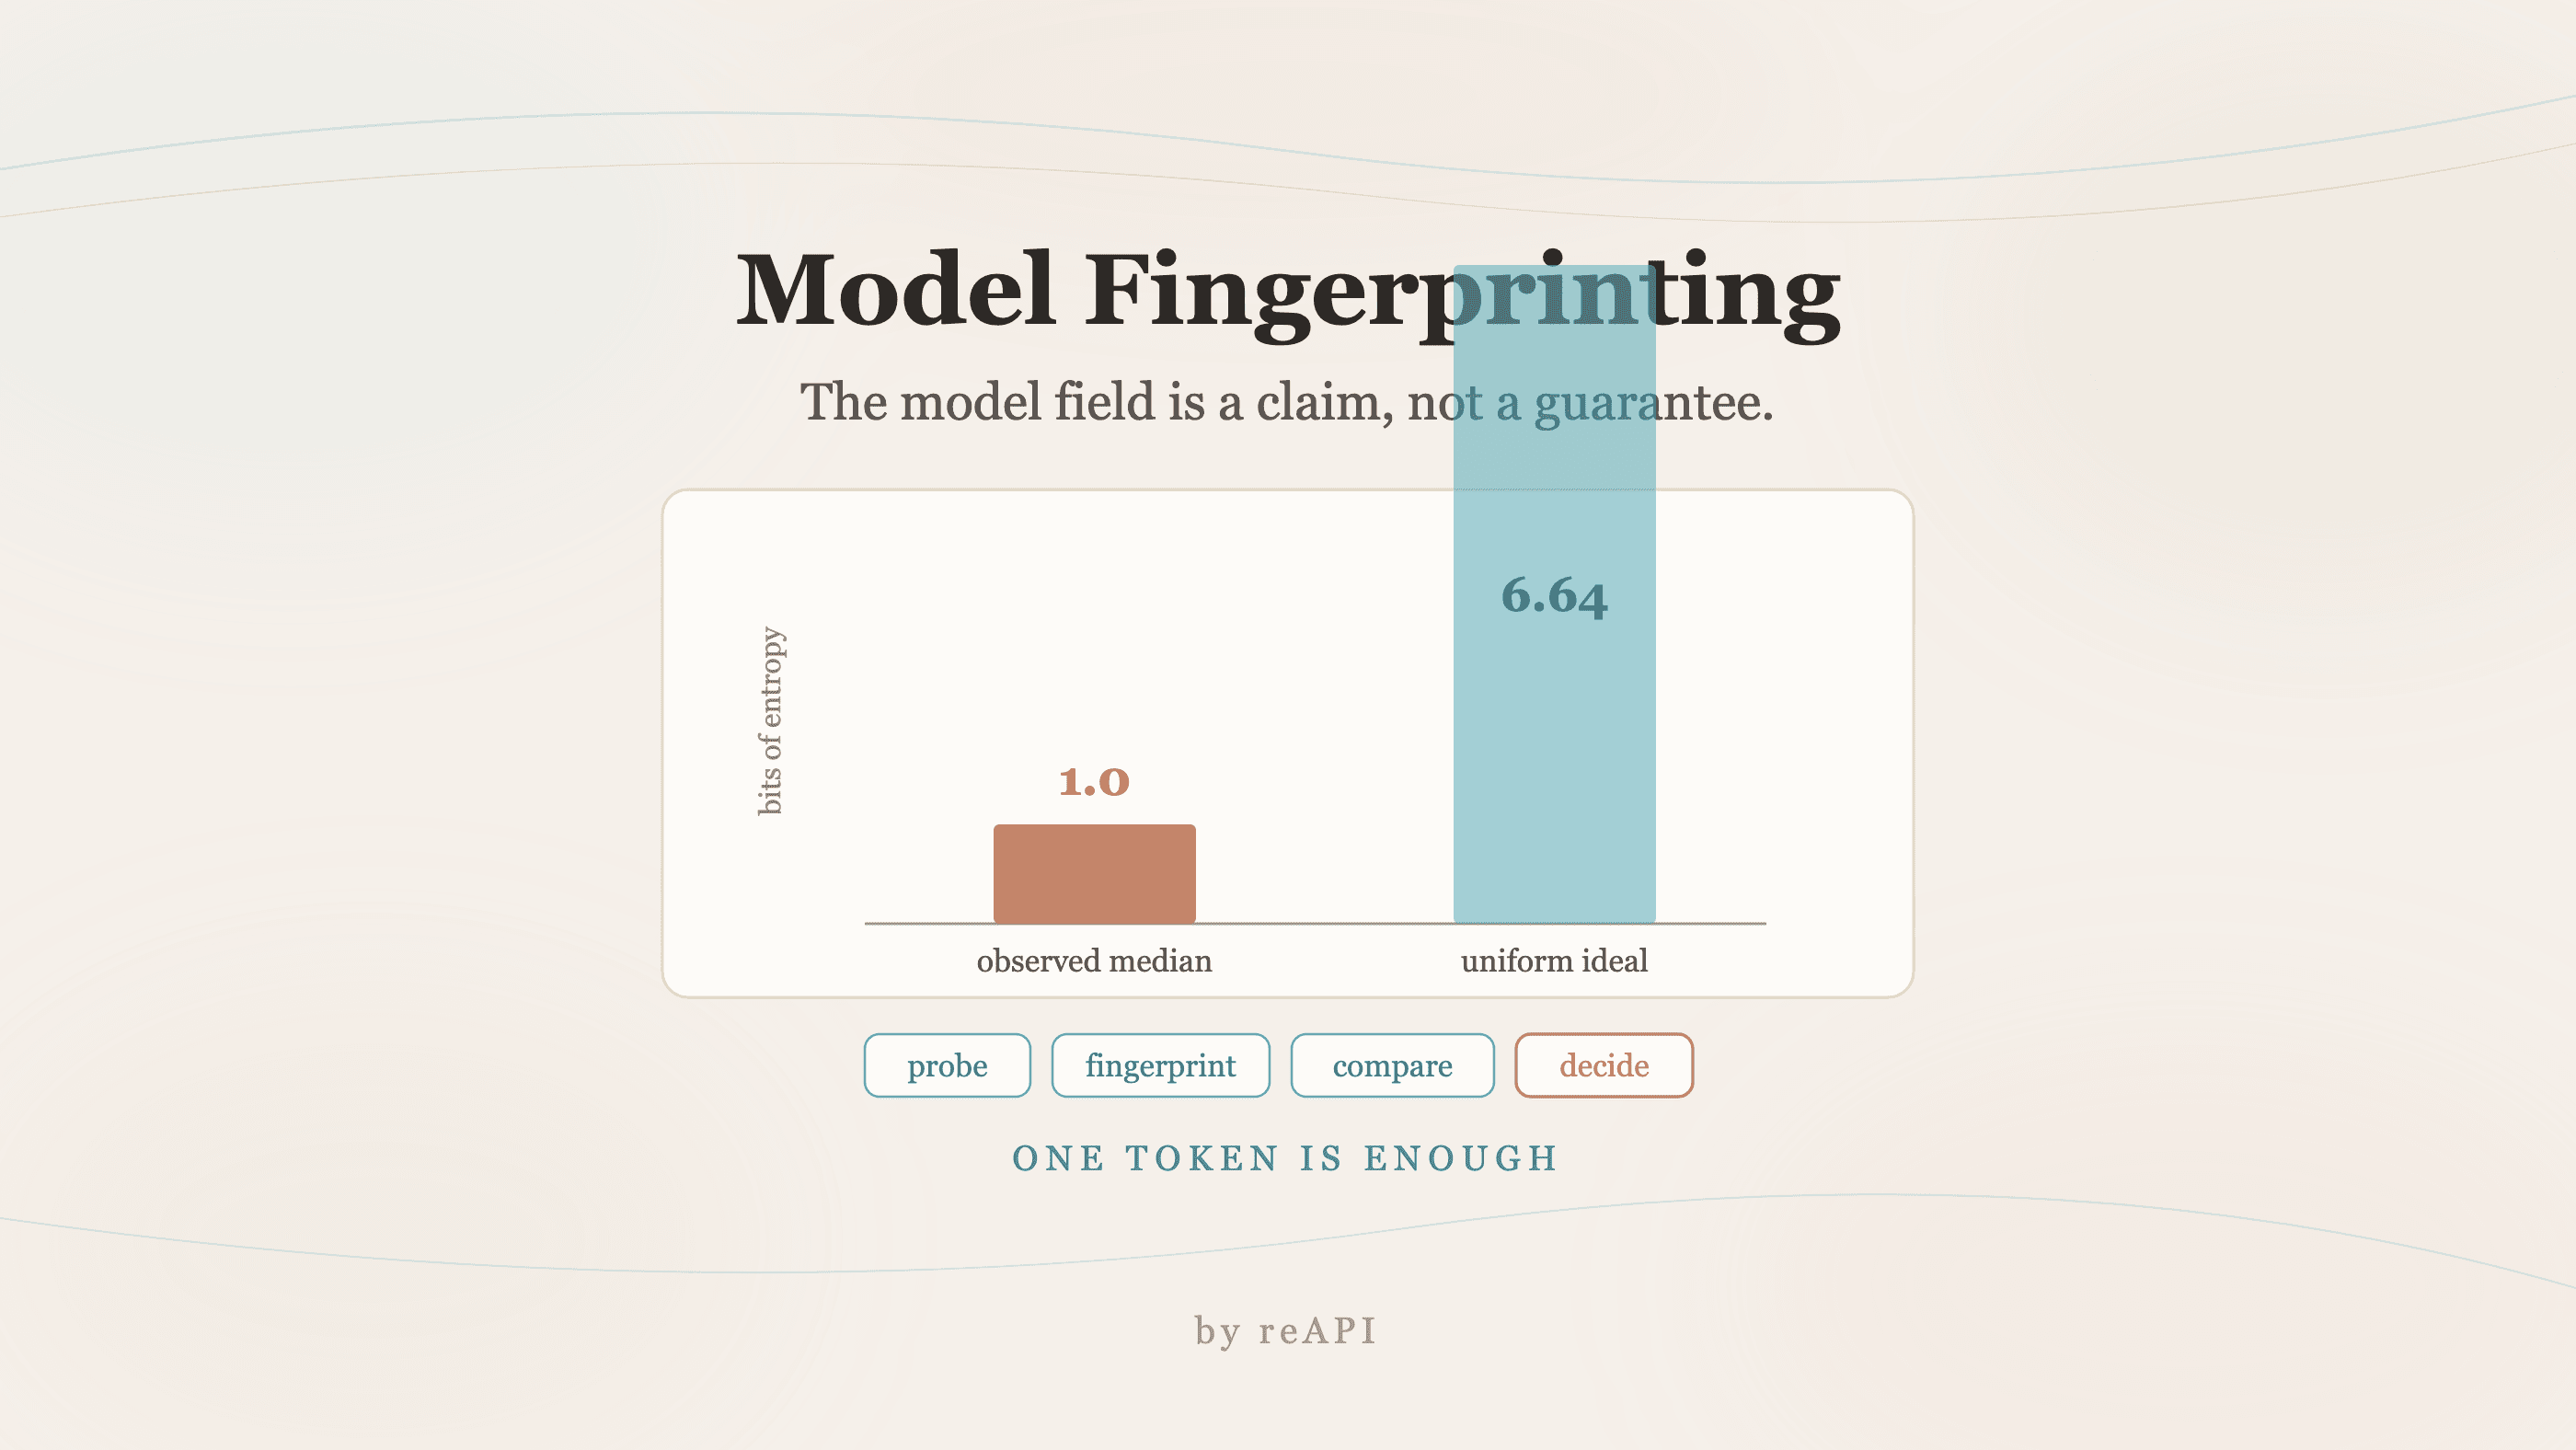
LLM API verifizieren: Modell-Fingerabdruck prüfen
Sprachmodelle können keine Zufallszahlen erzeugen. Dieser Fehler ist ein stabiler Fingerabdruck, um zu prüfen, welches Modell ein API-Endpoint bedient.
Wan 3.0 API Preise: 480P, 720P und 1080P Kosten
Vergleich der Wan-3.0-Preise zwischen reAPI und Alibaba Cloud, einschließlich Kostenberechnung für 5-, 10- und 30-Sekunden-Videos bei 480P, 720P und 1080P.