GPT-6 Luna API Preise: Token-Tarife und Kostenrechner
GPT-6 Luna API Preise laut OpenAI: Input, Output, Cache-Lese- und Schreibzugriffe, die 272K-Langkontextstufe, Batch und Fast, plus Kostenbeispiele.
Die Preise der GPT-6 Luna API beginnen im Standard-Tier von OpenAI bei $0.10 pro Million Input-Tokens und $0.50 pro Million Output-Tokens, den niedrigsten Tarifen der GPT-6-Reihe[1]. Diese beiden Zahlen sind allerdings nur ein Teil der Rechnung. Gecachter Input, Cache-Schreibzugriffe, ein eigener Tarif für Prompts über 272K Tokens und Reasoning-Tokens, die als Output abgerechnet werden, können die tatsächlichen Kosten verschieben.
Dieser Leitfaden listet jeden GPT-6-Luna-Tarif von der OpenAI-Preisseite auf (abgerufen am 7. Oktober 2026), erklärt, wie eine Anfrage bepreist wird, und rechnet fünf Kostenszenarien mit ausgeschriebenen Annahmen durch, damit Sie die Rechnung mit Ihren eigenen Token-Zahlen nachvollziehen können.
TL;DR
- Standard-Tarife pro 1M Tokens: $0.10 Input, $0.01 gecachter Input, $0.125 Cache-Schreibzugriffe, $0.50 Output[1].
- Über 272K Input-Tokens wechselt die gesamte Anfrage zu $0.20 Input, $0.02 gecachtem Input, $0.25 Cache-Schreibzugriffen und $0.75 Output[1][2].
- Batch und Flex kosten die Hälfte von Standard; Fast mode kostet das Doppelte; regionale Verarbeitung schlägt 10% auf[2].
- Reasoning-Tokens werden als Output abgerechnet, daher ist der Reasoning-Effort nach dem Volumen der größte Hebel[3].
- Eine kurze Anfrage ist günstig: 500 Input- und 10 Output-Tokens kosten zu Standard-Tarifen $0.000055, also $55 pro Million solcher Anfragen (unsere Rechnung, siehe unten).
- Im Vergleich zum Rest von GPT-6: Die Standard-Tarife von Astra betragen genau das 100-Fache von Luna, Input und Output von GPT-6 Sol das 20-Fache[1].
GPT-6 Luna API Preise für jeden Token-Typ
OpenAI bepreist GPT-6 Luna nach Token-Typ und nach Prompt-Länge. „Short context“ reicht bis 272K Input-Tokens; darüber gelten die Langkontext-Tarife für die gesamte Anfrage[1].
| Pro 1M Tokens (Standard) | Bis 272K Input | Über 272K Input |
|---|---|---|
| Input | $0.10 | $0.20 |
| Gecachter Input | $0.01 | $0.02 |
| Cache-Schreibzugriffe | $0.125 | $0.25 |
| Output | $0.50 | $0.75 |
Quelle: OpenAI API pricing, Standard-Tier[1].
Die Modellseite nennt die Multiplikatoren hinter diesen Zahlen. Gecachter Input kostet 10% des ungecachten Input-Tarifs, Cache-Schreibzugriffe das 1.25-Fache davon, und Prompts mit mehr als 272K Input-Tokens werden laut OpenAI „für die gesamte Anfrage mit dem 2-Fachen der Input- und Cache-Tarife und dem 1.5-Fachen des Output-Tarifs berechnet“[2].
Batch, Flex, Fast und regionale Verarbeitung
Das Processing-Tier ändert jeden Tarif um einen festen Faktor. Auf der Modellseite von OpenAI heißt es: „Batch und Flex werden mit 50% der Standard-Tarife berechnet. Fast mode wird mit dem 2-Fachen der jeweils geltenden Tarife berechnet“, und regionale Verarbeitung „schlägt, wo verfügbar, 10% auf“[2].
| Pro 1M Tokens, bis 272K Input | Input | Gecachter Input | Cache-Schreibzugriffe | Output |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Quelle: OpenAI API pricing, Tabellen für Standard, Batch, Flex und Fast[1].
Batch eignet sich für Offline-Jobs wie nächtliche Klassifizierung oder Backfills. Fast mode ist die Option von OpenAI für latenzkritischen Traffic, und laut OpenAI ist er für GPT-6 Luna nicht mit EU-Datenresidenz verfügbar[4].
Wie eine GPT-6-Luna-Anfrage bepreist wird
Für einen Prompt mit 272K Input-Tokens oder weniger, zu Standard-Tarifen:
cost = ( uncached_input × 0.10
       + cached_input   × 0.01
       + cache_write    × 0.125
       + output         × 0.50 ) / 1,000,000
Über 272K Input-Tokens setzen Sie für die gesamte Anfrage 0.20, 0.02, 0.25 und 0.75 ein. Vier Regeln entscheiden, in welchem Topf jedes Token landet.
Reasoning-Tokens sind Output. Laut OpenAI „belegen Reasoning-Tokens Platz im Kontextfenster des Modells und werden als Output-Tokens abgerechnet“[3]. GPT-6 Luna unterstützt sechs Effort-Stufen, von none bis max, mit medium als Standard[2]. Hinter einem Klassifizierungslabel aus zwei Wörtern können Hunderte abgerechnete Reasoning-Tokens stecken.
Cache-Gebühren ersetzen den Input-Tarif, statt hinzuzukommen. Der Caching-Leitfaden von OpenAI sagt, die Bepreisung von Cache-Schreibzugriffen „ist keine zusätzliche Gebühr: Input-Tokens verwenden den Tarif für ungecachten Input, gecachten Input oder Cache-Schreibzugriffe“[5].
Kurze Präfixe werden nie gecacht. Die minimale cachebare Prompt-Länge beträgt 1,024 Tokens für GPT-5.6 und neuere Modelle, und ein gecachtes Präfix bleibt nach dem letzten Schreibzugriff oder der letzten Wiederverwendung mindestens 30 Minuten nutzbar[5].
Die 272K-Grenze gilt pro Anfrage. Ein einzelner Prompt mit 300K Input-Tokens wird vollständig zu Langkontext-Tarifen abgerechnet, einschließlich Output[2].
GPT-6 Luna API Kostenrechner: fünf durchgerechnete Beispiele
Jede Zeile unten verwendet die oben genannten Listentarife von OpenAI. Die Token-Zahlen sind zur Veranschaulichung gewählte Annahmen, keine Messwerte. Ersetzen Sie sie durch Zahlen aus dem usage-Objekt Ihrer eigenen Antworten.
| Szenario | Annahmen | Rechnung | Gesamt |
|---|---|---|---|
A. Ticket-Tagging, Effort none | 1,000,000 Anfragen × 500 Input, 10 Output | 500M × $0.10 + 10M × $0.50 = $50 + $5 | $55.00 |
B. Gleicher Job, Effort medium | Wie A, plus angenommene 300 Reasoning-Tokens pro Anfrage | 500M × $0.10 + 310M × $0.50 = $50 + $155 | $205.00 |
| C. Szenario A über Batch | Wie A, zu Batch-Tarifen | 500M × $0.05 + 10M × $0.25 = $25 + $2.50 | $27.50 |
| D. Support-Assistent mit gecachtem Präfix | 100,000 Anfragen; stabiles Präfix mit 4,000 Tokens, 1,000-mal geschrieben und 99,000-mal gelesen; je 1,000 neue Input- und 400 Output-Tokens | 396M × $0.01 + 4M × $0.125 + 100M × $0.10 + 40M × $0.50 = $3.96 + $0.50 + $10 + $20 | $34.46 |
| E. Lange Dokumente | 1,000 Anfragen × 400,000 Input, 2,000 Output (Langkontext-Tier) | 400M × $0.20 + 2M × $0.75 = $80 + $1.50 | $81.50 |
Drei Erkenntnisse fallen auf.
Der Effort kostet hier mehr als das Volumen. In B macht der angenommene Reasoning-Durchlauf die Output-Tokens zum größeren Posten, und der Job kostet das 3.7-Fache von Szenario A. Prüfen Sie, ob none oder low Ihr Genauigkeitsziel erreicht, bevor Sie für medium bezahlen.
Caching halbiert Szenario D. Ohne Cache kostet derselbe Traffic 500M × $0.10 + 40M × $0.50 = $70.00. Cache-Lesezugriffe senken die Kosten für das Präfix von $40 auf $4.46, Schreibzugriffe eingerechnet.
Die 272K-Grenze verdoppelt den Input. Ließe sich jedes Dokument in E in zwei Anfragen mit je 200,000 Tokens und je 2,000 Output-Tokens aufteilen, läge die Rechnung bei 400M × $0.10 + 4M × $0.50 = $42.00. Das Aufteilen ändert, was das Modell auf einmal sieht. Prüfen Sie daher die Qualität, bevor Sie der Ersparnis nachjagen.
GPT-6 Luna Preise im Vergleich mit anderen GPT-Modellen
Alle Standard-Tarife pro 1M Tokens für Prompts bis 272K Input-Tokens[1]:
| Modell | Input | Gecachter Input | Cache-Schreibzugriffe | Output |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 |
OpenAI führt den niedrigen Preis von Luna auf „Verbesserungen bei Caching und Inferenz“ zurück, die als Senkung gegenüber den GPT-5.6-Preisen weitergegeben werden[6]. Die Abwägungen zwischen den Modellen behandeln GPT-6 Luna vs 5.6 Luna und GPT-6 Sol vs Luna; die Tarife von Sol selbst stehen in GPT-6 Sol pricing.
GPT-6 Luna über reAPI bezahlen
reAPI stellt GPT-6 Luna auf seinem Chat-Completions-Endpunkt mit der Modell-ID gpt-6-luna bereit, abgerechnet pro Token aus Ihrem reAPI-Guthaben. Input, Output, Cache-Lesezugriffe und Cache-Schreibzugriffe haben jeweils einen eigenen Tarif, Reasoning-Tokens werden als Output abgerechnet, und Prompts über 272K Input-Tokens bepreisen die gesamte Anfrage neu[7]. Das usage-Objekt jeder Antwort meldet prompt_tokens, completion_tokens (einschließlich Reasoning) und cached_tokens, sodass Sie die Rechnung mit der obigen Formel abgleichen können[7].
Die aktuellen Token-Tarife von reAPI und ein Kostenrechner für Input- und Output-Tokens finden Sie auf der GPT-6 Luna Modellseite. Ein Hinweis zur Form der Anfrage: Wenn Sie temperature an GPT-6 Luna senden, erhalten Sie 400; Details dazu in GPT-6 Luna temperature.
FAQ
Wie viel kostet chat gpt 6?
In der API wird GPT-6 pro Token und pro Modell bepreist: GPT-6 Luna mit $0.10 Input und $0.50 Output pro 1M Tokens, GPT-6 Sol und GPT-6.1 Sol mit $2 und $10 und GPT-6 Astra mit $10 und $50[1]. In ChatGPT hat OpenAI GPT-6 Sol und Luna für Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer freigegeben, und Free- und Go-Nutzer können GPT-6 Luna in der Desktop-App verwenden[6].
gpt 6 luna Preis für 10000 Tokens
Zu Standard-Tarifen kosten 10,000 Input-Tokens $0.001 und 10,000 Output-Tokens $0.005[1]. Wären diese 10,000 Input-Tokens Cache-Lesezugriffe, würden sie $0.0001 kosten.
gpt 6 luna Kosten für Output-Tokens
Output kostet zu Standard-Tarifen $0.50 pro 1M Tokens für Prompts bis 272K Input-Tokens und darüber $0.75[1]. Reasoning-Tokens sind im abgerechneten Output enthalten[3].
gpt 6 luna Preisrabatt
OpenAI nennt zwei: Batch und Flex zu 50% der Standard-Tarife sowie gecachten Input zu 10% des ungecachten Input-Tarifs[2]. Fast mode und regionale Verarbeitung wirken in die andere Richtung, mit 2x und +10%.
gpt 6 luna kostenlos
In der API wird GPT-6 Luna pro Token zu den obigen Tarifen abgerechnet[1]. In ChatGPT können laut OpenAI Free- und Go-Nutzer GPT-6 Luna in der Desktop-App nutzen[6].
gpt 6 luna API Kosten vs gpt 6 astra
Die Standard-Tarife von GPT-6 Astra liegen bei $10 Input, $1 gecachtem Input, $12.50 Cache-Schreibzugriffen und $50 Output pro 1M Tokens, also genau beim 100-Fachen jedes GPT-6-Luna-Tarifs[1]. Astra bietet außerdem ein Ultrafast-Tier zu höheren Preisen an; Luna erscheint in dieser Tabelle nicht[1].
Wie viel kostet eine GPT API?
Das hängt vom Modell ab. In der aktuellen Standard-Tabelle von OpenAI reichen die Tarife von $0.10 Input und $0.50 Output pro 1M Tokens bei GPT-6 Luna bis zu $30 Input und $180 Output bei GPT-5.5 Pro und GPT-5.4 Pro[1].
GPT-6-Luna-Kosten planbar halten
Der Großteil einer GPT-6-Luna-Rechnung wird durch drei Entscheidungen bestimmt: den Reasoning-Effort, den Sie senden, ob Ihr stabiles Prompt-Präfix lang genug zum Cachen ist und ob ein einzelner Prompt 272K Input-Tokens überschreitet. Messen Sie jeden dieser Punkte anhand echter usage-Daten an einer Stichprobe Ihres Traffics und setzen Sie die Werte in die Formel ein. Damit lassen sich die Preise der GPT-6 Luna API leicht vorhersagen: $0.10 rein, $0.50 raus, und jede Ausnahme ist dokumentiert.
References
- OpenAI. API pricing. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/pricing
- OpenAI. GPT-6 Luna model page. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI. Reasoning models. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/guides/reasoning
- OpenAI. Fast mode. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/guides/fast-mode
- OpenAI. Prompt caching. Abgerufen im Oktober 2026 von developers.openai.com/api/docs/guides/prompt-caching
- OpenAI. Introducing GPT-6 Sol and Luna. Abgerufen im Oktober 2026 von openai.com/index/introducing-gpt-6-sol-and-luna
- reAPI. GPT-6 Luna API docs. Abgerufen im Oktober 2026 von reapi.ai/docs/gpt-6-luna
Autor

Kategorien
Weitere Beiträge
Günstigstes Seedance 2.5 2026: Vergleiche echte API-Kosten
Vergleiche Seedance 2.5 nach Auflösung: aktuelle API-Tarife, Kosten für 10 Sekunden, Referenzvideo-Abrechnung und Credit-Limits der Abonnements.
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Benchmarks
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 in allen 18 Benchmarks aus Googles Tabelle, dazu Output-Limits, Preise und welches Modell für welche Aufgabe.
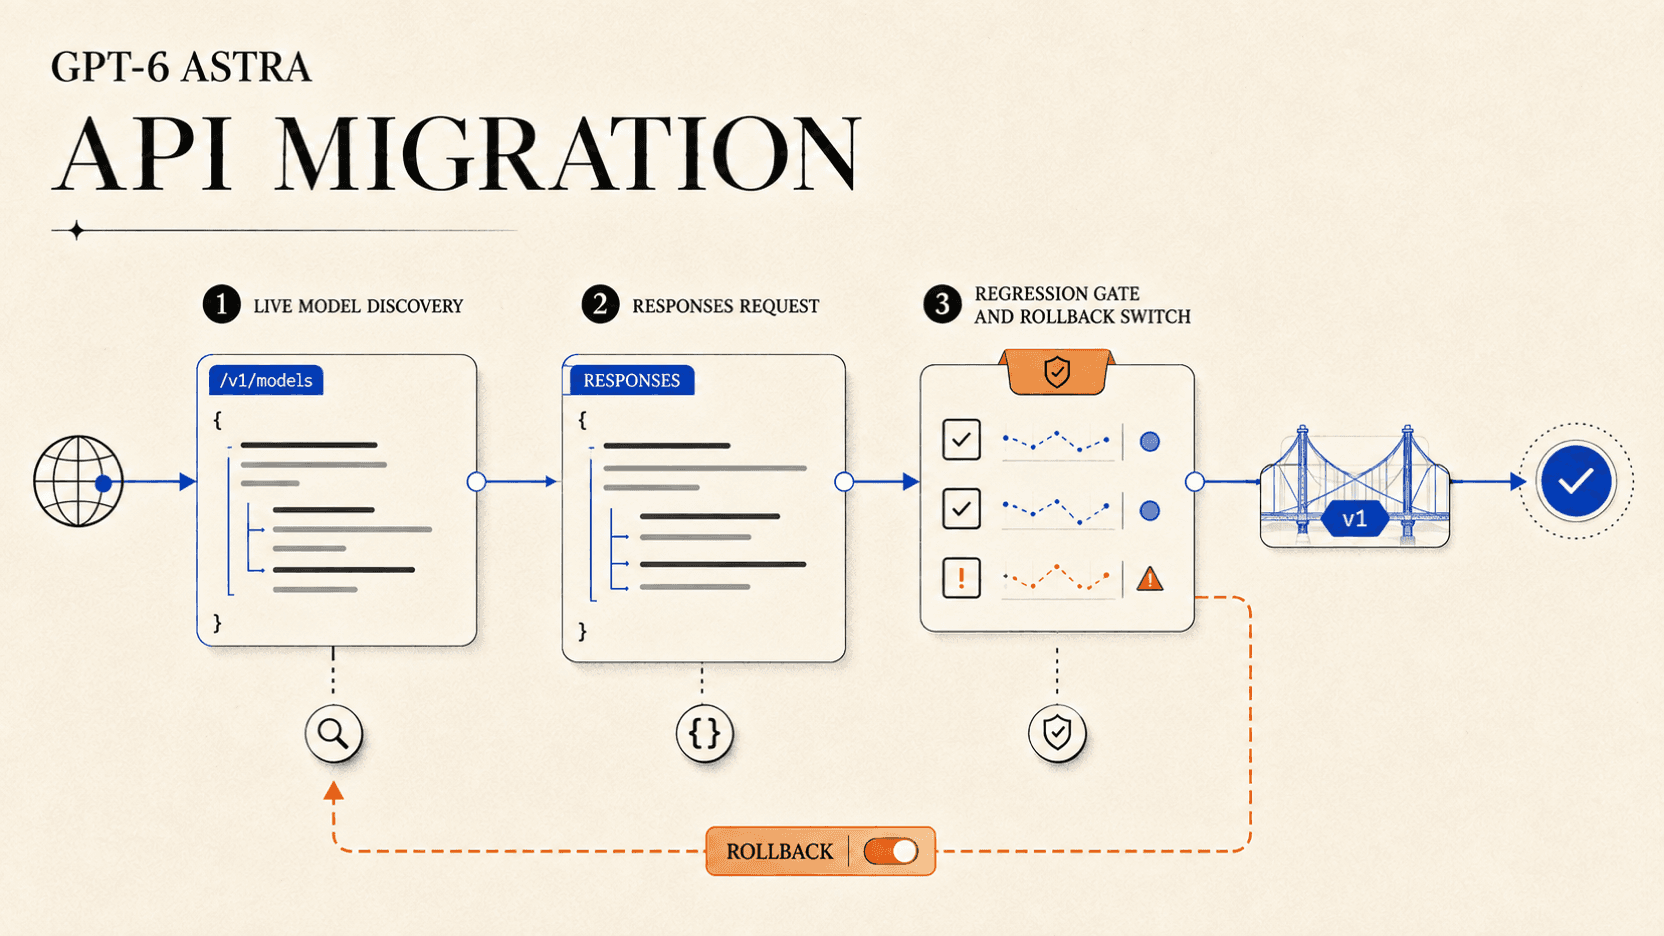
GPT-6-Astra-API-Migration: Responses, Tools und Rollback
Migration zur GPT-6-Astra-API: Model-Discovery, Responses-API-Integration, Reasoning-Level-Steuerung, Tool-Validierung, Akzeptanzgates und Rollback.