· reAPI Team
Gemini 4 Argon vs Opus 5.5: Der umstrittene virale Test
Gemini 4 Argon vs Opus 5.5: Der Gummibärchen-Test wurde hinterfragt. Was Originaldemo, gemeldete Wiederholungen und Antworten des Autors tatsächlich zeigen.
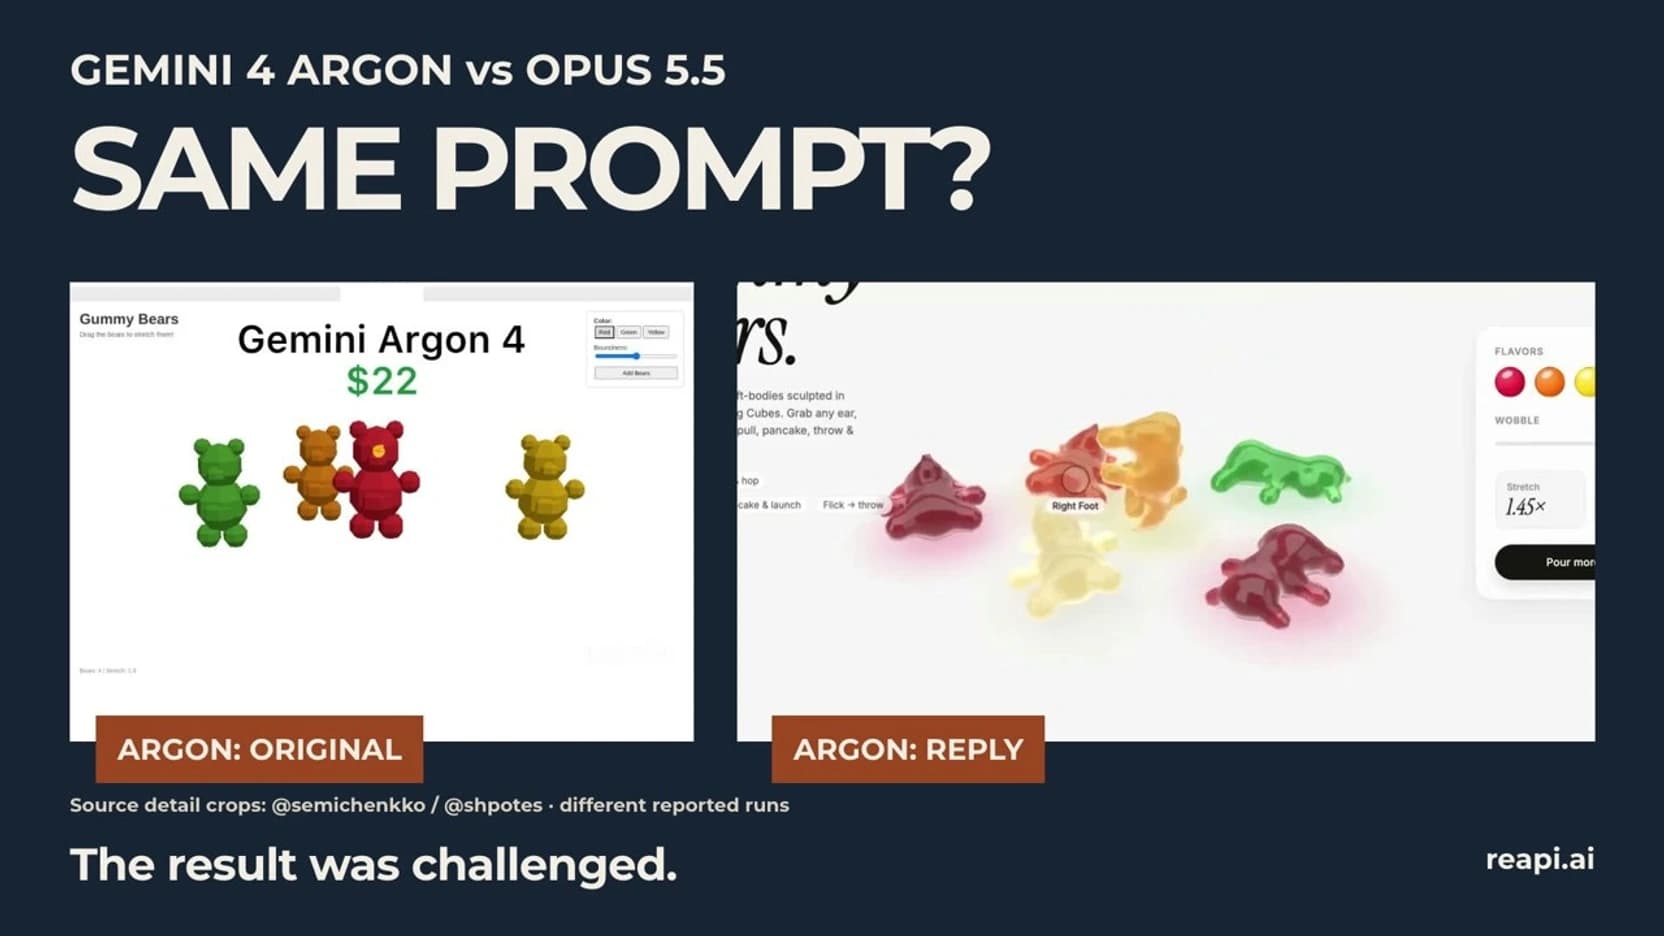
Eine Gummibärchen-Simulation machte Gemini 4 Argon vs Opus 5.5 zum Streit darüber, wie viel eine Coding-Demo beweisen kann. In einem von Semichenko veröffentlichten Vergleich ließ sich das als Claude Opus 5.5 gekennzeichnete Ergebnis überzeugender dehnen und zusammendrücken als das mit der Kennzeichnung Gemini 4 Argon. Laut dem Autor erhielten beide denselben Prompt[1]. Ein anderer Entwickler veröffentlichte anschließend ein sichtbar anderes Argon-Ergebnis und gab ebenfalls an, diesen Prompt verwendet zu haben[2].
Die Reaktion darauf ist ebenso wichtig wie der ursprüngliche Clip: Semichenko räumte ein, dass der Gemini-Durchlauf möglicherweise fehlgeschlagen sei und weitere Tests nötig seien[3]. Die verfügbaren Beiträge dokumentieren eine Auseinandersetzung über einzelne Ergebnisse. Eine allgemeine Rangfolge der Modelle bleibt offen. Wir ordnen die Belege und die Antwort des Autors ein und zeigen, wie sich der nächste Vergleich sinnvoll beurteilen lässt.
Kurzfassung
- Semichenkos ursprünglicher Beitrag zeigt zwei interaktive Gummibärchen-Simulationen und gibt an, dass ein identischer Prompt verwendet wurde. Der auffällige visuelle Unterschied betrifft diese berichteten Durchläufe[1].
- @shpotes berichtet von einem anderen Ergebnis mit Argon in Antigravity. Dieses Beispiel stellt den Schluss infrage, der erste Clip belege die Grenzen von Argon[2].
- Der ursprüngliche Autor hielt einen fehlgeschlagenen Gemini-Durchlauf ausdrücklich für möglich und sprach sich für weitere Tests aus[3].
- In einer weiteren Antwort schlug der Autor vor, beim nächsten Mal für jedes Modell den besten von drei Versuchen auszuwählen. Das war ein Methodenvorschlag, kein bereits durchgeführter neuer Vergleich[4].
- Unser begleitendes Video bespricht diese Beispiele Dritter. reAPI hat weder einen neuen kontrollierten Benchmark durchgeführt noch die vollständigen Testumgebungen und angegebenen Kosten unabhängig überprüft[5].
Den Vergleich und die Reaktionen ansehen
Unser Video mit einer Länge von 2 Minuten und 18 Sekunden zeigt die ursprüngliche Demonstration, den berichteten Wiederholungsversuch und die Antworten des Autors. Es ergänzt diese Analyse; die Quellen sind in der Videobeschreibung angegeben[5].
Spring direkt zur ursprünglichen Demonstration bei 0:19, zum berichteten Wiederholungsversuch bei 0:46 oder zur Antwort des Autors bei 1:11.
Die Aufnahmen zeigen das Ergebnis von Code, der eine interaktive Simulation erzeugt. Entsprechend ist dies als Programmieraufgabe zu bewerten. Eine Aufnahme der entstandenen Animation macht daraus keinen Vergleich von Text-zu-Video-Modellen. Das Titelbild oben ist das Vorschaubild unseres Videos. Die berichteten Ergebnisse kannst du im Video und in den verlinkten Originalbeiträgen prüfen.
Was die Demo zu Gemini 4 Argon vs Opus 5.5 zeigte
Im ursprünglichen Beitrag ist Opus über Argon angeordnet. Beschrieben wird eine Reihe von Interaktionen: ziehen, zusammendrücken, werfen und weitere Bären hinzufügen. Die Kritik verbindet die Verformung der Objekte, ihre Interaktion miteinander und das Aussehen des Materials[1].
Diese Aspekte lassen sich sinnvoll getrennt prüfen. Bei dieser Aufgabe würden wir bewerten, ob sich ein Bär beim Ziehen verformt, ob er nach dem Loslassen seine Form wieder annimmt, ob eine Szene mit vielen Objekten bedienbar bleibt und ob seine Oberfläche dem gewünschten Material ähnelt. Das sind vorgeschlagene Bewertungskriterien, keine Messungen, die wir an den zugrunde liegenden Anwendungen vorgenommen haben.
Durch diese Trennung entscheidet eine ansprechende Oberfläche nicht allein über den gesamten Coding-Vergleich. Man kann die Beleuchtung bevorzugen und trotzdem noch die Interaktionen prüfen müssen. Umgekehrt kann ein optisch weniger ausgefeiltes Objekt eine funktionale Anforderung erfüllen. Lege fest, welche Anforderungen zählen, bevor du einen Clip zum Sieger erklärst.
Außerdem besteht ein Unterschied zwischen der Bewertung des gezeigten Ergebnisses und der Erklärung seiner Ursache. Eine Aufnahme kann eine eng begrenzte Beobachtung dessen belegen, was auf dem Bildschirm zu sehen ist. Um die Ursache zu bestimmen, wären die Anweisungen, das generierte Projekt, der Ausführungsverlauf und die Einstellungen nötig. Uns liegt für die beiden ursprünglichen Durchläufe keine vollständige, vergleichbare Dokumentation vor. Deshalb können wir das Modell nicht als alleinige Ursache des Unterschieds bestimmen.
Wie die berichteten Wiederholungen die Diskussion veränderten
@shpotes beschrieb das eigene Ergebnis so, übersetzt: „Derselbe Prompt ergab mit Argon + Antigravity ein radikal anderes Ergebnis.“ Die angehängte Demonstration zeigt Dehnung und Verformung bei dem Argon zugeschriebenen Ergebnis[2]. Damit haben Zuschauer einen konkreten Grund zu hinterfragen, ob das erste Ergebnis repräsentiert, was Argon bei dieser Aufgabe erzeugen kann.
Ein separater Beitrag von @Caxvalencia trägt die Kennzeichnung „Argon - Medium“ und enthält ein weiteres Interaktionsbeispiel[6]. Diese Kennzeichnung gibt die vom Autor berichtete Einstellung wieder. Sie belegt nicht unabhängig, dass die Anweisungen, die Ausgangsdateien oder die Reihenfolge der Werkzeugaufrufe identisch waren.
| Öffentlicher Beleg | Sein Beitrag zur Einordnung | Was hier ungeprüft bleibt |
|---|---|---|
| Semichenkos ursprünglicher Vergleich | Ein sichtbarer Unterschied zwischen zwei gekennzeichneten Ergebnissen; die Angabe, denselben Prompt verwendet zu haben | Vollständige, vergleichbare Ausführungsprotokolle beider Durchläufe |
| Der Folgebeitrag von @shpotes | Ein nach eigener Angabe mit demselben Prompt erzieltes Argon-Ergebnis in Antigravity | Gleichheit der gesamten Testumgebung mit dem ursprünglichen Vergleich |
| Das Beispiel von @Caxvalencia | Ein weiteres Argon zugeordnetes Interaktionsbeispiel mit der Kennzeichnung Medium | Ein vollständig übereinstimmendes Wiederholungsprotokoll |
| Semichenkos Antworten | Anerkennung der Unsicherheit und der Vorschlag, den besten von drei Versuchen auszuwählen | Ergebnisse eines abgeschlossenen Vergleichs nach diesem Vorschlag |
Quellen: die Originalbeiträge und Antworten[1][2][3][4][6].
Der ursprüngliche Beitrag enthält außerdem eine Community Note, die auf Wiederholungsversuche verweist[1]. Folge diesen Links und prüfe die dortigen Belege. Eine solche Notiz liefert zusätzlichen Kontext; ihre Aussagen müssen weiterhin anhand der zugrunde liegenden Quellen geprüft werden.
Wenn man die Folgebeiträge als zutreffend annimmt, schwächen sie die pauschale Behauptung, Argon könne keine verformbaren Bären erzeugen. Sie belegen weder, wie häufig die beiden Modelle erfolgreich sind, noch, wie viele Eingriffe jeweils nötig sind oder welches Modell bei einer anderen Programmieraufgabe besser abschneidet. Ein überzeugendes Gegenbeispiel kann eine absolute Behauptung infrage stellen, ohne eine allgemeine Rangfolge zu begründen.
Die Antwort des Autors gehört zur Darstellung
Semichenko schrieb, übersetzt: „Hm, vielleicht ist mein Gemini-Durchlauf fehlgeschlagen. Ich muss mehr testen“[3]. In einer früheren Antwort bedankte er sich bei einem anderen Tester und schlug vor, für einen künftigen Vergleich bei jedem Modell den besten von drei Versuchen zu verwenden[4].
Diese Antwort grenzt den Streit ein. Man muss weder so tun, als sei der ursprüngliche visuelle Unterschied verschwunden, noch liefern diese Beiträge eine Grundlage dafür, dem Autor Täuschungsabsicht zuzuschreiben. Er hat Unsicherheit über den Durchlauf eingeräumt. Leser sollten diese Einordnung zusammen mit dem Clip sehen, den sie beurteilen sollen.
Die Auswahl des besten von drei Versuchen würde eine bestimmte Frage beantworten: Wie gut kann das Ergebnis jedes Modells innerhalb von drei Versuchen unter den gewählten Regeln werden? Würde nur der beste Versuch gezeigt, bliebe die Zuverlässigkeit beim ersten Anlauf weiterhin offen. Bei einem künftigen Test würden wir alle Versuche veröffentlichen und den ausgewählten kennzeichnen, damit sowohl das stärkste Ergebnis als auch die Fehlschläge überprüfbar bleiben.
So lassen sich die Coding-Ergebnisse sinnvoller vergleichen
Die folgenden Punkte sind ein redaktioneller Testvorschlag. Wir haben ihn nicht durchgeführt, und er rekonstruiert nicht die privaten Sitzungen der Autoren. Er soll helfen, das nächste Ergebnis besser einzuordnen.
Den vollständigen Ausgangspunkt sichern. Bewahre den exakten Prompt, Anhänge, das Ausgangsprojekt und zusätzliche Anweisungen auf. Wenn der Test in einem leeren Verzeichnis beginnt, halte das fest. Ein Prompt, der in ein anderes Projekt kopiert wird, belegt allein noch keinen gleichwertigen Kontext für beide Modelle.
Umgebung und Einstellungen dokumentieren. Nenne das Modell, die Anwendung oder den Coding-Agenten, die verfügbaren Werkzeuge und die tatsächlich verwendeten Einstellungen. Sichere nach Möglichkeit die Anfrage oder das Sitzungsprotokoll. Kennzeichne eine unbekannte Einstellung als unbekannt, statt sie aus der Qualität des Ergebnisses abzuleiten. Dass im Folgebeitrag Antigravity genannt wird, ist eine nützliche Information. Sie ersetzt jedoch keine fehlenden Angaben zu den anderen Sitzungen.
Die Versuchsregeln vorab festlegen. Entscheide, ob erste Versuche, eine feste Anzahl an Versuchen oder die Fertigstellung innerhalb eines festgelegten Budgets verglichen werden. Wende dieselben Regeln für Eingriffe an. War bei einem Ergebnis ein Korrektur-Prompt nötig, veröffentliche ihn und rechne den zusätzlichen Aufwand ein, statt die fertige Anwendung als unveränderte erste Antwort darzustellen.
Dieselben Interaktionen prüfen. Lege für diese Gummibärchen-Aufgabe eine wiederholbare Abfolge fest: an einem Arm oder Bein ziehen, loslassen, den Körper zusammendrücken, einen Bären gegen einen anderen bewegen und mehrere Objekte hinzufügen. Dokumentiere, welche geforderte Interaktion funktioniert, wo sie scheitert und ob die Anwendung bedienbar bleibt. Dies ist eine vorgeschlagene Abnahme-Checkliste, keine Aussage darüber, ob die gezeigten Simulationen physikalisch korrekte Materialien umsetzen.
Qualität und Kosten zunächst getrennt bewerten. Der ursprüngliche Clip enthält Kostenangaben des Autors. Wir haben weder die Abrechnungsbelege noch den vollständigen dahinterstehenden Aufwand unabhängig geprüft[5]. Halte bei deinem eigenen Test Verbrauch und Kosten jedes berücksichtigten Versuchs fest und vergleiche den Aufwand anschließend anhand derselben Abnahmekriterien. Auch ein fehlgeschlagener Versuch gehört in die Bewertungsdokumentation.
Wenn du eine Bewertung über reAPI durchführen möchtest, findest du auf der Modellseite zu Gemini 4 Argon und der Modellseite zu Claude Opus 5.5 die aktuellen Modellinformationen und Preise. Diese Seiten sind Ausgangspunkte für deinen eigenen Aufbau. Sie bilden nicht die Werkzeuge oder Sitzungen aus den Social-Media-Beiträgen nach.
Für die separate Frage nach veröffentlichten Modell-Benchmarks lies unseren Vergleich von Gemini 4 Argon, GPT-6 Astra und Claude Opus 5.5. Er behandelt eine auf einen bestimmten Zeitpunkt bezogene Benchmark-Tabelle der Anbieter. Dieser Artikel untersucht die konkrete Auseinandersetzung um die Gummibärchen-Simulation.
FAQ
Hat der virale Test bewiesen, dass Opus 5.5 besser programmiert?
Er zeigt ein Ergebnis, das in diesem konkreten visuellen Vergleich für Opus spricht. Die von uns geprüften Beiträge enthalten keine kontrollierte, wiederholte Auswertung, die einen allgemeinen Vorteil beim Programmieren belegt[1][3].
Wurde beim Argon-Wiederholungsversuch derselbe Prompt verwendet?
@shpotes sagt das ausdrücklich. Es handelt sich um eine Aussage dieser Quelle. Wir haben nicht unabhängig überprüft, ob sämtliche Prompt-Inhalte, der umgebende Kontext, die Einstellungen und die Ausführungsschritte mit den ursprünglichen Sitzungen übereinstimmen[2].
Beweist der Wiederholungsversuch stattdessen einen Sieg von Argon?
Aus diesen Beispielen ergibt sich kein allgemeiner Sieger. Der berichtete Wiederholungsversuch stellt den Schluss aus dem ersten Argon-Ergebnis infrage. Er belegt weder eine Erfolgsquote noch einen Vorteil über verschiedene Programmieraufgaben hinweg[2].
Hat der Autor auf die Kritik reagiert?
Ja. Semichenko erklärte, dass der Gemini-Durchlauf möglicherweise fehlgeschlagen sei und weitere Tests nötig seien. Außerdem schlug er vor, bei einem künftigen Vergleich jeweils den besten von drei Versuchen auszuwählen[3][4].
War dies ein Test zur KI-Videogenerierung?
Die veröffentlichten Beispiele betreffen interaktive Simulationen, die durch Programmierung entstanden sind. Unser Video bespricht Aufnahmen dieser Ergebnisse. Es vergleicht keine Text-zu-Video-Modelle[5].
Hat reAPI den Benchmark erneut durchgeführt?
Nein. Dieser Artikel und das verlinkte Video analysieren Durchläufe, von denen Dritte berichtet haben. Wir haben weder die vollständigen Testumgebungen unabhängig nachgestellt noch die kompletten Abrechnungsbelege geprüft oder einen neuen Benchmark-Wert ermittelt[5].
Was du vor der Wahl eines Siegers anfordern solltest
Beginne mit der ursprünglichen Demonstration und lies anschließend den Wiederholungsbericht sowie die Antwort des Autors. Wenn du eine Modellauswahl treffen musst, verlange den vollständigen Testaufbau und alle Versuche unter klar benannten Bewertungsregeln. Solange diese Informationen fehlen, ist der Gummibärchen-Test Gemini 4 Argon vs Opus 5.5 ein konkreter Fall, den es zu untersuchen lohnt. Wähle ein Modell für deine eigene Arbeit, nachdem du das benötigte Verhalten unter wiederholbaren Bedingungen geprüft hast.
Quellen
-
Semichenko (@semichenkko). Ursprünglicher Gummibärchen-Vergleich mit angehängter Community Note. Abgerufen am 19. Oktober 2026 unter x.com/semichenkko/status/2110131790136401989
-
@shpotes. Berichteter Wiederholungsversuch mit demselben Prompt in Argon + Antigravity. Abgerufen am 19. Oktober 2026 unter x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko). Antwort, die einen möglichen Fehlschlag des Gemini-Durchlaufs und die Notwendigkeit weiterer Tests einräumt. Abgerufen am 19. Oktober 2026 unter x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko). Antwort mit dem Vorschlag, für einen künftigen Vergleich den besten von drei Versuchen auszuwählen. Abgerufen am 19. Oktober 2026 unter x.com/semichenkko/status/2110282000246472931
-
reAPI. Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged. Abgerufen am 19. Oktober 2026 unter youtu.be/QR9HChbtym0
-
@Caxvalencia. Interaktionsbeispiel „Argon - Medium“. Abgerufen am 19. Oktober 2026 unter x.com/Caxvalencia/status/2110170790444269766