Was ist Ox Alpha? Das Stealth-Modell mit 1M Kontext und Video
Ox Alpha war im August 2026 das anonyme 1M-Kontext-Modell auf OpenRouter. Z.ai enthüllte es als GLM-5.3-Flash. Specs, Preise, Benchmarks und API-Zugang.
Ox Alpha war ein anonymes „Stealth“-KI-Modell, das am 20. August 2026 auf OpenRouter auftauchte – mit einem Kontextfenster von 1.048.576 Token und Eingaben aus Text, Bild und Video.[1] Sechs Tage lang wollte niemand sagen, wer dahintersteckt. Am 26. August beendete Z.ai das Rätselraten: Ox Alpha war ein unveröffentlichter Build von GLM-5.3-Flash, der vor dem Launch öffentlich getestet wurde.[3]
Die ehrliche Antwort auf die Frage „Was ist Ox Alpha?“ hat sich also geändert, seit die meisten Erklärtexte geschrieben wurden. Es ist kein kostenloses Mystery-Modell mehr, sondern ein veröffentlichtes Open-Weight-Modell mit Preisliste, Model Card und Benchmark-Werten. Dieser Leitfaden erklärt, was Ox Alpha während der Preview war, was sich dahinter verbarg und welches Modell Sie heute tatsächlich aufrufen, wenn Sie dasselbe Modell nutzen wollen.
TL;DR
- Start: Ox Alpha ging am 20. August 2026 auf OpenRouter als
stealth/ox-alphaonline, gelistet als Reasoning-Modell für Coding, agentische Arbeit und Produktions-Workloads.[1] - Identität: Z.ai bestätigte am 26. August, GLM-5.3-Flash anonym als ox-alpha auf OpenCode und OpenRouter getestet zu haben.[3]
- Größe: 320B Parameter insgesamt, 18B aktiv, mit einer Mischung aus Sparse und Linear Attention.[3]
- Eingaben: Video, Bild, Text und Datei rein, Text raus; 1M Kontext und 128K maximale Ausgabe über die API von Z.ai.[4]
- Aktueller Preis: Z.ai listet GLM-5.3-Flash mit $0.15 Eingabe, $0.03 gecachter Eingabe und $0.50 Ausgabe pro Million Token.[5]
- Gewichte: auf Hugging Face unter der MIT-Lizenz veröffentlicht.[6]
Was Ox Alpha während der Stealth-Preview war
OpenRouter beschrieb Ox Alpha als „ein Reasoning-Modell für Coding, dauerhafte agentische Arbeit und Produktions-Workloads“, geeignet für langfristiges Software-Engineering und für Workflows, die Text mit visuellem Kontext mischen.[1] Im Anbieterfeld stand „stealth“. Laut Listing wurde das Modell von einem Drittanbieter betrieben, der anonym bleiben wollte; OpenRouter leitete die Anfragen lediglich weiter.
Das Datenblatt war für ein kostenloses Listing ungewöhnlich. Die FAQ von OpenRouter auf der Seite nennt ein Kontextfenster von 1.048.576 Token und sagt, Ox Alpha „akzeptiert Text, Bilder und Video als Eingabe und gibt Text zurück“.[1] Videoeingabe ist bei Coding-Modellen noch selten, und ein 1M-Fenster an einem kostenlosen Endpunkt zog schnell Aufmerksamkeit auf sich.
TechCrunch berichtete am 23. August über den Hype. Die Kurzmeldung hält fest, dass das Modell auf OpenRouter kostenlos war, dass Stripe-CEO Patrick Collison es „sehr beeindruckend“ nannte und dass die Vermutungen weit auseinandergingen.[2] Frühe Spekulationen zeigten auf die GLM-Familie von Z.ai. Ein Update von Wccftech brachte stattdessen ein unveröffentlichtes MAI-Modell von Microsoft ins Spiel, und in Reddit-Threads wurde in beide Richtungen argumentiert. Das Fingerprinting der Community lag also richtig, beweisen konnte es aber niemand.
Ein Detail aus der Preview ist weiterhin relevant. Laut dem Hinweis von OpenRouter wurden Prompts und Completions, die an Ox Alpha gingen, „vom Anbieter gespeichert und nicht für das Training verwendet“.[1] Wer im August privaten Code in Ox Alpha eingefügt hat, hat diese Daten an Z.ai geschickt.
Ox Alpha war GLM-5.3-Flash
Die Enthüllung kam im Launch-Beitrag von Z.ai zu GLM-5.3-Flash vom 26. August 2026: „Vor der Veröffentlichung haben wir GLM-5.3-Flash anonym als ox-alpha auf OpenCode und OpenRouter getestet, um Nutzerfeedback zu sammeln. Es wurde schnell zum beliebtesten Modell der Woche – und der gesamte Traffic lief auf chinesischen KI-Chips.“[3]
OpenRouter aktualisierte die Stealth-Seite entsprechend. Dort steht jetzt:
„Dieses Stealth-Modell wurde von ZAI entwickelt und betrieben und hat sich als
ZAI GLM-5.3-Flash herausgestellt“, mit Verweis auf das Listing
z-ai/glm-5.3-flash.[1]
Dieses Listing nennt als Veröffentlichungsdatum den 26. August 2026.[7]
GLM-5.3-Flash ist das erste nativ multimodale Modell der GLM-5-Serie. Laut Z.ai basiert es auf einem neu trainierten Basismodell statt auf einem Fine-Tune eines älteren GLM und wurde auf einem multimodalen Korpus von 30T Token vortrainiert.[3]
Ox Alpha: die Spezifikationen im Überblick
| Eigenschaft | Ox Alpha / GLM-5.3-Flash |
|---|---|
| Entwickler | Z.ai (bestätigt am 26. August 2026) |
| Stealth-ID | stealth/ox-alpha (eingestellt) |
| API-Modellcode | glm-5.3-flash, dazu das schnellere glm-5.3-flashx |
| Parameter | 320B insgesamt, 18B aktiv |
| Layer | 45 |
| Eingabe | Video, Bild, Text, Datei |
| Ausgabe | Text |
| Kontextfenster | 1M Token über die API von Z.ai |
| Maximale Ausgabe | 128K Token |
| Thinking | Immer aktiv; reasoning_effort mit low, high oder max |
| Lizenz | MIT, Gewichte auf Hugging Face |
Quellen: Launch-Beitrag und Modell-Guide von Z.ai sowie die Model Card auf Hugging Face.[3][4][6] Die GLM-5.3-Flash-Seite von OpenRouter und der Guide von Z.ai stimmen beim Kontext überein: OpenRouter nennt 1.048.576 Tokens, also die 1M, die Z.ai angibt.[7][4] Wenn Sie das Fenster ausreizen wollen, planen Sie mit 1M.
Wie Ox Alpha so viel Kontext mit so wenig Rechenaufwand schafft
Die Architektur erklärt sowohl das 1M-Fenster als auch den niedrigen Preis. Im Vergleich zu GLM-4.5 hat GLM-5.3-Flash eine ähnliche Gesamtgröße (320B gegenüber 355B), aber fast nur halb so viele aktive Parameter (18B gegenüber 32B) und weniger als halb so viele Layer (45 gegenüber 92).[3]
Die größere Änderung betrifft die Attention. Z.ai kombiniert Linear Attention, die lokale Abhängigkeiten über einen laufenden Zustand verfolgt, mit Sparse Attention, die über einen schlanken Indexer relevante Token aus weit zurückliegendem Kontext heranzieht. Ein Verfahren, das Z.ai IndexPool nennt, komprimiert vier Key-Vektoren des Indexers zu einem, damit der Indexer auch bei 1M Token günstig bleibt. Gegenüber GLM-5.3 meldet Z.ai 3,0× weniger Attention-Rechenaufwand und einen 4,4× kleineren KV-Cache.[3]
Deshalb konnte die Preview auch auf chinesischen KI-Chips laufen. Laut Z.ai sind diese Chips vor allem durch Speicherkapazität und Bandbreite begrenzt, und auf derselben Hardware habe man die End-to-End-Serving-Leistung gegenüber der ersten Baseline um das 3-Fache gesteigert.[3] Ein kleinerer KV-Cache ist genau das, was ein speichergebundener Chip braucht.
Ox Alpha Benchmarks: jetzt mit offiziellen Zahlen
Während der Preview war jeder Ox-Alpha-Benchmark ein Screenshot von Unbekannten. Jetzt gibt es eine offizielle Tabelle. Es sind Z.ais eigene Zahlen, keine unabhängigen Prüfungen – lesen Sie sie also als Angabe des Herstellers.[3]
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 |
| DeepSWE v1.1 | 63.4 | 46.2 | 58.0 |
| NL2Repo | 56.3 | 48.9 | 69.7 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 |
| HLE w/ Tools | 55.3 | 54.7 | 57.9 |
| OSWorld 2.0 | 59.1 | k. A. | 54.8 |
Zwei Dinge fallen auf. Erstens ist der Sprung gegenüber GLM-5.2 bei agentischer Arbeit groß: Bei AutomationBench verdoppelt sich der Wert fast. Zweitens liegt das Modell nicht durchgehend vor Claude Opus 4.8. Deutlich zurück liegt es bei NL2Repo, wo aus einer natürlichsprachigen Spezifikation ein ganzes Repository entstehen soll. Z.ais Zusammenfassung „nähert sich Claude Opus 4.8 an“ ist fair. „Schlägt Opus“ wäre es nicht.
Z.ai meldet außerdem einen Wert von 57 im Artificial Analysis Intelligence Index v4.1.1 bei $0.045 pro Aufgabe (rabattiert).[3]
Ox Alpha Preise nach der kostenlosen Preview
Die kostenlose Phase ist vorbei. So viel kostet dasselbe Modell über die API von Z.ai, pro Million Token:[5]
| Modell | Eingabe | Gecachte Eingabe | Ausgabe |
|---|---|---|---|
| GLM-5.3-Flash | $0.15 | $0.03 | $0.50 |
| GLM-5.3-FlashX | $0.37 | $0.075 | $1.25 |
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 |
Daher stammt die Aussage „ein Zehntel des Preises“ aus dem Launch-Beitrag von Z.ai: $0.50 Ausgabe gegenüber $4.40 bei GLM-5.2 sind ungefähr ein Neuntel.[3] FlashX ist dasselbe Modell, auf Geschwindigkeit ausgelegt. Z.ai nennt dafür bis zu 200 Token pro Sekunde.[4]
Da die Gewichte offen sind, bieten auch andere Hoster das Modell an. OpenRouter
listet mehr als zwanzig Anbieter für z-ai/glm-5.3-flash, und der eigene
Endpunkt von Z.ai dort entspricht dem Listenpreis von $0.15 / $0.50.[7]
Das Modell aufrufen, zu dem Ox Alpha wurde
stealth/ox-alpha ist eingestellt, also nicht fest einprogrammieren. Rufen Sie
glm-5.3-flash über die Chat Completions API von Z.ai auf oder
z-ai/glm-5.3-flash über OpenRouter.[4][7]
Einige Verhaltensweisen bringen Umsteiger von reinen Textmodellen ins Stolpern:
- Thinking lässt sich nicht abschalten.
thinking.typeakzeptiert nurenabled. Die Kosten steuern Sie überreasoning_effort, daslow,highodermaxannimmt und ohne Angabe aufmaxsteht.[4][6] - Empfohlenes Sampling:
temperature: 1undtop_p: 0.95. Für Streaming empfiehlt Z.ai, sowohlstreamals auchtool_streamzu aktivieren.[4] - Bilder gehören in
image_url-Content-Blöcke. Für mehrere Bilder fügen Sie mehrere Blöcke hinzu. Z.ai empfiehlt, eine URL zu übergeben.[4] - Selbst gehostete Chat-Apps sollten
clear_thinkingsetzen. Im Chat-Template der offenen Gewichte steht es standardmäßig auffalse, und die Model Card empfiehlt für den Chat-Einsatztrue.[6]
Eine minimale Anfrage sieht so aus:
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "reasoning_effort": "high",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "image_url", "image_url": {"url": "https://example.com/ui.png"}},
        {"type": "text", "text": "Find the layout bugs in this screenshot."}
      ]
    }]
  }'
Für Self-Hosting nennt die Model Card unter anderem SGLang, vLLM, Transformers, KTransformers und Unsloth als unterstützte Wege.[6]
FAQ
Was ist Ox Alpha?
Ox Alpha war der anonyme Name für GLM-5.3-Flash von Z.ai während einer öffentlichen Preview auf OpenRouter und OpenCode, die am 20. August 2026 begann. Es ist ein multimodales Reasoning-Modell für Coding und Agenten-Arbeit mit einem Kontextfenster von 1M Token.
Wer hat Ox Alpha entwickelt?
Z.ai. Das Unternehmen bestätigte es im Launch-Beitrag zu GLM-5.3-Flash am 26. August 2026, und die Stealth-Seite von OpenRouter sagt jetzt, das Modell sei „von ZAI entwickelt und betrieben“ worden.
Ist Ox Alpha noch kostenlos?
Nein. Die Stealth-Preview ist beendet. Das Modell gibt es jetzt als GLM-5.3-Flash für $0.15 Eingabe und $0.50 Ausgabe pro Million Token über die API von Z.ai.
Ist Ox Alpha Open Source?
Ja, als GLM-5.3-Flash. Die Gewichte liegen auf Hugging Face unter der MIT-Lizenz. Während der Preview selbst waren keine Gewichte verfügbar.
Wie groß ist das Kontextfenster von Ox Alpha?
OpenRouter listete für Ox Alpha 1.048.576 Token. Der Guide von Z.ai für GLM-5.3-Flash nennt 1M Kontext und 128K maximale Ausgabe.
Kann Ox Alpha Video verarbeiten?
Ja. Z.ai listet Video, Bild, Text und Datei als Eingabemodalitäten für GLM-5.3-Flash. Die Ausgabe ist ausschließlich Text.
War Ox Alpha ein Gemini- oder Microsoft-Modell?
Nein. Das waren Vermutungen aus der Community, über die während der Preview berichtet wurde. Z.ai und OpenRouter identifizieren das Modell beide als GLM-5.3-Flash.
Ist Ox Alpha besser als GLM-5.2?
Laut den veröffentlichten Benchmarks von Z.ai ja, bei agentischen Aufgaben mit großem Abstand. Bei der Ausgabe kostet es außerdem nur etwa ein Neuntel. Der einzige Grund, bei GLM-5.2 zu bleiben: Sie haben Ihre Prompts bereits auf dessen Verhalten abgestimmt und brauchen keine Bildverarbeitung.
Wo Ox Alpha in einen GLM-Stack passt
Ox Alpha war ein Marketing-Experiment, das aufgegangen ist: Ein anonymes Modell wurde zum beliebtesten Listing seiner Woche, und die Enthüllung kam gleich mit Preisliste. Für Entwickler ist die praktische Erkenntnis einfacher. Hinter Ox Alpha steckt ein günstiges Open-Weight-Coding-Modell mit 1M Kontext, das Screenshots und Videos auswerten kann – und der kostenlose Stealth-Endpunkt ist Geschichte.
Wenn Sie GLM-5.2 bereits über reAPI nutzen, erklärt unser GLM-5.2 API-Leitfaden Anfrageformat, Reasoning-Steuerung und Limits, und die GLM-5.2 Modellseite zeigt die aktuellen Preise. Weitere Optionen mit langem Kontext finden Sie in unserem Kimi K3 Leitfaden und im DeepSeek V4 Leitfaden zum 1M-Kontext. Denken Sie nur daran: Wer heute nach Ox Alpha sucht, sucht eigentlich nach GLM-5.3-Flash.
Referenzen
- OpenRouter. Ox Alpha (stealth/ox-alpha): listing, reveal notice and FAQ. Retrieved September 2026 from openrouter.ai/stealth/ox-alpha
- TechCrunch. Who's behind the new 'stealth model' Ox Alpha? August 23, 2026. Retrieved September 2026 from techcrunch.com/2026/08/23/whos-behind-the-new-stealth-model-ox-alpha
- Z.ai. GLM-5.3-Flash: Frontier Intelligence, Flash Cost. August 26, 2026. Retrieved September 2026 from z.ai/blog/glm-5.3-flash
- Z.ai. GLM-5.3-Flash/FlashX model guide. Retrieved September 2026 from docs.z.ai/guides/llm/glm-5.3-flash
- Z.ai. Pricing. Retrieved September 2026 from docs.z.ai/guides/overview/pricing
- Z.ai. zai-org/GLM-5.3-Flash model card. Hugging Face. Retrieved September 2026 from huggingface.co/zai-org/GLM-5.3-Flash
- OpenRouter. Z.ai: GLM 5.3 Flash (z-ai/glm-5.3-flash). Retrieved September 2026 from openrouter.ai/z-ai/glm-5.3-flash
Weitere Lektüre
- reAPI. GLM-5.2 API guide. reapi.ai/blog/glm-5-2-api-guide
- reAPI. GLM-5.2 model page. reapi.ai/models/glm-5-2
Autor

Kategorien
Weitere Beiträge
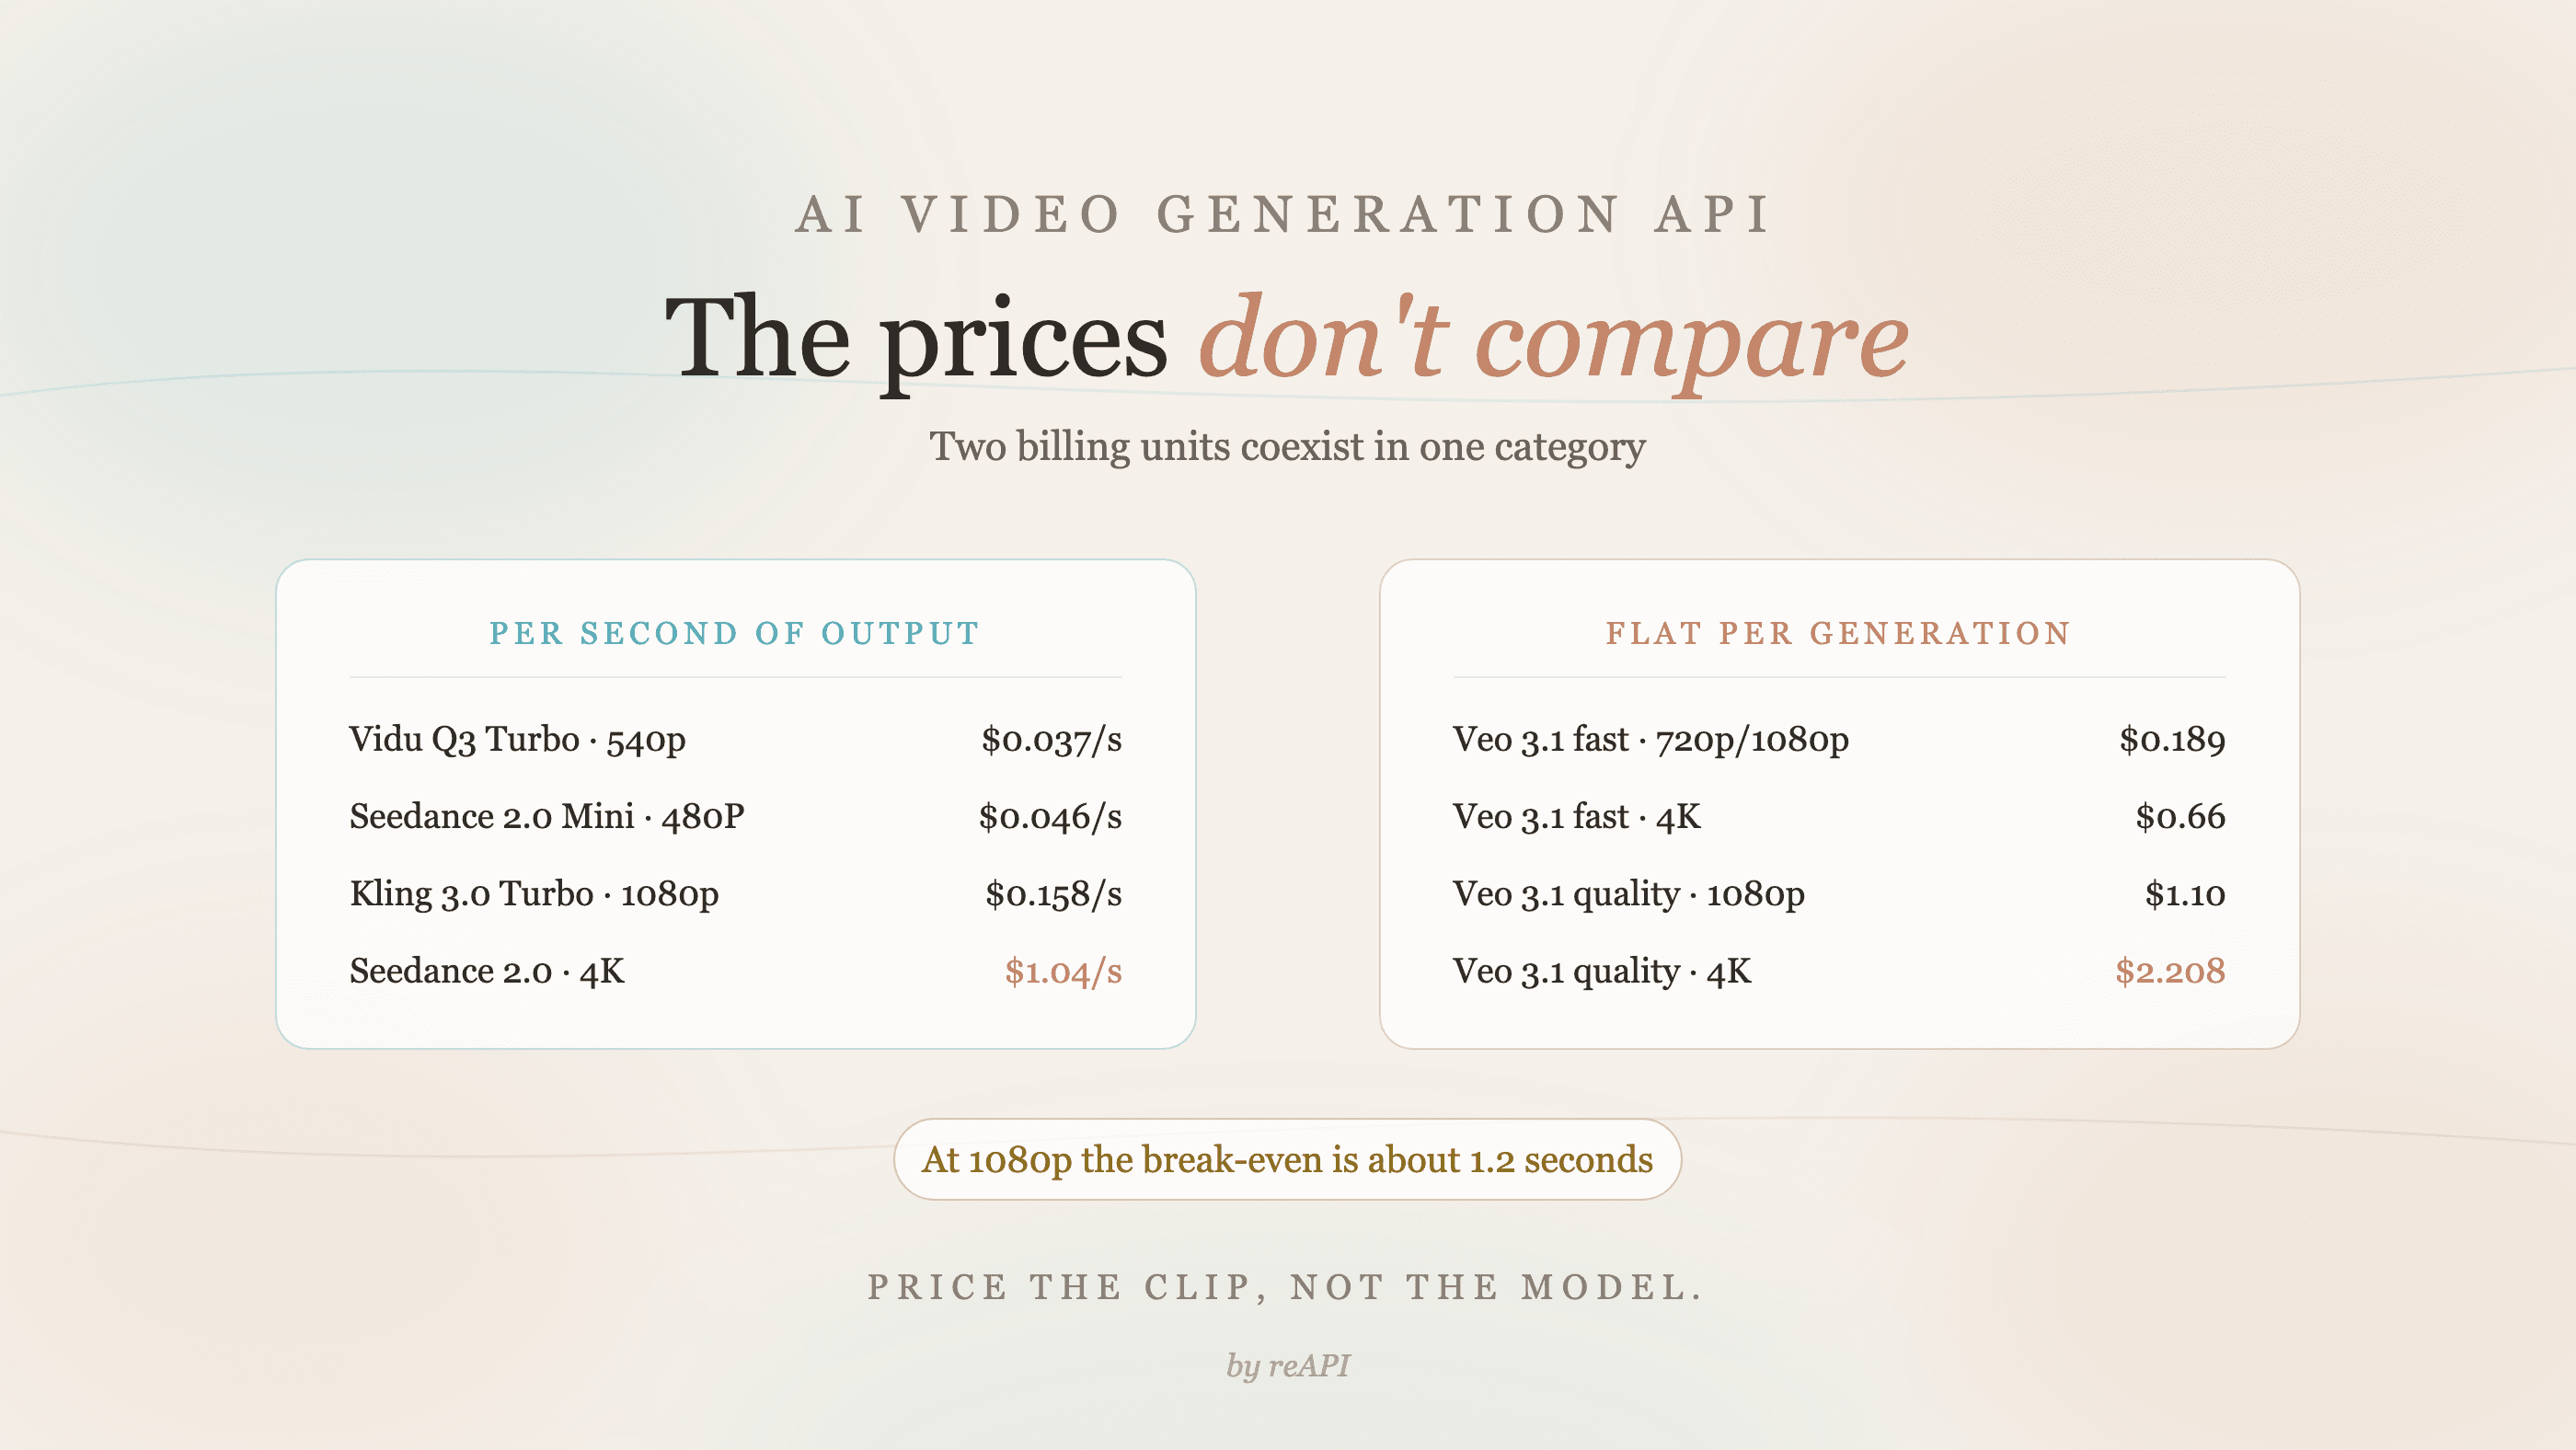
KI-Video-API-Preismodelle: pro Sekunde vs. Pauschal
Warum sich Preise von KI-Video-APIs nicht direkt vergleichen lassen: zwei inkompatible Abrechnungsmodelle, Break-Even-Punkte und was ein echtes Video kostet.
Inhaltsfilter bei Bild-APIs: wie Ablehnungen funktionieren
Bild-APIs filtern mehrschichtig. Ein Prompt kann auf einer Plattform bestehen und auf einer anderen fehlschlagen, doch zentrale Grenzen sind unveränderbar.
Together-AI-Alternativen 2026: 5 Optionen im Vergleich
Auf der Suche nach Together-AI-Alternativen 2026? Vergleiche OpenRouter, Replicate, RunPod, Hugging Face und reAPI bei Modellen, Preisen, Tempo und API-Design.