Qu'est-ce qu'Ox Alpha ? Le modèle furtif 1M de contexte et vidéo
Ox Alpha, modèle anonyme à 1M de contexte apparu sur OpenRouter en août 2026, était en fait GLM-5.3-Flash de Z.ai. Specs, tarifs, benchmarks et accès API.
Ox Alpha était un modèle d'IA « furtif » anonyme apparu sur OpenRouter le 20 août 2026, avec une fenêtre de contexte de 1 048 576 jetons et une entrée texte, image et vidéo.[1] Pendant six jours, personne n'a voulu dire qui l'avait conçu. Le 26 août, Z.ai a mis fin aux spéculations : Ox Alpha était une version non publiée de GLM-5.3-Flash, testée en public avant son lancement.[3]
La réponse honnête à « qu'est-ce qu'Ox Alpha » a donc changé depuis la rédaction de la plupart des articles explicatifs. Ce n'est plus un modèle mystère gratuit. C'est un modèle publié, à poids ouverts, avec une grille tarifaire, une fiche de modèle et des résultats de benchmarks. Ce guide présente ce qu'était Ox Alpha pendant la préversion, ce qu'il s'est révélé être, et ce qu'il faut appeler aujourd'hui pour utiliser le même modèle.
TL;DR
- Lancement : Ox Alpha a été mis en ligne sur OpenRouter le 20 août 2026
sous l'identifiant
stealth/ox-alpha, présenté comme un modèle de raisonnement pour le code, le travail agentique et les charges de production.[1] - Identité : Z.ai a confirmé le 26 août avoir testé GLM-5.3-Flash anonymement sous le nom ox-alpha sur OpenCode et OpenRouter.[3]
- Taille : 320B paramètres au total, dont 18B actifs, avec une attention hybride combinant attention creuse et attention linéaire.[3]
- Entrées : vidéo, image, texte et fichier en entrée ; texte en sortie ; contexte de 1M et sortie maximale de 128K sur l'API de Z.ai.[4]
- Prix actuel : Z.ai affiche GLM-5.3-Flash à $0.15 en entrée, $0.03 en entrée mise en cache et $0.50 en sortie par million de jetons.[5]
- Poids : publiés sur Hugging Face sous licence MIT.[6]
Ce qu'était Ox Alpha pendant la préversion furtive
OpenRouter décrivait Ox Alpha comme « un modèle de raisonnement conçu pour le code, le travail agentique soutenu et les charges de production », adapté à l'ingénierie logicielle à long horizon et aux flux de travail qui mêlent texte et contexte visuel.[1] Le champ fournisseur indiquait « stealth ». La fiche précisait que le modèle était exploité par un tiers ayant choisi de rester anonyme, et qu'OpenRouter se contentait de router les requêtes.
La fiche technique sortait de l'ordinaire pour une offre gratuite. La FAQ d'OpenRouter sur cette page annonce une fenêtre de contexte de 1 048 576 jetons et indique qu'Ox Alpha « accepte du texte, des images et de la vidéo en entrée et renvoie du texte ».[1] L'entrée vidéo reste rare parmi les modèles orientés code, et une fenêtre de 1M sur un endpoint gratuit a vite attiré l'attention.
TechCrunch a couvert l'engouement le 23 août. Son article relève que le modèle était gratuit sur OpenRouter, que le PDG de Stripe, Patrick Collison, l'a qualifié de « très impressionnant », et que les hypothèses partaient dans tous les sens.[2] Les premières spéculations visaient la famille GLM de Z.ai. Une mise à jour de Wccftech avançait plutôt un modèle MAI de Microsoft non publié, et des fils Reddit défendaient les deux thèses. Autrement dit, l'analyse d'empreinte menée par la communauté allait dans la bonne direction, mais personne ne pouvait le prouver.
Un détail de la préversion compte encore. L'avis d'OpenRouter précise que les prompts et les complétions envoyés à Ox Alpha « ont été conservés par le fournisseur et ne sont pas utilisés pour l'entraînement ».[1] Si vous avez collé du code privé dans Ox Alpha en août, ces données sont parties chez Z.ai.
Ox Alpha était GLM-5.3-Flash
La révélation est venue dans l'article de lancement de GLM-5.3-Flash publié par Z.ai le 26 août 2026 : « Avant la sortie, nous avons testé GLM-5.3-Flash anonymement sous le nom ox-alpha sur OpenCode et OpenRouter pour recueillir les retours des utilisateurs. Il est rapidement devenu le modèle le plus populaire de la semaine, et tout ce trafic a été servi sur des puces d'IA chinoises. »[3]
OpenRouter a mis à jour la page furtive dans le même sens. On y lit désormais :
« Ce modèle furtif a été développé et exploité par ZAI ; il s'agit de ZAI
GLM-5.3-Flash », avec un renvoi vers la fiche z-ai/glm-5.3-flash.[1]
Cette fiche indique une date de sortie au 26 août 2026.[7]
GLM-5.3-Flash est le premier modèle nativement multimodal de la série GLM-5. Selon Z.ai, il repose sur un modèle de base entraîné de zéro plutôt que sur un fine-tune d'un GLM antérieur, et a été pré-entraîné sur un corpus multimodal de 30T jetons.[3]
Ox Alpha : les caractéristiques en un coup d'œil
| Attribut | Ox Alpha / GLM-5.3-Flash |
|---|---|
| Développeur | Z.ai (confirmé le 26 août 2026) |
| ID furtif | stealth/ox-alpha (retiré) |
| Code du modèle API | glm-5.3-flash, plus la variante plus rapide glm-5.3-flashx |
| Paramètres | 320B au total, 18B actifs |
| Couches | 45 |
| Entrée | Vidéo, image, texte, fichier |
| Sortie | Texte |
| Fenêtre de contexte | 1M jetons sur l'API de Z.ai |
| Sortie maximale | 128K jetons |
| Réflexion | Toujours active ; reasoning_effort à low, high ou max |
| Licence | MIT, poids sur Hugging Face |
Sources : article de lancement et guide du modèle de Z.ai, ainsi que la fiche de modèle Hugging Face.[3][4][6] La page GLM-5.3-Flash d'OpenRouter et le guide de Z.ai concordent sur le contexte : OpenRouter annonce 1 048 576 tokens, soit le 1M publié par Z.ai.[7][4] Si vous comptez remplir la fenêtre, prévoyez 1M.
Comment Ox Alpha obtient autant de contexte pour si peu de calcul
L'architecture explique à la fois la fenêtre de 1M et le prix bas. Par rapport à GLM-4.5, GLM-5.3-Flash a une taille totale comparable (320B contre 355B), mais presque deux fois moins de paramètres actifs (18B contre 32B) et moins de la moitié des couches (45 contre 92).[3]
Le changement le plus important concerne l'attention. Z.ai combine l'attention linéaire, qui suit les dépendances locales via un état cumulatif, et l'attention creuse, qui s'appuie sur un indexeur léger pour aller chercher des jetons pertinents loin en arrière dans le contexte. Une technique que Z.ai appelle IndexPool compresse quatre vecteurs clés de l'indexeur en un seul, pour que cet indexeur reste peu coûteux à 1M jetons. Par rapport à GLM-5.3, Z.ai annonce un calcul d'attention divisé par 3,0 et un cache KV 4,4 fois plus petit.[3]
C'est aussi ce qui a permis de faire tourner la préversion sur des puces d'IA chinoises. Z.ai explique que ces puces sont surtout limitées par la capacité et la bande passante mémoire, et qu'il a obtenu une amélioration d'un facteur 3 des performances de service de bout en bout par rapport à sa première référence, sur le même matériel.[3] Un cache KV plus petit est exactement ce dont a besoin une puce limitée par la mémoire.
Les benchmarks d'Ox Alpha, désormais officiels
Pendant la préversion, chaque benchmark d'Ox Alpha était une capture d'écran publiée par un inconnu. Il existe maintenant un tableau officiel. Ce sont les chiffres de Z.ai, pas des audits indépendants : lisez-les comme une affirmation de l'éditeur.[3]
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 |
| DeepSWE v1.1 | 63.4 | 46.2 | 58.0 |
| NL2Repo | 56.3 | 48.9 | 69.7 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 |
| HLE w/ Tools | 55.3 | 54.7 | 57.9 |
| OSWorld 2.0 | 59.1 | n/d | 54.8 |
Deux points ressortent. D'abord, le gain par rapport à GLM-5.2 sur le travail agentique est important : le score AutomationBench double presque. Ensuite, le modèle ne devance pas Claude Opus 4.8 partout. Il reste nettement derrière sur NL2Repo, qui demande de produire un dépôt complet à partir d'une spécification en langage naturel. Le résumé de Z.ai, « qui se rapproche de Claude Opus 4.8 », est juste. « Bat Opus » ne le serait pas.
Z.ai annonce aussi un score de 57 sur l'Artificial Analysis Intelligence Index v4.1.1, pour $0.045 par tâche (tarif réduit).[3]
Les tarifs d'Ox Alpha après la préversion gratuite
La période gratuite est terminée. Voici ce que coûte le même modèle sur l'API de Z.ai, par million de jetons :[5]
| Modèle | Entrée | Entrée en cache | Sortie |
|---|---|---|---|
| GLM-5.3-Flash | $0.15 | $0.03 | $0.50 |
| GLM-5.3-FlashX | $0.37 | $0.075 | $1.25 |
| GLM-5.3 | $1.40 | $0.26 | $4.40 |
| GLM-5.2 | $1.40 | $0.26 | $4.40 |
C'est de là que vient la formule « un dixième du prix » de l'article de lancement de Z.ai : $0.50 en sortie contre $4.40 pour GLM-5.2, soit environ un neuvième.[3] FlashX est le même modèle, servi pour la vitesse. Z.ai annonce jusqu'à 200 jetons par seconde pour cette variante.[4]
Comme les poids sont ouverts, d'autres hébergeurs le servent aussi. OpenRouter
recense plus de vingt fournisseurs pour z-ai/glm-5.3-flash, et l'endpoint de
Z.ai sur la plateforme correspond au tarif catalogue de $0.15 / $0.50.[7]
Appeler le modèle qu'Ox Alpha est devenu
stealth/ox-alpha est retiré : ne le codez pas en dur. Appelez glm-5.3-flash
sur l'API Chat Completions de Z.ai, ou z-ai/glm-5.3-flash sur OpenRouter.[4][7]
Quelques comportements surprennent ceux qui arrivent d'un modèle texte
uniquement :
- La réflexion ne peut pas être désactivée.
thinking.typen'accepte queenabled. Maîtrisez le coût avecreasoning_effort, qui acceptelow,highoumaxet vautmaxpar défaut s'il est omis.[4][6] - Échantillonnage recommandé :
temperature: 1ettop_p: 0.95. Pour le streaming, Z.ai conseille d'activer à la foisstreamettool_stream.[4] - Les images passent dans des blocs de contenu
image_url. Ajoutez plusieurs blocs pour plusieurs images. Z.ai recommande de transmettre une URL.[4] - Les applications de chat auto-hébergées doivent définir
clear_thinking. Dans le modèle de chat des poids ouverts, sa valeur par défaut estfalse, et la fiche de modèle indique de passertruepour un usage en chat.[6]
Une requête minimale ressemble à ceci :
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "reasoning_effort": "high",
    "messages": [{
      "role": "user",
      "content": [
        {"type": "image_url", "image_url": {"url": "https://example.com/ui.png"}},
        {"type": "text", "text": "Find the layout bugs in this screenshot."}
      ]
    }]
  }'
Si vous auto-hébergez le modèle, la fiche de modèle cite SGLang, vLLM, Transformers, KTransformers et Unsloth parmi les options prises en charge.[6]
FAQ
Qu'est-ce qu'Ox Alpha ?
Ox Alpha était le nom anonyme de GLM-5.3-Flash de Z.ai pendant une préversion publique sur OpenRouter et OpenCode, lancée le 20 août 2026. C'est un modèle de raisonnement multimodal pour le code et le travail d'agent, doté d'une fenêtre de contexte de 1M jetons.
Qui a créé Ox Alpha ?
Z.ai. L'entreprise l'a confirmé dans l'article de lancement de GLM-5.3-Flash le 26 août 2026, et la page furtive d'OpenRouter indique désormais que le modèle a été « développé et exploité par ZAI ».
Ox Alpha est-il toujours gratuit ?
Non. La préversion furtive est terminée. Le modèle est désormais proposé sous le nom GLM-5.3-Flash à $0.15 en entrée et $0.50 en sortie par million de jetons sur l'API de Z.ai.
Ox Alpha est-il open source ?
Oui, sous le nom GLM-5.3-Flash. Les poids sont sur Hugging Face sous licence MIT. Pendant la préversion elle-même, aucun poids n'était disponible.
Quelle est la fenêtre de contexte d'Ox Alpha ?
OpenRouter indiquait 1 048 576 jetons pour Ox Alpha. Le guide de Z.ai pour GLM-5.3-Flash annonce un contexte de 1M et une sortie maximale de 128K.
Ox Alpha peut-il lire de la vidéo ?
Oui. Z.ai liste la vidéo, l'image, le texte et le fichier comme modalités d'entrée de GLM-5.3-Flash. La sortie est uniquement textuelle.
Ox Alpha était-il un modèle Gemini ou Microsoft ?
Non. Il s'agissait d'hypothèses de la communauté relayées pendant la préversion. Z.ai et OpenRouter identifient tous deux le modèle comme GLM-5.3-Flash.
Ox Alpha est-il meilleur que GLM-5.2 ?
Selon les benchmarks publiés par Z.ai, oui, avec une large avance sur les tâches agentiques. Il coûte aussi environ neuf fois moins cher en sortie. La seule raison de rester sur GLM-5.2 serait d'avoir déjà ajusté vos prompts à son comportement sans avoir besoin de la vision.
La place d'Ox Alpha dans une stack GLM
Ox Alpha était une expérience marketing réussie : un modèle anonyme est devenu l'offre la plus populaire de sa semaine, et la révélation est arrivée avec une grille tarifaire déjà prête. Pour les développeurs, la leçon pratique est plus simple. Le modèle derrière Ox Alpha est un modèle de code bon marché, à poids ouverts et à 1M de contexte, capable d'analyser des captures d'écran et de la vidéo, et l'endpoint furtif gratuit n'existe plus.
Si vous utilisez déjà GLM-5.2 via reAPI, notre guide de l'API GLM-5.2 détaille la forme des requêtes, les réglages de raisonnement et les limites, et la page du modèle GLM-5.2 affiche les tarifs actuels. Pour d'autres options à long contexte, consultez notre guide Kimi K3 et notre guide DeepSeek V4 à 1M de contexte. Retenez simplement qu'aujourd'hui, chercher Ox Alpha revient à chercher GLM-5.3-Flash.
Références
- OpenRouter. Ox Alpha (stealth/ox-alpha): listing, reveal notice and FAQ. Retrieved September 2026 from openrouter.ai/stealth/ox-alpha
- TechCrunch. Who's behind the new 'stealth model' Ox Alpha? August 23, 2026. Retrieved September 2026 from techcrunch.com/2026/08/23/whos-behind-the-new-stealth-model-ox-alpha
- Z.ai. GLM-5.3-Flash: Frontier Intelligence, Flash Cost. August 26, 2026. Retrieved September 2026 from z.ai/blog/glm-5.3-flash
- Z.ai. GLM-5.3-Flash/FlashX model guide. Retrieved September 2026 from docs.z.ai/guides/llm/glm-5.3-flash
- Z.ai. Pricing. Retrieved September 2026 from docs.z.ai/guides/overview/pricing
- Z.ai. zai-org/GLM-5.3-Flash model card. Hugging Face. Retrieved September 2026 from huggingface.co/zai-org/GLM-5.3-Flash
- OpenRouter. Z.ai: GLM 5.3 Flash (z-ai/glm-5.3-flash). Retrieved September 2026 from openrouter.ai/z-ai/glm-5.3-flash
Pour aller plus loin
- reAPI. GLM-5.2 API guide. reapi.ai/blog/glm-5-2-api-guide
- reAPI. GLM-5.2 model page. reapi.ai/models/glm-5-2
Auteur

Catégories
Plus d'articles
MiniMax M3 : guide de codage et contexte d'un million
Utilisez l'API MiniMax M3 pour le codage et les agents. Comparez tarifs reAPI et MiniMax, contexte d'un million de tokens, modes de réflexion.
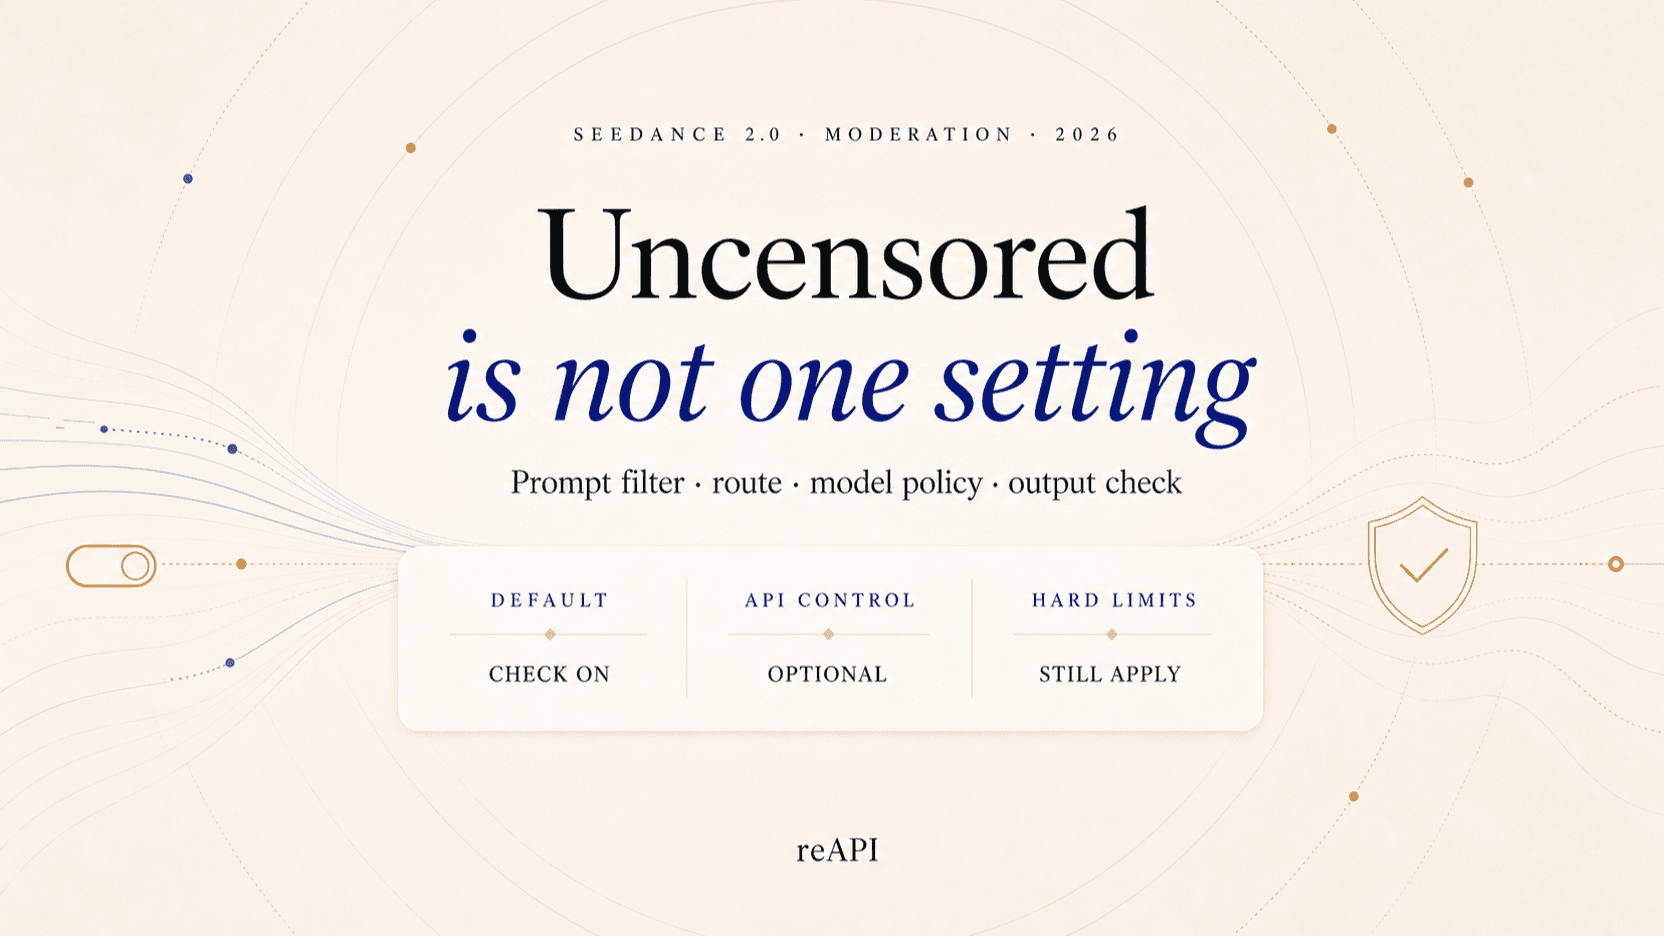
Couches de sécurité Seedance 2.0 : ce que chacune bloque
Seedance 2.0 filtre en plusieurs couches ; un refus ne dit pas laquelle a agi. Découvrez ce que chaque couche bloque et les limites qui ne changent jamais.
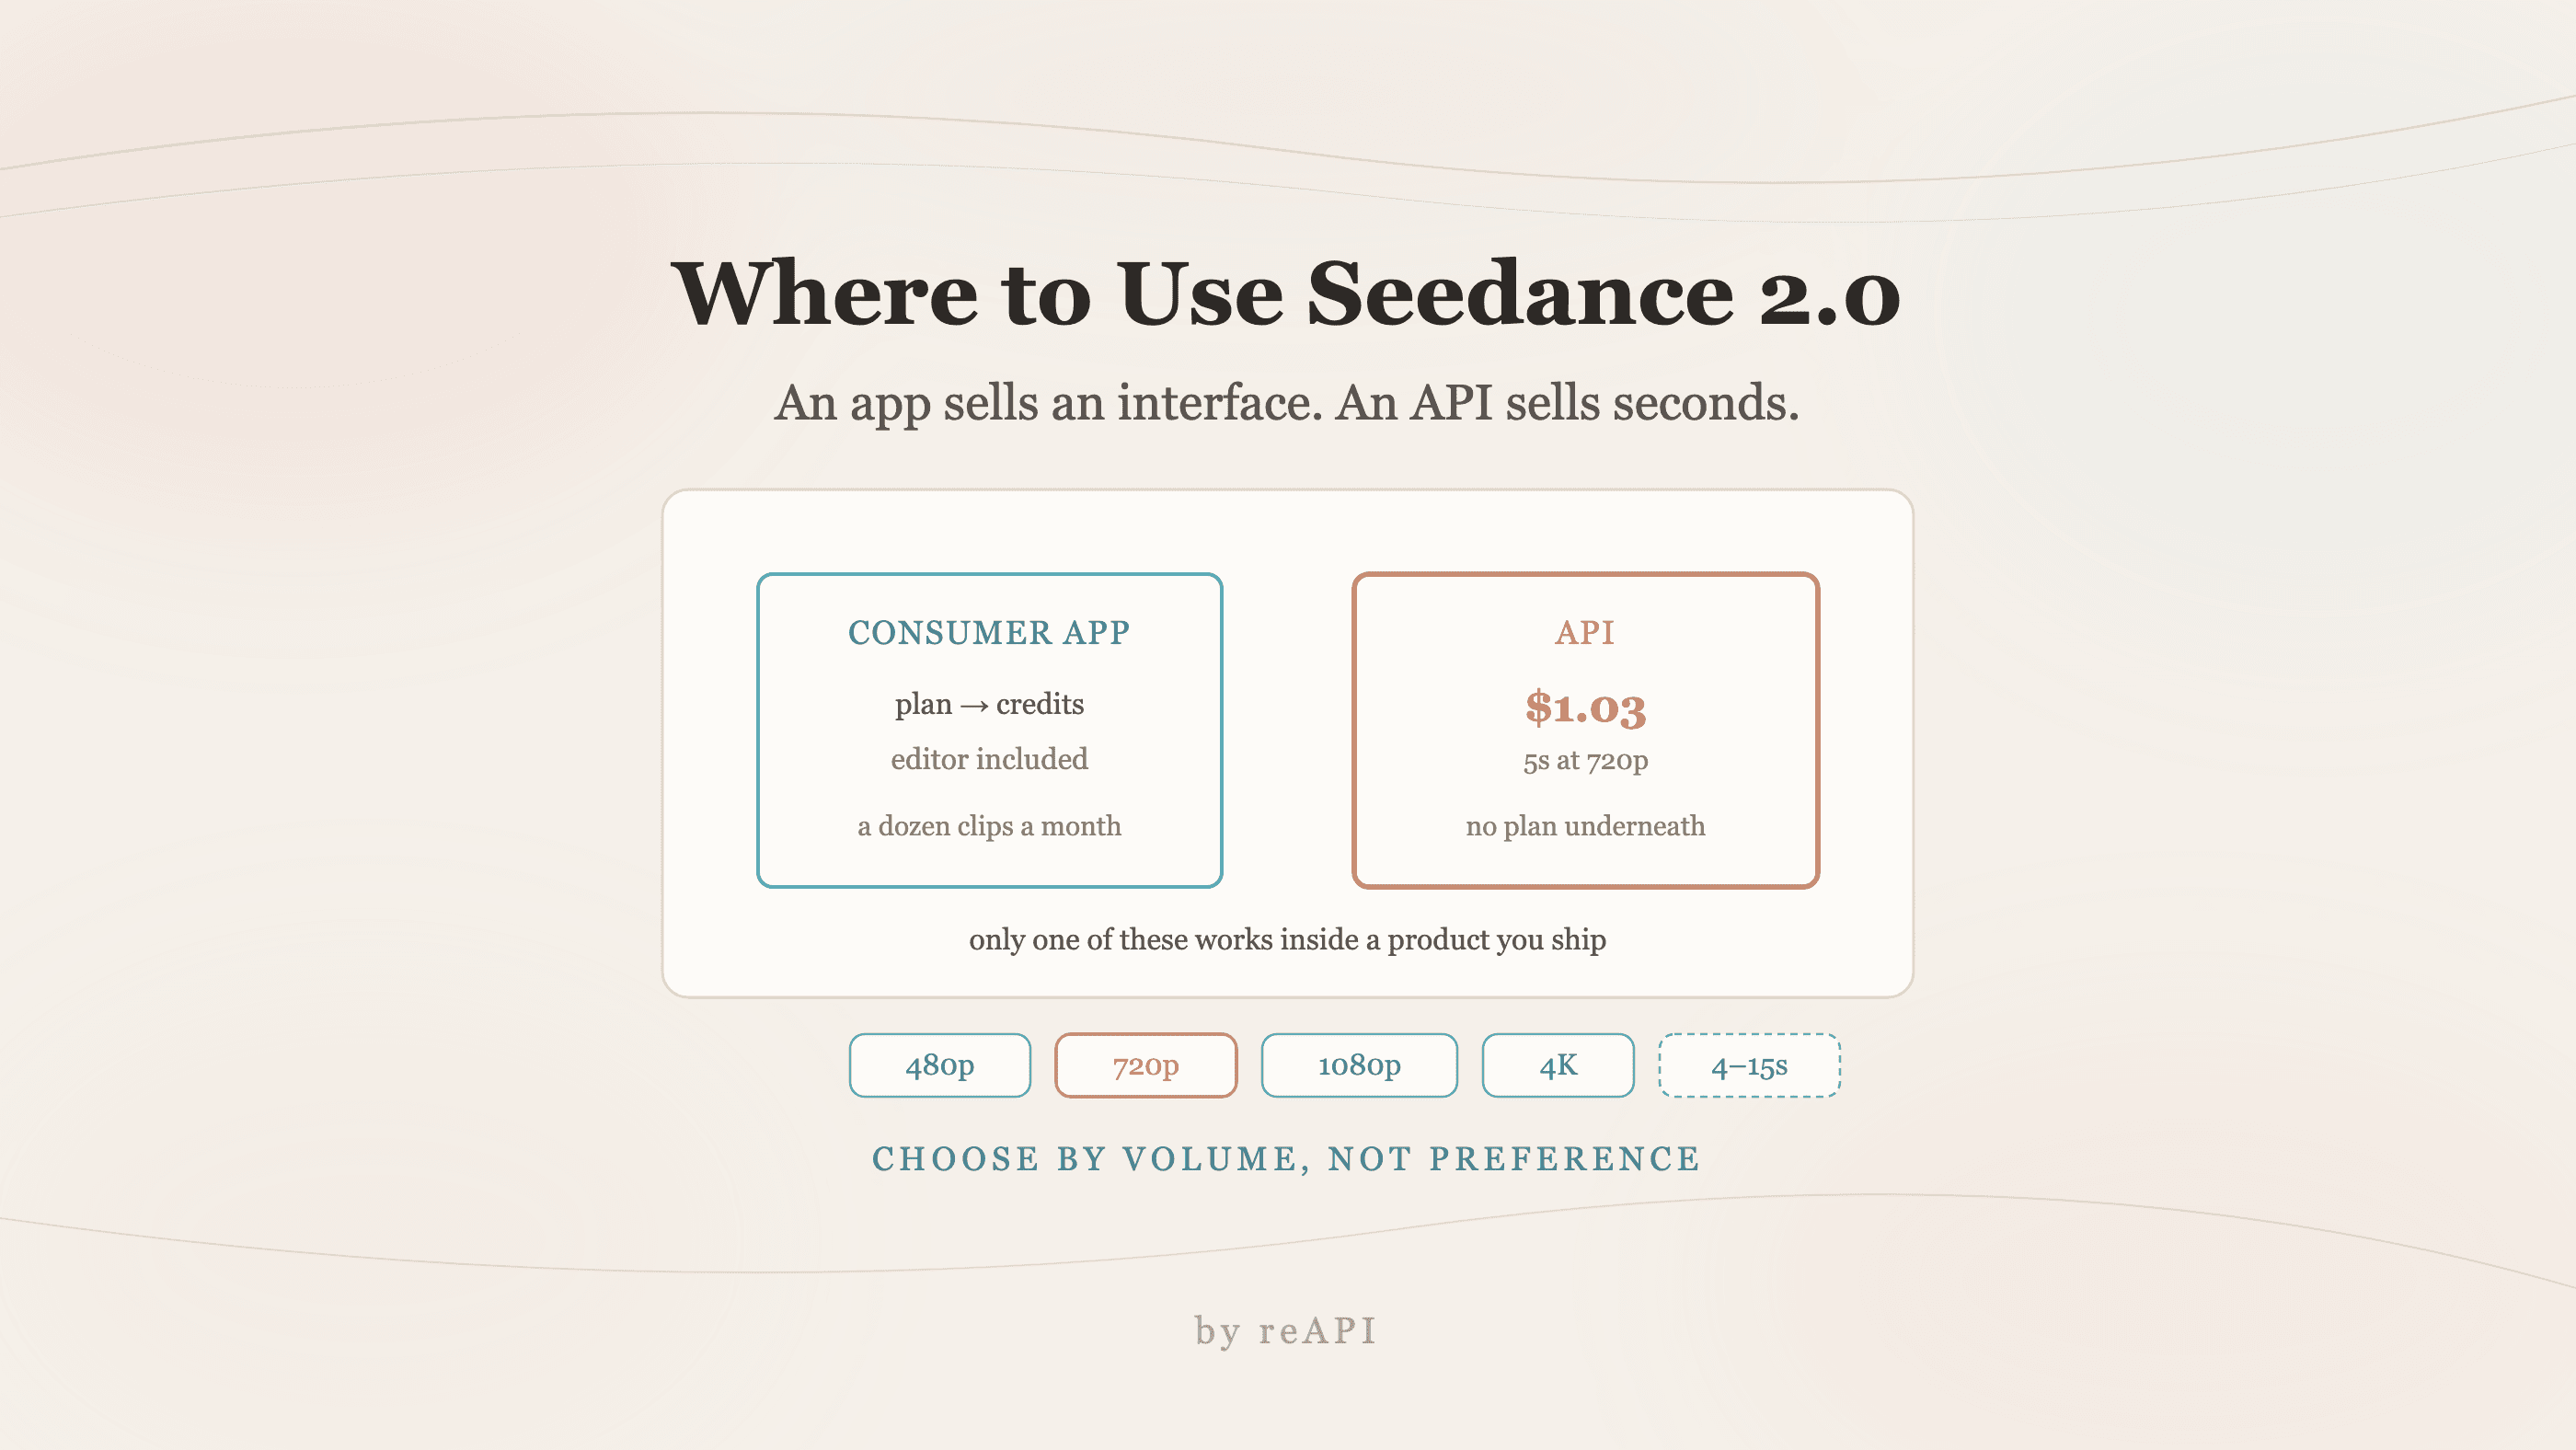
Où utiliser Seedance 2.0 : applications ou API
Où utiliser Seedance 2.0 : applications grand public avec abonnement ou API à la seconde sans forfait. Tarifs réels, limite 4-15s, comment choisir.