Définir la température sur l'API GPT-6 Luna : pourquoi elle renvoie 400 et quoi envoyer
Définir la température sur l'API GPT-6 Luna ? Pourquoi GPT-6 Luna et Sol renvoient 400 pour temperature et top_p, l'ID exact et une requête corrigée.
Si vous essayez de définir la température sur l'API GPT-6 Luna, vous obtenez en général une erreur HTTP 400, pas une réponse plus sage. Le guide de migration GPT-6 d'OpenAI demande aux développeurs de retirer temperature, top_p et top_logprobs dès que l'effort de raisonnement est différent de none, et de supprimer aussi logprobs sur Chat Completions[1]. GPT-6 Luna utilise par défaut l'effort medium[2] : une requête qui ajoute temperature: 0.2 sans toucher à l'effort tombe donc du mauvais côté de la règle.
Cet article explique ce que dit la règle, reprend les messages d'erreur exacts que des développeurs ont publiés depuis Amazon Bedrock, Azure et des clients OpenAI, donne l'ID de modèle correct et montre une requête avant/après pour l'endpoint Chat Completions de reAPI. Les mêmes règles s'appliquent à GPT-6 Sol.
En bref
- Retirez
temperatureettop_p. Le guide d'OpenAI demande de les retirer, ainsi quetop_logprobs, lorsque l'effort de raisonnement n'est pasnone[1]. L'effort par défaut de Luna estmedium[2]. - Sur reAPI, la règle est plus simple :
temperature,top_p,frequency_penaltyetpresence_penaltyrenvoient400surgpt-6-lunacomme surgpt-6-sol. Ne les envoyez dans aucune requête[3][4]. - Même
temperature: 1peut échouer. Un rapport de bug Langflow a constaté que l'API Converse d'Amazon Bedrock rejette le champ quelle que soit sa valeur, 1 compris[5]. - Le levier dont vous disposez est
reasoning_effort:none,low,medium,high,xhighoumax[2]. Il n'existe pas de valeurauto. - L'ID de modèle est
gpt-6-luna(etgpt-6-sol), à écrire exactement ainsi[2][3]. - Le premier résultat Microsoft Q&A concerne un autre bug. Il porte sur le rejet de
reasoning.effortdans Azure AI Foundry, pas sur la température[6].
Pourquoi GPT-6 Luna rejette la température
GPT-6 Luna est un modèle de raisonnement. La page du modèle chez OpenAI mentionne « Reasoning token support » et six niveaux d'effort, avec medium par défaut[2]. Dans le guide GPT-6 d'OpenAI, la checklist « Update API and model parameters » range les paramètres d'échantillonnage sous une rubrique dédiée[1] :
Unsupported parameters: When reasoning effort is not none, remove temperature, top_p, and top_logprobs. For Chat Completions, also remove logprobs.
Lisez bien la condition. Le guide lie la suppression à l'effort de raisonnement, pas au nom du modèle. Le même guide précise que GPT-6 Sol et GPT-6 Luna acceptent none, contrairement à GPT-6 Astra et GPT-6.1 Sol[1]. En pratique, la plupart des requêtes tournent avec l'effort par défaut medium, si bien que la plupart des requêtes qui contiennent temperature échouent.
reAPI documente un comportement plus strict. Son tableau de paramètres pour gpt-6-luna, mesuré sur l'endpoint le 2026-09-24, indique pour temperature, top_p, frequency_penalty et presence_penalty : « Not supported by this model — sending any of them returns 400. Leave them out of the request. »[3] La page gpt-6-sol contient la même ligne[4]. La documentation ne décrit aucune exception pour l'effort none, alors ne comptez pas dessus : supprimez les champs.
Les erreurs 400 que rencontrent réellement les développeurs
Les résultats de recherche sur ce problème mélangent plusieurs erreurs distinctes. Voici les messages publiés par des développeurs, leur provenance et la correction pour chacun.
| Texte de l'erreur, tel que rapporté | Contexte | Correction |
|---|---|---|
| "Only the default (1) value is supported." | Endpoint compatible OpenAI de Bedrock, Langflow envoyant temperature 0.1[5] | Retirer temperature |
| "This model doesn't support the temperature field. Remove temperature and try again." | Bedrock Converse, depuis Langflow (défaut 0.7) et Phoenix (défaut 1)[5][7] | Retirer temperature, puis top_p, que Converse rejette de la même façon[5] |
| "Unsupported parameter: 'reasoning.effort' is not supported with this model." | Agents Azure AI Foundry et endpoint de projet Foundry[6][8] | Pas un problème de température ; voir la réponse Azure dans la FAQ |
| "Function tools with reasoning_effort are not supported for gpt-6-luna in /v1/chat/completions. To use function tools, use /v1/responses or set reasoning_effort to 'none'." | OpenAI Chat Completions, depuis un client Ruby envoyant des tools[9] | Utiliser l'API Responses ou l'effort none, selon la page du modèle chez OpenAI[2] |
| "Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22" | Une définition de Foundry Agent[10] | Signalé sur Azure ; pas un problème de température |
Deux de ces rapports montrent que le champ arrive sans que personne ne l'ait choisi. Le playground AWS de Phoenix démarre chaque exécution avec temperature: 1 issu d'une configuration par défaut, et son curseur ne peut pas être vidé[7]. Le composant Bedrock de Langflow envoie par défaut Temperature 0.7 et Top P 0.9[5]. Si votre propre code ne mentionne jamais la température et que l'erreur apparaît quand même, regardez les valeurs par défaut du framework.
Définir la température sur l'API GPT-6 Luna avec reAPI : avant et après
reAPI sert GPT-6 Luna via POST https://reapi.ai/api/v1/chat/completions, avec votre clé reAPI en bearer token[3]. La requête suivante reprend des habitudes héritées des anciens modèles de chat et sera rejetée :
# Rejected: temperature and top_p return 400 on gpt-6-luna
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "temperature": 0.2,
    "top_p": 0.9
  }'
La version corrigée supprime les deux champs et règle les paramètres que le modèle respecte. Sur reAPI, reasoning_effort accepte les six niveaux, et max_completion_tokens est appliqué jusqu'à 128 000[3] :
# Accepted: no sampling fields, explicit effort and output cap
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "reasoning_effort": "low",
    "max_completion_tokens": 1000
  }'
Les tokens de raisonnement sont comptés dans max_completion_tokens et facturés comme sortie : un plafond dimensionné uniquement pour la réponse visible peut tronquer un prompt plus difficile[3]. Les tarifs par token actuels figurent sur la page du modèle GPT-6 Luna.
Le reste de la surface de paramètres sur reAPI, tel que documenté pour les deux modèles GPT-6[3][4] :
| Champ | Résultat sur gpt-6-luna et gpt-6-sol |
|---|---|
temperature, top_p, frequency_penalty, presence_penalty | 400, à ne pas envoyer |
seed, stop, logprobs, verbosity | Acceptés (200) mais sans effet |
n | Uniquement 1 ; une valeur supérieure renvoie 400 |
reasoning_effort | none, low, medium, high, xhigh, max ; medium si omis |
response_format | Appliqué, y compris json_schema avec strict |
tools, tool_choice | tool_calls renvoyés avec l'effort medium comme avec none |
La ligne tools diffère de la règle d'OpenAI pour Chat Completions, qui n'autorise le function calling qu'avec reasoning_effort: "none"[2]. Sur l'endpoint de reAPI, les tools ont renvoyé des tool_calls avec l'effort medium lors de la mesure du 2026-09-24[3].
Que faire à la place de la température
La température réglait le caractère aléatoire de l'échantillonnage. GPT-6 Luna n'offre aucun remplacement direct ; choisissez donc le levier qui correspond à ce que vous attendiez de la température.
Vous vouliez une sortie cohérente et facile à parser. Utilisez response_format avec un schéma JSON et strict: true. reAPI l'applique sur les deux modèles GPT-6[3], et un schéma strict fige la forme de la réponse, ce que beaucoup de réglages temperature: 0 cherchaient justement à obtenir.
Vous vouliez des réponses plus rapides ou moins chères. Baissez reasoning_effort. Le guide d'OpenAI sur le raisonnement recommande none pour les tâches sensibles à la latence, comme la classification et la récupération rapide, et low pour l'usage d'outils, les workflows de support et la rédaction de brouillons[11]. Moins de tokens de raisonnement, c'est aussi moins de tokens de sortie facturés[3].
Vous vouliez des réponses variées. Ni seed ni n ne vous aideront sur reAPI. seed est accepté sans effet et n est limité à 1[3]. Envoyez des requêtes séparées, ou demandez plusieurs variantes dans un seul prompt.
Vous vouliez un autre style. Dites-le dans le message system ou developer. Les paramètres d'échantillonnage ont toujours été un outil grossier pour régler le ton, et les instructions sont le seul levier qui reste.
Supprimer les champs en Python
Si un helper partagé ou une configuration injecte des valeurs d'échantillonnage par défaut, retirez-les avant l'appel plutôt que de modifier chaque appelant. L'exemple utilise le SDK OpenAI officiel pointé vers reAPI, comme dans l'exemple Python de reAPI[3] :
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://reapi.ai/api/v1")

REJECTED = {"temperature", "top_p", "frequency_penalty", "presence_penalty"}

def gpt6_params(params: dict) -> dict:
    """Drop fields that gpt-6-luna and gpt-6-sol answer with 400."""
    return {k: v for k, v in params.items() if k not in REJECTED}

params = {"temperature": 0.2, "top_p": 0.9, "max_completion_tokens": 1000}

resp = client.chat.completions.create(
    model="gpt-6-luna",
    messages=[{"role": "user", "content": "Summarize this refund policy in two sentences."}],
    reasoning_effort="low",
    **gpt6_params(params),
)
print(resp.choices[0].message.content)
Si vous ne voyez pas d'où vient un champ, journalisez pendant vos tests les clés du corps de requête final sérialisé. Les rapports Phoenix et Langflow cités plus haut sont tous deux des cas de valeur par défaut que l'appelant n'a jamais écrite[5][7].
FAQ
Définir la température de l'API GPT-6 Luna : GitHub
Les issues GitHub sur ce sujet portent surtout sur des outils qui envoient la température par défaut. Le composant Bedrock de Langflow envoie 0.7 et 0.9 pour temperature et top_p[5], et le playground AWS de Phoenix envoie temperature: 1 à chaque exécution[7]. Les deux rapports indiquent que la requête fonctionne une fois les champs retirés. Dans votre propre code, la correction est la même : n'envoyez ni temperature ni top_p à GPT-6 Luna.
Définir la température de l'API GPT-6 Luna en Python
Vous ne pouvez pas la définir. Laissez temperature et top_p hors de client.chat.completions.create(...) et passez plutôt reasoning_effort. Sur reAPI, ces deux champs renvoient 400[3]. Le helper Python ci-dessus les filtre s'ils proviennent d'une configuration partagée.
Définir la température de l'API GPT-6 Luna : exemple
La requête cURL corrigée plus haut sert d'exemple : model défini sur gpt-6-luna, le tableau messages, reasoning_effort: "low" et max_completion_tokens: 1000, sans temperature ni top_p. Elle respecte les règles de champs de la documentation GPT-6 Luna de reAPI[3].
Nom de l'API GPT-6 Luna
L'ID de modèle de l'API est gpt-6-luna. OpenAI l'indique à la fois comme ID de modèle et comme unique snapshot, avec la consigne « Use gpt-6-luna in your API requests. »[2] reAPI utilise la même chaîne et le traite comme un modèle distinct de gpt-5.6-luna et de gpt-6-sol[3]. Les messages d'erreur Azure mentionnent aussi une version de modèle, gpt-6-luna-2026-09-22[10].
Raisonnement auto sur l'API GPT-6 Luna
Il n'existe pas d'effort de raisonnement auto. OpenAI liste none, low, medium, high, xhigh et max pour GPT-6 Luna, avec medium par défaut[2]. Pour obtenir la valeur par défaut du modèle, omettez simplement reasoning_effort. Le guide d'OpenAI sur le raisonnement utilise bien auto, mais pour d'autres réglages : les résumés de raisonnement et le champ reasoning.context[11].
GPT-6 Luna sur Azure
Le problème Azure le plus cité ne concerne pas la température. Un post Microsoft Q&A du 29 septembre 2026 signale des agents Foundry qui échouent avec "Unsupported parameter: 'reasoning.effort' is not supported with this model"[6]. Une issue GitHub le reproduit sur l'endpoint de projet Foundry, où les appels simples renvoient 500 et ceux avec effort renvoient 400, alors que l'endpoint de ressource fonctionne avec l'effort de raisonnement. Le contournement proposé par l'auteur consiste à appeler l'endpoint de ressource, et l'issue était toujours ouverte lors de notre vérification le 7 octobre 2026[8].
Quel effort choisir pour GPT-6 Sol
GPT-6 Sol accepte les mêmes six valeurs que Luna, avec medium par défaut[4][12]. La recommandation générale d'OpenAI : none pour les tâches sensibles à la latence, low pour l'usage d'outils et les brouillons, medium pour la plupart des charges de travail, high pour le débogage et la planification difficiles, et xhigh uniquement lorsque vos evals justifient la latence et le coût supplémentaires[11]. Sur reAPI, Sol rejette temperature et top_p exactement comme Luna[4].
Envoyer des requêtes GPT-6 Luna qui passent du premier coup
Une requête GPT-6 Luna propre contient un model égal à gpt-6-luna, un tableau messages, un reasoning_effort choisi délibérément et un plafond de sortie qui laisse de la place au raisonnement. Elle ne contient ni temperature, ni top_p, ni champs de pénalité. Si vous êtes arrivé ici pour définir la température sur l'API GPT-6 Luna, la réponse est d'arrêter de la définir : maîtrisez le coût et la latence avec l'effort, la forme avec un schéma JSON strict, et vérifiez ce que votre framework ajoute par défaut. La même forme de requête fonctionne pour GPT-6 Sol. Les paramètres sont détaillés dans la documentation GPT-6 Luna et la documentation GPT-6 Sol, et les tarifs actuels sur les pages des modèles GPT-6 Luna et GPT-6 Sol.
References
- OpenAI. Using GPT-6. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/latest-model
- OpenAI. GPT-6 Luna model page. Consulté en octobre 2026 sur developers.openai.com/api/docs/models/gpt-6-luna
- reAPI. gpt-6-luna API documentation. Consulté en octobre 2026 sur reapi.ai/docs/gpt-6-luna
- reAPI. gpt-6-sol API documentation. Consulté en octobre 2026 sur reapi.ai/docs/gpt-6-sol
- Langflow on GitHub. Amazon Bedrock Converse: OpenAI GPT-6 Sol/Luna/Astra calls fail with 400 because Temperature and Top P are sent by default (#15349). Consulté en octobre 2026 sur github.com/langflow-ai/langflow/issues/15349
- Microsoft Q&A. GPT-6-Luna agents fail with Unsupported parameter: 'reasoning.effort' error. Consulté en octobre 2026 sur learn.microsoft.com/en-us/answers/questions/6018360
- Arize Phoenix on GitHub. Playground can't run OpenAI GPT-6 Sol/Luna/Astra on AWS Bedrock: default temperature=1 is always sent and rejected with 400 (#16430). Consulté en octobre 2026 sur github.com/Arize-ai/phoenix/issues/16430
- Azure SDK for Python on GitHub. azure-ai-projects: gpt-6-luna returns 500 on project endpoint, works on resource endpoint (#49169). Consulté en octobre 2026 sur github.com/Azure/azure-sdk-for-python/issues/49169
- redmine_ai_helper on GitHub. Chat fails with gpt-6 models (gpt-6-luna, gpt-6-sol): "Function tools with reasoning_effort are not supported" (#480). Consulté en octobre 2026 sur github.com/haru/redmine_ai_helper/issues/480
- Microsoft Agent Framework on GitHub. Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22 (#8718). Consulté en octobre 2026 sur github.com/microsoft/agent-framework/issues/8718
- OpenAI. Reasoning models. Consulté en octobre 2026 sur developers.openai.com/api/docs/guides/reasoning
- OpenAI. GPT-6 Sol model page. Consulté en octobre 2026 sur developers.openai.com/api/docs/models/gpt-6-sol
Pour aller plus loin
- reAPI. GPT-6 Sol vs GPT-6 Luna. reapi.ai/blog/gpt-6-sol-vs-luna
- reAPI. GPT-6 Luna API pricing. reapi.ai/blog/gpt-6-luna-api-pricing
Auteur

Catégories
Plus d'articles
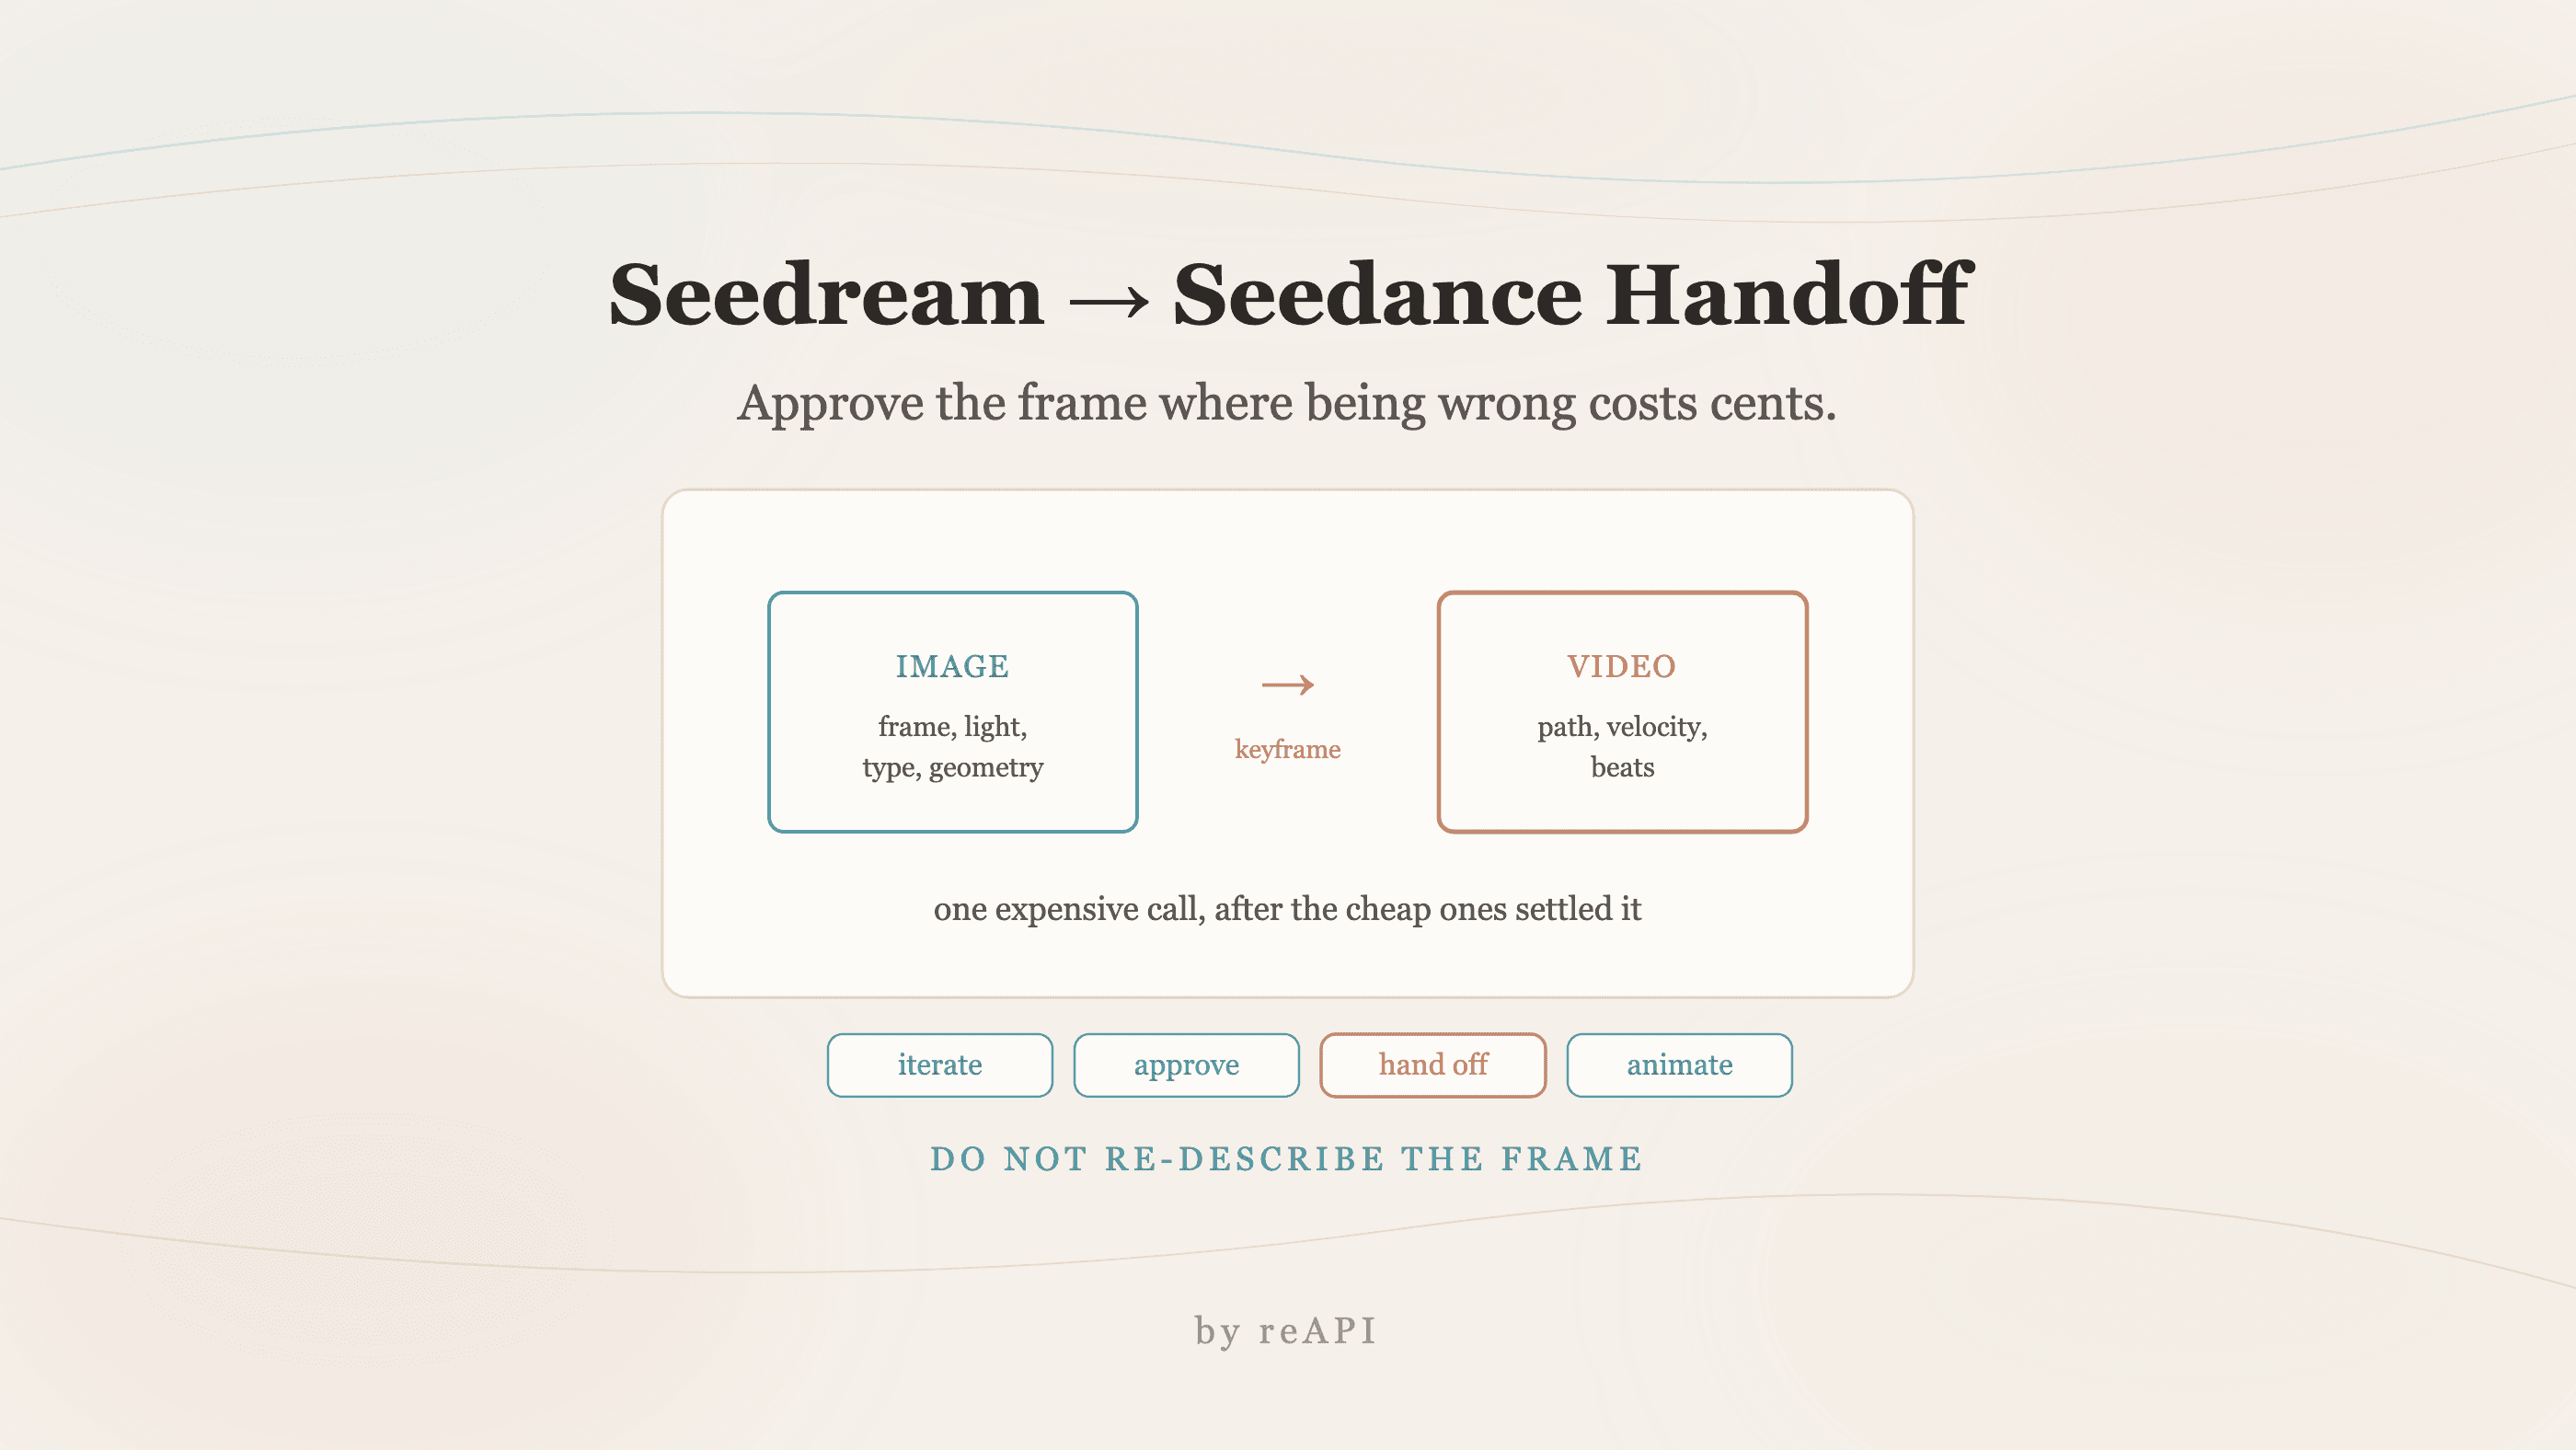
De Seedream à Seedance : flux du transfert de cadre clé
Le flux Seedream Seedance stabilise la composition par image, puis transfère le cadre à la vidéo. Répartition des tâches et pièges essentiels.
Alternatives à Venice.ai en 2026 : 5 options comparées
Vous cherchez des alternatives à Venice.ai en 2026 ? Comparez OpenRouter, Together AI, DeepInfra, Ollama en local et reAPI sur les modèles, les prix et l'API.
Quel modèle Grok Imagine utiliser : 1.0 vs 1.5 vs Image 2.0
Trois modèles Grok Imagine en quatre mois pour la vidéo et l'image. Lequel possède une API, lequel coûte moins cher, et le piège de nomenclature.