Gemini 4 Argon Preise: Einführung, Abrechnung und Budget
Gemini 4 Argon Preise nach Input, Thinking, Cache-Treffern und Long Decode verstehen. So wirken gemeinsame Token-Limits auf dein Budget und die reAPI-Kosten.
Gemini 4 Argon kostet bei Googles Standard-Einführungstarif bis zum 30. November 2026 $2.00 für Input und $10.00 für Output pro Million Token; ab dem 1. Dezember gelten $4.00/$20.00. Googles Output-Kategorie umfasst Thinking-Token; gecachter Input wird separat bepreist[1][4]. Am 23. Oktober 2026 zeigte die reAPI-Seite für Gemini 4 Argon $0.80 für Input und $4.00 für Output pro Million Token. Das ist der bei dieser Prüfung angezeigte reAPI-Preis, kein Versprechen, Googles künftigem Zeitplan zu folgen[5].
Eine Kostenfrage wird konkreter, wenn sie mit einer Aufgabe beginnt. Eine kurze Klassifikation, wiederholte Agent-Turns über dasselbe Repository und ein langer Forschungsbericht brauchen unterschiedlich viel Input, Reasoning und Output. Dieser Leitfaden erklärt Abrechnungsdimensionen, gemeinsamen Kontext und Fortsetzungen. Die Beispiele sind hypothetische Token-Budgets, keine gemessenen Workloads oder Angebote.
TL;DR
- Input, gecachter Input und Output sind getrennte Preisdimensionen. Googles Output-Kategorie enthält Thinking-Tokens[1].
- Googles Einführungspreise gelten bis 30. November 2026; Standardpreise beginnen am 1. Dezember. Aktuelle reAPI-Preise stehen auf der Modellseite[1].
- Input, Thinking und Output teilen 1,048,576 Tokens. Ein Prompt mit 100,000 Tokens plus 1,000,000 generierte Tokens passt nicht hinein[2].
- Ein nativer Request liefert höchstens 32,768 Tokens ohne Streaming oder 65,536 mit Streaming. Längere Generierungen benötigen Fortsetzungsanfragen[2].
- Google dokumentiert implizites Caching ab 4,096 Prompt-Tokens. Explizite Cache-Erstellung wird für dieses Modell nicht unterstützt[1].
Was auf die Rechnung für Gemini 4 Argon gehört
Die sichtbare Antwort ist nur ein Teil der Nutzung. Gemini 4 Argon kann vor der Textausgabe Tokens für Reasoning verbrauchen; Google rechnet diese als Output ab[1]. Eine kurze Antwort muss deshalb keine kleine Rechnung bedeuten.
| Dimension | Was du prüfen solltest |
|---|---|
| Frischer Input | Prompt- und Gesprächsmaterial ohne Cache-Treffer |
| Gecachter Input | Tatsächlich gemeldete Cache-Tokens des Requests |
| Output | Antwort- und Thinking-Nutzung nach den Abrechnungsregeln des Dienstes |
| Fortsetzung | Gemeldete Nutzung jeder ausdrücklich gesendeten Fortsetzungsanfrage |
Speichere die Usage-Antwort je Request sowie Modell-ID, Thinking-Einstellung, Finish Reason und eventuelle Fortsetzung. So lassen sich Läufe mit verschiedenen Ausgabelängen vergleichen. Zeichen in der sichtbaren Antwort zu zählen ersetzt nicht die gemeldete Token-Nutzung.
Wenn ein Dienst disjunkte Token-Kategorien meldet, multipliziere frischen Input, gecachten Input und abrechenbaren Output jeweils mit dem aktuellen Preis und teile jeden Term durch eine Million. Addiere nach den Abrechnungs- und Rundungsregeln des Dienstes. Enthält der Input-Zähler bereits Cache-Tokens, ziehe diese Teilmenge vor Anwendung des frischen Input-Preises ab, sonst zählst du doppelt. Den hier verwendeten Vertrag beschreibt die reAPI-Referenz.
gemini api pricing
Googles Oktober-Leitfaden beantwortet die offene Frage aus dem September: Die Einführungsphase endet am 30. November 2026[1]. Die frühere Aussage, es gebe kein veröffentlichtes Enddatum, stimmt nicht mehr.
Vergleiche für ein Gemini-API-Budget das genaue Modell und den Preiszeitraum. Die folgende Tabelle umfasst Gemini 4 Argon und Gemini 3.6 Flash, die beiden bei reAPI angebotenen Gemini-Modelle, mit Googles Standard-Tarifen der kostenpflichtigen Stufe in USD pro 1 Million Token. Output umfasst Thinking. Batch, Flex, Priority, Tool-Gebühren, Cache-Speicherung und Steuern sind nicht enthalten; Googles Preiszeitplan ist kein Versprechen für künftige reAPI-Tarife[4][6].
| Google-Modell und Preiszeitraum | Input | Output einschließlich Thinking | Gecachter Input |
|---|---|---|---|
| Gemini 4 Argon, bis 30. November 2026 | $2.00 | $10.00 | $0.10 |
| Gemini 4 Argon, ab 1. Dezember 2026 | $4.00 | $20.00 | $0.20 |
| Gemini 3.6 Flash, bis 31. Dezember 2026 | $0.75 | $3.75 | $0.075 |
| Gemini 3.6 Flash, ab 1. Januar 2027 | $1.50 | $7.50 | $0.15 |
Googles Argon-Cache-Preis gilt für implizite Cache-Treffer; die explizite Erstellung eines Caches wird nicht unterstützt. Flash hat eine separate Cache-Speichergebühr von $0.50 pro Million Token und Stunde bis zum 31. Dezember 2026, danach $1.00 ab dem 1. Januar 2027. Übertrage Flashs Speichermodell nicht auf Argon und zähle gecachten Input nicht zusätzlich als frischen Input[1][4].
Bei der Prüfung am 23. Oktober zeigte reAPIs Argon-Pricing-Bereich $0.80 für Input und $4.00 für Output pro Million Token, aber keinen Cache-Input-Preis. Die reAPI-Seite für Gemini 3.6 Flash zeigte weiterhin „Pricing temporarily unavailable“ und enthielt kein Preisangebot. Deshalb nennen wir keinen aktuellen reAPI-Flash-Preis und verwenden den Artikelpreis vom Juli nicht als aktuellen Rabatt. Ein fehlender Cache-Preis ist weder ein Nullpreis noch eine Erlaubnis, Googles Preis einzusetzen[5].
Bei 20.000 ungecachten Input-Token und 5.000 abrechenbaren Output-Token kostet Argon nach Googles Standard-Einführungstarif (20,000 × $2 + 5,000 × $10) / 1,000,000 = $0.09. Mit den geplanten Dezemberpreisen sind es $0.18. Die beobachteten reAPI-Input-/Output-Raten ergeben (20,000 × $0.80 + 5,000 × $4.00) / 1,000,000 = $0.036. Dies sind reine Tokenberechnungen mit festen Mengen, ohne Cache-Treffer und zusätzliche Tool-Gebühren; keine gemessenen Rechnungen und keine Garantie für gleiche Ausgabequalität[4][5].
Auf reAPI unterstützt Argon native Google-GenerateContent-Anfragen. Flash verwendet reAPIs Chat-Completions-Route mit einer Output-Grenze von 8.192 Token. Halte diese Anfrageverträge beim Budgetvergleich auseinander. Gemini 3.1 Pro wird von reAPI nicht angeboten; der Flash-Pro-Vergleich erklärt diese Grenze und der Flash-Nutzungsleitfaden die Integration[6].
Für Workloads über den Wechsel hinweg erstelle zwei Schätzungen mit den jeweils geltenden Preisen. Halte Token-Zahlen und Aufgabenannahmen identisch und ändere nur die Preise. Dann zeigt das Ergebnis den Preiseffekt statt einer Mischung aus Preis- und Workload-Änderung. Beim Dienstvergleich prüfst du ebenso zuerst, ob Request, Thinking, Cache-Annahmen und Output-Budget dasselbe bedeuten.
Googles Ankündigung vom 13. Oktober trennt die Zugänge: Entwickler nutzen die kostenpflichtige API-Stufe, Ultra- und Pro-Abonnenten die Gemini-App und AI Mode in Search[3]. Die Planausschlüsse des Entwicklerleitfadens gelten nicht pauschal für Endnutzer-Apps. Ein Endnutzer-Abo ist keine Vorauszahlung für reAPI.
Warum das gemeinsame Fenster die Schätzung verändert
Input, Thinking und Output teilen bei Gemini 4 Argon einen Kontext von 1,048,576 Tokens[2]. Der Input belegt schon vor der Generierung Platz; der Rest muss Reasoning und Antwort aufnehmen.
Bei genau 100,000 Input-Tokens bleiben rechnerisch höchstens 948,576 für Thinking und Output zusammen. Das ist eine Kontext-Obergrenze, keine zugesagte Antwortlänge. Transportgrenzen und konfiguriertes Generierungsbudget gelten zusätzlich.
| Hypothetische Aufgabe | Input | Budget für Thinking und Output zusammen | Passt ins gemeinsame Fenster? |
|---|---|---|---|
| Fokussiertes Code-Review | 100,000 | 20,000 | Ja; das Modell kann früher fertig sein |
| Agent-Turn über Referenzmaterial | 500,000 | 50,000 | Ja; Cache-Treffer anhand der Usage bestätigen |
| Langer Bericht | 200,000 | 600,000 | Insgesamt ja; oberhalb der Request-Grenzen sind Fortsetzungen nötig |
| Zu großer Output-Plan | 100,000 | 1,000,000 | Nein; die Summe überschreitet 1,048,576 |
Die Tabelle reserviert ein kombiniertes Budget, nicht ausschließlich sichtbaren Text. Schwierige Aufgaben können viel davon fürs Thinking nutzen. Brauchst du eine bestimmte Berichtslänge, plane genug Reasoning-Raum ein und prüfe den Abbruchgrund[2].
Long Decode benötigt mehrere Requests
Google nennt 32,768 generierte Tokens pro nicht gestreamtem Request und 65,536 pro Stream. Long Decode kann innerhalb des gemeinsamen Fensters darüber hinaus fortsetzen[2]. „Eine Million Tokens in einer Antwort“ verschleiert diesen für die Usage-Erfassung wichtigen Ablauf.
Aktuelle Google-GenAI-SDKs können standardmäßig automatisch fortsetzen, wenn das Budget oberhalb der Request-Grenze liegt. Direkte REST-Clients verwalten dies selbst[1]. reAPI sendet serverseitig keine automatischen Fortsetzungsanfragen; dein Client entscheidet über den nächsten Request mit den Fortsetzungsinformationen.
Protokolliere jede Anfrage, entscheide, ob sich die unerledigte Arbeit weiterzuführen lohnt, und bewahre ein zurückgegebenes Continuation-Token auf. Ist das konfigurierte Budget erschöpft, verlangt Googles Leitfaden beim Wiederaufnehmen ein höheres Budget[1]. Starte nicht blind neu: Neustart und Fortsetzung ab Checkpoint sind unterschiedliche Aktionen.
Eine schwierige Aufgabe kann laut Google ein ganzes Segment fürs Thinking nutzen und leeren sichtbaren Text mit Continuation-Token liefern[1]. Das beweist nicht, dass keine Arbeit stattgefunden hat. Prüfe Finish Reason und Usage vor der nächsten Client-Aktion.
Thinking und Caching steuern verschiedene Kosten
Die nativen Thinking-Level heißen low, medium, high; Standard ist medium. Thinking lässt sich bei Gemini 4 Argon nicht vollständig deaktivieren[2]. Google empfiehlt, dieselbe Aufgabe mit mehreren Stufen zu prüfen und die niedrigste zu wählen, die den Qualitätsanspruch erfüllt[1].
Ein niedrigeres Output-Budget kann auch die Antwort abschneiden. Ein aussagekräftiger Versuch lässt genug Ausgaberaum und verändert das Thinking-Level. Vergleiche Akzeptanz, Tokens und Laufzeit. Ein billiger unvollständiger Lauf spart nichts Nützliches, wenn die Anwendung erneut starten muss.
Caching betrifft dagegen wiederholten Input. Google dokumentiert implizites Caching ab 4,096 Prompt-Tokens, aber keine explizite Cache-Erstellung[1]. Bewahre nach Möglichkeit einen stabilen gemeinsamen Präfix und berechne Einsparungen aus gemeldeten Treffern. Wiederholung garantiert nicht, dass sämtliche Input-Tokens den Cache-Preis erhalten.
Übertrage beim Modellvergleich weder Cache-Schreibkosten noch Lebensdauer oder explizite Cache-APIs anderer Produkte auf Argon. Maßgeblich sind Mechanismus und Usage-Felder des tatsächlich verwendeten Dienstes.
FAQ
Was kostet Gemini 4 Argon?
Bei der Prüfung am 23. Oktober 2026 kostet Google Standard bis zum 30. November $2.00 für Input, $10.00 für Output einschließlich Thinking und $0.10 für gecachten Input pro Million Token; ab dem 1. Dezember gelten $4.00, $20.00 und $0.20. Die reAPI-Modellseite zeigte $0.80 für Input und $4.00 für Output, ohne ausgewiesenen Cache-Input-Preis. Verwende bei der Rechnungsschätzung den passenden Anbieter und Zeitraum[4][5].
Ist Gemini 4 Argon kostenlos?
Google dokumentiert eine kostenpflichtige API-Stufe sowie Gemini-App und AI Mode für Ultra- und Pro-Abonnenten[3]. Diese Abos sind von reAPIs Tokenabrechnung getrennt; aktuelle Nutzungspreise stehen auf der Modellseite.
Wann endet der Einführungspreis?
Google nennt den 30. November 2026 als letzten Tag, Standardpreise gelten ab 1. Dezember[1]. Für reAPI prüfst du die Live-Tabelle dieses Dienstes.
Werden Thinking-Tokens berechnet?
Ja, Googles veröffentlichte Output-Preise enthalten Thinking-Tokens[1]. Die sichtbare Textlänge ist kein vollständiges Nutzungsmaß.
Kann ich eine Million Output-Tokens plus großen Prompt einplanen?
Alle drei Kategorien teilen 1,048,576 Tokens. Ein Prompt mit 100,000 lässt höchstens 948,576 für Thinking und Output, zusätzlich begrenzt durch Budget und Request-Limits[2].
Setzt reAPI lange Generierungen automatisch fort?
Nein. reAPI liefert die Antwort auf deinen Request; der Client sendet Fortsetzungen ausdrücklich. Lies die Request-Dokumentation, bevor du die Schleife implementierst.
Ist Argon günstiger als GPT-6 Astra oder Claude Opus 5.5?
Vergleiche aktuelle Preise mit der Token-Nutzung deiner Aufgabe. Thinking-Budget, Cache-Treffer und Antwortlänge verändern die Rechnung. Der Benchmark-Vergleich erklärt Fähigkeiten, ohne Tokenpreis und Preis einer fertigen Aufgabe gleichzusetzen.
Eine fertige Aufgabe budgetieren
Bewahre repräsentative Prompts und klare Akzeptanzkriterien auf. Wiederhole dieselbe Evaluation bei Änderungen an Thinking, Kontext oder Modell und erfasse jede Fortsetzung. So bedeuten Gemini 4 Argon Preise konkret: Kosten für Arbeit, die deine Anwendung tatsächlich annehmen kann.
Quellen
-
Google. What's new in Gemini 4 Argon. Abgerufen am 14. Oktober 2026 von ai.google.dev/gemini-api/docs/generate-content/latest-model
-
Google. Gemini thinking. Abgerufen am 14. Oktober 2026 von ai.google.dev/gemini-api/docs/generate-content/thinking
-
Google. Gemini 4 Argon: Built to solve your hardest problems. Veröffentlicht am 13. Oktober 2026; abgerufen am 14. Oktober 2026 von blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon
-
Google. Gemini-API-Preise — Argon-Einführungs-/Standardtarife und Flash-Aktion. Geprüft am 23. Oktober 2026. ai.google.dev/gemini-api/docs/pricing
-
reAPI. Gerenderte Pricing-Bereiche der Modelle. Geprüft am 23. Oktober 2026. Gemini 4 Argon, Gemini 3.6 Flash. Bei dieser Prüfung waren die Flash-Preise vorübergehend nicht verfügbar.
-
reAPI. Aktuelle Modellintegration und Anfrageverträge. Geprüft am 23. Oktober 2026. Gemini-4-Argon-Dokumentation, Gemini-3.6-Flash-Dokumentation.
Autor

Kategorien
Weitere Beiträge
OpenRouter Preise: Gebühren, Limits der Gratis-Modelle und eine günstigere Option
OpenRouter Preise erklärt: Tokens zum Listenpreis, 5.5% Gebühr auf Credits, Tageslimits der kostenlosen Modelle, Verfall und Erstattung von Credits und wo reAPI pro Token weniger kostet.
GPT-6 Luna vs 5.6 Luna vs 5.6 Terra: Preis und welches Modell passt
GPT-6 Luna vs 5.6 Luna und 5.6 Terra: OpenAI-Listenpreise, der offizielle Grund für den Preisnachlass, Benchmarks, erste A/B-Tests und die richtige Wahl.
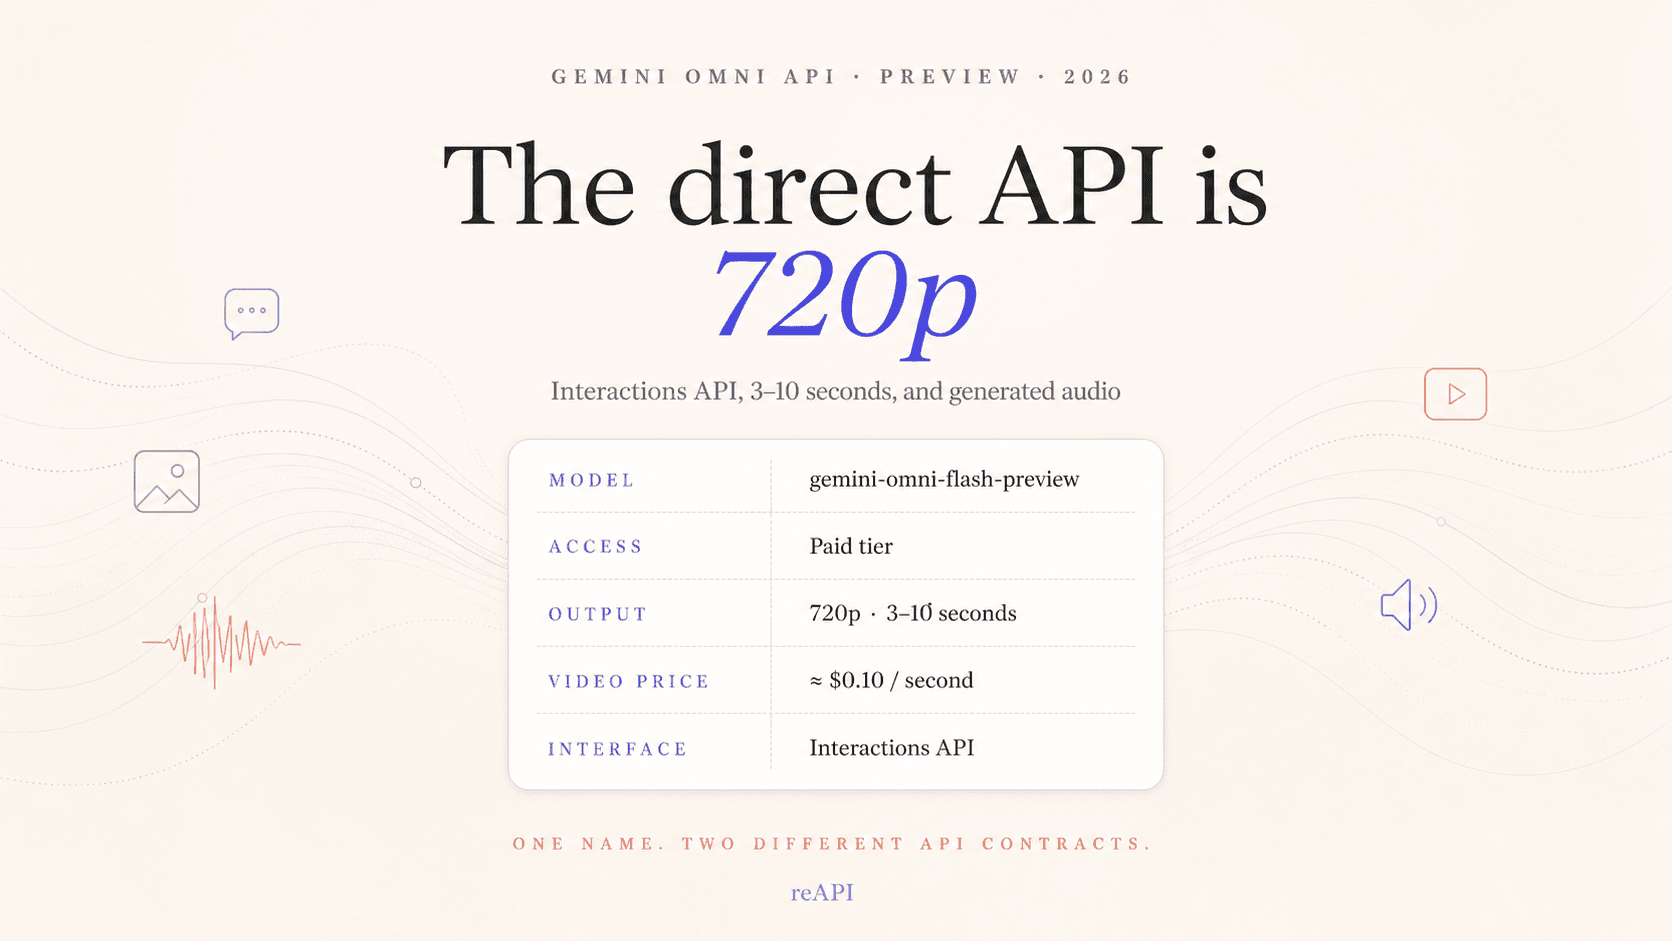
Gemini Omni API: Preisgestaltung und Spezifikationen
Google Gemini Omni API Preview: Modell-ID, Interactions API, 720p-Ausgabe, Preisgestaltung, Eingabelimits, Multi-Turn-Bearbeitung und reAPI-Unterschiede.