· reAPI Team
Gemini 4 Argon vs Opus 5.5 : le test viral contesté
Gemini 4 Argon vs Opus 5.5 : le test des oursons a suscité des répliques. Retour sur la démo, les reproductions rapportées et les réponses de son auteur.
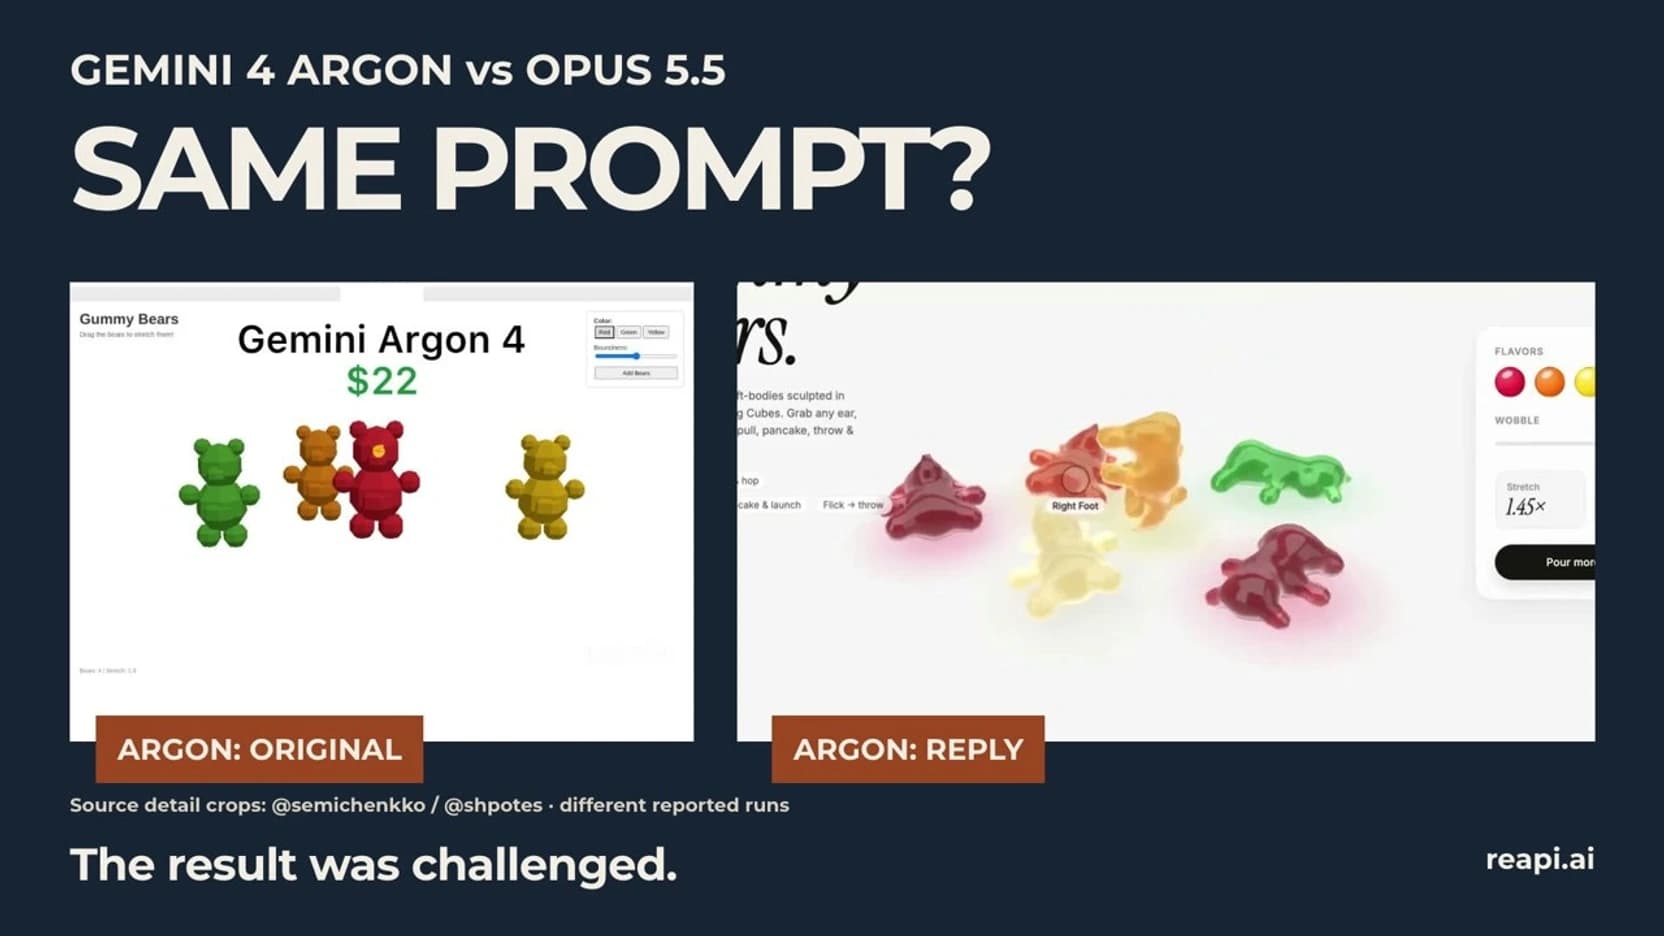
Une simulation d'oursons gélifiés a transformé Gemini 4 Argon vs Opus 5.5 en débat sur ce qu'une démo de programmation permet réellement de prouver. Dans une comparaison publiée par Semichenko, le résultat étiqueté Claude Opus 5.5 s'étirait et se comprimait de façon plus convaincante que celui étiqueté Gemini 4 Argon. Le créateur affirmait que les deux avaient reçu le même prompt[1]. Un autre développeur a ensuite publié un résultat d'Argon visiblement différent, en indiquant lui aussi avoir utilisé ce prompt[2].
La suite compte autant que le clip initial : Semichenko a reconnu que son essai avec Gemini avait peut-être échoué et qu'il fallait tester davantage[3]. Les publications disponibles documentent un désaccord sur des résultats précis. Elles ne tranchent pas le classement général des modèles. Voici les éléments disponibles, la réponse de l'auteur et une méthode pratique pour juger la prochaine comparaison.
En bref
- La publication initiale de Semichenko présente deux simulations interactives d'oursons gélifiés et indique qu'un prompt identique a été utilisé. Le contraste visuel frappant concerne ces essais rapportés[1].
- @shpotes rapporte un résultat différent avec Argon dans Antigravity. Cet exemple remet en cause l'idée que le premier clip établirait les limites d'Argon[2].
- L'auteur initial a explicitement envisagé un échec de l'essai Gemini et appelé à poursuivre les tests[3].
- Dans une autre réponse, l'auteur a proposé de retenir le meilleur de trois essais pour chaque modèle la prochaine fois. Il s'agissait d'une méthode proposée, pas d'une nouvelle comparaison déjà réalisée[4].
- Notre vidéo complémentaire revient sur ces exemples de tiers. reAPI n'a pas réalisé de nouveau benchmark contrôlé ni vérifié indépendamment les configurations complètes et les coûts annoncés[5].
Regarder la comparaison et les réponses
Notre vidéo de 2 minutes et 18 secondes suit la démonstration initiale, la reproduction rapportée et les réponses de l'auteur. Elle complète cette analyse, avec les sources indiquées dans la description[5].
Accède directement à la démonstration initiale à 0:19, à la reproduction rapportée à 0:46 ou à la réponse de l'auteur à 1:11.
Les images portent sur du code qui produit une simulation interactive. Il faut donc l'évaluer comme une tâche de programmation. Filmer l'animation obtenue n'en fait pas un comparatif de modèles de génération de vidéo à partir de texte. L'image de couverture ci-dessus reprend la miniature de notre vidéo ; consulte la vidéo et les publications sources pour examiner les résultats rapportés.
Ce que montrait la démo Gemini 4 Argon vs Opus 5.5
La publication initiale place Opus au-dessus d'Argon et décrit une série d'interactions : tirer, comprimer, lancer et ajouter d'autres oursons. Sa critique associe la déformation des objets, leurs interactions et l'aspect du matériau[1].
Il est utile d'examiner ces aspects séparément. Pour cette tâche, nous évaluerions si un ourson change de forme quand on le fait glisser, s'il reprend sa forme après avoir été relâché, si une scène chargée reste utilisable et si sa surface ressemble au matériau demandé. Ce sont des critères d'évaluation proposés, pas des mesures que nous avons recueillies dans les applications concernées.
Séparer les critères évite qu'une belle surface décide de tout le comparatif de programmation. Un spectateur peut préférer l'éclairage tout en ayant encore besoin de vérifier les interactions. À l'inverse, un objet moins soigné visuellement peut satisfaire une exigence fonctionnelle. Définis les exigences importantes avant de choisir le clip gagnant.
Il faut également distinguer l'évaluation du résultat présenté de l'explication de sa cause. Un enregistrement peut étayer une observation limitée à ce qui apparaît à l'écran. Établir la cause demanderait les instructions, le projet généré, l'historique d'exécution et les réglages. Nous n'avons pas obtenu de dossier complet et comparable pour les deux essais initiaux ; nous ne pouvons donc pas isoler le modèle comme cause de cet écart.
Comment les reproductions rapportées ont changé le débat
@shpotes a décrit son résultat ainsi, en traduction : « Le même prompt a donné un résultat radicalement différent avec Argon + Antigravity. » La démonstration jointe montre des étirements et des déformations dans le résultat attribué à Argon[2]. Elle donne une raison concrète de se demander si le premier résultat représente ce qu'Argon peut produire pour cette tâche.
Une autre publication de @Caxvalencia porte la mention « Argon - Medium » et présente un exemple d'interaction supplémentaire[6]. Cette mention correspond au réglage déclaré par l'auteur. Elle ne démontre pas indépendamment que les instructions, les fichiers de départ ou la séquence d'appels d'outils étaient identiques.
| Élément public | Ce qu'il apporte | Ce qui n'est pas vérifié ici |
|---|---|---|
| Comparaison initiale de Semichenko | Un contraste visible entre deux résultats étiquetés ; l'affirmation d'un même prompt | Des historiques d'exécution complets et comparables pour les deux essais |
| Publication de suivi de @shpotes | Un résultat d'Argon dans Antigravity présenté comme issu du même prompt | L'équivalence de l'ensemble de la configuration avec la comparaison initiale |
| Exemple de @Caxvalencia | Un autre exemple d'interaction attribué à Argon, avec la mention Medium | Un protocole de reproduction entièrement équivalent |
| Réponses de Semichenko | La reconnaissance de l'incertitude et la proposition de retenir le meilleur de trois essais | Les résultats d'une comparaison achevée suivant cette proposition |
Sources : les publications initiales et les réponses[1][2][3][4][6].
La publication initiale comporte aussi une Note de la Communauté qui renvoie vers des reproductions[1]. Suis ces liens et examine leurs éléments de preuve. Une note apporte du contexte supplémentaire ; ses affirmations doivent encore être confrontées aux sources sur lesquelles elles reposent.
Si l'on prend les publications de suivi telles qu'elles se présentent, elles affaiblissent l'affirmation générale selon laquelle Argon ne pourrait pas produire d'oursons déformables. Elles n'établissent ni la fréquence de réussite de chaque modèle, ni les interventions nécessaires, ni celui qui fera mieux sur une autre tâche de programmation. Un contre-exemple solide peut remettre en cause une affirmation absolue sans établir un classement général.
La réponse de l'auteur fait partie du récit
Semichenko a écrit, en traduction : « Hmm, peut-être que mon Gemini a échoué, il faut que je teste davantage »[3]. Dans une réponse antérieure, il remerciait une autre personne ayant testé le modèle et proposait de retenir le meilleur de trois essais pour chacun lors d'une future comparaison[4].
Cette réponse précise la portée du désaccord. Il n'est pas nécessaire de faire comme si l'écart visuel initial avait disparu, et ces publications ne permettent pas d'attribuer une intention de tromper. L'auteur a reconnu une incertitude au sujet de son essai. Les lecteurs devraient voir cette reconnaissance en même temps que le clip qu'on leur demande de juger.
Retenir le meilleur de trois essais répondrait à une question précise : quelle qualité chaque modèle peut-il produire en trois tentatives selon les règles choisies ? Si seul l'essai gagnant était montré, la fiabilité dès la première tentative resterait inconnue. Pour un futur test, nous publierions tous les essais en identifiant celui qui a été retenu, afin de laisser accessibles à la fois le meilleur résultat et la trace des échecs.
Une façon plus utile de comparer les résultats de programmation
Ce qui suit est une proposition éditoriale de protocole. Nous ne l'avons pas exécutée et elle ne reconstitue pas les sessions privées des créateurs. Son objectif est de rendre le prochain résultat plus facile à interpréter.
Conserver le point de départ complet. Garde le prompt exact, les pièces jointes, le projet initial et les instructions supplémentaires. Si le test commence dans un dossier vide, précise-le. Copier un prompt dans un autre projet ne suffit pas à établir que les modèles ont reçu un contexte équivalent.
Consigner l'environnement et les réglages. Indique le modèle, l'application ou l'agent de programmation, les outils disponibles et les réglages réellement utilisés. Garde si possible la trace de la requête ou de la session. Note comme inconnu un réglage que tu ne connais pas ; ne le déduis pas de la qualité apparente du résultat. La mention d'Antigravity dans la publication de suivi est un détail utile, mais elle ne comble pas les informations manquantes sur les autres sessions.
Fixer les règles des tentatives à l'avance. Détermine si la comparaison porte sur les premiers essais, sur un nombre fixe de tentatives ou sur l'achèvement dans un budget défini. Applique les mêmes règles d'intervention. Si un résultat a nécessité un prompt de correction, publie-le et comptabilise le travail supplémentaire, au lieu de présenter l'application finale comme une première réponse restée intacte.
Effectuer les mêmes vérifications d'interaction. Pour cette tâche d'oursons gélifiés, définis une séquence reproductible : tirer sur un membre, le relâcher, comprimer le corps, déplacer un ourson contre un autre et ajouter plusieurs objets. Consigne si chaque interaction demandée fonctionne, où elle échoue et si l'application reste utilisable. C'est une liste de critères de validation proposée, pas une affirmation selon laquelle les simulations montrées reproduisent des matériaux physiquement exacts.
Séparer la qualité de la dépense jusqu'à l'évaluation de la tâche. Le clip initial contient des chiffres de coût déclarés par son créateur. Nous n'avons pas vérifié indépendamment les justificatifs de facturation ni l'ensemble du travail correspondant[5]. Pour ton propre test, conserve la consommation et le coût de chaque tentative incluse, puis compare la dépense selon les mêmes critères de validation. Une tentative ratée fait aussi partie du dossier d'évaluation.
Si tu souhaites réaliser une évaluation via reAPI, consulte la page du modèle Gemini 4 Argon et la page du modèle Claude Opus 5.5 pour les informations et tarifs actuels. Ces pages sont des points de départ pour ta propre configuration ; elles ne reproduisent pas les outils ni les sessions montrés dans les publications sur les réseaux sociaux.
Pour la question distincte des benchmarks publiés, consulte notre comparatif de Gemini 4 Argon, GPT-6 Astra et Claude Opus 5.5. Il porte sur un tableau de benchmarks des fournisseurs correspondant à une date donnée. Cet article traite du désaccord précis autour des oursons gélifiés.
FAQ
Le test viral a-t-il prouvé qu'Opus 5.5 programme mieux ?
Il présente un résultat favorable à Opus dans cette comparaison visuelle précise. Les publications examinées ne fournissent pas d'évaluation contrôlée et répétée établissant un avantage général en programmation[1][3].
La reproduction avec Argon utilisait-elle le même prompt ?
@shpotes l'affirme explicitement. C'est une déclaration attribuée à cette source. Nous n'avons pas vérifié indépendamment tout le contenu du prompt, le contexte, les réglages et les étapes d'exécution par rapport aux sessions initiales[2].
La reproduction prouve-t-elle qu'Argon gagne à la place ?
Ces exemples ne permettent pas de désigner un gagnant général. La reproduction rapportée remet en cause la conclusion tirée du premier résultat d'Argon ; elle n'établit ni un taux de réussite ni un avantage sur l'ensemble des tâches de programmation[2].
Le créateur a-t-il reconnu les critiques ?
Oui. Semichenko a indiqué que l'essai Gemini avait peut-être échoué et qu'il fallait tester davantage. Il a également proposé de retenir le meilleur de trois essais lors d'une future comparaison[3][4].
S'agissait-il d'un test de génération de vidéo par IA ?
Les exemples publiés concernent des simulations interactives créées par programmation. Notre vidéo commente les enregistrements de ces résultats. Elle ne compare pas des modèles de génération de vidéo à partir de texte[5].
reAPI a-t-il refait le benchmark ?
Non. Cet article et la vidéo liée analysent des essais rapportés par des tiers. Nous n'avons pas reproduit indépendamment les configurations complètes, examiné l'intégralité des justificatifs de facturation ni produit de nouveau score de benchmark[5].
Ce qu'il faut demander avant de choisir un gagnant
Commence par la démonstration initiale, puis lis le compte rendu de reproduction et la réponse de l'auteur. Si tu dois choisir un modèle, demande la configuration complète et toutes les tentatives réalisées selon une règle d'évaluation explicite. Tant que ces éléments manquent, le test des oursons Gemini 4 Argon vs Opus 5.5 reste un cas concret à examiner. Choisis un modèle pour ton travail après avoir vérifié le comportement dont tu as besoin dans des conditions que tu peux reproduire.
Références
-
Semichenko (@semichenkko). Comparaison initiale des oursons gélifiés et Note de la Communauté jointe. Consulté le 19 octobre 2026 sur x.com/semichenkko/status/2110131790136401989
-
@shpotes. Reproduction rapportée avec le même prompt dans Argon + Antigravity. Consulté le 19 octobre 2026 sur x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko). Réponse reconnaissant un possible échec de l'essai Gemini et le besoin de tester davantage. Consulté le 19 octobre 2026 sur x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko). Réponse proposant de retenir le meilleur de trois essais pour une future comparaison. Consulté le 19 octobre 2026 sur x.com/semichenkko/status/2110282000246472931
-
reAPI. Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged. Consulté le 19 octobre 2026 sur youtu.be/QR9HChbtym0
-
@Caxvalencia. Exemple d'interaction « Argon - Medium ». Consulté le 19 octobre 2026 sur x.com/Caxvalencia/status/2110170790444269766