GPT-5.6の使い方:Sol、Terra、Luna比較ガイド
GPT-5.6の使い方:Sol・Terra・Lunaの料金比較、Terminal-Benchのポイント、新しいmax・ultraモード、そして最適なtierの選び方を解説します。
GPT-5.6 Sol vs Terra vs Luna を選ぶ際は、自分の品質チェックに合格する最も安いティアから始めてください。コスト重視の大量処理には Luna、Luna のエラーや再試行のコストがアップグレードを正当化する場合は Terra、追加の能力が費用に見合う難しい専門業務には Sol を評価します。入力プロンプトが 272K トークン以下の場合、現在の OpenAI Standard の入力/出力単価は100 万トークンあたり Luna $0.20/$1.20、Terra $2/$12、Sol $4/$20です。文書上のコンテキストと出力の上限は三者で同じであり、高い料金を払ってもウィンドウは大きくなりません。[3][4][5]
以下の料金と現在の API 上限は 2026 年 10 月 23 日に確認しました。公開時の経緯と Terminal-Bench の説明は歴史的な背景として残しています。新たなベンチマークの実行結果ではなく、公開時の評価モードがすべて API パラメーターであることを約束するものでもありません。
OpenAIは2026年6月26日にGPT-5.6の限定プレビューを開始しましたが、最も奇妙だったのはほぼ誰も使用できなかったことです。アクセスはAPIとCodexを通じ、米国政府の要請に基づいた段階的ロールアウトのなか、約20の厳選パートナーに限定されました[1]。
その制限は解除されました。GPT-5.6の使い方は、いま待機ゲームではなく実践的な課題であり、答えは主に3つのtierのいずれかを選ぶことになります:Solはフラッグシップ、Terraはバランス型の主力、Lunaはコスト重視モデル。それぞれは一時的な変種ではなく、1つの世代番号の下で安定したcapability tierです。
本ガイドでは、現在の三つのティアの選び方、料金、上限に加え、公開時のベンチマークと四つの注意点、当時の ultra 評価設定、公開の進め方に影響したサイバーセキュリティ審査を説明します。
TL;DR
- 上限を共有する三つのティア。 Sol はフラッグシップ、Terra は知能とコストのバランス型、Luna はコスト重視の大量処理向けです。すべてが
max推論強度に対応します。[3][4][5] - 公開時の Terminal-Bench 2.1 表での Sol のスコア:単一エージェント時88.8%、
ultramode時91.9%。Claude Mythos 5対比での差は0.8ポイントで、ノイズ幅内です[1]。 ultraは1エージェントではなく複数エージェント。 並列でサブエージェントをオーケストレートするため、スコアは単一エージェント・ベースラインとは直接比較できません[1]。- ティア名ではなく、合格したタスクで選ぶ。 定型的な大量処理ではまず Luna を試し、失敗したタスクで Terra と比較し、改善が高い料金に見合う場合は Sol を使います。
- reAPI の短いコンテキストの入力/出力料金は、OpenAI の現在の Standard 単価の 80%:Sol $3.20 / $16.00、Terra $1.60 / $9.60、Luna $0.16 / $0.96(100 万トークンあたり、2026 年 10 月 23 日確認)。この比率は、長いコンテキストのすべての単価を表すものではありません。[8]
- 評価範囲は意図的に限定。 OpenAIはコーディング、生物学、cybersecurityのみを公開し、SWE-bench、GDPval、数学、幻覚測定は保留[1]。
gpt 5.6 sol vs terra vs luna
GPT-5.6は、2026年4月に完全に再学習されたagentic modelのGPT-5.5の後継です。GPT-5.5が1つのmodelで複数のreasoning-effortレベルを提供していたのに対し、GPT-5.6は1つの世代番号の下に3つのtierをもつfamilyとなります。OpenAIの説明は明確です:世代番号は生成を識別し、Sol、Terra、Lunaはそれぞれ独立した進化が可能な安定したcapability tierを示しています[1]。
この方針は、本リリースの最も重要な設計判断です。「どの程度スマートか」を「どの程度新しいか」から切り離しています。将来の世代がSolに手を入れないで新しいLunaを提供できますし、SolのアップグレードがTerraのすべてのユーザーにパイプラインの再テストを強制することもありません。
| Tier | ポジショニング |
|---|---|
| GPT-5.6 Sol | 複雑な専門業務向けのフラッグシップ。難しいタスクが高い単価を正当化する場合に評価 |
| GPT-5.6 Terra | 知能とコストのバランス型。Luna がタスク要件を満たさない場合に評価 |
| GPT-5.6 Luna | 高速で低コスト。大容量の定型業務向け |
gpt 5.6 context window
OpenAI は現在、GPT-5.6 の三つのティアに同じ上限を定めています。合計コンテキストウィンドウは 1,050,000 トークン、最大入力は 922,000 トークン、最大出力は 128,000 トークンです。入力上限はコンテキスト全体の大きさではありません。いずれもテキストと画像を入力し、テキストを出力します。モデルページにはストリーミング、構造化出力、関数呼び出しが掲載されています。ホスト型ツールの一覧には Responses API 用と明記されているため、すべての互換エンドポイントで同じツールが使えるという保証として読んではいけません。[3][4][5]
三者とも none、low、medium、high、xhigh、max に対応し、既定値は medium です。現在のモデルリファレンスには minimal と ultra は推論強度の値として掲載されていません。推論トークンはコンテキストを消費し、出力として課金されます。出力枠には、隠れた推論と表示される回答の両方を収める必要があります。[6]
Terminal-Bench 2.1と4つのアスタリスク
OpenAIはプレビューでコーディング、生物学、cybersecurityの3つのベンチマーク領域のみを公表し、残りはGA時点の発表に保留しています[1]。最重要はTerminal-Bench 2.1で、計画と反復とツール調整が必要なagenticコマンドラインワークフローをテストします。
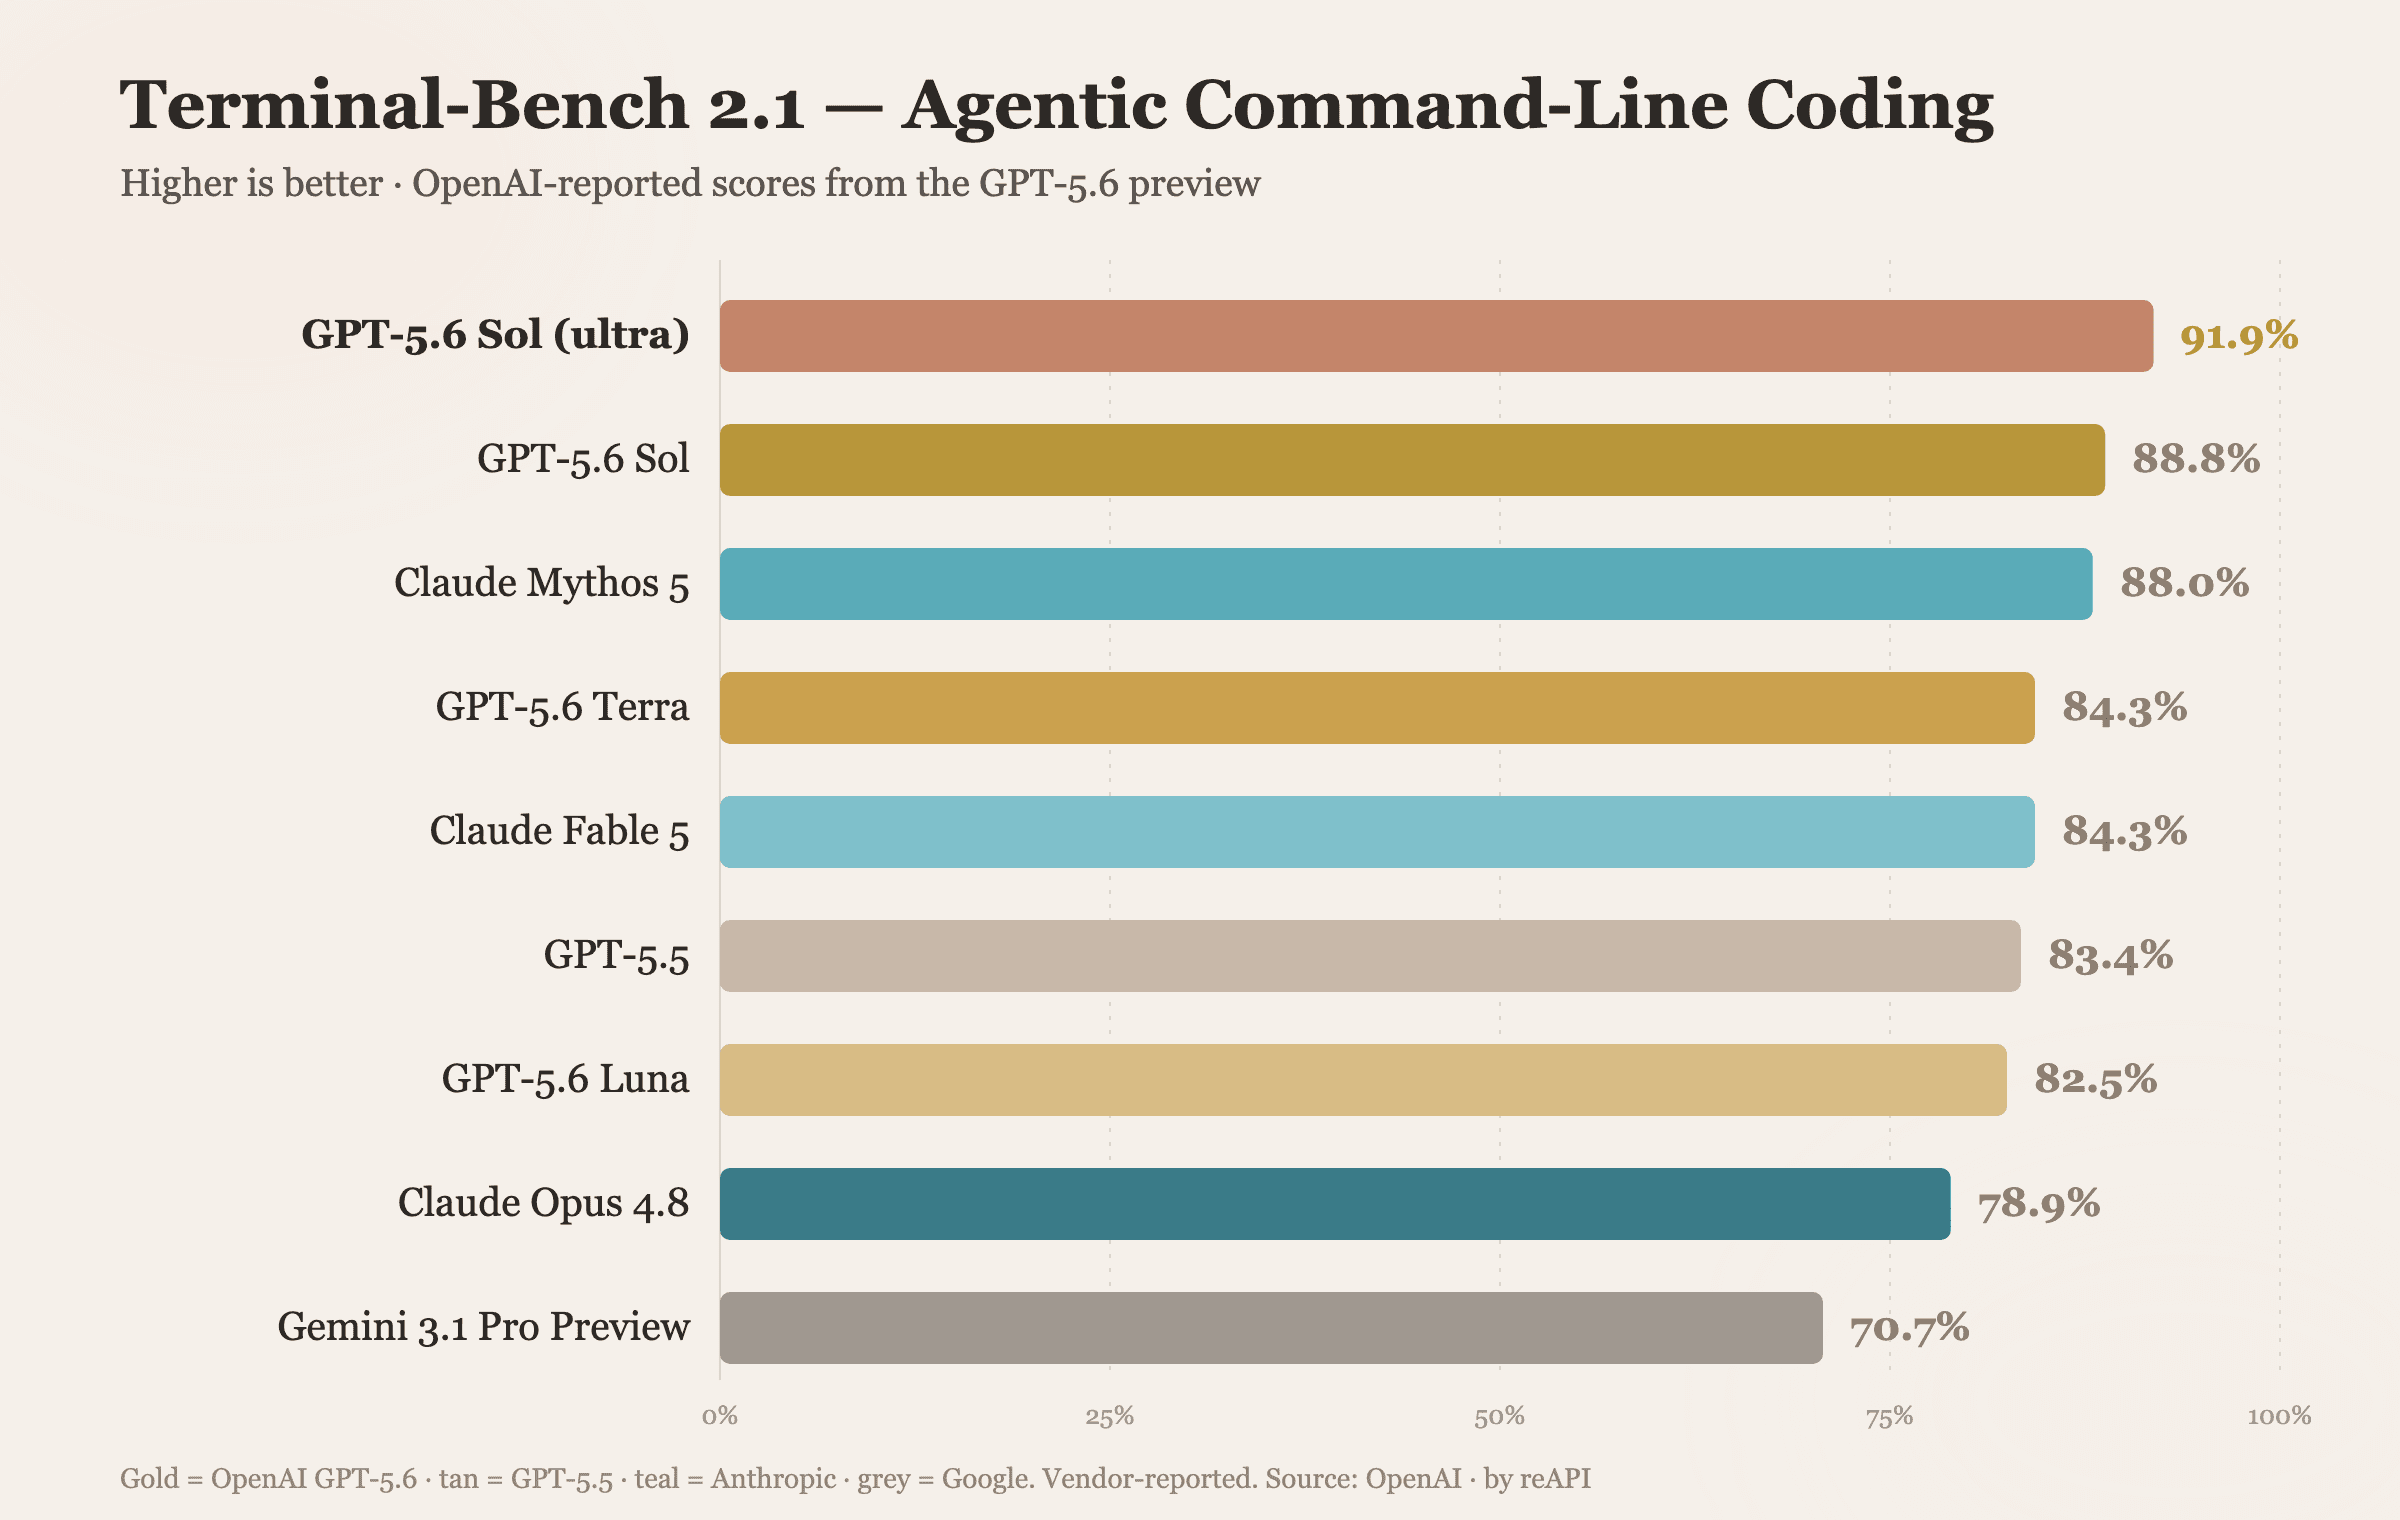
| Model | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (ultramode) | 91.9% |
| GPT-5.6 Sol | 88.8% |
| Claude Mythos 5 | 88.0% |
| GPT-5.6 Terra | 84.3% |
| Claude Fable 5 | 84.3% |
| GPT-5.5 | 83.4% |
| GPT-5.6 Luna | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
よく読む必要があります。この表は「新しいstate of the art」という見出しから想像する以上に正直です。4つの理由があります[1]。
91.9%の記録はultraを使用していますが、これは単一エージェントではなく。 Solが複数のサブエージェントをオーケストレートした結果です。単一エージェント・ベースラインとの比較はりんごとみかんです。公正な比較はSolの88.8%です。
単一エージェント・SolはClaude Mythos 5を0.8ポイント上回ります。 同じmodelの2度の実行で0.8ポイント以上の差は珍しくありません。OpenAIはコーディング曲線の頂点で実質的な利点を保有しますが、このベンチマークでは狭い差です。
TerraはClaude Fable 5と同等で、GPT-5.5をわずかに上回ります。 84.3%はFable 5と完全に一致し、前世代より1ポイント未満です。価格低下と組み合わせると、これが真の商業的価値です:公開時の料金を抑えながら、報告された Terminal-Bench の結果は近い水準でした。各種タスクで同じコーディング能力を持つ証明ではありません。
Gemini 3.1 Pro Previewは約21ポイント遅れています。 この差は実在しますが、ベンチマーク限定です。Geminiは長文コンテキスト検索やマルチモーダル作業では他で優位性を示しており、ここでは測定されていません。
生物学については、OpenAIはSolがGPT-5.5より強いGeneBench v1結果を達成し、より少ないtokenを消費していると報告します。ただし生のデータは非公表のため、検証可能なスコアではなく方向性ある主張です[1]。
maxとultra
公開時の比較では max と、マルチエージェントの評価設定 ultra が使われました。現在の API 接続では、この歴史的な名称と文書化されたパラメーター仕様を区別してください。max は Sol、Terra、Luna のすべてが対応しており、ultra は現在の六つの推論強度の値には含まれません。[3][4][5]
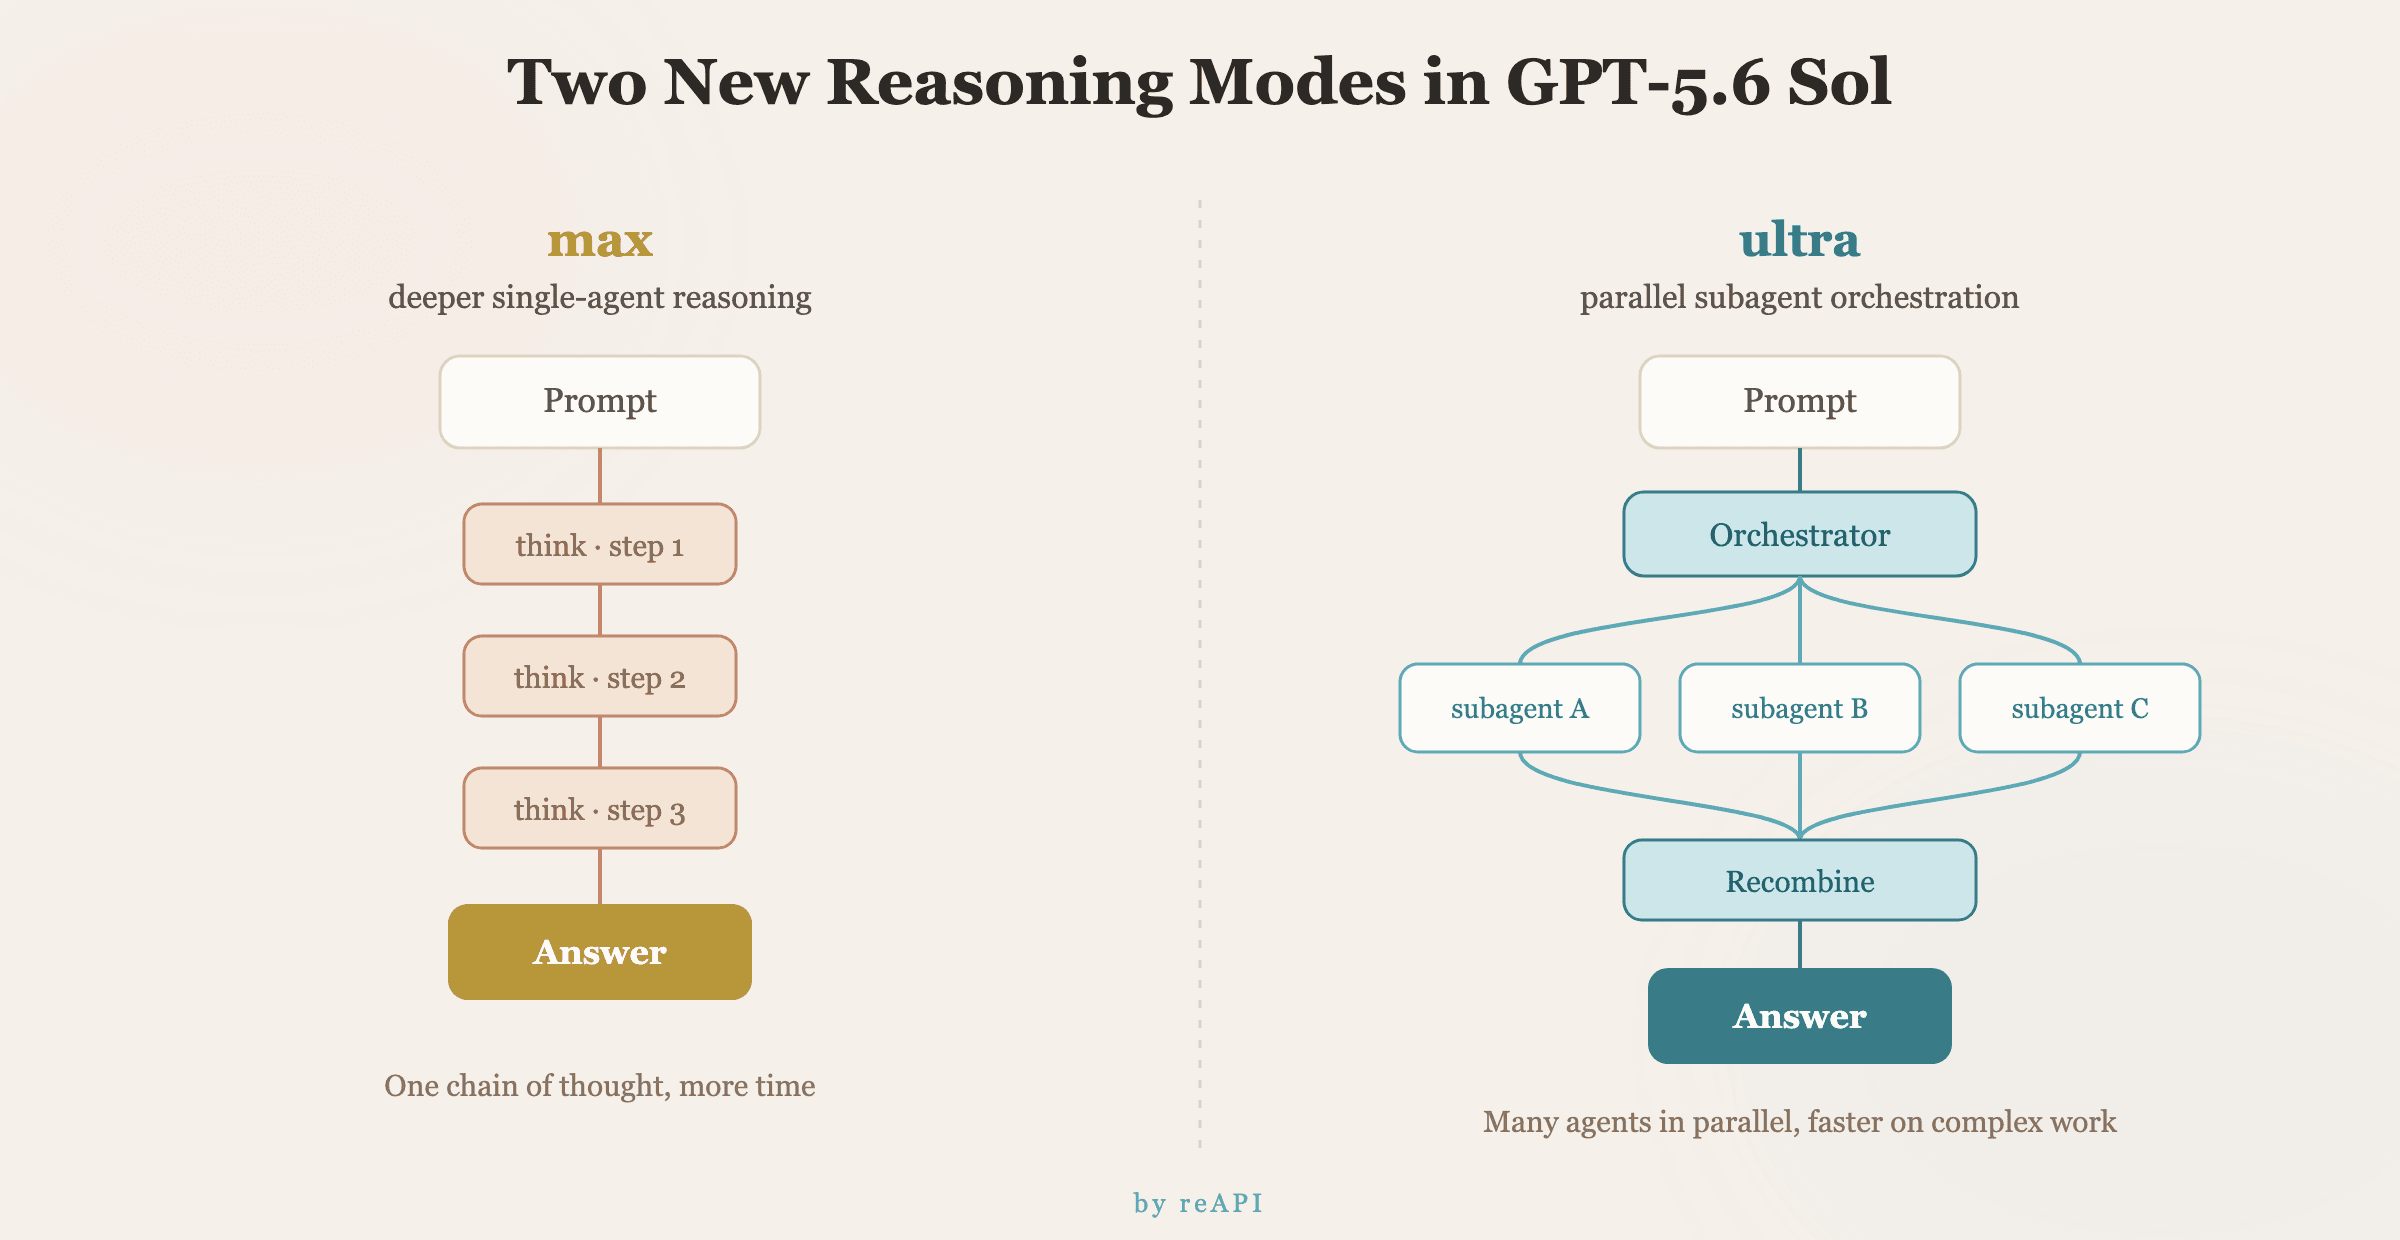
この図は公開時の比較を説明したものです。ultra のスコアはサブエージェントを使用しており、同条件の単一エージェントの結果ではありません。呼び出し可能な ultra パラメーターや、reAPI に組み込まれたオーケストレーションがあることを示すものではありません。
一方、OpenAI の現在の Responses API では、推論強度と推論モードが独立した制御として文書化されています。reasoning.mode は standard または pro を選びます。Pro モードはより多くのモデル処理を行い、その結果生じたトークンに、そのモデルの標準トークン単価を適用します。そのため、トークン単価が変わらなくても総費用は増えることがあります。GPT-5.6 の推論強度の既定値は、どちらのモードでも medium です。[6]
reAPI でこれらのモデルに使う公開ルートは Chat Completions で、reasoning_effort を使用します。リクエストにフィールドをコピーするだけで、OpenAI の Responses 専用モード、推論の永続化、ホスト型エージェント機能を有効にできると考えないでください。
gpt 5.6 pricing
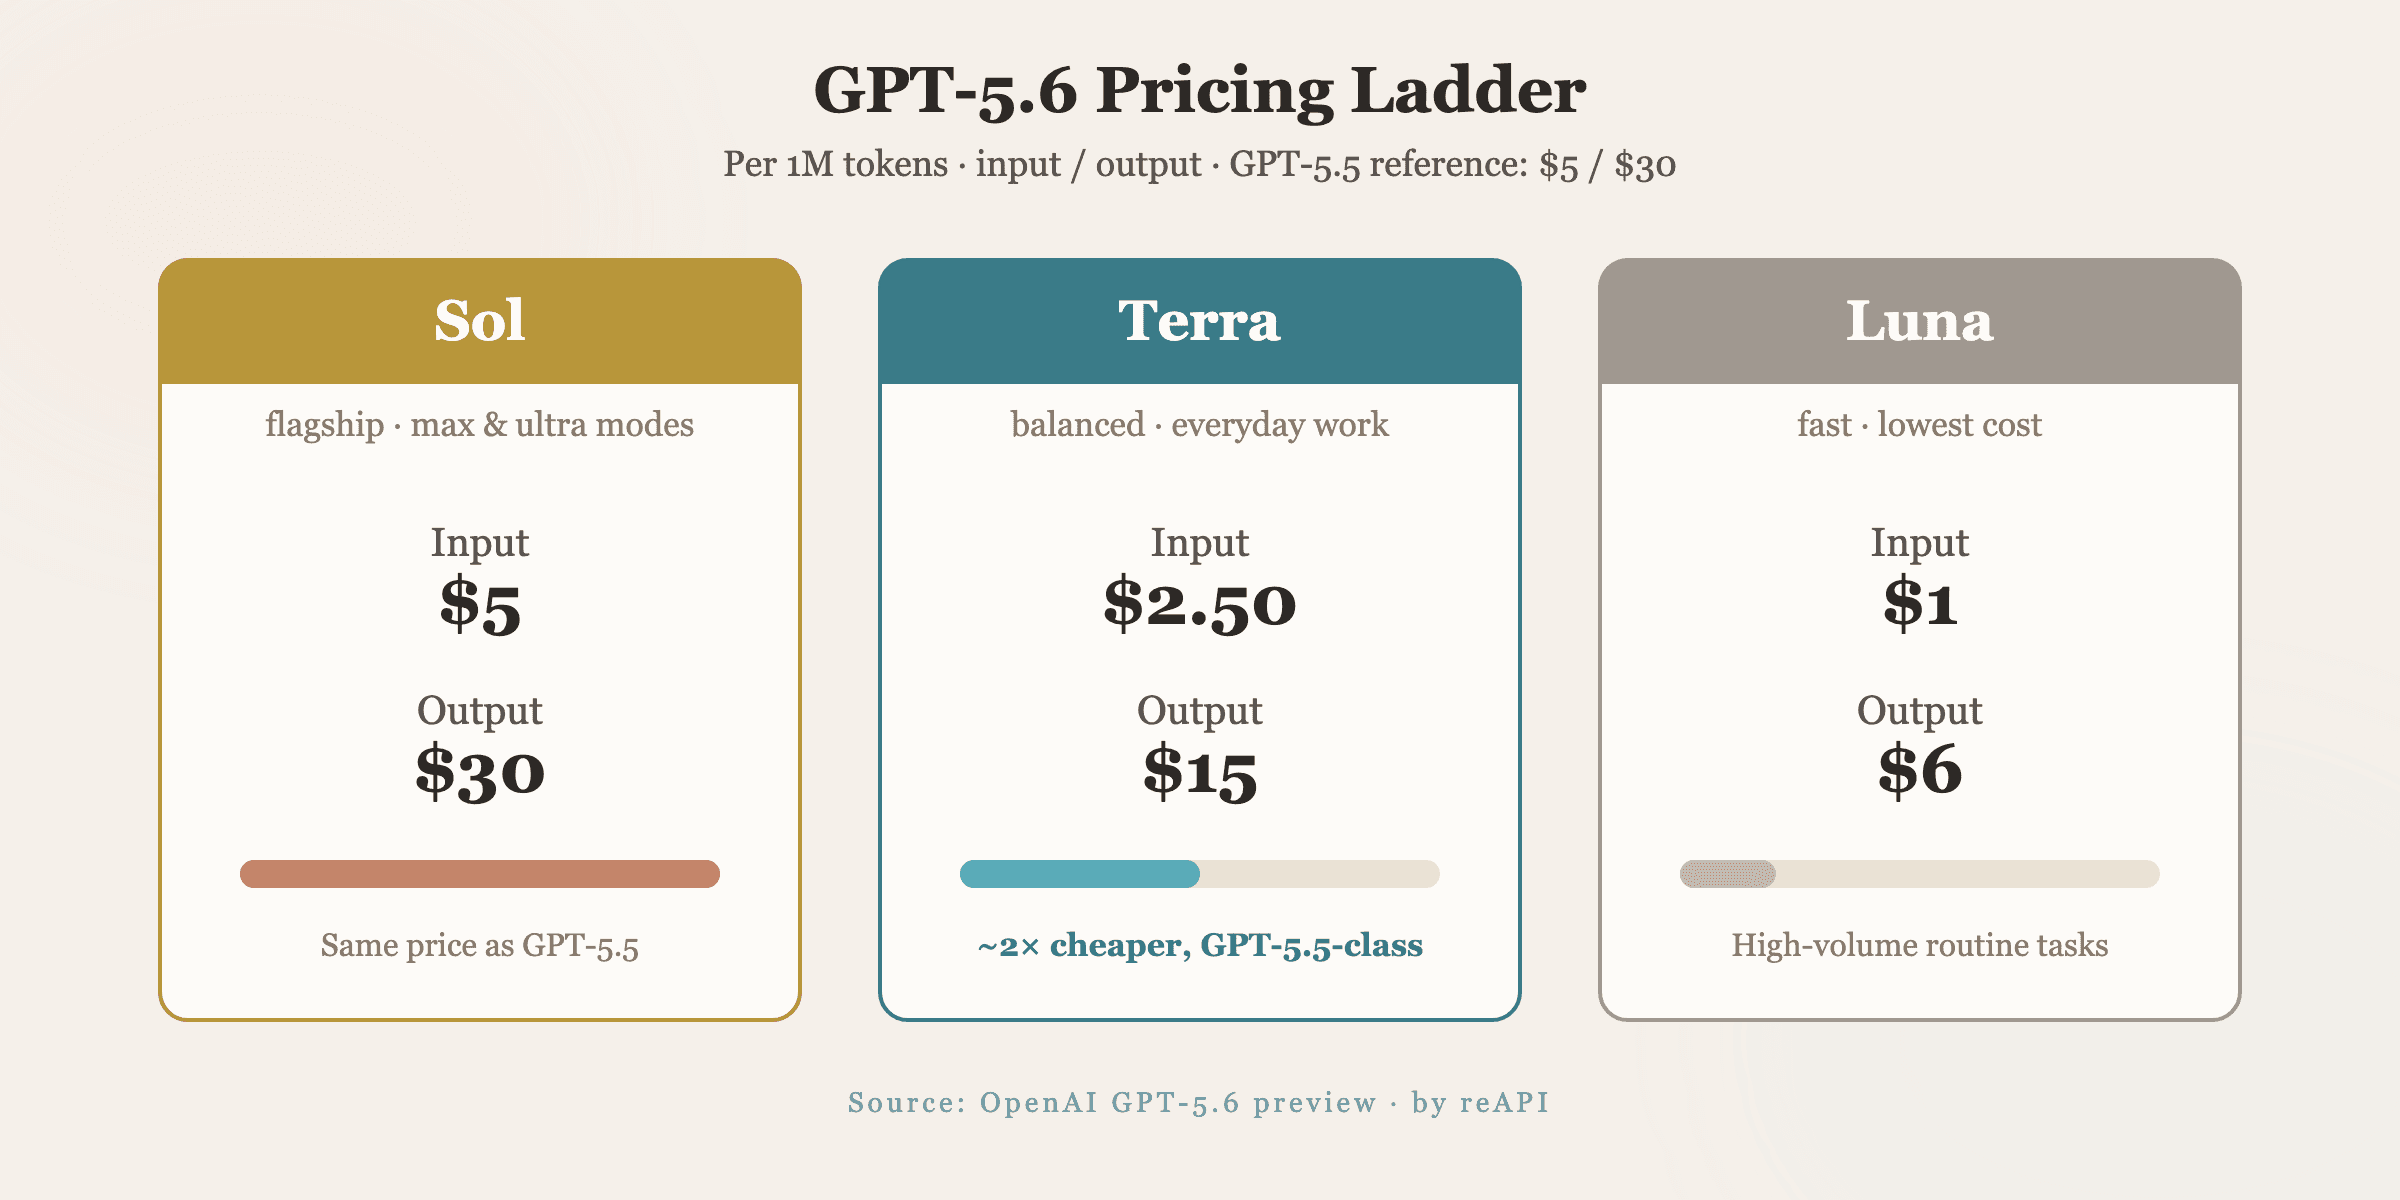
画像は公開時の料金を残したものです。以下の現在価格の列は、短いコンテキストでの 100 万トークンあたりの入力/出力料金です。すべてのプロンプトサイズや処理モードに共通する料金ではありません。[2][8]
| Tier | OpenAI 推出時の公表価(入力/出力・100万tokenあたり) | OpenAI Standard(2026年10月23日) | reAPI価格(2026年10月23日) |
|---|---|---|---|
| GPT-5.6 Sol | $5 / $30 | $4 / $20 | $3.20 / $16.00 |
| GPT-5.6 Terra | $2.50 / $15 | $2 / $12 | $1.60 / $9.60 |
| GPT-5.6 Luna | $1 / $6 | $0.20 / $1.20 | $0.16 / $0.96 |
OpenAIの推出時の数字で2つが目立ちました。SolはGPT-5.5の正確な$5/$30価格を保ったまま機能を追加。新しいmodeも付属。これは同じ価格でより多く手に入る稀なケースです。そして Terra は、公開時の Terminal-Bench で GPT-5.5 に近い結果を報告しながら、公開時の料金は低く、評価する価値がありました[1]。Solのtoken効率改善を加えれば、それは比較可能な結果をより少ないoutput tokenで達成するため、task単位の実質的なコスト削減は公表レートより大きいです。
OpenAI はその後、三つのティアすべての公表価格を引き下げました。Sol はキャンペーンで、少なくとも 2026 年 11 月 21 日まで続くとしています[2]。Sol は現在、GPT-5.5 の $5 / $30 と同額ではなく、それより低い料金です。現在の reAPI の短いコンテキストの入力/出力単価は OpenAI Standard の 80% ですが、ティア間の相対価格は変わりました。Luna の $0.20/$1.20 は Terra の $2/$12 の十分の一で、公開時の単価はこの比率ではありませんでした。Sol の 11 月の日付はキャンペーンの最低期間であり、翌日の値上げを保証するものではありません。Terra を自動的な既定の選択肢にするのではなく、測定した品質要件を満たす最も安いティアを選んでください。
入力が 272K トークンを超える場合、OpenAI は境界を超えた部分だけでなく、リクエスト全体に入力 2x、出力 1.5x の単価を適用します。現在の Standard のキャッシュ料金と長いコンテキストの料金は次のとおりです。[2]
| ティア | 短コンテキストのキャッシュ読み取り / 30m 書き込み / 12h 書き込み | 長コンテキストの入力 / 出力 | 長コンテキストのキャッシュ読み取り / 30m 書き込み / 12h 書き込み |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI は暗黙的キャッシュと明示的キャッシュに対応しています。既定の 30 分間の書き込み料金は通常入力の 1.25x で、Responses API では最低 12 時間の保持も 2.5x で選択できます。これは書き込みの総単価であり、通常入力に上乗せする追加料金ではありません。この三つのモデルの読み取りは 0.1x です。キャッシュ可能なプレフィックスの最小サイズは 1,024 トークンです。12 時間という設定は最低保持時間であり、削除期限ではありません。[7]
キャッシュなしの入力 20,000 トークンと課金対象の出力 5,000 トークンを例にすると、OpenAI Standard は (20,000 × input rate + 5,000 × output rate) / 1,000,000 で計算し、Sol $0.18、Terra $0.10、Luna $0.01 になります。reAPI の短いコンテキストの入力/出力単価では、それぞれ $0.144、$0.08、$0.008 です。固定した出力トークン数には推論を含み、ツール、税金、キャッシュ操作は除いています。これは計算例であり、タスク完了までの費用を測定したものではありません。
キャッシュなしの入力 300,000 トークンと課金対象の出力 5,000 トークンでは、OpenAI の長いコンテキストの単価がリクエスト全体に適用され、Sol $2.55、Terra $1.29、Luna $0.129 になります。低い短コンテキスト料金は適用できません。キャッシュを使用するリクエストでは、通常入力、キャッシュ読み取り、キャッシュ書き込みを分け、それぞれの単価を掛けます。キャッシュトークンを通常入力として再び数えると、請求額を過大に見積もることになります。
10 月 23 日に reAPI のページに表示された長いコンテキストの入力/出力単価は、100 万トークンあたり Sol $6.40/$24.00、Terra $3.20/$14.50、Luna $0.320/$1.440 でした。Terra の長いコンテキストの出力単価は $14.50 と表示されているため、すべての料金が「80%」だとする説明は不正確です。モデルページで正確なカテゴリを確認してください。この表は、OpenAI で選べるキャッシュ保持時間を reAPI でも利用できると約束するものではありません。[8]
上記の OpenAI の数値は Standard 処理のもので、別料金のツールやリージョン別処理の追加料金は含みません。Batch、Flex、Fast モードには別の料金表があります。あるモデルの別処理モードを、別モデルの Standard 料金と同じサービス条件として比較しないでください。[2]
ロールアウトを形作った審査
アクセスが解放された今でも理解する価値があります。これは脚注ではなく先例だからです。
OpenAIは、ローンチ前にmodelの能力をプレビューした後、米国政府の要請で初期リリースを約20の厳選パートナーに限定しました[1]。きっかけはcybersecurity能力。SolはVulnerability Researchを著しく前進させ、ChromiumとFirefoxを含む評価では、exploitの構成要素となるBugとexploitation primitiveを自動抽出しました。テスト条件下では機能的なfull-chain exploitの自動生成はしません。OpenAIはSolがPreparedness FrameworkのCyber Critical閾値を超えないと述べており、この区別がリリースの全体的理由です[1]。
注目すべきことに、OpenAIはこの配置を常設化しないと述べています。この手の政府アクセス・プロセスは長期デフォルトにはならないべきと。なぜなら、それを必要とする防御側から最良のツールを奪うからです[1]。
共に出荷されたセキュリティスタックは知る価値があります。高capability modelが今後どう出荷されるかを予示するからです:訓練済みrefusal、生成を一時停止して大きなmodelで検証できるreal-time cyberと生物学classifier、フラグ付きactivity対象のaccount層審査、最機密capabilityへの差別化アクセス。OpenAIは普遍的jailbreak対する自動化red-teamingに70万以上のA100相当GPU時間を投下[1]。
OpenAIは正直です:このsafeguardは時に失敗します。正当なsecurity研究者がdual-use requestでrefusalに遭遇することもあります。
主張が強い場所と弱い場所
強い。 Agenticコマンドラインコーディング。単一エージェント・SolがベンチマークをリードしてUltraがそれを拡張。Token効率。大容量エージェントでは複合効果が出ます。Mid-tierの価値。Terraの価格低下はリリースで最も広く有用な改善。公開時の ultra の結果はマルチエージェントのオーケストレーションを含みます。現在の reAPI 機能の約束ではなく、評価設定として解釈する必要があります[1]。
弱い。 見出しは1ベンチマーク・0.8ポイント勝利。評価範囲は意図的に狭い。SWE-bench、GDPval、数学、幻覚測定は非公表。GPT-5.6がGPT-5.5を悩ませた信頼できる幻覚問題を修正したかは不明。すべてOpenAIの自社harness下のvendor報告[1]。
拡張テストスイートと独立スコアリングが登場するまで、汎用能力への判断は保留されるべきです。
GPT-5.6の使い方:どのtierを選ぶか
品質チェックに合格するなら、コスト重視の定型的な大量処理には Luna。 代表的な分類、抽出、短い回答のタスクから始め、合格した出力、再試行、レビューの手間を記録します。低いトークン単価が役立つのは、出力が仕事の要件を満たす場合だけです。
追加の能力が料金に見合うほど結果を改善する場合は Terra。 すべての本番リクエストに中間ティアが必要だと考えず、Luna が実際に失敗したケースで比較してください。公開時のコーディングベンチマークはその評価についての証拠であり、すべてのタスクで同等の能力があることの証明ではありません。
改善が追加費用に見合う複雑な専門業務には Sol。 同じツールと受け入れ基準で、難しいコーディングや長期的なタスクをテストします。三つのティアすべてが max に対応し、高い推論強度や大きいコンテキストウィンドウは Sol 専用ではありません。ultra が対応するリクエスト値だと仮定して reAPI のティアを選ばないでください。
reAPIでGPT-5.6を呼び出す
三つのティアはいずれも、reAPI の OpenAI 互換エンドポイント https://reapi.ai/api/v1/chat/completions に登録されています。現在の reAPI ワークスペースのキーと、ティアの接尾辞が付いた正確なリクエスト用 ID を使い、OpenAI の ID にあるドットを残してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)
gpt-5.6-terra を gpt-5.6-sol または gpt-5.6-luna に置き換えることで、同じ Chat Completions の形式でティアを比較できます。OpenAI は接尾辞のない gpt-5.6 エイリアスを文書化していますが、reAPI の現在の登録は三つの接尾辞付き ID なので、ここではその正確な文字列を使用してください。reAPI の設定上の出力上限は各 128,000 トークンで、文書にある推論強度の値は none、low、medium、high、xhigh、max です。[8]
OpenAI はこのファミリーで Chat Completions と Responses の両方をサポートし、推論ワークフローには Responses を推奨しています。reAPI は /v1/responses ルートを公開していません。パラメーターの転送だけでは機能の同等性は確認できません。この Chat エンドポイントが、OpenAI のホスト型ツール群、Pro 推論モード、推論の永続化仕様を再現すると考えないでください。リンク先の reAPI エンドポイントリファレンスに接続方法があります。本記事の更新にあたり、本番の生成呼び出しは行っていません。[6][8]
現行レートはreapi.ai/models/gpt-5-6-sol、reapi.ai/models/gpt-5-6-terra、reapi.ai/models/gpt-5-6-lunaに在ります。
FAQ
maxとultra mode間の違いは何ですか?
max は、GPT-5.6 の三つのティアすべてで使える現在の推論強度の値です。過去の ultra ベンチマークはサブエージェントを使い、Terminal-Bench で注目された 91.9% を記録しましたが、現在の六つの強度の値には含まれません。OpenAI の独立した reasoning.mode: "pro" は Responses の機能であり、ultra フィールドや reAPI Chat の機能と混同しないでください。[1][3][6]
GPT-5.6 SolはコーディングでClaudeより優れていますか?
Terminal-Bench 2.1では単一エージェント・Sol 88.8%がClaude Mythos 5(88.0%)を0.8ポイント上回り。実質的ですが狭い。ultraではSol 91.9%に到達ですがサブエージェント使用のため直接比較ではありません[1]。
どのGPT-5.6 tierを使うべきですか?
定型的な大量処理には Luna、Luna では要件を満たさない場合は Terra、追加の品質が費用に見合う難しい作業には Sol を評価してください。文書上のコンテキストウィンドウ、出力上限、推論強度の段階は三者で共通です。ultra を利用できるという仮定ではなく、合格したタスクあたりの費用と独自テストで選んでください。
なぜ米国政府が関わったのですか?
SolはVulnerability Research含むcybersecurity能力を著しく前進。OpenAIのCyber Critical閾値超過なし。政府要請でOpenAIは約20の厳選パートナー向け段階的プレビューを実施。cyberフレームワーク開発と並行[1]。
GPT-5.6はGPT-5.5の幻覚問題を修正しましたか?
不明。OpenAIはプレビューでコーディング、生物学、cybersecurity評価のみ公表。幻覚と知識task測定は保留[1]。High-stakes outputはsource-grounded検証と組み合わせてください。
GPT-5.6 Solのコンテキストウィンドウ大きさは?
OpenAI の現在のドキュメントでは、合計コンテキストウィンドウは 1,050,000 トークン、最大入力は 922,000 トークン、最大出力は 128,000 トークンです。Terra と Luna も同じ上限です。以前報じられた約 1.5 百万トークンは、現在の公式仕様ではありません。[3][4][5]
Prompt Cachingで何が変わりましたか?
OpenAI は暗黙的キャッシュと明示的なキャッシュブレークポイントをサポートします。既定の 30 分間の書き込みは通常入力の 1.25x で、Responses API では最低 12 時間を 2.5x で選べます。この三つのモデルの読み取りは 0.1x です。書き込み単価は総額で、最低保持時間は削除期限ではありません。reAPI の Chat ルートが同じ設定可能なキャッシュ制御を提供するという約束ではありません。[7]
OpenAI SDKでGPT-5.6をどう呼び出しますか?
OpenAI クライアントを https://reapi.ai/api/v1 に向け、reAPI ワークスペースのキーを使い、model を gpt-5.6-sol、gpt-5.6-terra、gpt-5.6-luna のいずれかに設定します。ドットとティアの接尾辞を残してください。OpenAI の接尾辞なしエイリアスは、ここには登録されていません。[8]
3-tierリリースを読む
GPT-5.6は1つのアナウンスメント内の2つのリリースです。1つは通常の・実行されたfamily更新:合理的naming reset、公開時の価格が低く、報告された Terminal-Bench の結果が GPT-5.5 に近い中間ティア、そしてマルチエージェントのオーケストレーションを用いた公開時の ultra ベンチマーク。もう1つはfrontier model。初期可用性は政府と調整設定、70万GPU時間のsecurity stackの背後から出荷。
現在の接続では、チェックに合格する最も安いティアから始め、推論と長いコンテキストの料金境界を予算に織り込み、ワークフローに必要な API 機能を確認してください。公開時のベンチマークは今も有用な過去の証拠ですが、何をリクエストし、どう予算を組むかを決めるのは現在のモデルリファレンスと料金条件です。
世代をまたぐ比較は、GPT-6 Sol vs Luna と GPT-6 Luna vs GPT-5.6 Lunaをご覧ください。そちらでは GPT-6 への移行を扱い、本ガイドでは GPT-5.6 の三つのティア内の選択を分けて説明します。
参考文献
-
OpenAI. モデル — GPT-5.6 family、reasoning mode、仕様。 2026年7月取得 platform.openai.com/docs/models
-
OpenAI。料金:モデルとティア別のトークン単価。2026 年 7 月取得、2026 年 10 月 23 日に再確認。https://developers.openai.com/api/docs/pricing
-
OpenAI。GPT-5.6 Sol モデルリファレンス。2026 年 10 月 23 日確認。https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI。GPT-5.6 Terra モデルリファレンス。2026 年 10 月 23 日確認。https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI。GPT-5.6 Luna モデルリファレンス。2026 年 10 月 23 日確認。https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI。推論モデル:強度、モード、トークンの計量。2026 年 10 月 23 日確認。https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI。プロンプトキャッシュ:最低保持時間と書き込み/読み取り料金。2026 年 10 月 23 日確認。https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI。モデルページに表示された料金とエンドポイントリファレンス。2026 年 10 月 23 日確認。https://reapi.ai/ja/models/gpt-5-6-sol — https://reapi.ai/ja/models/gpt-5-6-terra — https://reapi.ai/ja/models/gpt-5-6-luna — https://reapi.ai/ja/docs/gpt-5-6-sol — https://reapi.ai/ja/docs/gpt-5-6-terra — https://reapi.ai/ja/docs/gpt-5-6-luna
さらに詳しく
- reAPI. Claude Opus 5の使い方。 reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. Claude Fable 5の使い方。 reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Modelカタログ。 reapi.ai/models
著者

カテゴリ
maxとultragpt 5.6 pricingロールアウトを形作った審査主張が強い場所と弱い場所GPT-5.6の使い方:どのtierを選ぶかreAPIでGPT-5.6を呼び出すFAQmaxとultra mode間の違いは何ですか?GPT-5.6 SolはコーディングでClaudeより優れていますか?どのGPT-5.6 tierを使うべきですか?なぜ米国政府が関わったのですか?GPT-5.6はGPT-5.5の幻覚問題を修正しましたか?GPT-5.6 Solのコンテキストウィンドウ大きさは?Prompt Cachingで何が変わりましたか?OpenAI SDKでGPT-5.6をどう呼び出しますか?3-tierリリースを読む参考文献さらに詳しく他の記事
最高のコード用Claudeモデルはどれか:ベンチマークで答えが変わる
コード向けClaudeモデルの選択はベンチマーク次第。Fable 5がSWE-Bench Pro首位、Opus 5がターミナルで優位、料金は1/3。
Seedance 2.5 API料金比較:四社の実価格
Seedance 2.5のAPI料金を2026年8月に四社で比較。reAPI、fal.ai、kie.ai、WaveSpeed。価格差は最大1.8倍、参照動画の課金ルール異なり、実例3つ付き。
2026年の無料AI API:何が実際に使えるのか
Google無料枠は画像・動画・音楽モデル完全除外。各プロバイダーの無料枠の実態と、2026年7月現在の公式料金・計金ルールをまとめました。