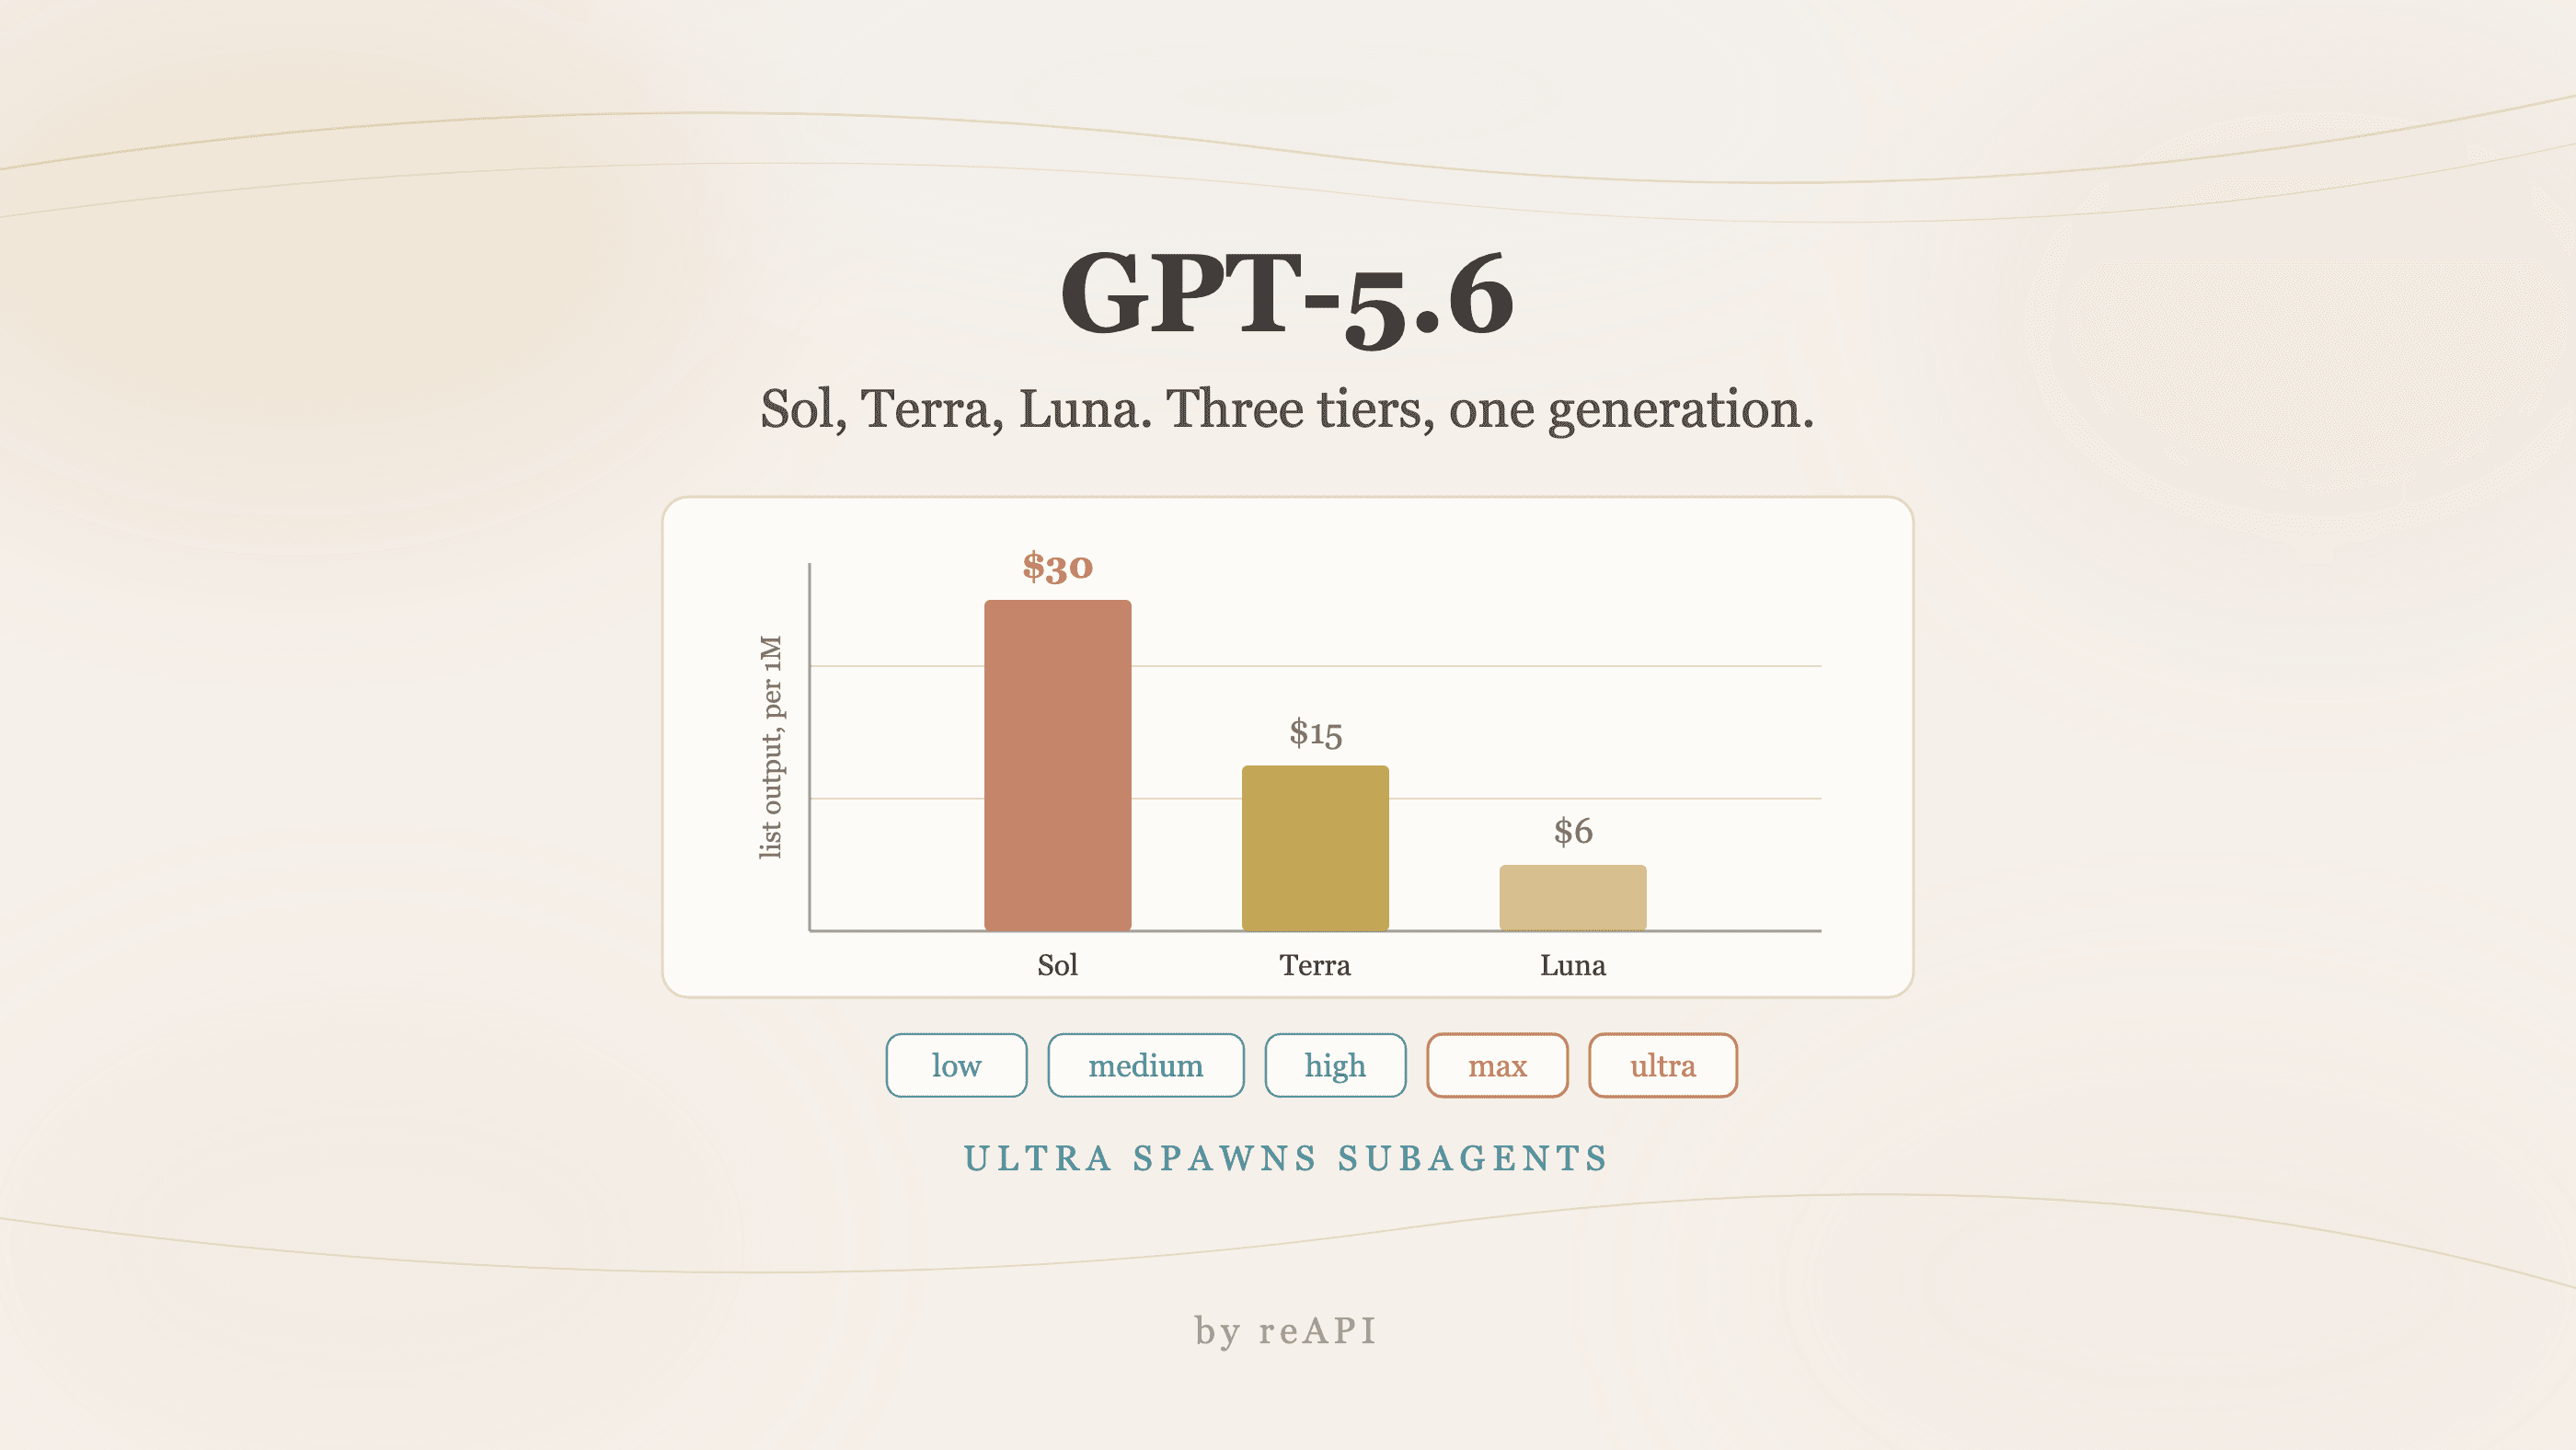
Guide d'utilisation de GPT-5.6 : niveaux Sol, Terra, Luna
Tarifs et performances des niveaux Sol, Terra et Luna, résultats Terminal-Bench 2.1, modes max et ultra, et comment choisir le bon niveau.
Pour choisir entre GPT-5.6 Sol vs Terra vs Luna, commencez par le niveau le moins cher qui satisfait vos contrôles qualité : Luna pour le volume sensible au coût, Terra lorsque les erreurs ou nouvelles tentatives de Luna justifient une montée en gamme, et Sol pour les travaux professionnels difficiles où la capacité supplémentaire est rentable. Les tarifs Standard actuels d’OpenAI par million de tokens d’entrée/sortie sont $0.20/$1.20 pour Luna, $2/$12 pour Terra et $4/$20 pour Sol, pour des prompts allant jusqu’à 272K tokens d’entrée. Les trois partagent les mêmes limites documentées de contexte et de sortie ; payer davantage n’achète pas une fenêtre plus grande.[3][4][5]
Les prix et limites API actuels ci-dessous ont été vérifiés le 23 octobre 2026. La discussion du lancement et de Terminal-Bench est conservée comme contexte historique ; ce n’est ni une nouvelle exécution de benchmark ni la promesse que chaque mode d’évaluation du lancement constitue un paramètre API.
OpenAI a lancé une prévisualisation limitée de GPT-5.6 le 26 juin 2026, et l'aspect le plus étrange de ce lancement était que presque personne ne pouvait l'utiliser. L'accès s'est fait par environ vingt partenaires vérifiés par le biais de l'API et de Codex, dans un déploiement progressif que le gouvernement américain a demandé, selon OpenAI[1].
Cette restriction a été levée depuis. Comprendre comment utiliser GPT-5.6 est maintenant une question pratique plutôt qu'un jeu d'attente, et la réponse porte surtout sur le choix de l'un des trois niveaux : Sol l'incontournable, Terra le cheval de trait équilibré, et Luna le niveau budgétaire. Chacun est un niveau de capacité durable sous un numéro de génération unique, pas une variante temporaire.
Ce guide couvre le choix actuel entre les trois niveaux, les prix et les limites, ainsi que le benchmark du lancement et ses quatre astérisques, la configuration historique d’évaluation ultra et l’examen de cybersécurité qui a déterminé le déploiement.
TL;DR
- Trois niveaux aux limites communes. Sol est le modèle phare, Terra équilibre intelligence et coût, et Luna vise le volume sensible au coût. Les trois prennent en charge l’effort de raisonnement
max.[3][4][5] - Dans le tableau de lancement Terminal-Bench 2.1, Sol obtient 88.8% en monoagent ou 91.9% en mode
ultra. Son avance monoagent sur Claude Mythos 5 est de 0.8 point, dans la marge de bruit[1]. ultran'est pas un seul agent. Il orchestre des sous-agents en parallèle, donc son score n'est pas une comparaison directe avec des références monoagent[1].- Choisissez selon les tâches acceptées, pas le nom du niveau. Testez Luna d’abord pour le volume courant, comparez Terra sur ses échecs et utilisez Sol lorsque l’amélioration couvre son surcoût.
- Sur reAPI, les prix d’entrée/sortie en contexte court représentent 80% des tarifs Standard actuels d’OpenAI : Sol $3.20 / $16.00, Terra $1.60 / $9.60, Luna $0.16 / $0.96 par million de tokens (vérifiés le 23 octobre 2026). Ce pourcentage ne décrit pas tous les tarifs de contexte long.[8]
- La fenêtre d'évaluation était volontairement étroite. OpenAI a publié le codage, la biologie et la cybersécurité uniquement, en retenant les chiffres SWE-bench, GDPval, mathématiques et hallucinations[1].
gpt 5.6 sol vs terra vs luna
GPT-5.6 succède à GPT-5.5, le modèle agentique entièrement réentraîné d'avril 2026. Où GPT-5.5 était un modèle unique avec des niveaux d'effort de raisonnement, GPT-5.6 est une famille de trois niveaux sous un numéro de génération unique. Le positionnement d'OpenAI est explicite : le numéro identifie une génération, tandis que Sol, Terra et Luna identifient les niveaux de capacité durables qui peuvent progresser à leur propre rythme[1].
Cette phrase est la décision de conception la plus importante de cette version. Elle découple « à quel point c'est intelligent » de « à quel point c'est nouveau ». Une future génération pourrait lancer un nouveau Luna sans toucher à Sol, et une mise à niveau de Sol ne force pas tous les utilisateurs de Terra à refaire leurs tests de pipeline.
| Niveau | Positionnement |
|---|---|
| GPT-5.6 Sol | Modèle phare pour les travaux professionnels complexes ; à évaluer lorsque les tâches difficiles justifient le tarif supérieur |
| GPT-5.6 Terra | Équilibre intelligence/coût ; à évaluer lorsque Luna ne satisfait pas les exigences de la tâche |
| GPT-5.6 Luna | Rapide et abordable, destiné aux tâches courantes à fort volume |
gpt 5.6 context window
OpenAI documente désormais les mêmes limites pour les trois niveaux GPT-5.6 : 1,050,000 tokens de fenêtre totale de contexte, 922,000 tokens d’entrée au maximum et 128,000 tokens de sortie au maximum. Le plafond d’entrée n’est pas la fenêtre totale de contexte. Chaque modèle accepte du texte et des images en entrée et produit du texte ; les pages des modèles indiquent streaming, sorties structurées et appels de fonctions. Leurs listes d’outils hébergés sont explicitement associées à l’API Responses et ne garantissent donc pas que tout endpoint compatible expose les mêmes outils.[3][4][5]
Les trois acceptent none, low, medium, high, xhigh et max, avec medium par défaut. Les références actuelles ne répertorient pas minimal ni ultra parmi les valeurs d’effort. Les tokens de raisonnement occupent le contexte et sont facturés en sortie ; le budget de sortie doit couvrir le raisonnement caché et la réponse visible.[6]
Terminal-Bench 2.1 et ses quatre notes
OpenAI n'a publié que trois domaines de référence en prévisualisation, le codage, la biologie et la cybersécurité, en retenant explicitement le reste pour la disponibilité générale[1]. Celui qu'il veut que vous reteniez est Terminal-Bench 2.1, qui teste les workflows d'agents en ligne de commande nécessitant la planification, l'itération et la coordination des outils.
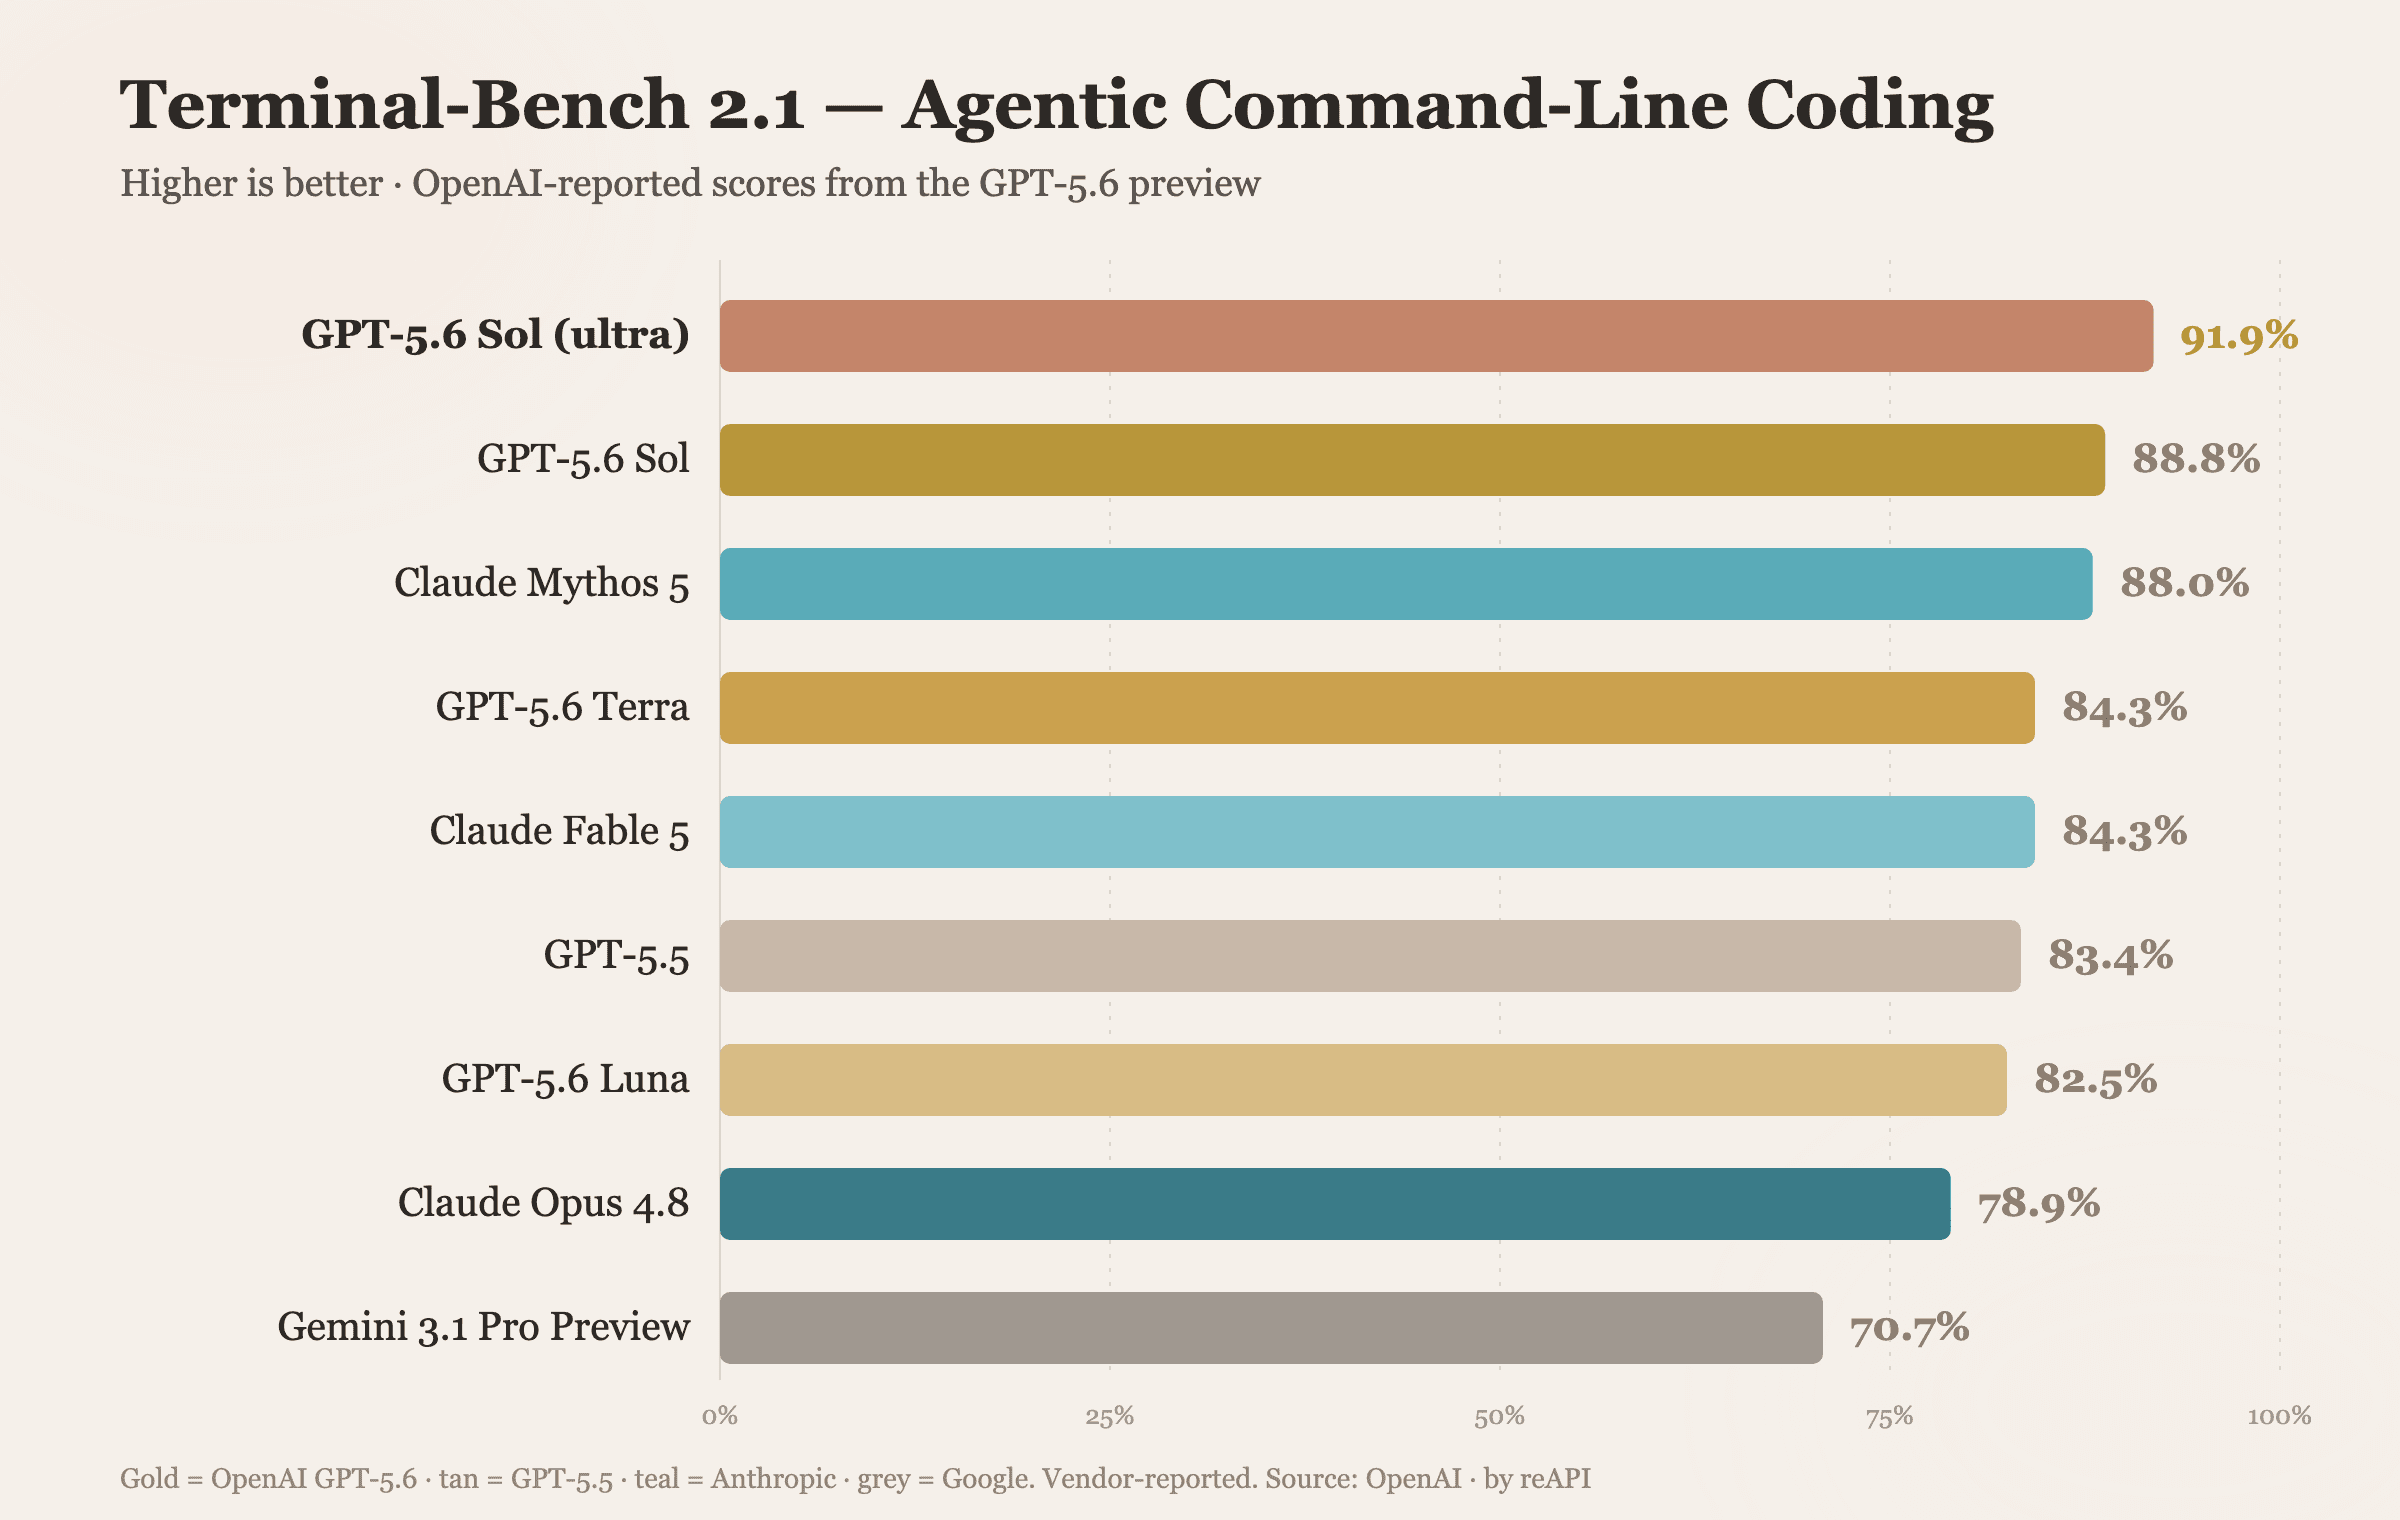
| Modèle | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (mode ultra) | 91,9 % |
| GPT-5.6 Sol | 88,8 % |
| Claude Mythos 5 | 88,0 % |
| GPT-5.6 Terra | 84,3 % |
| Claude Fable 5 | 84,3 % |
| GPT-5.5 | 83,4 % |
| GPT-5.6 Luna | 82,5 % |
| Claude Opus 4.8 | 78,9 % |
| Gemini 3.1 Pro Preview | 70,7 % |
Lisez attentivement, ce tableau est plus honnête que le titre « nouvel état de l'art » ne le suggère, de quatre façons[1].
Le record de 91,9 % utilise ultra, qui n'est pas un seul agent. Il provient de l'orchestration par Sol de sous-agents. Comparé à des références monoagent ce n'est pas une comparaison pommes avec pommes. La comparaison équitable est le 88,8 % de Sol.
Le Sol monoagent dépasse Claude Mythos 5 de 0,8 points. Deux exécutions du même modèle peuvent différer de plus que cela. OpenAI détient un réel avantage au sommet de la courbe de codage, mais sur ce référentiel c'est étroit, pas une victoire écrasante.
Terra égale Claude Fable 5 et dépasse de peu GPT-5.5. Ses 84.3% correspondent exactement à Fable 5 et dépassent de moins d’un point le modèle remplacé. Avec la baisse de prix, voilà l’intérêt commercial concret : un résultat publié similaire sur Terminal-Bench à un prix de lancement inférieur, sans preuve d’une capacité de programmation identique pour toutes les tâches.
Gemini 3.1 Pro Preview traîne d'environ 21 points. Cet écart est réel mais propre au référentiel. Gemini mène ailleurs sur la récupération à long contexte et les travaux multimodaux non montrés ici.
En biologie, OpenAI rapporte que Sol obtient des résultats GeneBench v1 plus forts que GPT-5.5 en utilisant moins de tokens, sans publier les chiffres bruts, donc c'est une affirmation directionnelle plutôt qu'un score vérifiable[1].
max et ultra
La comparaison du lancement utilisait max et une configuration d’évaluation multiagent ultra. Pour l’intégration API actuelle, distinguez cette étiquette historique du contrat documenté : Sol, Terra et Luna acceptent max, tandis que ultra ne figure pas parmi leurs six valeurs actuelles d’effort de raisonnement.[3][4][5]
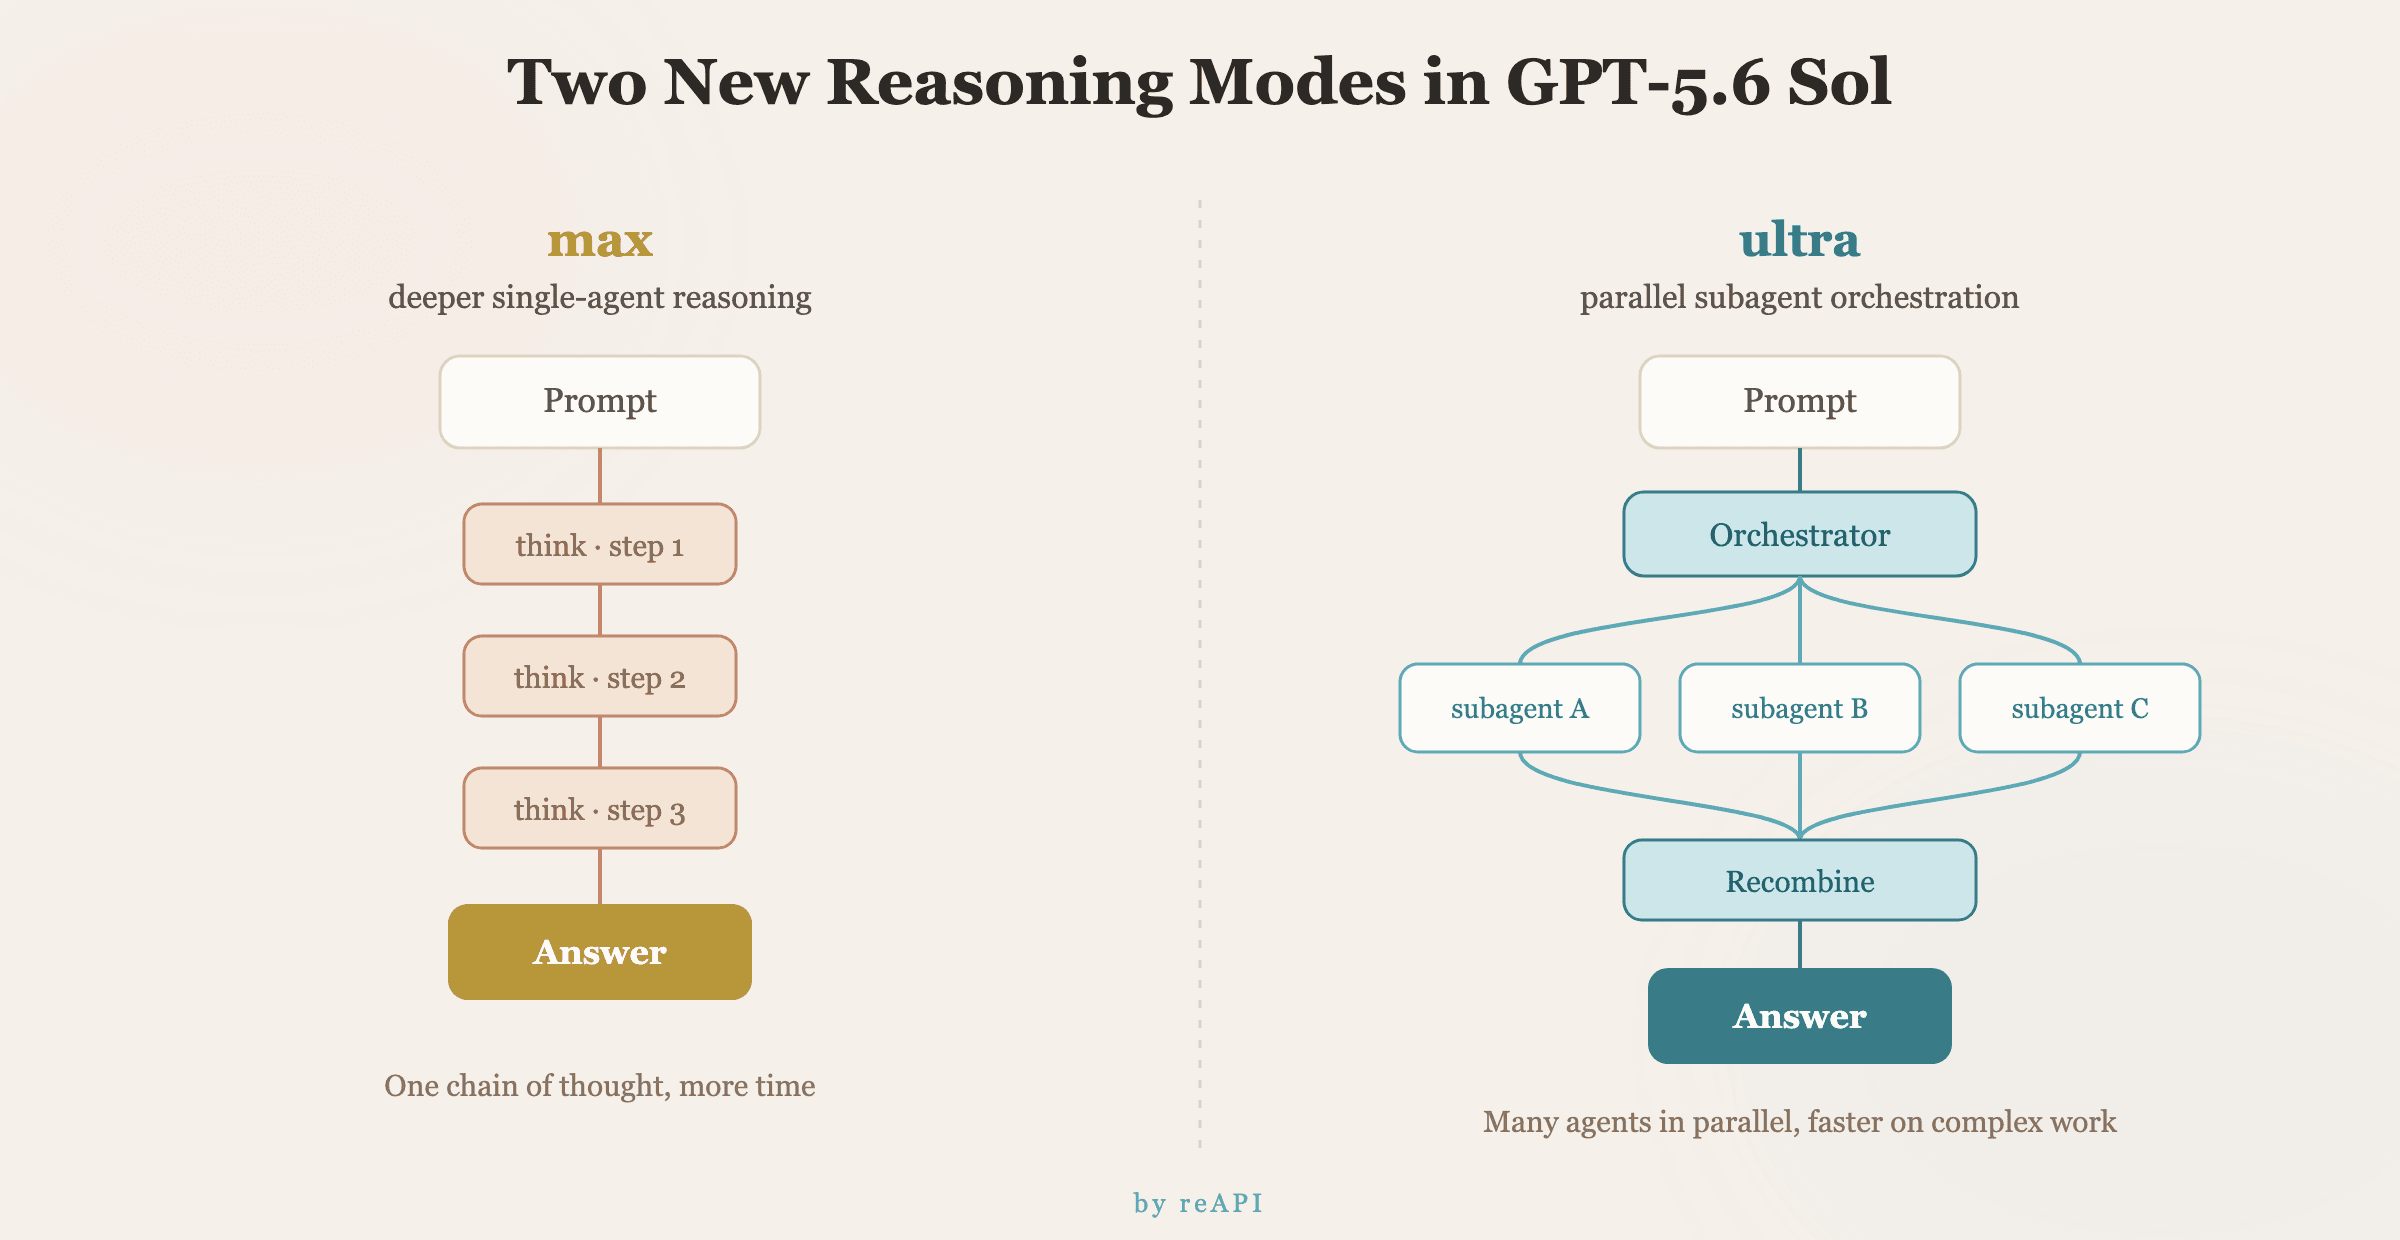
L’illustration décrit la comparaison du lancement. Le score ultra utilise des sous-agents et n’est pas directement comparable à un résultat monoagent. Il ne démontre ni l’existence d’un paramètre ultra appelable ni une orchestration intégrée via reAPI.
L’API Responses actuelle d’OpenAI documente plutôt des contrôles indépendants d’effort de raisonnement et de mode de raisonnement. reasoning.mode sélectionne standard ou pro ; le mode Pro effectue davantage de travail avec le modèle et facture les tokens produits aux tarifs standard de ce modèle. Il peut donc coûter davantage sans tarif différent par token. L’effort par défaut de GPT-5.6 est medium dans les deux modes.[6]
La route publique de reAPI pour ces modèles est Chat Completions. Elle expose reasoning_effort ; ne supposez pas que copier des champs dans cette requête active le mode réservé à Responses d’OpenAI, le raisonnement persistant ou ses fonctions d’agents hébergés.
gpt 5.6 pricing
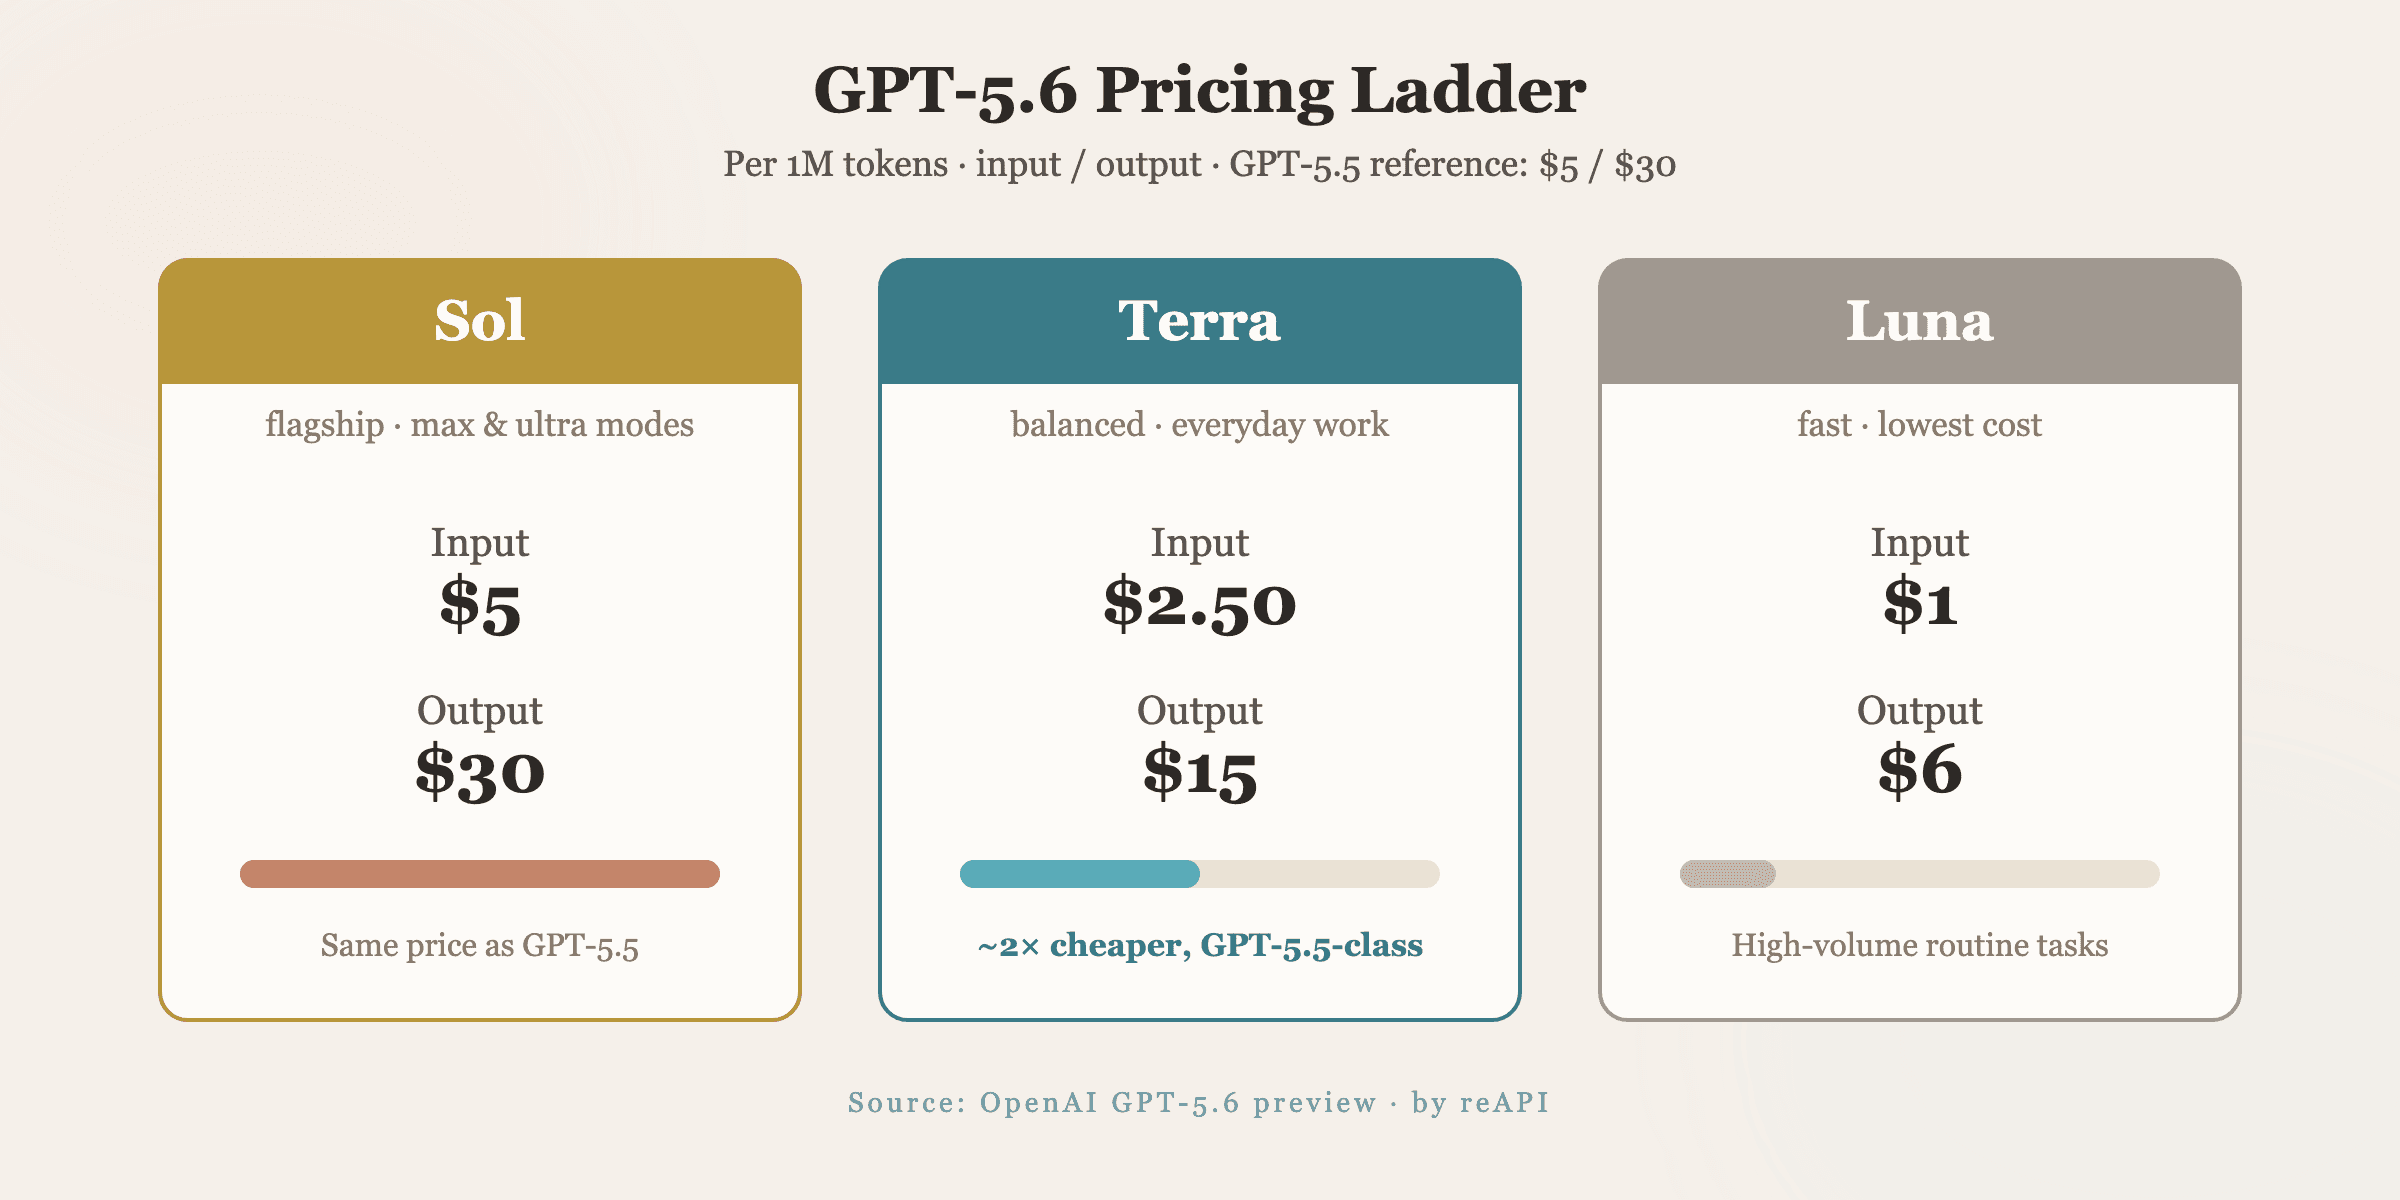
L’image conserve les prix du lancement. Les colonnes actuelles ci-dessous présentent les prix d’entrée/sortie en contexte court, par million de tokens, et non des tarifs universels pour toutes les tailles de prompt et tous les modes de traitement.[2][8]
| Niveau | Tarif OpenAI au lancement (entrée / sortie par 1M) | OpenAI Standard, 23 octobre 2026 | Sur reAPI, 23 octobre 2026 |
|---|---|---|---|
| GPT-5.6 Sol | 5 $ / 30 $ | 4 $ / 20 $ | 3,20 $ / 16,00 $ |
| GPT-5.6 Terra | 2,50 $ / 15 $ | 2 $ / 12 $ | 1,60 $ / 9,60 $ |
| GPT-5.6 Luna | 1 $ / 6 $ | 0,20 $ / 1,20 $ | 0,16 $ / 0,96 $ |
Deux éléments ressortaient des chiffres de lancement d’OpenAI. Sol conservait exactement les $5 / $30 de GPT-5.5 en ajoutant des capacités et de nouveaux modes, un cas rare de fonctionnalités supplémentaires au même prix. Terra annonçait un résultat de lancement Terminal-Bench similaire à GPT-5.5 avec des prix de lancement inférieurs, ce qui justifiait de l’évaluer[1]. Ajoutez les gains d’efficacité de Sol, qui atteint des résultats comparables avec moins de tokens de sortie, et la baisse effective du coût par tâche dépasse celle suggérée par les seuls tarifs.
OpenAI a depuis réduit les trois tarifs, celui de Sol étant une promotion annoncée au moins jusqu’au 21 novembre 2026[2]. Sol coûte désormais moins que les $5 / $30 de GPT-5.5. Les tarifs actuels d’entrée/sortie en contexte court de reAPI représentent 80% d’OpenAI Standard, mais les rapports entre niveaux ont changé : les $0.20/$1.20 de Luna valent un dixième des $2/$12 de Terra, alors que leurs prix de lancement n’avaient pas ce rapport. La date de novembre pour Sol correspond à une durée promotionnelle minimale, pas à une hausse garantie le lendemain. Choisissez le niveau le moins coûteux répondant à votre qualité mesurée plutôt que Terra par défaut.
Au-delà de 272K tokens d’entrée, OpenAI facture 2x l’entrée et 1.5x la sortie pour la requête entière, et pas seulement les tokens dépassant le seuil. Ses tarifs Standard actuels de cache et de contexte long sont les suivants :[2]
| Niveau | Cache court : lecture / écriture 30m / écriture 12h | Entrée / sortie longue | Cache long : lecture / écriture 30m / écriture 12h |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI prend en charge le cache implicite et explicite. Les écritures par défaut de 30 minutes coûtent 1.25x l’entrée ordinaire ; l’API Responses propose aussi un minimum de 12 heures à 2.5x. Ce sont des tarifs totaux d’écriture, pas des suppléments à ajouter à l’entrée ordinaire. Les lectures coûtent 0.1x sur ces trois modèles. Le préfixe minimal pouvant être mis en cache est de 1,024 tokens. Un réglage de 12 heures est une durée minimale, pas une échéance de suppression.[7]
Pour un exemple de 20,000 tokens d’entrée sans cache et 5,000 tokens de sortie facturés, OpenAI Standard coûte (20,000 × input rate + 5,000 × output rate) / 1,000,000 : Sol $0.18, Terra $0.10 et Luna $0.01. Les prix d’entrée/sortie en contexte court de reAPI donnent respectivement $0.144, $0.08 et $0.008. Ces quantités fixes incluent le raisonnement dans la sortie facturée et excluent outils, taxes et opérations de cache ; ce sont des calculs, pas des coûts mesurés de réussite de tâches.
Avec 300,000 tokens d’entrée sans cache et 5,000 tokens de sortie facturés, les tarifs longs d’OpenAI sur la requête entière donnent Sol $2.55, Terra $1.29 et Luna $0.129. Les tarifs inférieurs de contexte court ne s’appliquent plus. Pour les requêtes avec cache, séparez entrée ordinaire, lectures et écritures du cache avant d’appliquer chaque tarif ; recompter les tokens en cache comme entrée ordinaire gonflerait la facture.
Les tarifs d’entrée/sortie en contexte long affichés par reAPI le 23 octobre étaient Sol $6.40/$24.00, Terra $3.20/$14.50 et Luna $0.320/$1.440 par million de tokens. Le tarif affiché de sortie longue de Terra est $14.50 : affirmer que toutes les catégories valent « 80% » serait donc inexact. Vérifiez la catégorie précise sur la page du modèle ; ce tableau ne promet pas que reAPI offre les durées de cache sélectionnables d’OpenAI.[8]
Les chiffres OpenAI ci-dessus utilisent Standard et excluent les outils facturés séparément ainsi que les majorations de traitement régional. Batch, Flex et le mode Fast possèdent des tableaux distincts ; ne comparez pas un mode alternatif d’un modèle au tarif Standard d’un autre comme si les conditions de service étaient identiques.[2]
L'examen qui a façonné le lancement
Cette partie vaut la peine d'être comprise maintenant que l'accès s'est ouvert, car c'est un précédent plutôt qu'une note de bas de page.
OpenAI a limité la version initiale à environ vingt partenaires vérifiés à la demande du gouvernement américain, après avoir prévisualisé les capacités des modèles avant le lancement[1]. Le déclencheur était la capacité de cybersécurité. Sol progresse considérablement la recherche de vulnérabilités, et dans les évaluations impliquant Chromium et Firefox, il a identifié des bugs et des primitives d'exploitation, les éléments constitutifs d'une exploitation, sans produire de manière autonome une exploitation de chaîne complète fonctionnelle dans les conditions testées. OpenAI déclare que Sol n'atteint pas le seuil critique de cybersécurité dans son cadre de préparation, et cette distinction est l'ensemble de la base pour sa publication[1].
Notamment, OpenAI n'a pas approuvé l'arrangement comme permanent, affirmant que ce type de processus d'accès gouvernemental ne devrait pas devenir la valeur par défaut à long terme car il empêche les meilleurs outils d'atteindre les défenseurs qui en ont besoin[1].
La pile de sécurité expédiée avec elle vaut la peine d'être connue car elle préfigure comment les modèles de haute capacité seront expédiés en général : refus entraînés, des classificateurs cyber et biologie en temps réel qui peuvent suspendre la génération pour examen par un modèle plus grand, examen au niveau du compte des activités signalées, et accès différencié aux capacités les plus sensibles. OpenAI a consacré plus de 700 000 heures équivalentes GPU A100 aux tests rouges automatisés pour les jailbreaks universels[1].
OpenAI est franc que ces mesures de sauvegarde tombent mal : les chercheurs en sécurité légitime peuvent déclencher des refus sur les requêtes à double usage.
Où le cas est fort et où il est faible
Points forts. La programmation agentique en ligne de commande, où Sol monoagent domine le benchmark et ultra l’améliore. L’efficacité des tokens, qui se cumule pour les agents à fort volume. La valeur du niveau intermédiaire, où la baisse du prix de Terra constitue le changement le plus largement utile du lancement. Le résultat ultra du lancement comprend une orchestration multiagent ; il faut l’interpréter comme une configuration d’évaluation plutôt qu’une promesse de fonctionnalité reAPI actuelle[1].
Faible. Le titre est une victoire de 0,8 points sur un référentiel. La fenêtre d'évaluation était intentionnellement petite, sans chiffres SWE-bench, GDPval, mathématiques ou hallucinations publiés, donc si GPT-5.6 a résolu le problème d'hallucination confiante qui a tourmenté GPT-5.5 reste inconnu. Et tout est rapporté par le vendeur sous les propres mesures d'OpenAI[1].
Jusqu'à l'arrivée d'une suite développée et d'une notation indépendante, le jugement sur la capacité générale doit rester réservé.
Comment utiliser GPT-5.6 : quel niveau choisir
Luna pour le volume courant sensible au coût, lorsqu’il passe vos contrôles. Commencez par des tâches représentatives de classification, d’extraction ou de réponse courte, puis relevez les sorties acceptées, les nouvelles tentatives et l’effort de révision. Son prix inférieur par token n’est utile que si la sortie répond aux exigences.
Terra lorsque sa capacité supplémentaire améliore suffisamment le résultat pour justifier son prix. Comparez-le sur les véritables échecs de Luna plutôt que de supposer que toute requête de production exige le niveau intermédiaire. Le benchmark de programmation du lancement renseigne sur cette évaluation, sans prouver une capacité identique sur chaque tâche.
Sol pour les travaux professionnels complexes où l’amélioration couvre le surcoût. Testez la programmation difficile ou les tâches de longue durée avec les mêmes outils et critères d’acceptation. Les trois niveaux acceptent max ; ni l’effort supérieur ni une fenêtre de contexte plus grande ne sont exclusifs à Sol. Ne choisissez pas un niveau reAPI en supposant que ultra est une valeur de requête acceptée.
Appeler GPT-5.6 sur reAPI
Les trois niveaux sont enregistrés sur l’endpoint reAPI compatible OpenAI https://reapi.ai/api/v1/chat/completions. Utilisez la clé de votre espace de travail reAPI actuel et l’identifiant exact avec suffixe, en conservant les points d’OpenAI :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)
Remplacez gpt-5.6-terra par gpt-5.6-sol ou gpt-5.6-luna pour comparer les niveaux dans le même format Chat Completions. OpenAI documente un alias simple gpt-5.6, mais l’enregistrement reAPI actuel utilise les trois identifiants avec suffixe ; employez ici ces chaînes exactes. Le plafond de sortie configuré dans reAPI est de 128,000 tokens pour chacun, et les efforts documentés sont none, low, medium, high, xhigh et max.[8]
OpenAI prend en charge Chat Completions et Responses pour cette famille et recommande Responses pour ses processus de raisonnement. reAPI ne publie pas de route /v1/responses. La transmission de paramètres ne démontre pas une équivalence de fonctions : ne supposez pas que cet endpoint Chat reproduit les outils hébergés d’OpenAI, le mode de raisonnement Pro ou le contrat de raisonnement persistant. Les références reAPI liées décrivent son intégration ; aucune génération en production n’a été effectuée pour cette mise à jour.[6][8]
Les tarifs actuels sont sur reapi.ai/models/gpt-5-6-sol, reapi.ai/models/gpt-5-6-terra et reapi.ai/models/gpt-5-6-luna.
FAQ
Quelle est la différence entre le mode max et ultra ?
max est une valeur actuelle d’effort de raisonnement sur les trois niveaux GPT-5.6. Le résultat historique ultra utilisait des sous-agents et produisait le chiffre vedette de 91.9% sur Terminal-Bench ; ce n’est pas l’une des six valeurs d’effort actuelles. Le paramètre indépendant reasoning.mode: "pro" d’OpenAI appartient à Responses et ne doit être confondu ni avec un champ ultra ni avec une fonctionnalité Chat de reAPI.[1][3][6]
GPT-5.6 Sol est-il meilleur que Claude pour le codage ?
Sur Terminal-Bench 2.1, le Sol monoagent à 88,8 % dépasse Claude Mythos 5 à 88,0 % de 0,8 points, un avantage réel mais étroit. Avec ultra Sol atteint 91,9 %, mais cela utilise des sous-agents et n'est pas une comparaison directe monoagent[1].
Quel niveau GPT-5.6 dois-je utiliser ?
Évaluez Luna pour le volume courant, Terra lorsque Luna ne répond pas aux exigences et Sol pour les travaux difficiles où la qualité supplémentaire justifie le coût. Les trois partagent la fenêtre de contexte, le plafond de sortie et les niveaux d’effort documentés ; choisissez selon le coût par tâche acceptée et vos tests, pas selon une intégration ultra supposée.
Pourquoi le gouvernement américain était-il impliqué dans le lancement ?
Sol progresse considérablement la capacité de cybersécurité, y compris la recherche de vulnérabilités, sans atteindre le seuil critique de cybersécurité d'OpenAI. À la demande du gouvernement, OpenAI a exécuté une prévisualisation progressive à environ vingt partenaires vérifiés tandis qu'un cadre cyber était développé[1].
GPT-5.6 corrige-t-il le problème d'hallucination de GPT-5.5 ?
Inconnu. OpenAI a publié uniquement les évaluations de codage, biologie et cybersécurité en prévisualisation et a retenu les chiffres des hallucinations et des travaux de connaissance[1]. Appairez le modèle avec une vérification ancrée aux sources pour les sorties à enjeu élevé.
Quelle est la taille de la fenêtre de contexte de GPT-5.6 Sol ?
OpenAI documente désormais une fenêtre totale de contexte de 1,050,000 tokens, un maximum de 922,000 tokens d’entrée et de 128,000 tokens de sortie. Terra et Luna ont les mêmes limites. L’ancien chiffre rapporté de 1.5 million de tokens n’est pas la spécification officielle actuelle.[3][4][5]
Qu'est-ce qui a changé dans la mise en cache des invites ?
OpenAI prend en charge le cache implicite et les points de coupure explicites, avec des écritures par défaut de 30 minutes à 1.25x l’entrée ordinaire et un minimum facultatif de 12 heures dans Responses à 2.5x. Les lectures coûtent 0.1x pour ces trois modèles. Les tarifs d’écriture sont totaux et une durée minimale n’est pas une échéance de suppression ; la route Chat de reAPI ne promet pas les mêmes contrôles de cache configurables.[7]
Comment appeler GPT-5.6 avec le SDK OpenAI ?
Pointez le client OpenAI vers https://reapi.ai/api/v1, utilisez la clé de votre espace de travail reAPI et définissez model sur gpt-5.6-sol, gpt-5.6-terra ou gpt-5.6-luna. Conservez les points et le suffixe du niveau ; l’alias simple OpenAI n’est pas enregistré ici.[8]
Lire une version à trois niveaux
GPT-5.6 réunit deux lancements dans une annonce. Le premier est une mise à jour de famille classique et bien réalisée : des noms réorganisés de façon cohérente, un niveau intermédiaire aux prix de lancement plus bas avec un résultat publié Terminal-Bench similaire à GPT-5.5, et un benchmark de lancement ultra utilisant une orchestration multiagent. Le second est un modèle de pointe dont la disponibilité initiale a été coordonnée avec un gouvernement, accompagné d’un dispositif de sécurité de 700,000 heures GPU.
Pour une intégration actuelle, commencez par le niveau le moins cher qui passe vos contrôles, budgétez le raisonnement et le seuil de contexte long, puis vérifiez les fonctionnalités API nécessaires. Le benchmark du lancement reste une source historique utile, mais les références et conditions tarifaires actuelles déterminent les paramètres à demander et le budget à prévoir.
Pour comparer les générations, consultez GPT-6 Sol vs Luna et GPT-6 Luna vs GPT-5.6 Luna. Ces articles répondent à la question de migration vers GPT-6 ; ce guide conserve séparément le choix entre les trois niveaux GPT-5.6.
Références
-
OpenAI. Models — the GPT-5.6 family, reasoning modes, and specifications. Retrieved July 2026 from platform.openai.com/docs/models
-
OpenAI. Tarifs par token selon le modèle et le niveau. Consulté en juillet 2026 et revérifié le 23 octobre 2026. https://developers.openai.com/api/docs/pricing
-
OpenAI. Référence du modèle GPT-5.6 Sol. Vérifié le 23 octobre 2026. https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI. Référence du modèle GPT-5.6 Terra. Vérifié le 23 octobre 2026. https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI. Référence du modèle GPT-5.6 Luna. Vérifié le 23 octobre 2026. https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI. Modèles de raisonnement : effort, mode et comptabilisation des tokens. Vérifié le 23 octobre 2026. https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI. Cache des prompts : durée minimale et tarifs d’écriture/lecture. Vérifié le 23 octobre 2026. https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI. Prix affichés sur les pages des modèles et références des endpoints, vérifiés le 23 octobre 2026. https://reapi.ai/models/gpt-5-6-sol — https://reapi.ai/models/gpt-5-6-terra — https://reapi.ai/models/gpt-5-6-luna — https://reapi.ai/docs/gpt-5-6-sol — https://reapi.ai/docs/gpt-5-6-terra — https://reapi.ai/docs/gpt-5-6-luna
Lectures complémentaires
- reAPI. How to use Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. How to use Claude Fable 5. reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Model catalog. reapi.ai/models
Auteur

Catégories
max et ultragpt 5.6 pricingL'examen qui a façonné le lancementOù le cas est fort et où il est faibleComment utiliser GPT-5.6 : quel niveau choisirAppeler GPT-5.6 sur reAPIFAQQuelle est la différence entre le mode max et ultra ?GPT-5.6 Sol est-il meilleur que Claude pour le codage ?Quel niveau GPT-5.6 dois-je utiliser ?Pourquoi le gouvernement américain était-il impliqué dans le lancement ?GPT-5.6 corrige-t-il le problème d'hallucination de GPT-5.5 ?Quelle est la taille de la fenêtre de contexte de GPT-5.6 Sol ?Qu'est-ce qui a changé dans la mise en cache des invites ?Comment appeler GPT-5.6 avec le SDK OpenAI ?Lire une version à trois niveauxRéférencesLectures complémentairesPlus d'articles
Date de lancement de Seedance 2.5 et statut : septembre 2026
Seedance 2.5 a été lancé le 31 juillet. Vérifiez la disponibilité, les preuves du déploiement et ce que les sources officielles établissent.
Forfaits illimités Seedance 2.5 : audit mathématique
Auditez un forfait Seedance 2.5 illimité à partir de son modèle publié, fenêtre, queue, concurrence, durée et conditions d'accès, puis comparez le coût facturé.
Wan 3.0 ComfyUI : modèles de workflow, API et coûts
Configurez Wan 3.0 ComfyUI avec les workflows officiels ou un adaptateur reAPI. Comparez comptes, entrées, suivi des tâches et estimations du coût des vidéos.