Gemini 4 Argon 价格:首发价、标准价与实际成本
Gemini 4 Argon 价格详解:$2/$10 首发优惠价、$4/$20 标准价、缓存输入,以及真实任务的费用与 GPT-6 Astra、Opus 5.5 的对比。
Gemini 4 Argon 的价格有两个数字,而大多数报道只提了第一个。谷歌以首发优惠价推出该模型:每百万输入 token $2,每百万输出 token $10,缓存输入比普通输入便宜 95%[1]。同一份公告里的脚注写道:“优惠期结束后,将适用每 1M 输入 token $4、每 1M 输出 token $20 的价格”[1]。谷歌没有说明优惠期持续多久。
所以,任何基于 Gemini 4 Argon 的预算都应该同时按两套价格来算。本文列出完整价目表,用四种真实任务形态算一遍账,并与谷歌自家基准表中三个模型里的两个做费用对比:GPT-6 Astra 和 Claude Opus 5.5。
要点速览
- 首发优惠价:每 1M 输入 token $2,每 1M 输出 token $10;缓存输入在输入价基础上便宜 95%,即每 1M $0.10[1]。
- 优惠期后的标准价:每 1M token 输入 $4、输出 $20。谷歌没有公布这一阶段的缓存输入价格[1]。
- 对比 GPT-6 Astra:Astra 标价为每 1M token 输入 $10、输出 $50,输入超过 272K token 后价格更高[2]。Argon 的首发价只有它的五分之一。
- 对比 Claude Opus 5.5:Opus 5.5 标价为输入 $4、输出 $20[3],与 Argon 的标准价完全相同。
- 没有免费额度,开发者也还用不上:第一批开发者是“付费 API 客户”,谷歌没有给出日期[1]。
Gemini 4 Argon 完整价目表
谷歌公布的 Gemini 4 Argon 价格信息,一张表就能装下。标注“未公布”的格子表示谷歌没有说明,而不是零。
| 项目 | 首发优惠价 | 标准价(优惠期后) |
|---|---|---|
| 输入,每 1M token | $2.00 | $4.00 |
| 输出,每 1M token | $10.00 | $20.00 |
| 缓存输入,每 1M token | $0.10(比输入便宜 95%) | 未公布 |
| 长上下文附加费 | 未公布 | 未公布 |
| Batch 折扣 | 未公布 | 未公布 |
| 优惠期时长 | 未公布 |
来源:谷歌的公告及其脚注[1]。
有两点值得注意。第一,输出价格是输入的五倍,与 GPT-6 Astra 和 Claude Opus 5.5 的比例相同[2][3]。第二,缓存折扣力度很大。按每百万 $0.10 计算,智能体每一轮都重读一个已缓存的大型代码库,成本只有重新读取的二十分之一。
Gemini 4 Argon 上 100 万 token 要多少钱?
取决于 token 的方向。100 万输入 token 在首发价下是 $2,之后是 $4。100 万输出 token 在首发价下是 $10,之后是 $20[1]。
对 Argon 来说,输出这一项比其他模型更重要,因为 Argon 真的能在一次回答里生成 100 万 token。谷歌把输出上限从 64K 提高到了 1M token[1]。GPT-6 Astra 的输出上限是 128,000 token[2];Claude Opus 5.5 在标准同步 API 上是 128K,通过带 beta header 的 Batch API 可达 300K[4]。因此,一次满长度的 Argon 回答,仅输出部分在首发价下就要 $10,在标准价下要 $20。
真实任务要花多少钱:Argon vs GPT-6 Astra vs Claude Opus 5.5
标价掩盖了任务本身的形态,所以下面用四种任务形态把账算出来。所有数字都按各厂商公布的单次请求标准 API 标价计算,不含 Batch 折扣。Astra 的提示超过 272K 输入 token 后,输入价翻倍、输出价升至 1.5 倍[2],触发该规则的地方已按此计算。
| 任务 | Argon 首发价 | Argon 标准价 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| 代码审查:输入 100K,输出 20K | $0.40 | $0.80 | $0.80 | $2.00 |
| 智能体单轮:100K 新输入 + 400K 缓存输入,输出 50K | $0.74 | 未公布 | $1.48 | $6.55 |
| 长篇报告:输入 200K,输出 600K | $6.40 | $12.80 | 无法在一次回答中完成 | 无法在一次回答中完成 |
| 最大输出:输入 100K,输出 1M | $10.20 | $20.40 | 无法在一次回答中完成 | 无法在一次回答中完成 |
智能体那一行的算法:Argon 首发价为 100K × $2 + 400K × $0.10 + 50K × $10(均按每百万计)。Opus 5.5 使用其 $0.20 的缓存命中价[3]。Astra 的 500K token 提示超过了 272K,因此输入变为每百万 $20、缓存输入 $2、输出 $75[2]。表中没有计入写入缓存的一次性费用,各家都另行收取。
规律很简单。在首发价下,Gemini 4 Argon 处理普通请求的费用是 Claude Opus 5.5 的一半、GPT-6 Astra 的五分之一。优惠期结束后,Argon 与 Opus 5.5 的 token 单价相同,Astra 的价格仍是它们的 2.5 倍。最后两行根本不是价格对比:只有 Argon 能在一次调用里返回这么多文本。
首发优惠价什么时候结束
谷歌只说 $4 和 $20 的价格在“优惠期结束后”适用[1]。没有日期,而开发者 API 也还没开放,所以有可能在大多数开发者能发出请求之前,优惠期就已经过去了一部分。
请按标准价做规划。如果一项任务只有在 $2 和 $10 的价格下才划算,那它会在一个没人公布过的日期失效。如果它在 $4 和 $20 下也成立,优惠期就是额外的折扣。
1M token 输出预算在实践中意味着什么
长输出是 Gemini 4 Argon 定价最有意思的地方,也是最可能让你意外的地方。谷歌称 Argon 能“在单条轨迹中生成数十万 token”[1]。正是这个特性,让 Argon 智能体重写了 libgav1 中 32K 行 SIMD 代码,并参与了一个 800K+ 行的内核迁移[1]。
这也意味着,一个无人看管的请求在标准价下可能花掉 $20。三个习惯可以把它控制住:
- 每个请求都设置最大输出预算。把 1M 上限当作余量,而不是默认值。
- 缓存稳定的上下文。每一轮都要重读的代码仓库或文档集,应该按每百万 $0.10 放在缓存里,而不是按 $2 作为新输入。
- 按任务衡量输出,而不是按 token。一个靠一次长回答完成任务的模型,即使 token 单价更高,也可能比需要五次较短重试的模型更省钱。
reAPI 的定位
Gemini 4 Argon 目前还没有在 reAPI 上线,因为谷歌尚未开放开发者访问[1]。它在 reAPI 上线时,我们会在 Gemini 4 Argon 模型页公布 reAPI 价格。
如果你想现在就开始开发,Claude Opus 5.5 已在 reAPI 上线,它在 Anthropic 官方平台的 token 标价与 Argon 的标准价相同[3]。reAPI 当前价格见各模型页。想了解输出上限为什么会影响成本,可以看我们的 LLM 最大输出 token 指南。
常见问题
Gemini 4 Argon 多少钱?
首发时为每 1M 输入 token $2、每 1M 输出 token $10,缓存输入每 1M $0.10。优惠期结束后,为每 1M token 输入 $4、输出 $20[1]。
Gemini 4 Argon 免费吗?
不免费。谷歌只公布了付费价格,第一批开发者访问也会给付费 API 客户[1]。
Gemini 4 Argon 的首发优惠价持续多久?
谷歌没有说明。公告只表示,优惠期结束后适用标准价[1]。
Gemini 4 Argon 比 GPT-6 Astra 便宜吗?
按标价是的。Astra 每 1M token 输入 $10、输出 $50[2],是 Argon 首发价的五倍、标准价的 2.5 倍。
Gemini 4 Argon 比 Claude Opus 5.5 便宜吗?
优惠期内是的,便宜一半。优惠期后,两者标价都是每 1M token 输入 $4、输出 $20[1][3]。
使用 Gemini 4 Argon 需要 Google AI Ultra 订阅吗?
API 不需要,API 按 token 计费。Google AI Ultra 是谷歌点名的、首批面向普通用户开放的消费者套餐[1]。
如何估算 Gemini 4 Argon 的账单?
输入 token 乘以输入单价,缓存输入 token 乘以缓存单价,输出 token 乘以输出单价,均按每百万计。然后再按标准价算一遍,因为优惠期没有公布结束日期。
为 Gemini 4 Argon 做预算
头条数字是真的:按 $2 和 $10 计算,Gemini 4 Argon 比谷歌自家对比表里的所有模型都便宜。但这是一个大多数开发者还调用不了的模型上的促销价,而且结束日期没人公布。请把业务测算建立在 $4 和 $20 上,这让 Argon 与 Claude Opus 5.5 持平、远低于 GPT-6 Astra,再把优惠期当作额外收益。
更大的定价看点是输出长度。在这组对比里,没有其他模型能在一次回答中向你收取一百万输出 token 的费用。所以 Gemini 4 Argon 的价格恰恰在它最强的地方最便宜,而在一次长运行无人看管时最贵。
参考资料
- Google. Gemini 4 Argon: our next era of frontier intelligence. 2026 年 10 月检索自 blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- OpenAI. GPT-6 Astra model page. 2026 年 10 月检索自 developers.openai.com/api/docs/models/gpt-6-astra
- Anthropic. Pricing. 2026 年 10 月检索自 platform.claude.com/docs/en/about-claude/pricing
- Anthropic. Models overview. 2026 年 10 月检索自 platform.claude.com/docs/en/about-claude/models/overview
作者

分类
更多文章
Kling 模型怎么选?可灵各版本全面对比
对比 Kling 3.0、3.0 Omni、3.0 Turbo、O1、2.6 和 2.5 Turbo 的时长、分辨率、音频与参考能力,并说明每类任务适合哪个 Kling 模型。
文档转视频 AI API: PDF、PPT、XLS、DOCX 和网页
用 Wan 3.0 从 PDF、演示文稿、表格或文档生成 2-30 秒的视频。了解输入限制、精确成本计算和完整请求示例。
GPT-5.6 已发布:三层架构与迁移指南
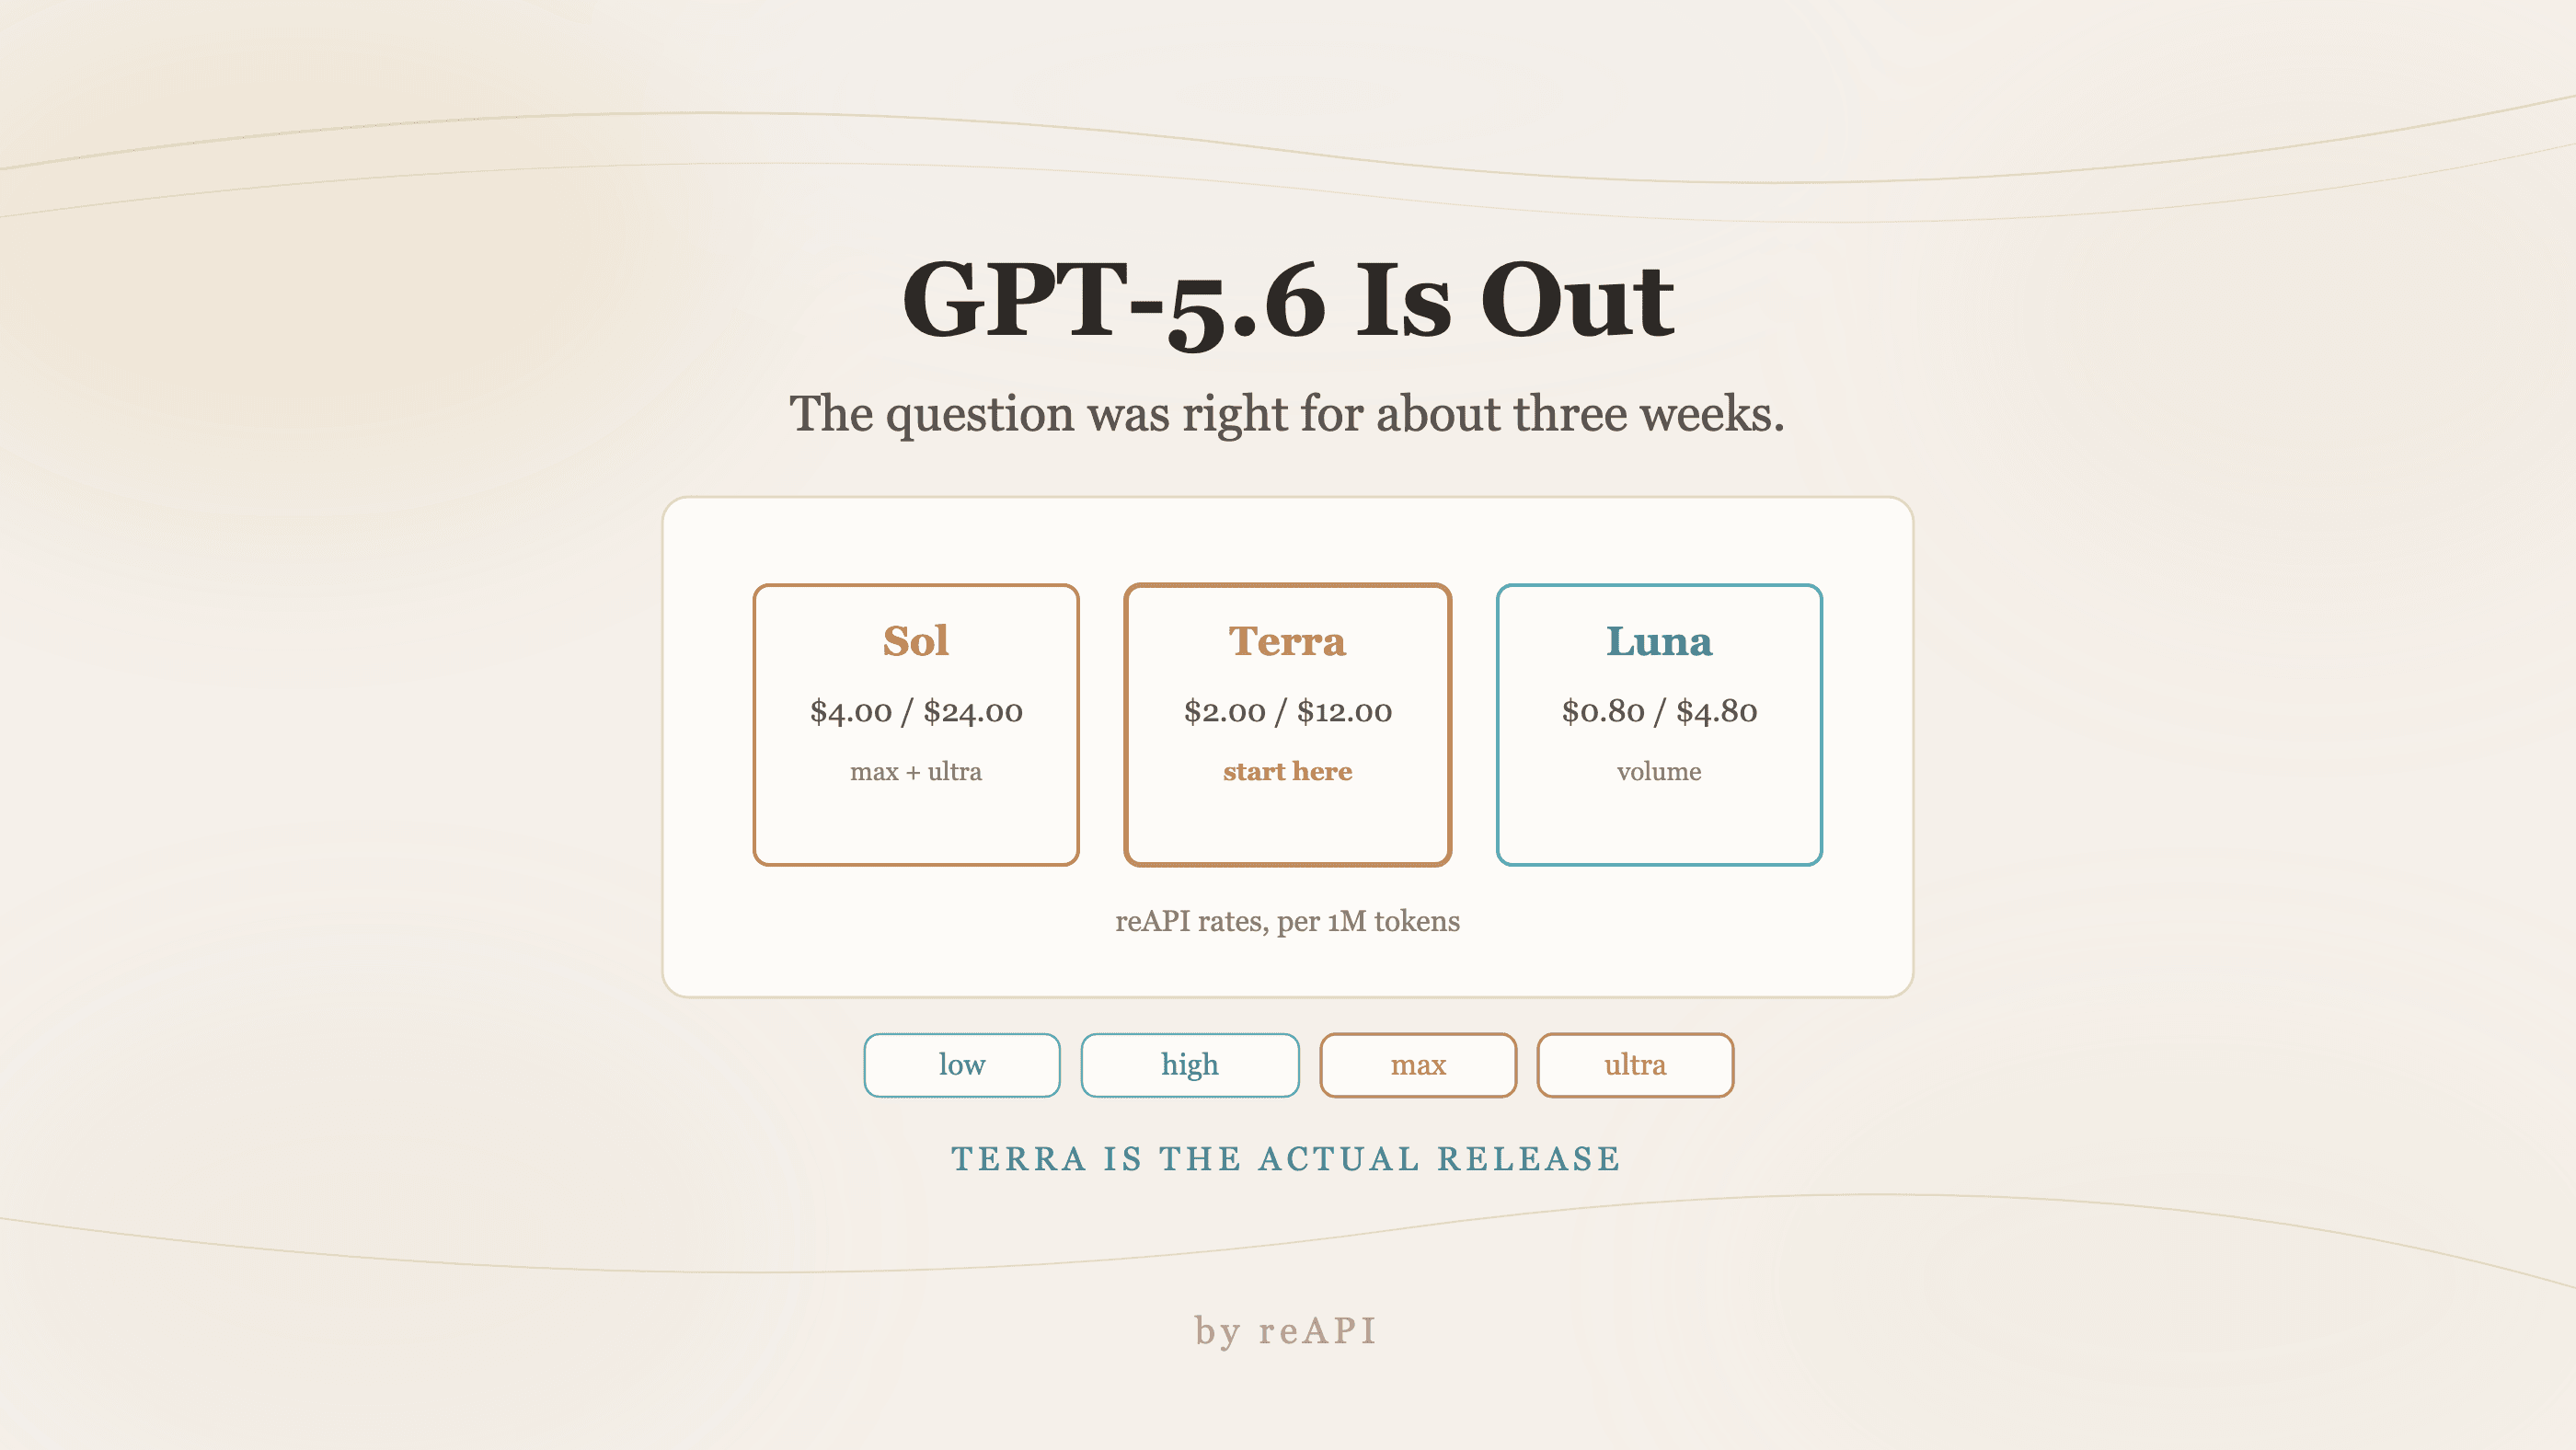
GPT-5.6 已发布三层模型:Sol、Terra、Luna。限制访问期间信息混乱,现已全量开放;Terra 以半价提供 GPT-5.5 级编码,最值得迁移。