Gemini 3.6 Flash 使用指南:速度、价格与限制
Gemini 3.6 Flash 指南:官方基准对标、与 GPT-5.6 Luna 和 Sonnet 5 的差距、四项 API 变更。
2026 年 7 月 21 日,Google 在一次声明中发布了三个 Gemini 模型:Gemini 3.6 Flash、Gemini 3.5 Flash-Lite 以及一个受限的安全专家模型 Gemini 3.5 Flash Cyber[1]。没有 Pro 模型,没有主题演讲,也没有声称进入新的智能边界。整个发布围绕一件事:生产环境中运行代理的团队需要更少的代币和更低的每个任务延迟,而不是更大的模型。
这个定位告诉你谁是目标用户。学会很好地使用 Gemini 3.6 Flash 主要是关于数学的复合,因为 Google 降低了输出价格,同时该模型在完成相同工作时也会发出更少的代币。这两个效应相乘。本指南涵盖官方基准数据、3.6 Flash 在哪些方面明确输给 GPT-5.6 Luna 和 Claude Sonnet 5、中断代码的四项 API 变更以及三个模型中哪一个真正适合你的工作负载。
TL;DR:2026 年 7 月 Gemini Flash 系列
| 模型 | 每百万代币表价 | 定位 |
|---|---|---|
| Gemini 3.6 Flash | $1.50 输入 / $7.50 输出 | 编码、代理和知识工作的主力机型。输出代币比 3.5 Flash 少约 17%[4] |
| Gemini 3.5 Flash-Lite | $0.30 输入 / $2.50 输出 | 3.5 系列中速度最快的模型,每秒 350 个输出代币[4]。高容量流水线 |
| Gemini 3.5 Flash Cyber | 公开未标价 | DeepMind CodeMender 代理内的漏洞查找器。仅限政府和经过核实的合作伙伴[3] |
同一篇文章中隐藏的两条路线图说明:Gemini 3.5 Pro 仍在合作伙伴测试中,没有公布日期,Google 确认已经开始其最雄心勃勃的预训练运行,用于 Gemini 4[1]。
上表记录的是 2026 年 7 月的发布价格。本文 2026 年 7 月 27 日的版本记录 reAPI 每百万 token 输入 $1.20、输出 $6.00,即 Google 发布时费率的 80%。这些是历史数据,不是当前报价。2026 年 10 月 23 日,reAPI 模型页显示“Pricing temporarily unavailable”,因此无法确认当前 reAPI 价格或折扣。Flash-Lite 和 Flash Cyber 不在网关上。
Google 当前 Standard 促销费率为每百万 token 输入 $0.75、含推理的输出 $3.75、缓存输入 $0.075,有效至 2026 年 12 月 31 日。从 2027 年 1 月 1 日起,公布的对应费率为 $1.50、$7.50 和 $0.15。缓存存储单独收费:促销期间为每百万 token 每小时 $0.50,从 2027 年 1 月 1 日起为 $1.00。这些是 Google 直连 API 费率,不是已核实的 reAPI 报价。[6]
效率优先
在 2026 年 7 月发布时,Gemini 3.6 Flash 的价格为每百万输入代币 $1.50,每百万输出 $7.50,缓存输入为每百万 $0.15[1]。其前身收费每百万输出 $9,所以 Google 将输出价格降低了约 17%,同时提高了各项基准分数。
标签价格只是故事的较小部分。Artificial Analysis 测量 3.6 Flash 在相同工作负载上消耗的输出代币比 3.5 Flash 少约 17%[4],Google 在 Datacurve 的 DeepSWE 基准上报告了高达 65% 的代币减少[1]。该模型还需要更少的推理步骤和更少的工具调用来完成多步工作。
对于每个任务循环数十次的代理来说,这些效应叠加:更便宜的代币、更少的代币、更少的循环。每代币价格比较低估了差异。
针对自身前代的官方基准
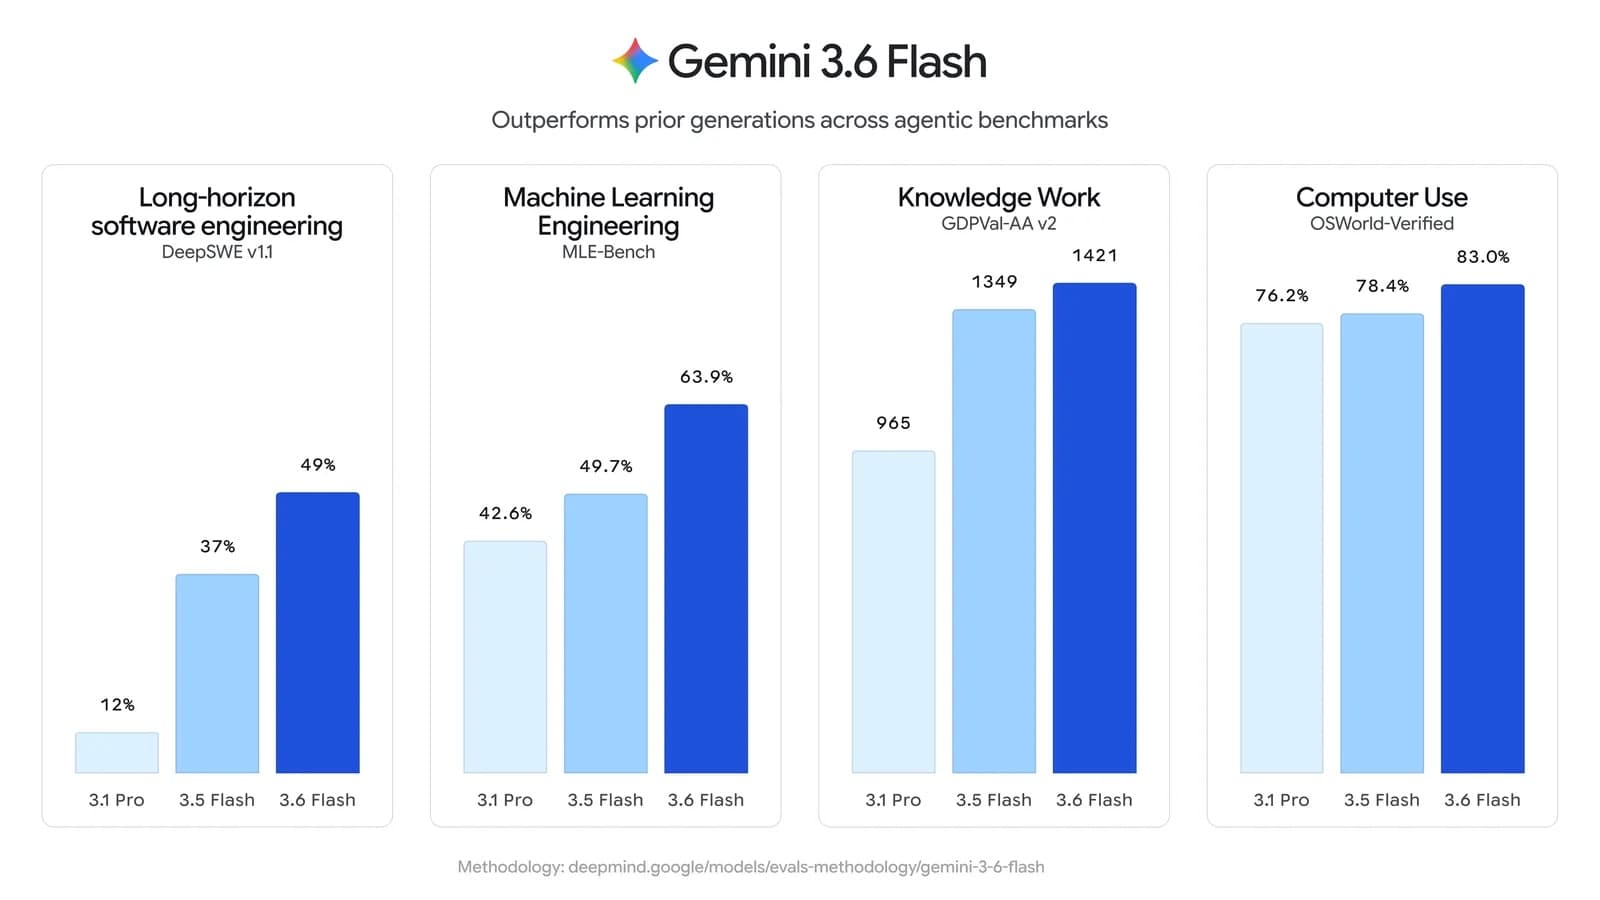
Google 启动图表在四个代理基准上比较 3.6 Flash 与 3.5 Flash 和较旧的 3.1 Pro[1]。
| 基准 | Gemini 3.1 Pro | Gemini 3.5 Flash | Gemini 3.6 Flash |
|---|---|---|---|
| DeepSWE v1.1(长水平软件工程) | 12% | 37% | 49% |
| MLE-Bench(机器学习工程) | 42.6% | 49.7% | 63.9% |
| GDPVal-AA v2(知识工作,Elo) | 965 | 1349 | 1421 |
| OSWorld-Verified(计算机使用) | 76.2% | 78.4% | 83.0% |
如需聚焦比较这两个模型,包括 Google 当前价格和 API 边界,请阅读 Gemini 3.6 Flash vs 3.1 Pro。reAPI 不提供 Gemini 3.1 Pro。
Google 评估方法中还隐藏了三项相比前代的收益:SWE-Bench Pro 在 58.7% vs 55.1%、Terminal-Bench 2.1 在 78.0% vs 76.2%,以及 GDM-MRCR v2 长上下文检索测试在完整 100 万代币深度,其中 3.6 Flash 大致翻倍两个前代在 54.0% 相比不到 27%[5]。
从模型卡:知识截断日期从 2025 年 1 月移至 2026 年 3 月,上下文套件保持在 100 万输入和 64K 输出代币,模型原生接受文本、图像、音频和视频[2]。
3.6 Flash 赢得的地方和输的地方
Google 的图表只比较 Gemini 与 Gemini。下面是使用 2026 年中期发布结果的跨供应商图景[5]。
| 基准 | Gemini 3.6 Flash | GPT-5.6 Luna | Grok 4.5 | Claude Sonnet 5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 49% | 67% | 无数据 | 无数据 |
| Terminal-Bench 2.1 | 78.0% | 84.7% | 无数据 | 无数据 |
| SWE-Bench Pro | 58.7% | 无数据 | 64.7% | 无数据 |
| MLE-Bench | 63.9% | 无数据 | 无数据 | 66.9% |
| GDPVal-AA v2(Elo) | 1421 | 无数据 | 无数据 | 1607 |
| OSWorld-Verified | 83.0% | 无数据 | 无数据 | 无数据 |
没有模型席卷全局,3.6 Flash 也不打算这样做。它在 OSWorld-Verified 计算机使用、两个 CharXiv 图表推理变体上处于领先,以及两个 GDM-MRCR 长上下文测试[5]。这些是多模态和长上下文的车道 Google 一直拥有。
它显然在代理编码上落后 GPT-5.6 Luna,在 DeepSWE 和 Terminal-Bench 上都是。它落后 Claude Sonnet 5 在 ML 工程和知识工作上,而 Sonnet 5 在 GDPVal-AA 上的 1607 Elo 是与 3.6 Flash 的 1421 不同的重量级[5]。
独立阅读同意。Artificial Analysis 在其智能指数上给 3.6 Flash 打 50 分,追踪的 187 个模型中排名 21。这不是前沿智能,Google 不声称它是。同一评估在其类别中按输出速度排名第一,每秒 303.6 代币,并将其代币使用描述为相当简洁,同时指出首代元代币,在高思维努力下 11.54 秒,位于其层的慢端[4]。
一个方法说明在任何人引用跨供应商表之前:供应商分数通常在每个模型的最大思维配置下报告,代理套件在供应商之间不同。将小间隙视为噪音,仅将大的视为信号。
实际阅读。如果工作是原始编码代理马力,GPT-5.6 Luna 和 Claude Sonnet 5 仍然占据顶部,价格是好几倍。如果工作是计算机使用、文档密集多模态工作或大规模长上下文检索,3.6 Flash 在其括号中为每美元提供最佳分数。
Gemini 3.5 Flash-Lite
第二个发布针对曲线的相反端。Flash-Lite 按 Artificial Analysis 测量每秒 350 个输出代币运行,价格为每百万输入 $0.30 和每百万输出 $2.50,是 3.6 Flash 汇率的五分之一和三分之一[1][4]。
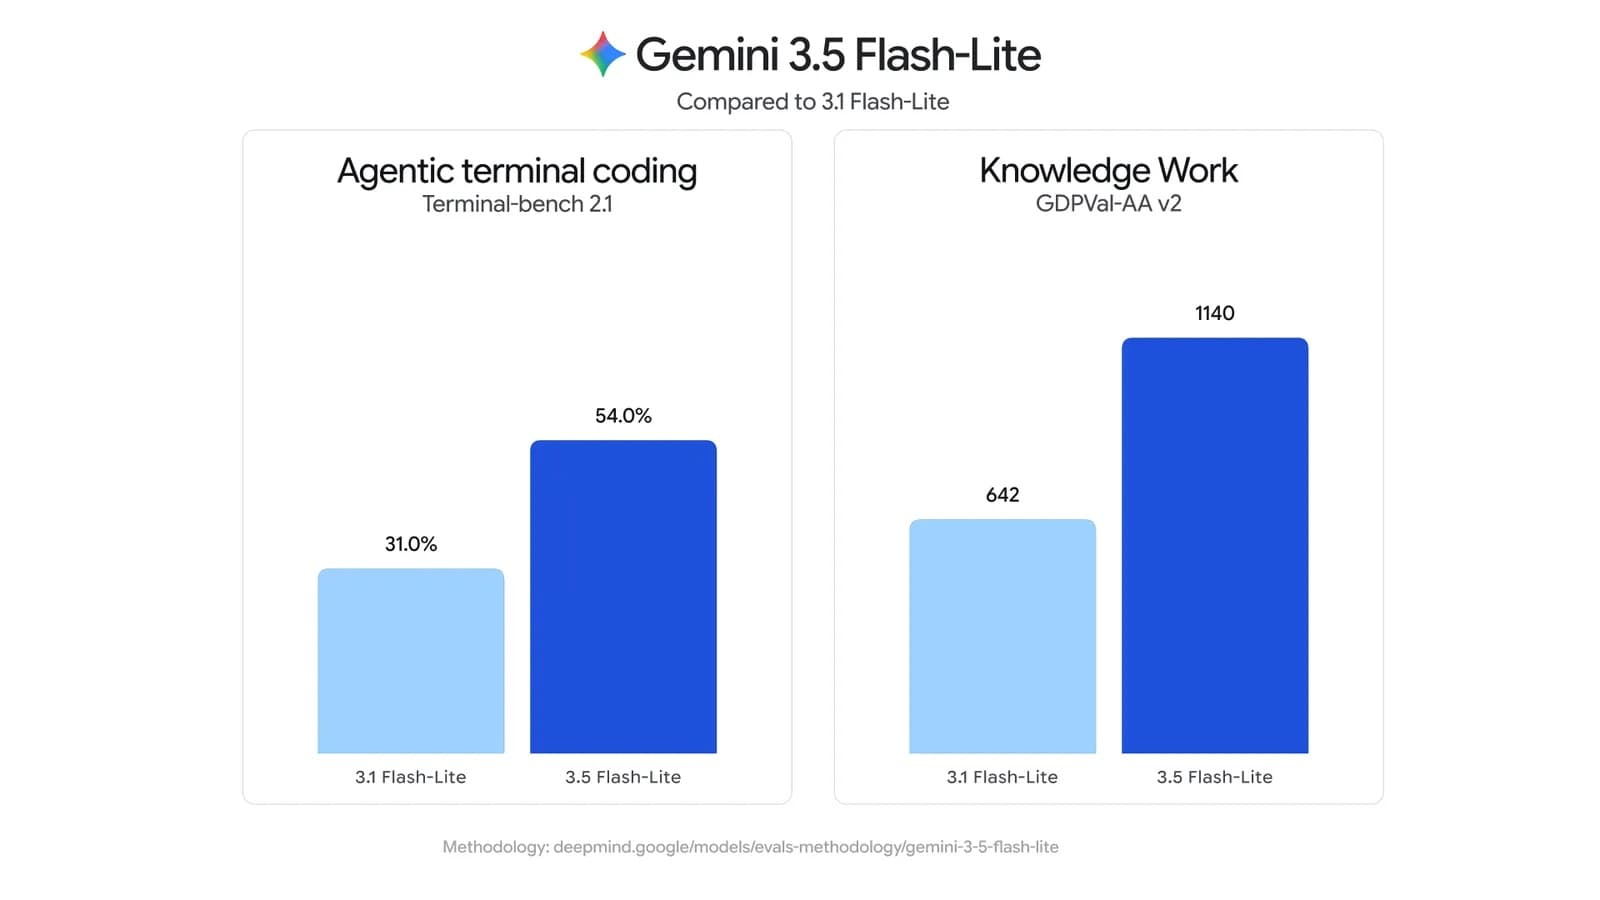
世代跳跃在这里比发布中的任何其他地方都更大[1]:
- Terminal-Bench 2.1:54.0% 相比 3.1 Flash-Lite 的 31.0%,代理终端编码中 23 点的移动。
- GDPVal-AA v2:1140 Elo 相比 642,在实际知识工作上接近翻倍。
- GDM-MRCR v2 长上下文:72.2% 相比 60.1%。
值得停顿的比较是与较旧、较大的 3 Flash:Flash-Lite 现在在 SWE-Bench Pro 54.2% vs 49.6% 和 OSWorld-Verified 74.0% vs 65.1% 上胜过它[1]。最便宜的当前模型在编码和计算机使用上击败前代的中层。
Google 将其定位用于高吞吐量工作:代理搜索、批量文档处理、分类、子代理扇出,思维级别可从最小值(默认)配置到高[1]。
Gemini 3.5 Flash Cyber
第三个模型是 Google 不会卖给你的那个。Flash Cyber 是 3.5 Flash 的一个版本,经过微调以查找、验证和修补安全漏洞,它独家在 CodeMender 内发货,DeepMind 的代码安全代理,在有限试点中仅限政府和受信任的合作伙伴[3]。
微调依赖于少数实验室拥有的资产:超过 700,000 个开源漏洞的 OSV.dev 数据库、超过十年的 OSS-Fuzz 结果以及来自包括 Chromium 的 Google 规模代码库的安全工作流数据[3]。在 CodeMender 内,多个 Flash Cyber 子代理分析不同的代码路径并将发现合并到一份报告中,这是架构赌注:一个廉价模型被调用最多五次与许多更大的单调用竞争。
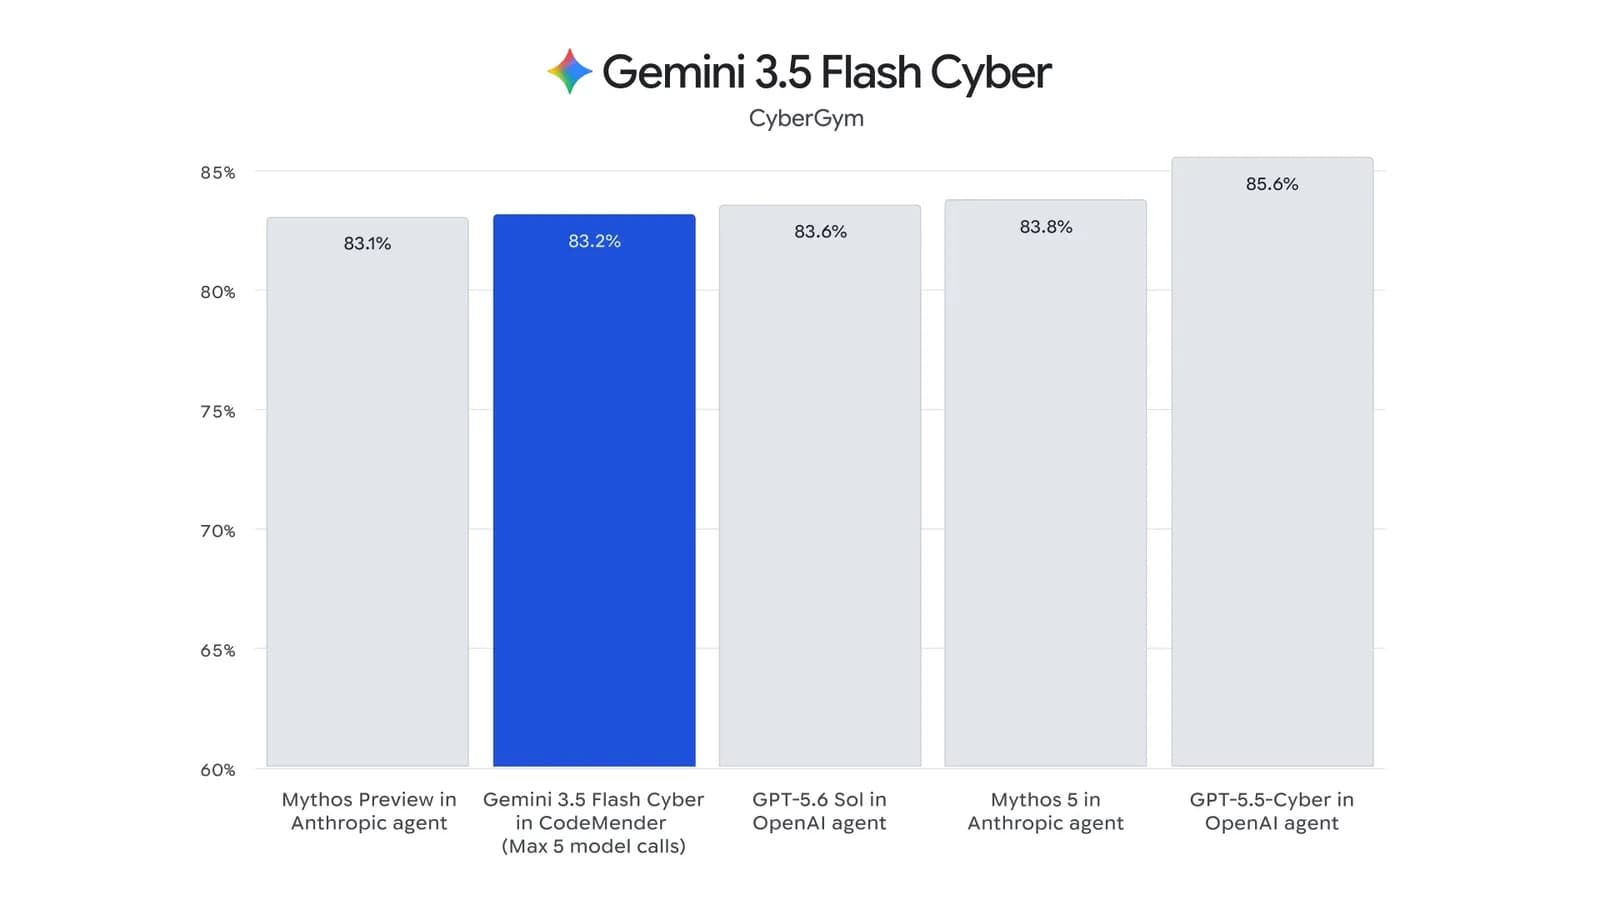
| 系统 | CyberGym 分数 |
|---|---|
| OpenAI 代理中的 GPT-5.5-Cyber | 85.6% |
| Anthropic 代理中的 Claude Mythos 5 | 83.8% |
| OpenAI 代理中的 GPT-5.6 Sol | 83.6% |
| CodeMender 中的 Gemini 3.5 Flash Cyber(最多 5 次调用) | 83.2% |
| Anthropic 代理中的 Claude Mythos Preview | 83.1% |
诚实地读那个:Flash Cyber 不在图表顶部。OpenAI 的专属 GPT-5.5-Cyber 领先 2.4 点,Mythos 5 以 0.6 点领先它。Google 的主张是来自 Flash 大小模型的竞争性能,这是成本主张而不是皇冠[3]。
它确实赢的地方是在 Google 自己更深的评估中。在 V8 JavaScript 引擎测试上,它确认了 55 个独特真实问题相比 47 个库存 3.5 Flash 和 36 个 Claude Opus 4.6,包括没有其他模型发现的 10 个[3]。Google 的云漏洞研究团队报告使用它在生产服务中找到内存损坏漏洞并构建可工作的利用链,绕过 ASLR 和 W^X,在两小时内[3]。
这解释了限制。Google 陈述能力是双用,将访问限制为经过验证的防御者,仅在 CodeMender 的报告工作流内部署它,并在补丁发货前需要人工批准[3]。
如何使用 Gemini 3.6 Flash:四项中断旧代码的 API 变更
模型卡将 3.6 Flash 描述为直接基于 3.5 Flash,相同的原生多模态稀疏推理基础和相同的 100 万/64K 套件,收益来自训练后而不是新基础模型[2]。工作在请求界面中。
- 模型 ID 是
gemini-3.6-flash和gemini-3.5-flash-lite[1]。 thinking_budget被替换为thinking_level字符串枚举。 3.6 Flash 默认为medium,Flash-Lite 为minimal[1]。- 经典采样旋钮消失了。
temperature、top_p和top_k被移除,应从请求负载中删除[1]。 candidate_count不受支持,预填充模型转弯(意味着以非空模型角色结尾的对话)被拒绝[1]。
两个公开模型都暴露完整的内置工具套件,包括计算机使用、搜索接地和代码执行[1]。从 3.5 Flash 来,迁移是模型字符串更改加删除已弃用参数。没有要学习的新 SDK 界面。
你应该选择哪个模型
直接从发布的数字的路由启发式:
- 默认使用 3.6 Flash 用于涉及编码、计算机使用、文档解析或任何多步的代理循环。代币效率收益在代理成本爆炸的位置复合。
- 将批量、延迟敏感工作路由到 Flash-Lite:提取、分类、搜索摘要、子代理扇出。仅在采样质量检查说你必须时提升
thinking_level。 - 在前沿模型上保持前沿编码。 如果 DeepSWE 级自主是工作,诚实数字说 GPT-5.6 Luna 和 Claude Sonnet 5 仍然完成 3.6 Flash 无法做的任务,高端在低容量、高赌注运行中可能值得。
- Flash Cyber 不是你可以选择做的事 除非你是政府或邀请的合作伙伴。
沿你的其他模型调用 Gemini 3.6 Flash
注意到路由列表实际上说什么。四个要点中的三个将工作发送到 Gemini 的其他位置。Google 自己基准表的诚实结论是 3.6 Flash 应赢得你的一些流量并输掉其余的,分割在每次供应商发货时移动。
reAPI 通过 OpenAI 兼容的 /api/v1/chat/completions 端点暴露 Gemini 3.6 Flash,所以已经调用 GPT 和 Claude 的客户也调用它。注意线路模型 ID 保持 Google 的点号:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gemini-3.6-flash",
    messages=[{"role": "user", "content": "Summarize this report and pull out the numbers."}],
    max_tokens=8192,
    stream=True,
)
2026 年 7 月 27 日的文章记录 reAPI 费率为每百万输入 token $1.20、每百万输出 $6.00,即 Google 当时公布的 $1.50 / $7.50 的 80%。这项历史比较不能证明今天的折扣,因为 Google 当前促销改变了比较基准,而本次检查时 reAPI 实时价格不可用。当前 reAPI 请求采用 Chat Completions,模型 ID 为 gemini-3.6-flash,输出上限为 8192 token;Google 原生 SDK 不能直接替换这种请求格式。本次更新没有逐项实测工具和媒体行为。价格请查看 reapi.ai/models/gemini-3-6-flash,文档请求格式请查看 reapi.ai/docs/gemini-3-6-flash。[7]
说清楚关于覆盖范围:Flash-Lite 和 Flash Cyber 不在网关上。Flash Cyber 对网关外的任何人都不可用,无论你如何调用它。
FAQ
Gemini 3.6 Flash 实际上比 3.5 Flash 便宜吗?
发布时,输出价格确实更低:每百万 token $7.50,相比 $9 约下降 17%。发布期间的评测还报告,相同任务的输出 token 约减少 17%,因此每个完成任务的实际成本可能比 token 单价的降幅更大。发布时缓存输入费率为每百万 $0.15。[1][4] 计算当前 Google 账单时,应采用上文的促销及计划恢复费率;这项历史比较不是当前 reAPI 折扣报价。[6]
Gemini 3.6 Flash 上下文窗口是什么?
100 万输入代币和 64K 输出代币,原生接受文本、图像、音频和视频[2]。 上述是 Google 模型层面的能力;当前 reAPI Chat Completions 配置的输出上限为 8192 token。不要把模型的原生 API 格式当作这条 reAPI 路由的契约。[7]
我需要改代码从 3.5 Flash 升级吗?
最少。将模型字符串交换为 gemini-3.6-flash,将 thinking_budget 替换为 thinking_level,并从请求中删除 temperature、top_p、top_k 和 candidate_count[1]。
Gemini 3.6 Flash 比 GPT-5.6 Luna 或 Claude Sonnet 5 更好吗?
不在代理编码上。Luna 领先 DeepSWE 67% 到 49% 和 Terminal-Bench 84.7% 到 78.0%,而 Sonnet 5 领先 MLE-Bench 和 GDPVal-AA[5]。Gemini 3.6 Flash 赢计算机使用、图表推理和长上下文检索,价格为一小部分。
我可以访问 Gemini 3.5 Flash Cyber 吗?
不,除非你是政府机构或 CodeMender 试点中的邀请合作伙伴[3]。
Gemini 3.5 Pro 发生了什么?
它仍在合作伙伴测试中没有公布日期,而 Google 已确认 Gemini 4 预训练已经在进行[1]。
Gemini 3.6 Flash 有多快?
Artificial Analysis 在其类中按输出速度排名第一,每秒 303.6 代币,但首代元代币在高思维努力下 11.54 秒,这对其层来说是慢的[4]。流式传输任何人观看的东西。
如何使用 OpenAI SDK 调用 Gemini 3.6 Flash?
将 OpenAI 客户端指向 https://reapi.ai/api/v1 并将 model 设置为 gemini-3.6-flash,在 ID 中保持点号。端点是 OpenAI 兼容的,所以不需要 SDK 重写。
阅读在单位经济学上竞争的发布
这个启动值得理解为价格举措而不是能力举措。Google 未发货 Pro 层、未做前沿声明、将其工程投入两个决定代理成本的数字:每代币价格和每个任务的代币。两者都下降约 17%,并且它们相乘。相比之下,跨供应商表显示 3.6 Flash 对 GPT-5.6 Luna 的代理编码和对 Claude Sonnet 5 的知识工作失败,这是此括号中的模型的正确权衡而不是缺陷。
实际版本:默认代理循环到它,将批量提取发送到更低,在前沿模型上保持前沿编码,并测量有效成本每个完成任务而不是每代币汇率,因为那是代币效率收益显示的唯一数字。这是如何使用 Gemini 3.6 Flash 而不为它已经表现良好的工作支付前沿价格,或期望它赢得它明确输的行。
References
- Google。推出 Gemini 3.6 Flash、3.5 Flash-Lite 和 3.5 Flash Cyber。 2026 年 7 月检索自 blog.google/technology/google-deepmind
- Google DeepMind。Gemini 3.6 Flash 模型卡。 2026 年 7 月检索自 deepmind.google/models/gemini
- Google DeepMind。推出 Gemini 3.5 Flash Cyber 和 CodeMender。 2026 年 7 月检索自 deepmind.google/discover/blog
- Artificial Analysis。Gemini 3.6 Flash —— 智能、性能和价格分析。 2026 年 7 月检索自 artificialanalysis.ai/models
- OfficeChai。Gemini 3.6 Flash 在大多数基准上击败 Gemini 3.5 Flash 和 Gemini 3.1 Pro。 2026 年 7 月检索自 officechai.com
- Google. Gemini API 价格:Gemini 3.6 Flash Standard 促销与计划费率. 核对日期:2026年10月23日。 ai.google.dev/gemini-api/docs/pricing.
- reAPI. Gemini 3.6 Flash 请求文档与当前 Chat Completions 模型配置. 核对日期:2026年10月23日。 reapi.ai/docs/gemini-3-6-flash. 本次更新未进行真实生成测试。
Further reading
- reAPI. How to use Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. Gemini 3.6 Flash endpoint reference. reapi.ai/docs/gemini-3-6-flash
- reAPI. Model catalog. reapi.ai/models
作者

分类
更多文章
Seedance 2.5 状态:API 接入、价格与当前限制
Seedance 2.5 已上线:reAPI 模型 ID、480p/720p 价格、30 秒输出、参考素材上限与源视频计费规则。
2026 年最佳 Replicate 替代方案:5 个选择对比
正在寻找 2026 年的 Replicate 替代方案?从模型范围、价格、速度和 API 设计对比 fal.ai、Together AI、RunPod、Hugging Face 与 reAPI。
AI 视频代理:构建批评循环实现质量保证
构建 AI 视频代理的批评循环,定义镜头验收规则、修复范围和重试预算,通过人工审核门控和选择性修复防止不合格视频进入最终编辑流程。