GPT-5.6 使用指南:Sol、Terra 和 Luna 三档对比
Sol、Terra、Luna 三档定价与性能、Terminal-Bench 基准、max/ultra 推理模式、选档指南。
选择 GPT-5.6 Sol vs Terra vs Luna 时,先从能通过自己质量检查的最低成本档位开始:Luna 用于成本敏感的大批量任务,Luna 的错误或重试成本足以支持升级时评估 Terra,而 Sol 用于额外能力能够抵消成本的高难度专业工作。目前,提示词输入不超过 272K token 时,OpenAI Standard 的输入/输出费率为每百万 token:Luna $0.20/$1.20、Terra $2/$12、Sol $4/$20。三者的文档上下文和输出限制相同,多付费并不会换来更大的窗口。[3][4][5]
下列价格和当前 API 限制核对于 2026 年 10 月 23 日。发布过程和 Terminal-Bench 的讨论保留为历史背景,不是新一轮基准实测,也不意味着发布评测中的每种模式都是 API 参数。
OpenAI 从 2026 年 6 月 26 日开始有限预览 GPT-5.6,这次发布最奇特的地方是几乎没有人能使用它。大约二十个经过审核的合作方通过 API 和 Codex 获得了访问权限,OpenAI 称美国政府要求了这个分阶段推出方案[1]。
这个限制随后被解除了。如今了解怎样使用 GPT-5.6 是一个实际问题,而不再是等待游戏,答案主要关乎选择三个档位中的一个:Sol 旗舰档、Terra 平衡档工作马,以及 Luna 经济档。每一档都是一个持久的能力等级,而非临时变种。
本指南介绍当前三个档位的选择、价格和限制,同时保留发布时的基准及其四项说明、历史 ultra 评测设置,以及影响发布过程的网络安全审查。
TL;DR
- 三个档位共享限制。 Sol 是旗舰,Terra 兼顾智能与成本,Luna 面向成本敏感的大批量任务。三者都支持
max推理强度。[3][4][5] - 在发布时的 Terminal-Bench 2.1 表中,Sol 得分为 单智能体模式下为 88.8%,
ultra模式下为 91.9%。相对 Claude Mythos 5 的单智能体领先幅度为 0.8 个百分点,这个差距在噪声范围内[1]。 ultra不是单个智能体。 它协调多个子智能体并行运行,所以其分数不能直接与单智能体基线比较[1]。- 按通过验收的任务选择,而非档位名称。 常规大批量任务先测试 Luna,在其未完成好的任务上比较 Terra,并在改进足以抵消更高成本时使用 Sol。
- reAPI 短上下文输入/输出价格为 OpenAI 当前 Standard 费率的 80%:Sol $3.20 / $16.00、Terra $1.60 / $9.60、Luna $0.16 / $0.96(每百万 token,2026 年 10 月 23 日核查)。这个比例不代表每项长上下文费率。[8]
- 评估窗口被意图缩小。 OpenAI 仅发布了编码、生物学和网络安全评估,保留了 SWE-bench、GDPval、数学和幻觉数字[1]。
gpt 5.6 sol vs terra vs luna
GPT-5.6 继承于 GPT-5.5,这是 2026 年 4 月发布的完全重训练的智能体模型。GPT-5.5 是一个具有推理努力等级的单一模型,而 GPT-5.6 是一个在同一代码号下的三档系列。OpenAI 的表述明确:代码号标识一代,而 Sol、Terra 和 Luna 标识可以独立演进的持久能力档位[1]。
这句话是这次发布中最重要的设计决策。它将"有多聪明"与"有多新"解耦了。未来的某代可能会发布新的 Luna 而不碰 Sol,Sol 升级也不会强制 Terra 上的所有人重新测试他们的管道。
| 档位 | 定位 |
|---|---|
| GPT-5.6 Sol | 复杂专业工作的旗舰档;在高难度任务足以证明更高费率合理时评估 |
| GPT-5.6 Terra | 兼顾智能与成本;Luna 不能满足任务要求时评估 |
| GPT-5.6 Luna | 快速且经济,针对高容量例行任务 |
gpt 5.6 context window
OpenAI 目前为 GPT-5.6 三个档位规定了相同限制:总上下文窗口为 1,050,000 token、最多输入 922,000 token、最多输出 128,000 token。输入上限不等于总上下文窗口。三者均接受文本和图片输入、输出文本;模型页列出了流式输出、结构化输出和函数调用。其托管工具列表明确标注为 Responses API 的能力,不能据此保证所有兼容接口都提供相同工具。[3][4][5]
三者都支持 none、low、medium、high、xhigh 和 max,默认值为 medium。当前模型文档没有将 minimal 或 ultra 列为推理强度值。推理 token 占用上下文并按输出计费;输出额度必须同时覆盖隐藏推理和可见答案。[6]
Terminal-Bench 2.1 及其四个注脚
OpenAI 在预览中仅发布了三个基准领域的结果——编码、生物学和网络安全,明确保留了其余的供正式发布[1]。它想让你记住的是 Terminal-Bench 2.1,这个基准测试的是需要规划、迭代和工具协调的命令行智能体工作流。
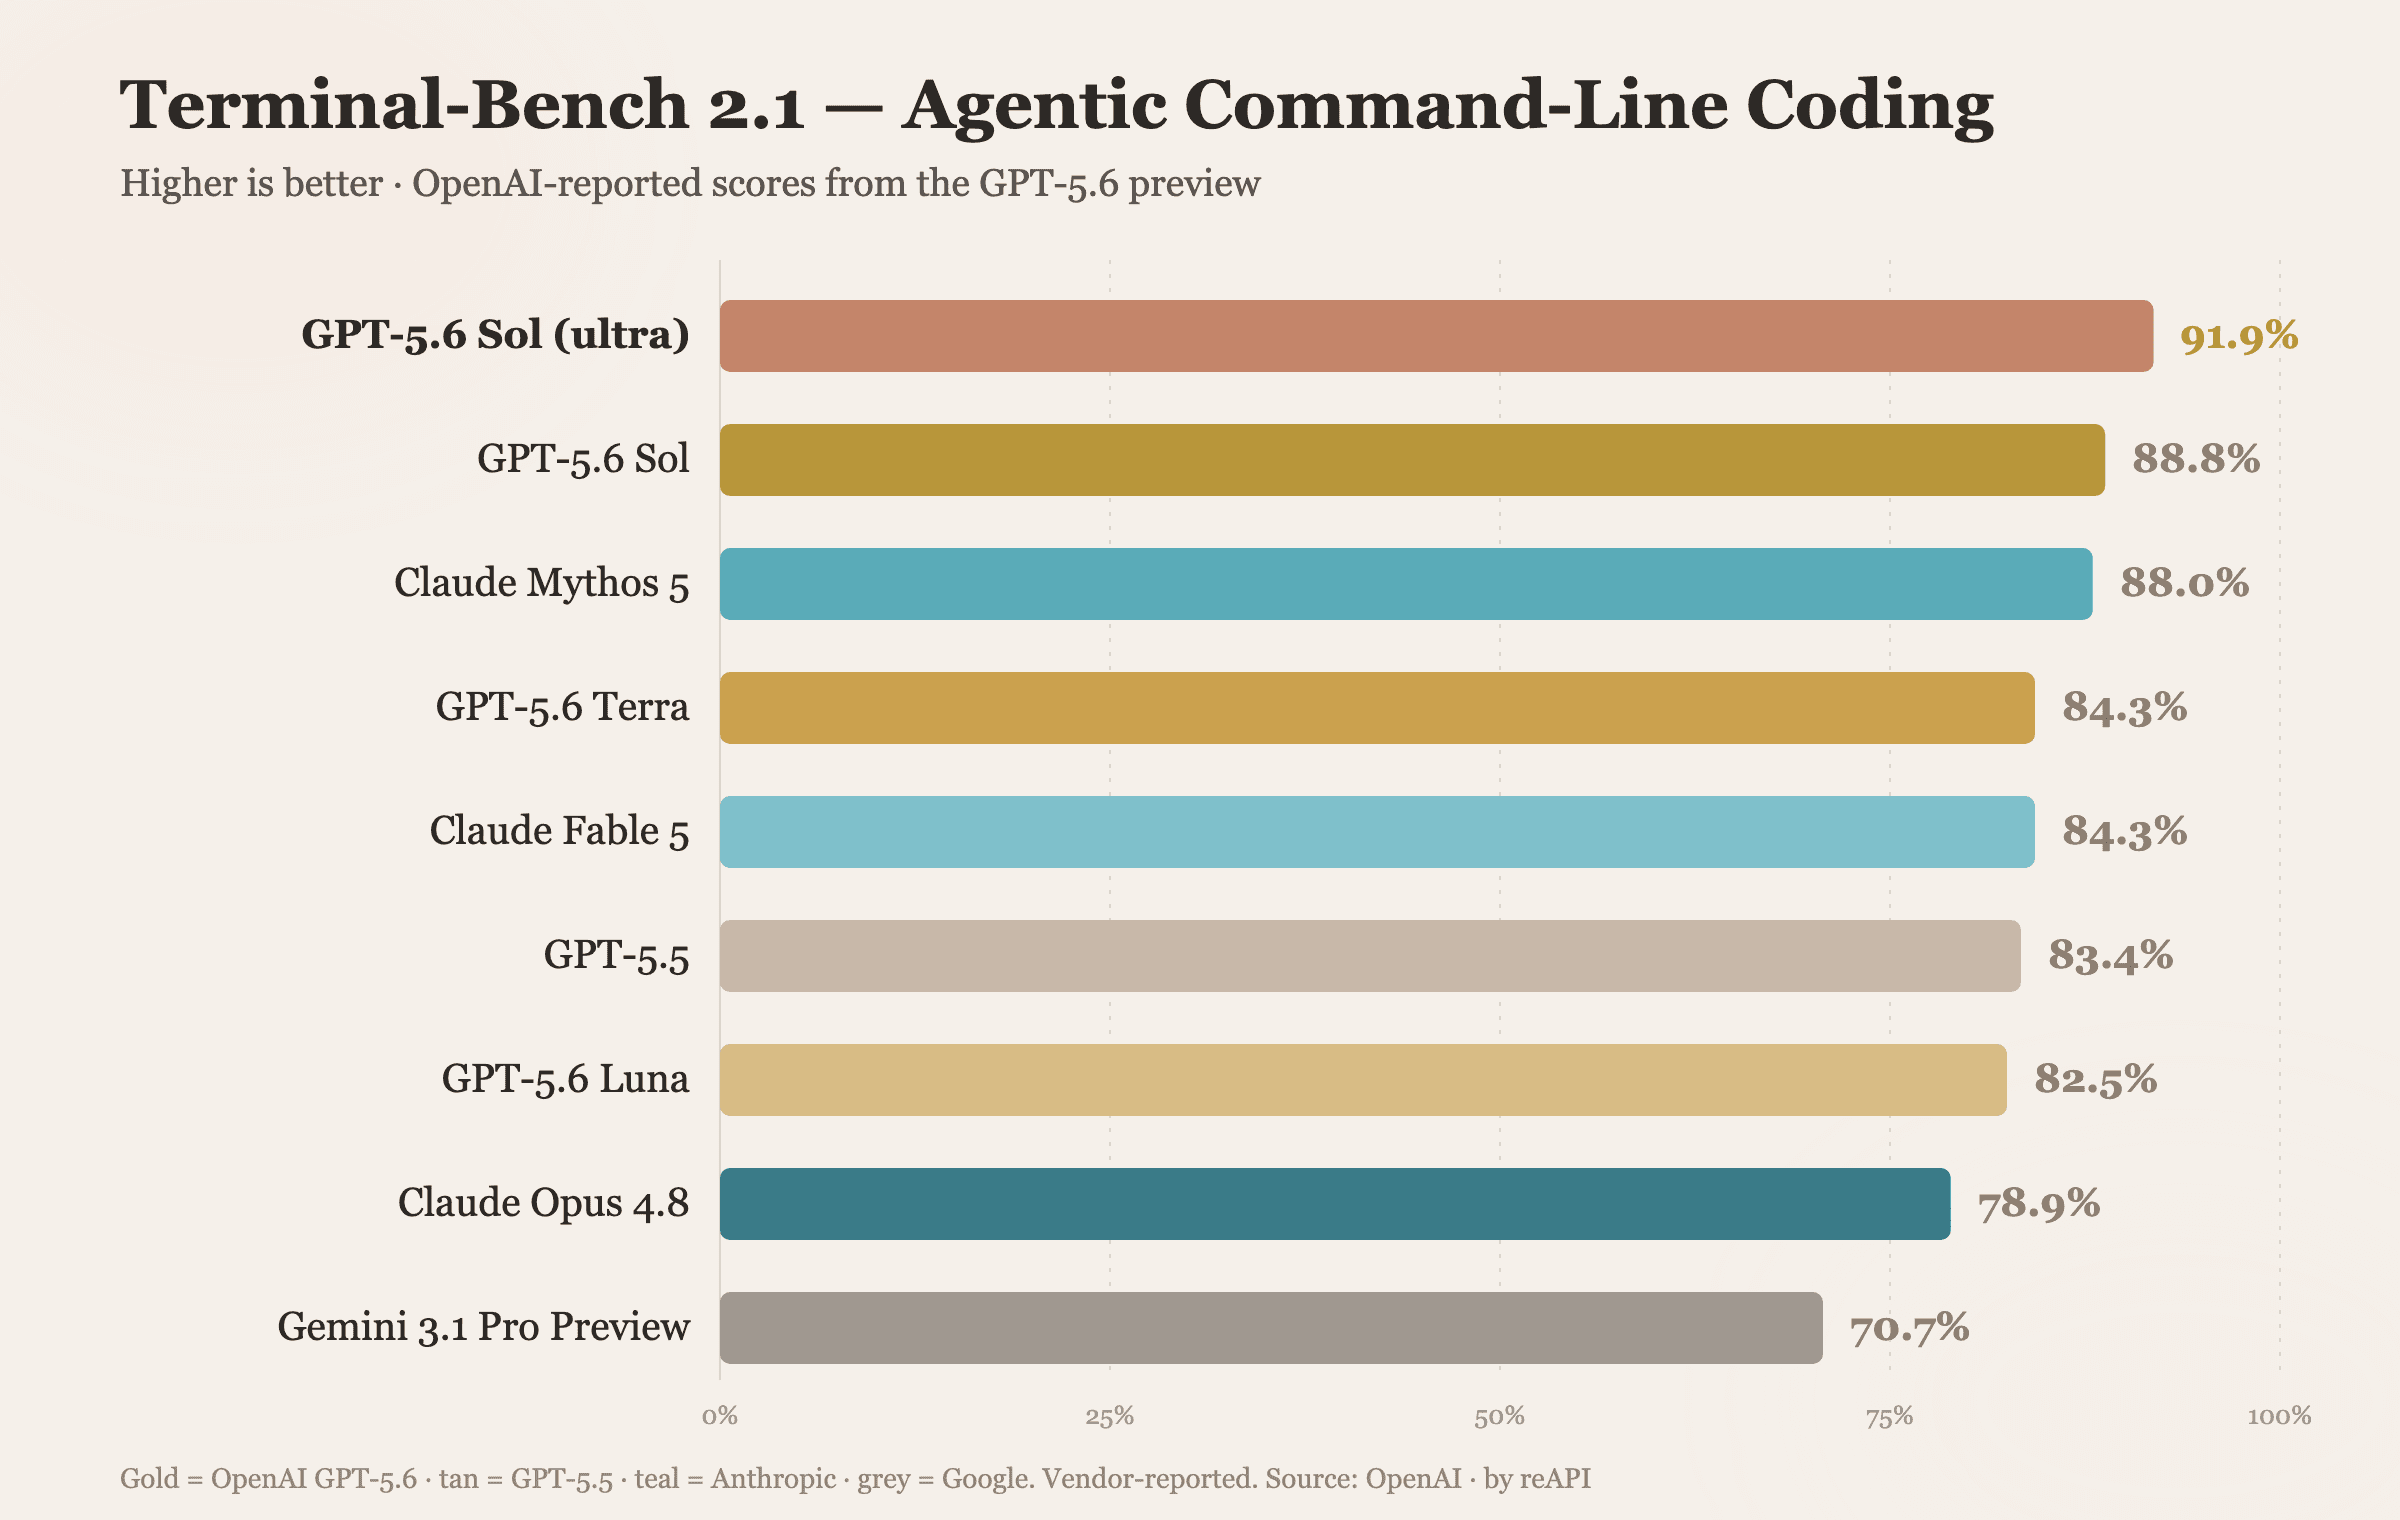
| 模型 | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (ultra 模式) | 91.9% |
| GPT-5.6 Sol | 88.8% |
| Claude Mythos 5 | 88.0% |
| GPT-5.6 Terra | 84.3% |
| Claude Fable 5 | 84.3% |
| GPT-5.5 | 83.4% |
| GPT-5.6 Luna | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
仔细看这个表格,它在四个方面比"新的最先进"的标题更诚实[1]。
91.9% 的记录使用 ultra,这不是单个智能体。 它来自 Sol 编排子智能体。与单智能体基线比较它不是苹果比苹果。公平的比较是 Sol 的 88.8%。
单智能体 Sol 超越 Claude Mythos 5 仅 0.8 个百分点。 同一模型的两次运行可能不同超过这个值。OpenAI 在编码曲线顶端确实有实际领先,但在这个基准上它很窄,不是爆炸性突破。
Terra 与 Claude Fable 5 打成平手,略胜 GPT-5.5。 84.3% 与 Fable 5 完全相同,仅比它替代的模型高不到一个百分点。结合价格下降,这是真正的商业故事:以更低的发布价获得相近的已公布 Terminal-Bench 结果,而不能证明各类任务中的编程能力相等。
Gemini 3.1 Pro Preview 落后约 21 个百分点。 这个差距是真实的但特定于基准。Gemini 在这里没有展示的长文本检索和多模态工作上领先。
在生物学方面,OpenAI 报告 Sol 在 GeneBench v1 上实现了比 GPT-5.5 更强的结果同时使用更少 token,但没有发布原始数字,所以那是定向声明而不是可验证的分数[1]。
max 和 ultra
发布时的比较使用了 max 和 ultra 多智能体评测设置。当前接入 API 时,应将这个历史标签与文档规定的参数区分开:Sol、Terra 和 Luna 都支持 max,而 ultra 不属于它们当前六个推理强度值。[3][4][5]
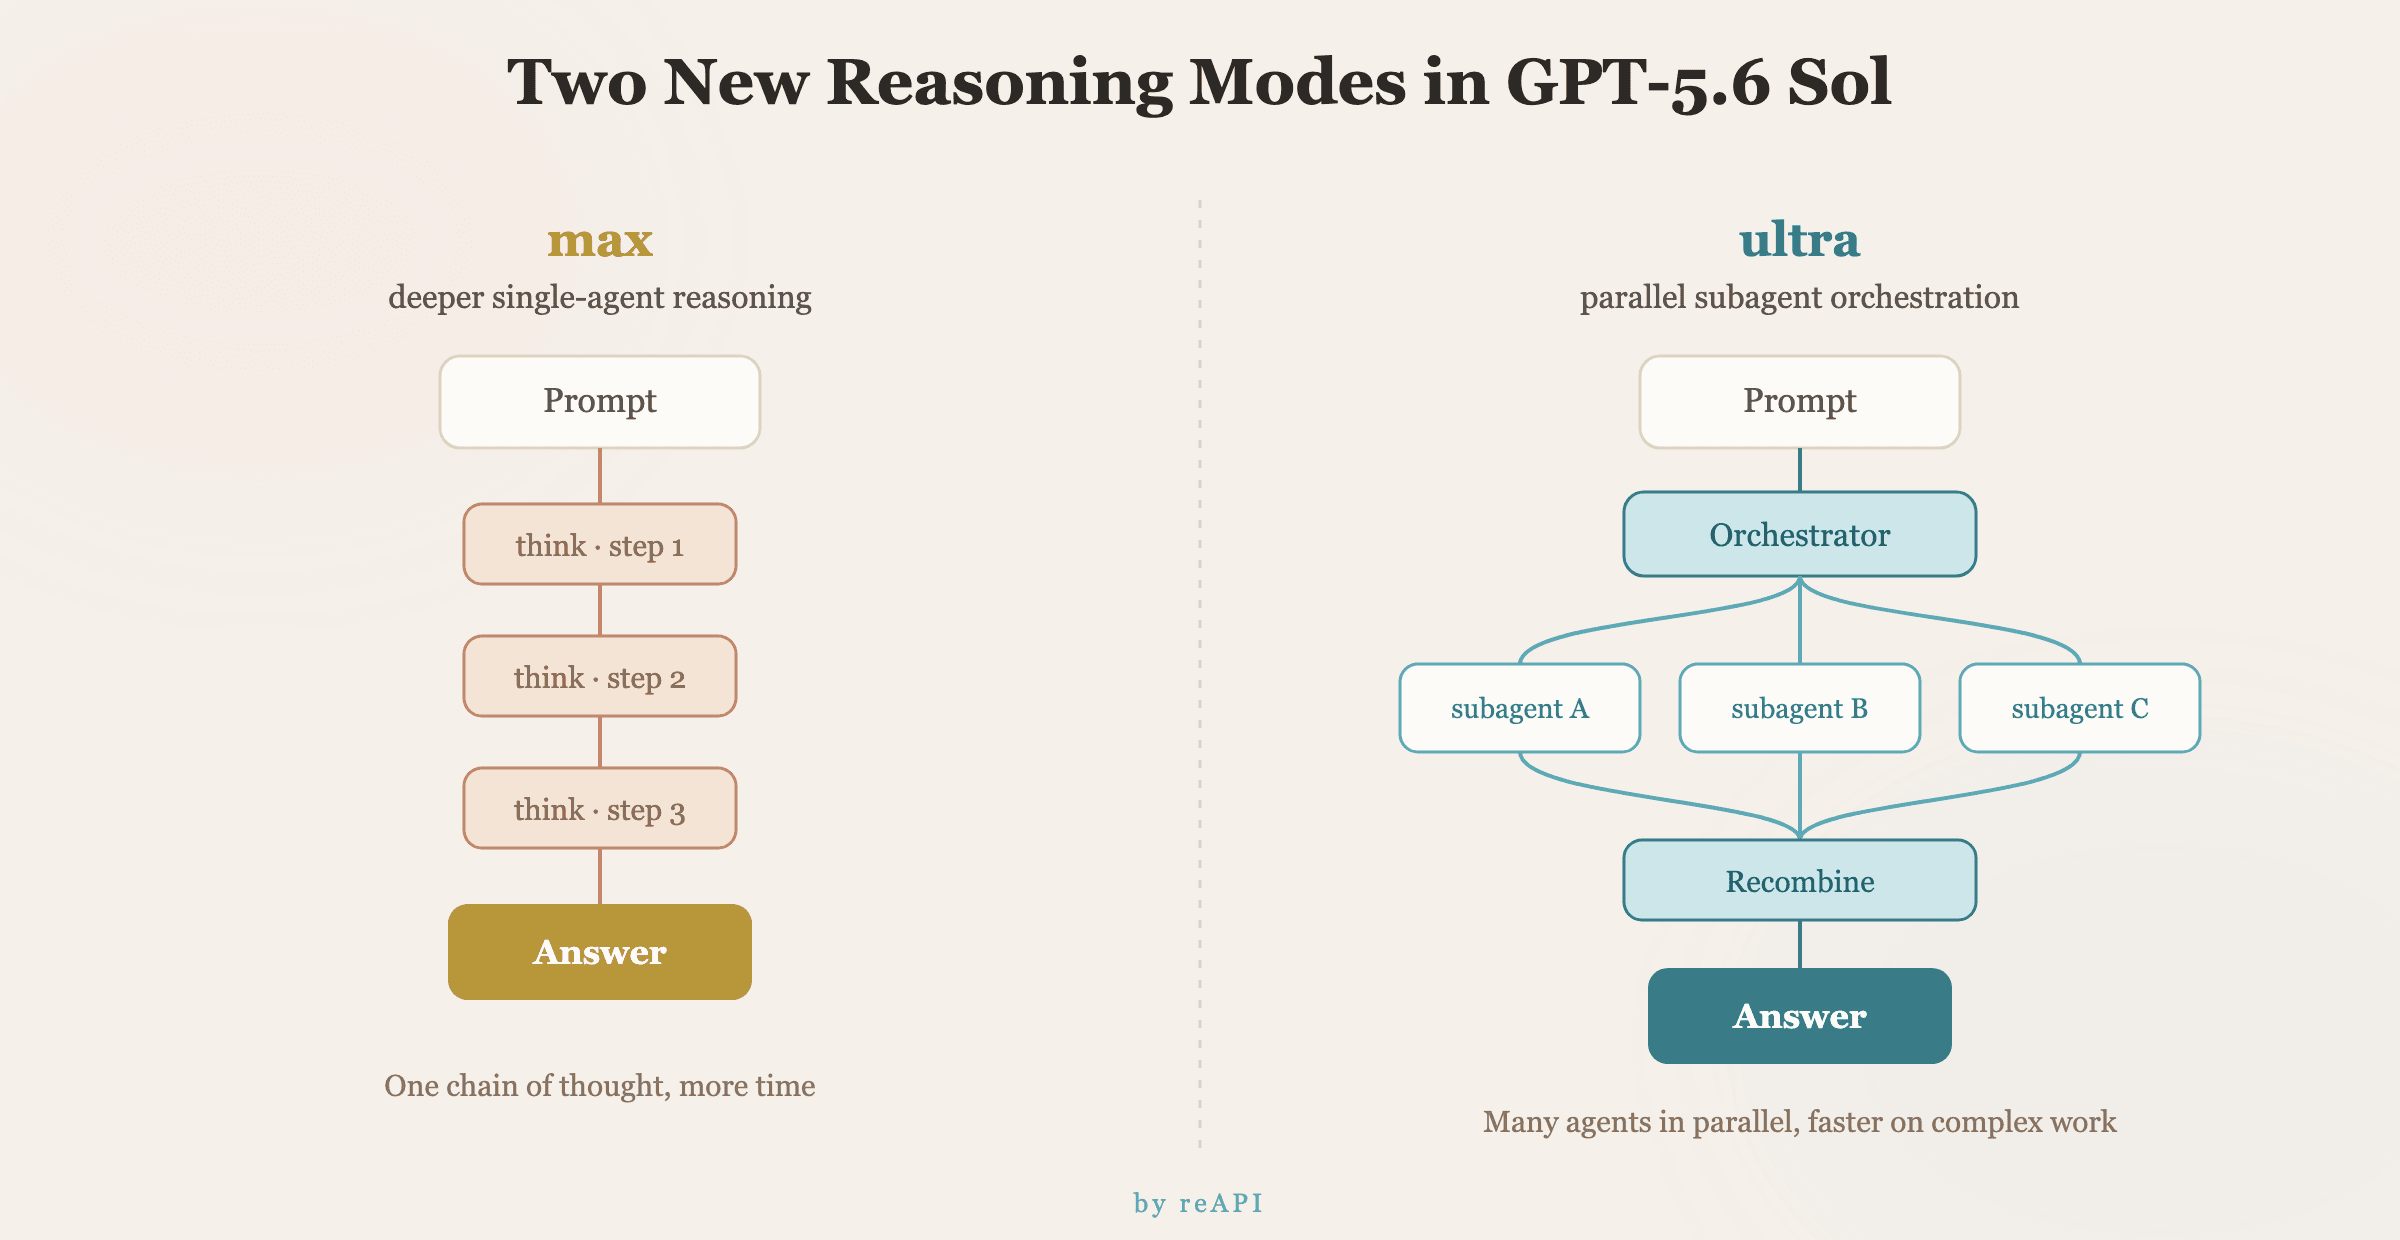
配图描述的是发布时的比较。其中的 ultra 分数使用了子智能体,并非同等条件下的单智能体结果。它不能证明存在可调用的 ultra 参数,也不能证明 reAPI 内置了这项编排能力。
OpenAI 当前的 Responses API 则分别提供推理强度和推理模式控制。reasoning.mode 可选择 standard 或 pro;Pro 模式会执行更多模型工作,并按该模型的标准 token 费率对产生的 token 计费。因此,即使单个 token 的费率不变,总成本也可能更高。GPT-5.6 在两种模式下的默认强度都是 medium。[6]
reAPI 为这些模型提供的公开路由是 Chat Completions,使用 reasoning_effort。不能假设把字段复制到该请求中,就能启用 OpenAI 仅在 Responses 中提供的模式、持久化推理或托管智能体功能。
gpt 5.6 pricing
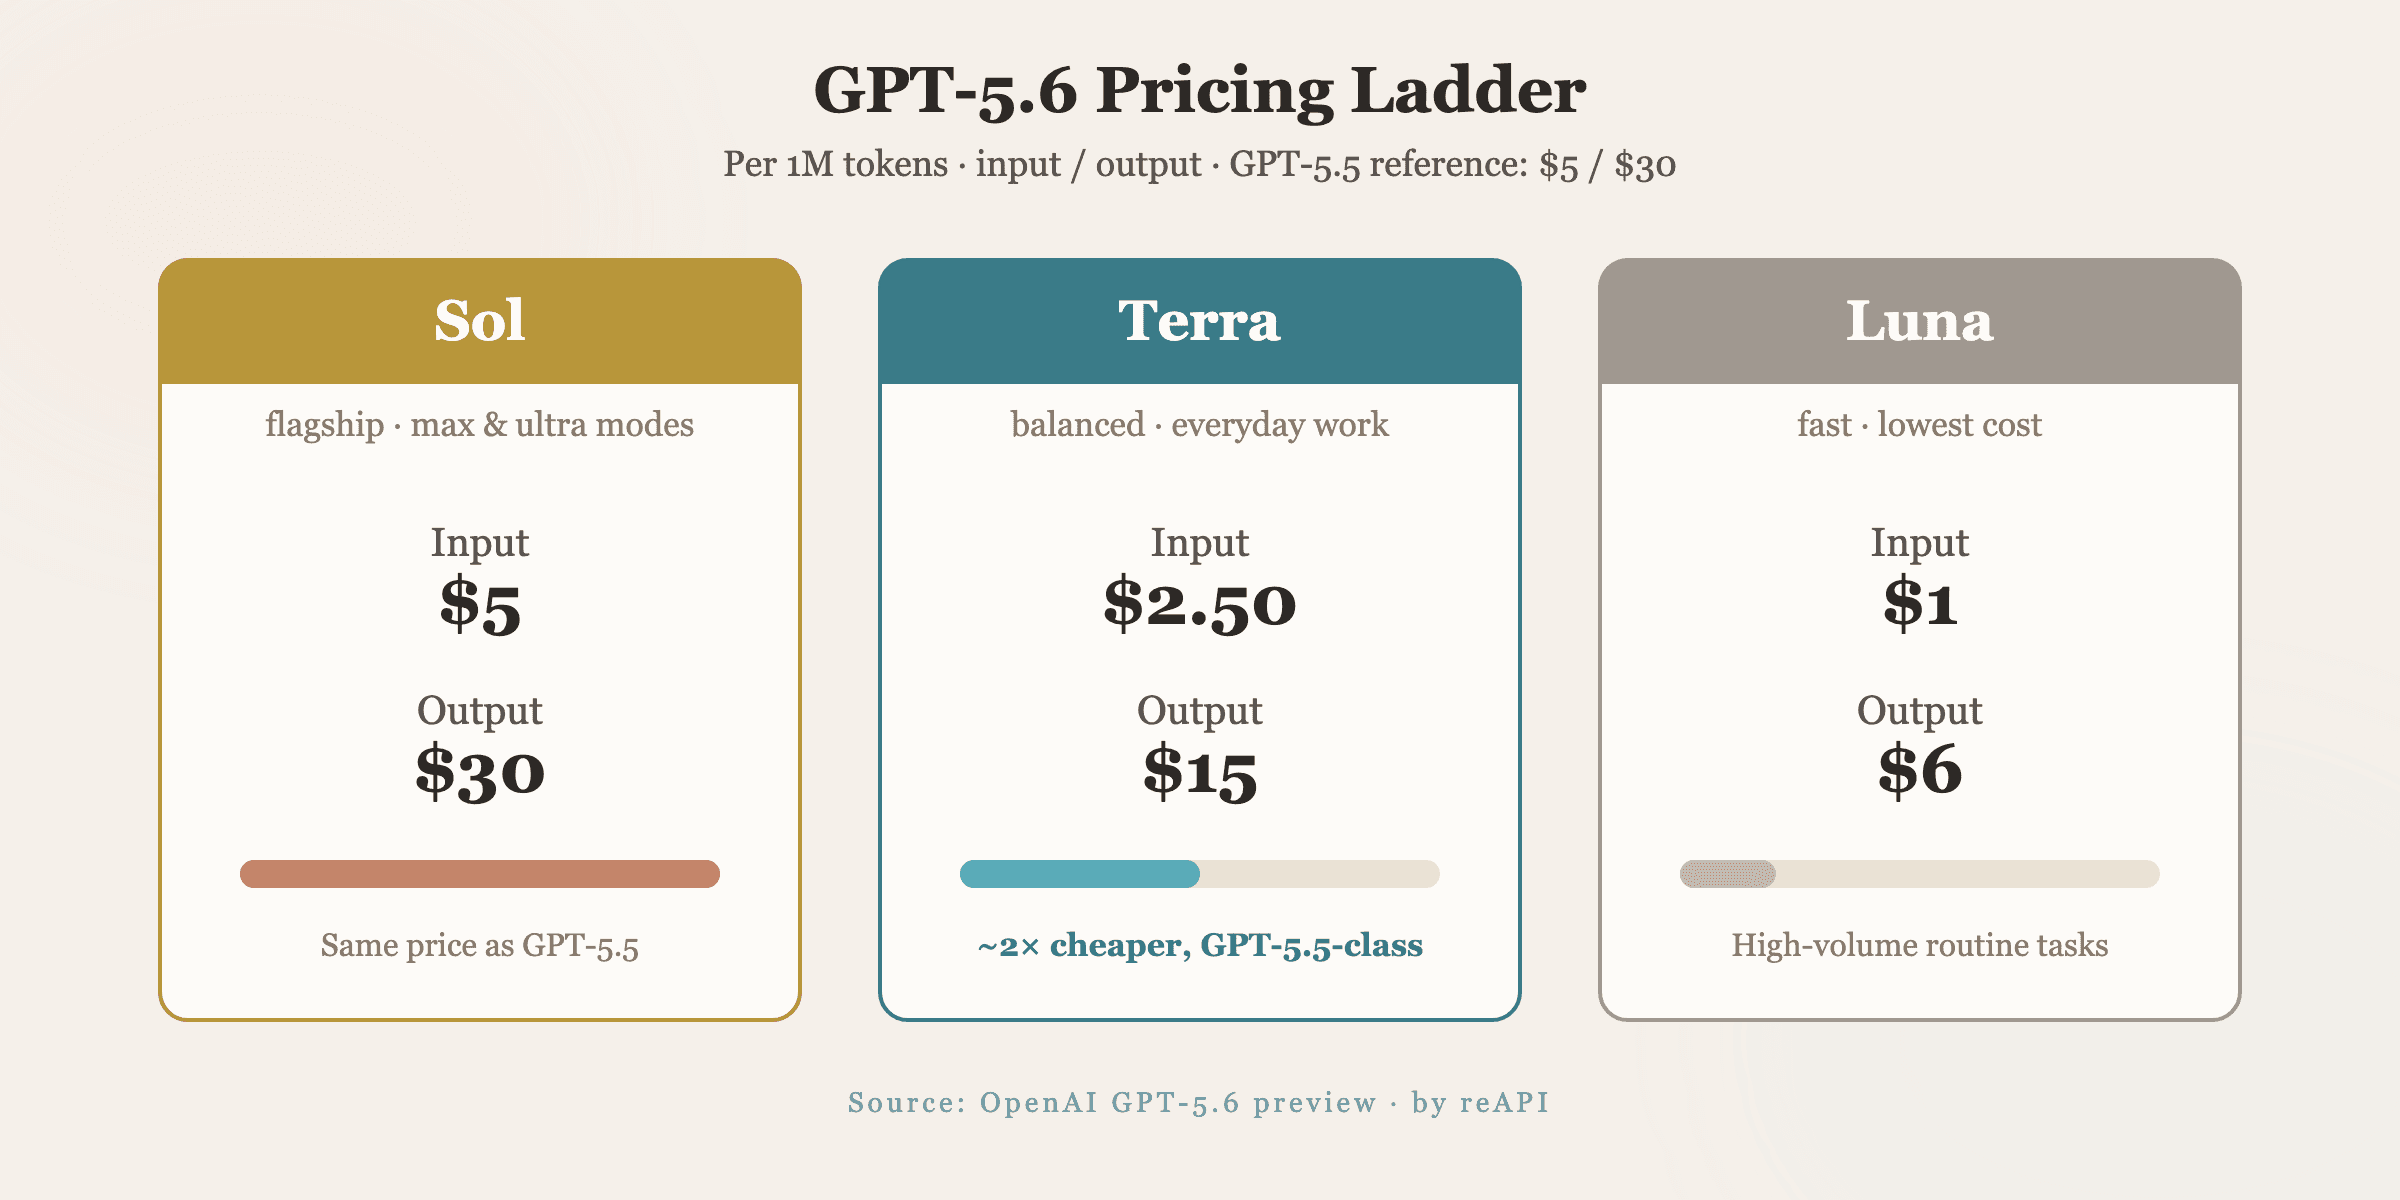
配图保留的是发布价格。下表当前价格列均为短上下文的每百万 token 输入/输出价格,不能通用于所有提示词长度或处理模式。[2][8]
| 档位 | OpenAI 推出时的挂牌价(每百万输入/输出) | OpenAI Standard,2026 年 10 月 23 日 | reAPI 上的价格,2026 年 10 月 23 日 |
|---|---|---|---|
| GPT-5.6 Sol | $5 / $30 | $4 / $20 | $3.20 / $16.00 |
| GPT-5.6 Terra | $2.50 / $15 | $2 / $12 | $1.60 / $9.60 |
| GPT-5.6 Luna | $1 / $6 | $0.20 / $1.20 | $0.16 / $0.96 |
两个东西在 OpenAI 推出时的数字中脱颖而出。Sol 保持了 GPT-5.5 的精确 $5 / $30 定价同时添加能力和新模式,这是更多却钱相同的罕见情况。而 Terra 在发布时报告了与 GPT-5.5 相近的 Terminal-Bench 结果,同时发布价更低,因此值得评估[1]。把 Sol 的 token 效率增益叠加上去,因为它用更少的输出 token 达到可比结果,每个任务的有效成本下降比标题费率暗示的要大。
OpenAI 此后下调了三个档位的挂牌价格,其中 Sol 属于促销,官方表示至少持续至 2026 年 11 月 21 日[2]。Sol 现在低于 GPT-5.5 的 $5 / $30,而不再与其持平。当前 reAPI 短上下文输入/输出费率为 OpenAI Standard 的 80%,但各档位的相对价格已经变化:Luna 的 $0.20/$1.20 为 Terra 的 $2/$12 的十分之一,而发布时并不是这个比例。Sol 的 11 月日期是最低促销期限,不代表次日一定涨价。应选择满足实测质量要求的最低成本档位,而不是自动默认 Terra。
输入超过 272K token 时,OpenAI 对整个请求按 2x 输入费率和 1.5x 输出费率收费,而不是只对超过门槛的 token 加价。当前 Standard 缓存和长上下文费率如下:[2]
| 档位 | 短上下文缓存读取 / 30m 写入 / 12h 写入 | 长上下文输入 / 输出 | 长上下文缓存读取 / 30m 写入 / 12h 写入 |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI 支持隐式和显式缓存。默认 30 分钟缓存写入的费用为普通输入的 1.25x;Responses API 还提供最低保留 12 小时的选项,费率为 2.5x。这些是写入总费率,不是在普通输入之上另加的费用。这三个模型的读取费率为 0.1x。可缓存前缀至少需要 1,024 token。12 小时设置表示最低存续时间,不是到期删除时点。[7]
以不使用缓存的 20,000 个输入 token 和 5,000 个计费输出 token 为例,OpenAI Standard 的计算为 (20,000 × input rate + 5,000 × output rate) / 1,000,000:Sol $0.18、Terra $0.10、Luna $0.01。按 reAPI 短上下文输入/输出费率,三者分别为 $0.144、$0.08 和 $0.008。这里固定了 token 数量,计费输出包含推理,不含工具、税费和缓存操作;这些是计算示例,不是实测的任务完成成本。
对于不使用缓存的 300,000 个输入 token 和 5,000 个计费输出 token,OpenAI 对整个请求应用长上下文费率后,费用为 Sol $2.55、Terra $1.29、Luna $0.129。较低的短上下文费率不再适用。对于使用缓存的请求,应先区分普通输入、缓存读取和缓存写入,再分别乘以对应费率;若把缓存 token 再算作普通输入,会高估账单。
reAPI 在 10 月 23 日渲染出的长上下文输入/输出费率为每百万 token Sol $6.40/$24.00、Terra $3.20/$14.50、Luna $0.320/$1.440。Terra 显示的长上下文输出价是 $14.50,因此不能把“80%”概括为所有费率。请在模型页核对具体类别;此表不承诺 reAPI 提供 OpenAI 可选的缓存存续时间。[8]
以上 OpenAI 数字采用 Standard 处理模式,不含单独计价的工具及区域处理附加费。Batch、Flex 和 Fast 模式有独立价目表,不能将某个模型的其他处理模式与另一模型的 Standard 费率当成服务条件相同来比较。[2]
塑造这次推出的审查
即便现在访问已开放,理解这部分仍值得关注,因为它是先例而不是脚注。
OpenAI 限制初始发布到大约二十个经过审核的合作方,其中美国政府要求在事先预览模型能力[1]。触发器是网络安全能力。Sol 显著推进了漏洞研究,在涉及 Chromium 和 Firefox 的评估中,它识别了 bug 和利用原语,即漏洞的构建块,而没有在测试条件下自主生产功能完整的全链利用。OpenAI 声称 Sol 不超越其备战框架中的网络关键阈值,这个区分是发布它的全部基础[1]。
值得注意的是,OpenAI 没有将这个安排背书为永久,说这类政府访问流程不应变成长期默认,因为它阻止了最好的工具到达需要它们的防守者[1]。
随它一起发布的安全栈值得了解,因为它预示了高能力模型将如何普遍推出:训练内置的拒绝、可以暂停生成供更大模型审查的实时网络和生物学分类器、账户级审查标记活动,以及对最敏感能力的区分访问。OpenAI 为通用越狱的自动红队投入了超过 700,000 个等效 A100 GPU 小时[1]。
OpenAI 坦言这些保障会误触:合法的安全研究者可能在双用途请求上触发拒绝。
案例强强弱弱的地方
强。 智能体命令行编码,这里单智能体 Sol 在基准上领先而 ultra 扩展了它。Token 效率,这对高容量智能体复合。中端价值,这里 Terra 的价格下降是这次发布最广泛有用的改变。发布时的 ultra 结果包含多智能体编排,应将其理解为评测设置,而不是对当前 reAPI 功能的承诺[1]。
弱。 标题是一个基准上 0.8 点的胜利。评估窗口意图小,没有 SWE-bench、GDPval、数学或幻觉数字发布,所以 GPT-5.6 是否修复了困扰 GPT-5.5 的自信幻觉问题仍未知。而一切都是 OpenAI 在其自身工具下的供应商报告[1]。
直到扩展套件和独立评分登陆,对一般能力的判断应保持保留。
如何使用 GPT-5.6:选择哪个档位
Luna 用于成本敏感、且能通过检查的大批量常规任务。 从有代表性的分类、抽取或短答案任务开始,记录通过验收的输出、重试和审核工作量。只有输出满足工作要求,更低的 token 价格才有意义。
Terra 用于额外能力足以改善结果、并证明其价格合理的场景。 应在 Luna 的实际失败用例上比较,而不是认为每个生产请求都需要中间档位。发布时的编程基准只能说明该项评测结果,不能证明所有任务上的能力相等。
Sol 用于改善效果足以抵消额外成本的复杂专业工作。 采用相同工具和验收标准测试高难度编程或长程任务。三个档位均支持 max;更高推理强度和更大上下文窗口都不是 Sol 独有。不能假设 ultra 是受支持的请求值,并据此选择 reAPI 档位。
在 reAPI 上调用 GPT-5.6
三个档位都已注册到 reAPI 的 OpenAI 兼容接口 https://reapi.ai/api/v1/chat/completions。请使用当前 reAPI 工作区的 key,以及带档位后缀的准确请求模型 ID,保留 OpenAI ID 中的点:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)
将 gpt-5.6-terra 替换为 gpt-5.6-sol 或 gpt-5.6-luna,即可在相同 Chat Completions 请求格式下比较档位。OpenAI 文档记载了不带后缀的 gpt-5.6 别名,但 reAPI 当前登记的是三个带后缀的 ID,在这里应使用这些准确字符串。reAPI 为三者配置的输出上限均为 128,000 token,文档列出的推理强度值为 none、low、medium、high、xhigh 和 max。[8]
OpenAI 为这一系列同时提供 Chat Completions 和 Responses,并推荐推理工作流使用 Responses。reAPI 未公开 /v1/responses 路由。参数可以透传,并不证明功能等同:不能假设此 Chat 接口复现了 OpenAI 托管工具集、Pro 推理模式或持久化推理约定。所链接的 reAPI 接口文档说明了接入方式;本次文章更新没有执行生产生成调用。[6][8]
当前费率在 reapi.ai/models/gpt-5-6-sol、reapi.ai/models/gpt-5-6-terra 和 reapi.ai/models/gpt-5-6-luna。
FAQ
max 和 ultra 模式之间有什么区别?
max 是当前 GPT-5.6 三个档位都支持的推理强度值。历史 ultra 基准使用子智能体,得到 Terminal-Bench 的 91.9% 头条分数;它不属于当前六个强度值。OpenAI 单独提供的 reasoning.mode: "pro" 属于 Responses,不能将其混同于 ultra 字段或 reAPI Chat 功能。[1][3][6]
GPT-5.6 Sol 在编码上比 Claude 更好吗?
在 Terminal-Bench 2.1 上,单智能体 Sol 在 88.8% 超越 Claude Mythos 5 在 88.0% 仅 0.8 点,这是一个实际但窄的领先。用 ultra Sol 到达 91.9%,但那使用子智能体而不是像对像的单智能体比较[1]。
我应该使用哪个 GPT-5.6 档位?
常规大批量任务先评估 Luna,Luna 不能满足要求时评估 Terra,高难度工作中额外质量足以抵消成本时评估 Sol。三者的文档上下文窗口、输出上限和推理强度档位相同;应按通过验收的任务成本和自己的测试选择,而不是假定存在 ultra 接入。
为什么美国政府涉及这次发布?
Sol 显著推进了网络安全能力,包括漏洞研究,而没有超越 OpenAI 的网络关键阈值。美国政府要求 OpenAI 对约二十个经过审核的合作方进行分阶段预览,而网络框架被开发[1]。
GPT-5.6 是否修复了 GPT-5.5 的幻觉问题?
未知。OpenAI 在预览中仅发布了编码、生物学和网络安全评估而保留了幻觉和知识工作数字[1]。将模型与源地基验证配对以获得高风险输出。
GPT-5.6 Sol 的上下文窗口有多大?
OpenAI 当前文档规定总上下文窗口为 1,050,000 token、最大输入为 922,000 token、最大输出为 128,000 token。Terra 和 Luna 的限制相同。早期约 1.5 百万 token 的报道不是当前官方规格。[3][4][5]
Prompt 缓存中改变了什么?
OpenAI 支持隐式缓存和显式缓存断点,默认 30 分钟缓存写入费率为普通输入的 1.25x;Responses API 可选择最低 12 小时,费率为 2.5x。这三个模型的读取费率为 0.1x。写入费率是总费率,最低存续时间不代表到期删除时点;reAPI 的 Chat 路由不承诺提供相同的可配置缓存控制。[7]
我如何用 OpenAI SDK 调用 GPT-5.6?
将 OpenAI 客户端指向 https://reapi.ai/api/v1,使用 reAPI 工作区的 key,并将 model 设为 gpt-5.6-sol、gpt-5.6-terra 或 gpt-5.6-luna。保留点和档位后缀;本站没有登记 OpenAI 的不带后缀别名。[8]
阅读三档发布
GPT-5.6 是两个发布穿一个声明。一个是普通、执行良好的家族更新:明智的命名重置、一个发布价更低、已公布 Terminal-Bench 结果与 GPT-5.5 相近的中端档,以及使用多智能体编排的发布时 ultra 基准。另一个是前沿模型,其初始可用性是与政府协调设置、在 700,000-GPU 小时安全栈后发布的。
当前接入时,应从能通过检查的最低成本档位开始,为推理和长上下文门槛预留预算,并核实工作流需要的 API 功能。发布基准仍是有用的历史证据,但当前模型文档和价格条件才决定请求方式与预算。
跨代比较请阅读 GPT-6 Sol vs Luna 和 GPT-6 Luna vs GPT-5.6 Luna。这些文章回答 GPT-6 迁移问题;本指南单独讨论 GPT-5.6 三个档位之间的选择。
参考资源
-
OpenAI. Models — the GPT-5.6 family, reasoning modes, and specifications. Retrieved July 2026 from platform.openai.com/docs/models
-
OpenAI。价格:各模型和档位的 token 费率。2026 年 7 月查阅,2026 年 10 月 23 日复核。https://developers.openai.com/api/docs/pricing
-
OpenAI。GPT-5.6 Sol 模型文档。核查日期:2026 年 10 月 23 日。https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI。GPT-5.6 Terra 模型文档。核查日期:2026 年 10 月 23 日。https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI。GPT-5.6 Luna 模型文档。核查日期:2026 年 10 月 23 日。https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI。推理模型:强度、模式及 token 计量。核查日期:2026 年 10 月 23 日。https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI。提示词缓存:最低存续时间与写入/读取价格。核查日期:2026 年 10 月 23 日。https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI。模型页渲染价格与接口文档。核查日期:2026 年 10 月 23 日。https://reapi.ai/zh/models/gpt-5-6-sol — https://reapi.ai/zh/models/gpt-5-6-terra — https://reapi.ai/zh/models/gpt-5-6-luna — https://reapi.ai/zh/docs/gpt-5-6-sol — https://reapi.ai/zh/docs/gpt-5-6-terra — https://reapi.ai/zh/docs/gpt-5-6-luna
延伸阅读
- reAPI. How to use Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. How to use Claude Fable 5. reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Model catalog. reapi.ai/models
作者

分类
max 和 ultragpt 5.6 pricing塑造这次推出的审查案例强强弱弱的地方如何使用 GPT-5.6:选择哪个档位在 reAPI 上调用 GPT-5.6FAQmax 和 ultra 模式之间有什么区别?GPT-5.6 Sol 在编码上比 Claude 更好吗?我应该使用哪个 GPT-5.6 档位?为什么美国政府涉及这次发布?GPT-5.6 是否修复了 GPT-5.5 的幻觉问题?GPT-5.6 Sol 的上下文窗口有多大?Prompt 缓存中改变了什么?我如何用 OpenAI SDK 调用 GPT-5.6?阅读三档发布参考资源延伸阅读更多文章
Seedance 2.5 对比 Veo 3.1:时长、音频和成本
对比 Seedance 2.5 与 Veo 3.1 在 30 秒视频、8 秒生成、参考资料、4K、原生音频和计费单位上的差异,做出正确选择。
可灵4.0发布时间:Kling 4.0 已于 10 月 15 日全面开放
Kling 4.0(可灵 4.0)于 2026 年 10 月 15 日正式发布,经历了 9 月 28 日公告和 Flash 抢先体验阶段。本文对比官方规格与此前泄露,并说明 API 现状。
完整指南:用一张产品照片制作多场景AI视频广告
从单张产品照片到专业多场景AI视频广告的详细端到端工作流:创意简报、镜头卡、参考规则、提示词、API示例和完整质量检查。