GPT-6 Luna API 价格:Token 费率与成本计算
GPT-6 Luna API 价格,数据取自 OpenAI 价格页:输入、输出、缓存读取与写入、272K 长上下文档位、Batch 与 Fast,并附成本算例。
在 OpenAI 的 Standard 档位下,GPT-6 Luna API 的价格为每百万输入 token $0.10、每百万输出 token $0.50,是 GPT-6 系列中最低的费率[1]。不过这两个数字只是账单的一部分。缓存输入、缓存写入、超过 272K token 的提示词单独计价,以及按输出计费的推理 token,都会改变实际成本。
本文列出 OpenAI 价格页上 GPT-6 Luna 的全部费率(获取于 2026 年 10 月 7 日),说明一次请求如何计价,并给出五个写明假设的成本场景,方便你用自己的 token 数重算一遍。
要点速览
- Standard 费率(每 1M token): 输入 $0.10,缓存输入 $0.01,缓存写入 $0.125,输出 $0.50[1]。
- 输入超过 272K token 时,整个请求改按输入 $0.20、缓存输入 $0.02、缓存写入 $0.25、输出 $0.75 计价[1][2]。
- Batch 和 Flex 是 Standard 的一半价格;Fast 模式是两倍;区域处理加收 10%[2]。
- 推理 token 按输出计费,所以除调用量之外,推理强度是影响成本最大的因素[3]。
- 短请求很便宜: 500 个输入 token 加 10 个输出 token,按 Standard 费率是 $0.000055,即每百万次这样的请求 $55(我们自己的计算,见下文)。
- 与 GPT-6 其他型号相比: Astra 的 Standard 费率恰好是 Luna 的 100 倍,GPT-6 Sol 的输入和输出是 Luna 的 20 倍[1]。
GPT-6 Luna API 各类 token 的价格
OpenAI 按 token 类型和提示词长度为 GPT-6 Luna 定价。“短上下文”指最多 272K 输入 token;超过之后,整个请求都适用长上下文费率[1]。
| 每 1M token(Standard) | 输入不超过 272K | 输入超过 272K |
|---|---|---|
| 输入 | $0.10 | $0.20 |
| 缓存输入 | $0.01 | $0.02 |
| 缓存写入 | $0.125 | $0.25 |
| 输出 | $0.50 | $0.75 |
来源:OpenAI API 价格页,Standard 档位[1]。
模型页写明了这些数字背后的倍率。缓存输入是未缓存输入费率的 10%,缓存写入是它的 1.25 倍;输入超过 272K token 的提示词“整个请求的输入和缓存费率按 2 倍、输出按 1.5 倍计价”[2]。
Batch、Flex、Fast 与区域处理
处理档位会让每项费率按固定倍数变化。OpenAI 模型页写道:“Batch 和 Flex 按 Standard 费率的 50% 计价。Fast 模式按适用费率的 2 倍计价”;区域处理则“在可用的地区加收 10% 溢价”[2]。
| 每 1M token,输入不超过 272K | 输入 | 缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
来源:OpenAI API 价格页,Standard、Batch、Flex 与 Fast 价格表[1]。
Batch 适合离线任务,比如夜间批量分类或数据回填。Fast 模式是 OpenAI 为延迟敏感流量提供的选项,OpenAI 表示 GPT-6 Luna 在启用 EU 数据驻留时不支持 Fast 模式[4]。
一次 GPT-6 Luna 请求如何计价
对于输入不超过 272K token 的提示词,按 Standard 费率:
cost = ( uncached_input × 0.10
       + cached_input   × 0.01
       + cache_write    × 0.125
       + output         × 0.50 ) / 1,000,000
输入超过 272K token 时,整个请求换用 0.20、0.02、0.25 和 0.75。每个 token 落进哪一类,由以下四条规则决定。
推理 token 算作输出。 OpenAI 表示,推理 token “会占用模型上下文窗口中的空间,并按输出 token 计费”[3]。GPT-6 Luna 支持六个推理强度档位,从 none 到 max,默认是 medium[2]。一个两个词的分类标签,背后可能带着数百个计费的推理 token。
缓存费用替代输入费率,而不是在其上叠加。 OpenAI 的缓存指南说,缓存写入的计价“不是附加费用:输入 token 采用未缓存输入、缓存输入或缓存写入三者之一的费率”[5]。
短前缀永远不会被缓存。 对 GPT-5.6 及之后的模型,可缓存提示词的最小长度为 1,024 token;缓存前缀在最后一次写入或复用后至少 30 分钟内保持可用[5]。
272K 的界线按单个请求计算。 一个 300K 输入 token 的提示词会全部按长上下文费率计费,输出也包括在内[2]。
GPT-6 Luna API 成本计算:五个算例
下表每一行都使用上文的 OpenAI 刊例费率。token 数是为说明而选定的假设,不是实测值。请换成你自己响应里 usage 对象给出的数字。
| 场景 | 假设 | 算式 | 合计 |
|---|---|---|---|
A. 工单打标签,推理强度 none | 1,000,000 次请求 × 500 输入、10 输出 | 500M × $0.10 + 10M × $0.50 = $50 + $5 | $55.00 |
B. 同一任务,推理强度 medium | 同 A,另假设每次请求 300 个推理 token | 500M × $0.10 + 310M × $0.50 = $50 + $155 | $205.00 |
| C. 场景 A 走 Batch | 同 A,按 Batch 费率 | 500M × $0.05 + 10M × $0.25 = $25 + $2.50 | $27.50 |
| D. 带缓存前缀的客服助手 | 100,000 次请求;4,000 token 的固定前缀写入 1,000 次、读取 99,000 次;每次另有 1,000 个新输入 token 和 400 个输出 token | 396M × $0.01 + 4M × $0.125 + 100M × $0.10 + 40M × $0.50 = $3.96 + $0.50 + $10 + $20 | $34.46 |
| E. 长文档 | 1,000 次请求 × 400,000 输入、2,000 输出(长上下文档位) | 400M × $0.20 + 2M × $0.75 = $80 + $1.50 | $81.50 |
有三点值得注意。
在这里,推理强度比调用量更花钱。 在 B 中,假设的推理过程让输出 token 成了账单的大头,任务成本是场景 A 的 3.7 倍。在为 medium 付费之前,先测试 none 或 low 能否达到你的准确率目标。
缓存让场景 D 的成本减半。 不用缓存时,同样的流量成本为 500M × $0.10 + 40M × $0.50 = $70.00。缓存读取把前缀部分的费用从 $40 降到 $4.46(含写入)。
272K 的界线让输入价格翻倍。 如果 E 中每份文档都能拆成两个 200,000 token 的请求、每个请求输出 2,000 token,账单就是 400M × $0.10 + 4M × $0.50 = $42.00。拆分会改变模型一次能看到的内容,所以在追求这笔节省之前先检查质量。
GPT-6 Luna 与其他 GPT 模型的价格对比
以下均为输入不超过 272K token 时每 1M token 的 Standard 费率[1]:
| 模型 | 输入 | 缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 |
| GPT-5.6 Luna | $0.20 | $0.02 | $0.25 | $1.20 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 |
OpenAI 将 Luna 的低价归因于“缓存和推理方面的改进”,并以相对 GPT-5.6 降价的形式让利[6]。各模型之间的取舍见 GPT-6 Luna vs 5.6 Luna 和 GPT-6 Sol vs Luna;Sol 自己的费率见 GPT-6 Sol 价格。
通过 reAPI 使用 GPT-6 Luna 的计费方式
reAPI 在 Chat Completions 端点上提供 GPT-6 Luna,模型 id 为 gpt-6-luna,按 token 从你的 reAPI 余额中扣费。输入、输出、缓存读取和缓存写入各有独立费率,推理 token 按输出计费,输入超过 272K token 的提示词整个请求重新计价[7]。每个响应中的 usage 对象会返回 prompt_tokens、completion_tokens(含推理)和 cached_tokens,你可以用上面的公式核对账单[7]。
reAPI 当前的每 token 费率,以及输入、输出 token 的成本估算器,见 GPT-6 Luna 模型页。关于请求格式有一点提醒:向 GPT-6 Luna 发送 temperature 会返回 400,详见 GPT-6 Luna temperature。
常见问题
chat gpt 6 多少钱?
在 API 中,GPT-6 按模型分别按 token 计价:GPT-6 Luna 每 1M token 输入 $0.10、输出 $0.50,GPT-6 Sol 和 GPT-6.1 Sol 为 $2 和 $10,GPT-6 Astra 为 $10 和 $50[1]。在 ChatGPT 中,OpenAI 向 Plus、Pro、Business、Enterprise 和 Edu 用户开放了 GPT-6 Sol 和 Luna,Free 和 Go 用户可以在桌面应用中使用 GPT-6 Luna[6]。
gpt 6 luna 10000 tokens 的价格
按 Standard 费率,10,000 个输入 token 是 $0.001,10,000 个输出 token 是 $0.005[1]。如果这 10,000 个输入 token 都是缓存读取,费用为 $0.0001。
gpt 6 luna 输出 token 费用
按 Standard 费率,输入不超过 272K token 时输出为每 1M token $0.50,超过后为 $0.75[1]。推理 token 计入计费输出[3]。
gpt 6 luna 价格折扣
OpenAI 列出了两种:Batch 和 Flex 按 Standard 费率的 50% 计价,缓存输入按未缓存输入费率的 10% 计价[2]。Fast 模式和区域处理则相反,分别是 2 倍和 +10%。
gpt 6 luna 免费吗
在 API 中,GPT-6 Luna 按上述费率逐 token 计费[1]。在 ChatGPT 中,OpenAI 表示 Free 和 Go 用户可以在桌面应用中使用 GPT-6 Luna[6]。
gpt 6 luna api 费用 vs gpt 6 astra
GPT-6 Astra 的 Standard 费率为每 1M token 输入 $10、缓存输入 $1、缓存写入 $12.50、输出 $50,每一项都恰好是 GPT-6 Luna 对应费率的 100 倍[1]。Astra 还提供价格更高的 Ultrafast 档位;Luna 不在那张价格表中[1]。
GPT API 要多少钱?
取决于模型。在 OpenAI 当前的 Standard 价格表中,费率从 GPT-6 Luna 的每 1M token 输入 $0.10、输出 $0.50,到 GPT-5.5 Pro 和 GPT-5.4 Pro 的输入 $30、输出 $180 不等[1]。
让 GPT-6 Luna 的成本可预测
GPT-6 Luna 账单的大部分由三个选择决定:你发送的推理强度、固定的提示词前缀是否足够长以触发缓存,以及是否有单个提示词超过 272K 输入 token。在一部分流量样本上用真实的 usage 数据逐项测量,再把这些数字代入公式。做到这一步,GPT-6 Luna API 的价格就很容易预测:输入 $0.10、输出 $0.50,所有例外都已写明。
参考资料
- OpenAI. API pricing. 2026 年 10 月获取自 developers.openai.com/api/docs/pricing
- OpenAI. GPT-6 Luna model page. 2026 年 10 月获取自 developers.openai.com/api/docs/models/gpt-6-luna
- OpenAI. Reasoning models. 2026 年 10 月获取自 developers.openai.com/api/docs/guides/reasoning
- OpenAI. Fast mode. 2026 年 10 月获取自 developers.openai.com/api/docs/guides/fast-mode
- OpenAI. Prompt caching. 2026 年 10 月获取自 developers.openai.com/api/docs/guides/prompt-caching
- OpenAI. Introducing GPT-6 Sol and Luna. 2026 年 10 月获取自 openai.com/index/introducing-gpt-6-sol-and-luna
- reAPI. GPT-6 Luna API docs. 2026 年 10 月获取自 reapi.ai/docs/gpt-6-luna
作者

分类
更多文章
AI 视频代理:构建批评循环实现质量保证
构建 AI 视频代理的批评循环,定义镜头验收规则、修复范围和重试预算,通过人工审核门控和选择性修复防止不合格视频进入最终编辑流程。
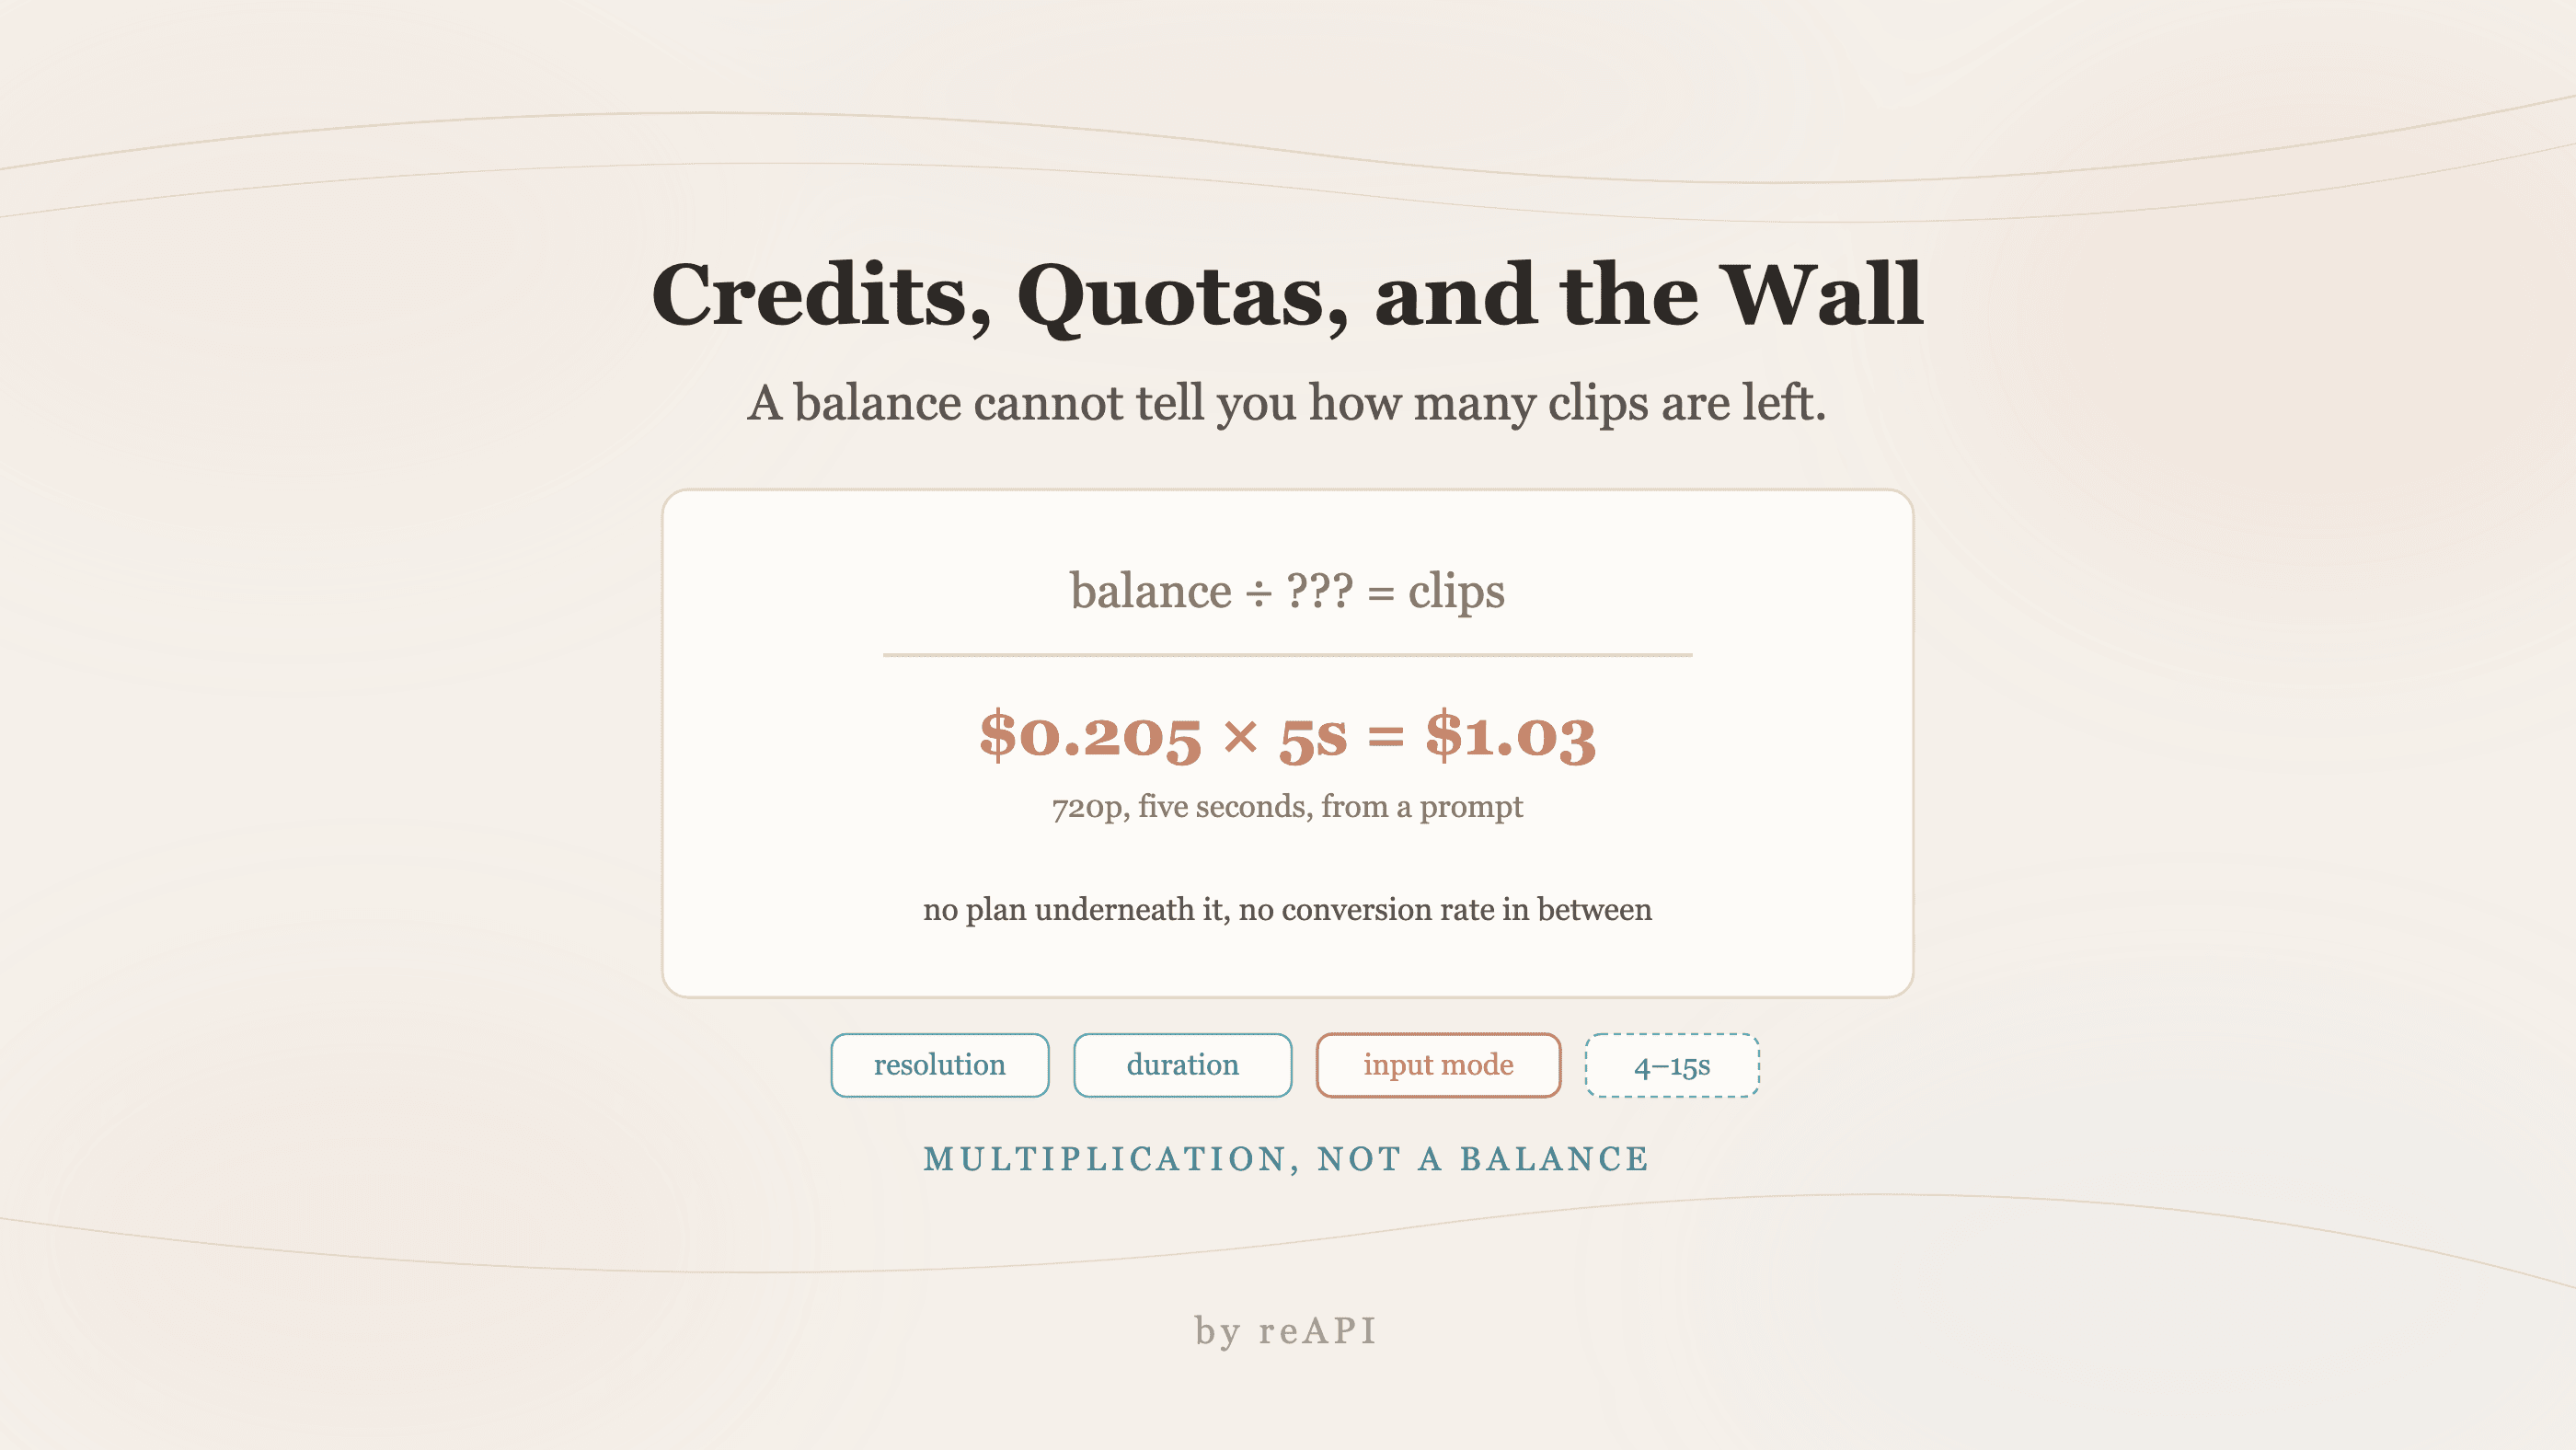
Seedance 积分与配额:余额为何透支
一个积分能换多少条视频,取决于分辨率、时长和输入模式同时起效。按秒计费用乘法精确回答这个问题,透明成本结构避免积分透支。
Suno 有官方 API 吗?公开接入现状、网关与开发者选择
核实 Suno 官方 API 的公开接入状态,区分合作伙伴申请、消费者订阅与独立网关,了解 reAPI 密钥、逐请求费用和当前商用条款边界。