真人 AI 视频生成器:哪些做法真的可行
用真人素材制作 AI 视频:如何准备合规参考图、挑选支持原生对白的模型,并逐项核对输入限制、审核结果与实际生成成本。
真人能不能用作 AI 视频生成器的参考?可以,前提是本人已经同意,而且所选路径明确支持真人参考。实际需要确认的是素材能否接收、模型是否生成语音、审核如何处理,以及一次任务要花多少钱。
真正有用的区分不在于工具,而在于这是谁的脸。已同意的真人照片、合成角色和指名道姓的名人,在法律和技术上是不同的输入。本文说明各类情况的文档化路径、说话功能需要什么,以及参考素材被拒时该检查什么。
TL;DR
- 真人的参考照片和视频片段受支持。 Seedance 2.5的参数参考明确说"参考图像/视频可能包含真人。"[1]
- 被拒参考素材全额退款。 素材在生成前经自动审查,任何被拒的内容都以错误失败,并全额退款预留金额。[2]
- 说话是单独的功能。 Seedance 2.5用
generate_audio生成"同步语音、音效和背景音乐",默认启用。[1] Kling 3.0明确记录唇形同步。[3] - 指名道姓的名人在所有路径上都被拒。 这是模型本身的决定,不是平台政策,没有参数能改变它。
- 同意仍然是你的责任。 接受上传的API没有代表你获得许可。
一个搜索词下的四种不同请求
你自己的素材,或一位同意的被拍摄者。 这是最大的合法案例:创始人在自己的产品演示中、UGC创作者、签署发布协议的演员、你正在制作品牌视频的客户。这是受支持的,本文的其余部分主要讲述这个。
参考素材被拒的合成人物。 单凭错误提示,无法判断审核系统如何识别图像,也无法确定是哪项内部检查作出的决定。应先核对文档中的输入要求和审核结果,再判断下一步。
指名道姓的公众人物。 被拒。不是reAPI作为政策的决定,而是模型本身,在任何转售它的主机上。任何声称相反的平台要么弄错了,要么在卖你一个肖像权问题。
说话的人。 这是能力问题而非权限问题,答案由你选择的模型决定,而非平台。
排查时要把这些情况分开。受支持的真人参考、被拒的合成参考,以及指定人物的请求,后续处理方式并不相同。
使用同意的人作为参考
支持的路径是参考素材,而非提示描述。Seedance 2.5在一次生成中接受最多30张参考图像、10个参考视频片段和10条音频轨道。[1]
curl https://reapi.ai/api/v1/videos/generations \
  -H "Authorization: Bearer rk_live_your_key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "doubao-seedance-2.5-face",
    "prompt": "@Image1 walks through a sunlit workshop, handheld follow",
    "resolution": "720p",
    "duration": 8,
    "image_urls": ["https://your-cdn.example.com/subject-01.jpg"]
}'组装参考集前需要了解的限制:[1]
| 字段 | 限制 | 格式 |
|---|---|---|
image_urls | 最多30张,各不超过30 MB | jpeg, png, webp, bmp, tiff, gif, heic, heif |
video_urls | 最多10个,各2–30秒,不超过200 MB,合计30秒 | mp4, mov, 480p to 4K |
audio_urls | 最多10个,各2–30秒,不超过15 MB | wav, mp3 |
两条规则让人吃惊。每个参考必须是公开HTTP(S)网址;base64和data:有效载荷在整个平台上被拒,不仅仅是这个模型。[1] 而且image_urls不能与image_with_roles组合,所以角色参考和首尾帧链接是分开的模式。[1]
参考素材会在生成前经过自动审核。如果被拒,任务会返回错误并全额退还预留金额,[2]因此失败尝试消耗的是时间,而不是这笔预留费用。
让他们说话
这里模型选择比平台选择更重要,两个文档化的选项行为不同。
Seedance 2.5本地生成音频。generate_audio默认为true,生成"同步语音、音效和背景音乐(单声道)。"[1] 语音与视频一起生成而非配音,所以口形和音频来自同一个处理过程。你通过提示词来指导它。
Kling 3.0更具体地记录该功能,将同步本地音频描述为"对白、唇形同步、环境音。"[3] 如果对白唇形同步精度是你被评判的标准,那是要测试的明确声明。
两者都不提供配音模式,即你提供成品语音轨道并获得精确的口型匹配。Seedance 2.5的audio_urls被文档化为参考音频轨道,[1]这是与唇形同步驱动不同的工作。如果你的流程已有录制的配音,在围绕它构建之前,先在短片段上测试这个假设。
对话头工作的实践注意:音频不会经历分割。每次生成都合成自己的轨道,所以从几个片段组装的序列给你多个独立的音频床。对于长于一次生成的对白,单独录制或合成语音,并仅将视频视为画面。
不会动的线
指名道姓的活人被拒。 每条诚实的路径都执行这一点,它与模型而非任何平台设置共存。如果主机声称相反,正确的回应是怀疑而非注册。
第三方角色也被拒。 同一检查捕获可识别的版权受保护角色,这对动漫和粉丝创作是反复的挫折,没有值得发布的解决办法。
同意不通过上传表单转移。 接受你参考照片的API不是照片中那个人的许可。发布协议、肖像权,以及在几个司法管辖区生物识别数据规则是你的责任,不会因为请求返回200而成为平台的。
最后一项不是法律套话。这是支持路径存在的原因:检查旨在阻止非同意情况,当合法情况有地方去时效果更好。
当合成角色参考素材被拒
拒绝提示本身无法证明问题来自素材内容、文件格式还是其他审核规则。不要根据一句提示猜测内部机制。先检查 URL、文件类型、大小、时长和字段组合是否符合公开参数文档。[1]
如果输入有效但自动审核仍然拒绝,应把它当作审核结果,而不是图像来源的证明。可以换一份合规参考素材,或选择输入政策更适合该任务的模型。面部检测排查指南会按文档区分输入校验与审核,不猜测内部系统。
费用是多少
参考驱动的工作在Seedance 2.5上的定价与任何其他生成相同,除了一个皱褶。参考图像和音频不改变费率;参考视频将你移至较低的每秒费率,按输入加输出秒计费。[2]
| 工作,720p | 费用 |
|---|---|
| 参考图像8秒 | $2.135 |
| 参考图像30秒 | $8.005 |
| 参考片段10秒到输出5秒 | $2.402 |
来自已发布每秒段的费率。[2] 失败的审核检查全额退款,所以探索性参考集让你花时间而非信用。
常见问题
我可以使用真人AI视频生成器吗?
可以,用同意被拍摄者的参考素材。Seedance 2.5的参数参考说参考图像和视频可能包含真人。[1]
我能生成名人吗?
不能。指名道姓的公众人物在所有路径的模型级被拒,没有参数改变这一点。
哪个模型处理说话的人?
Seedance 2.5用generate_audio生成与视频同步的语音。[1] Kling 3.0明确记录对白和唇形同步。[3]
我能提供自己的语音录音并获得对它的唇形同步吗?
不是文档化的模式。Seedance 2.5的audio_urls是参考轨道而非唇形同步驱动。[1] 在围绕它设计流程前在短片段上测试。
为什么我的AI生成角色被当真人拒了?
错误提示不会透露内部原因。先核对参考 URL、格式、大小和字段组合;如果都有效,就按审核拒绝处理。面部检测说明提供了基于文档的检查清单。
参考被拒时我会被收费吗?
reAPI上不会。失败审核的任务全额退款预留。[2]
我能直接上传参考文件吗?
不能。每个参考必须是公开HTTP(S)网址。Base64和data:有效载荷在平台范围内被拒。[1]
一次生成能采用多少参考图像?
最多30张,加10个视频片段和10条音频轨道。[1]
与脸一起工作而不是绕过它们
在选择工具前,先确定自己面对的是哪一种请求。已同意的被拍摄者和有效参考集属于有明确参数、审核失败可退款的支持流程。合成参考被拒时,应核对输入和审核结果,而不是猜测隐藏分类器。对白则仍是模型选择问题,现有文档给出了两种方案。
只有第四个请求,一个没同意的指名道姓的人,没有路径,这值得防卫而非绕过。真人AI视频生成器是当人们说是时的正常工具,支持路径保持开放的原因是不支持的路径保持关闭。
完整参数参考在reapi.ai/docs/seedance-2-5;Seedance 2.5模型页面的当前费率。
参考文献
- reAPI. doubao-seedance-2.5-face — request body, reference limits,
generate_audioand platform media rules. Retrieved August 2026 from reapi.ai/docs/seedance-2-5 - reAPI. Seedance 2.5 — model page, real-person reference support, published rates and refund behaviour. Retrieved 9 August 2026 from reapi.ai/models/seedance-2-5
- reAPI. Kling 3.0 — native audio with dialogue and lip sync. Retrieved August 2026 from reapi.ai/docs/kling-3-0
更多阅读
- reAPI. Seedance Face Detected: Real Person Errors, Explained. reapi.ai/blog/seedance-face-detected-real-person-error
- reAPI. AI Video Generator Long Videos: Chaining Past the Cap. reapi.ai/blog/ai-video-generator-long-videos
更多文章
Mammouth.ai 替代方案 2026:5 个工具对比
在找 Mammouth.ai 替代方案?看 Poe、Perplexity、OpenRouter、HuggingChat 和 reAPI 在 2026 年的模型阵容、功能范围和使用方式上到底差在哪。

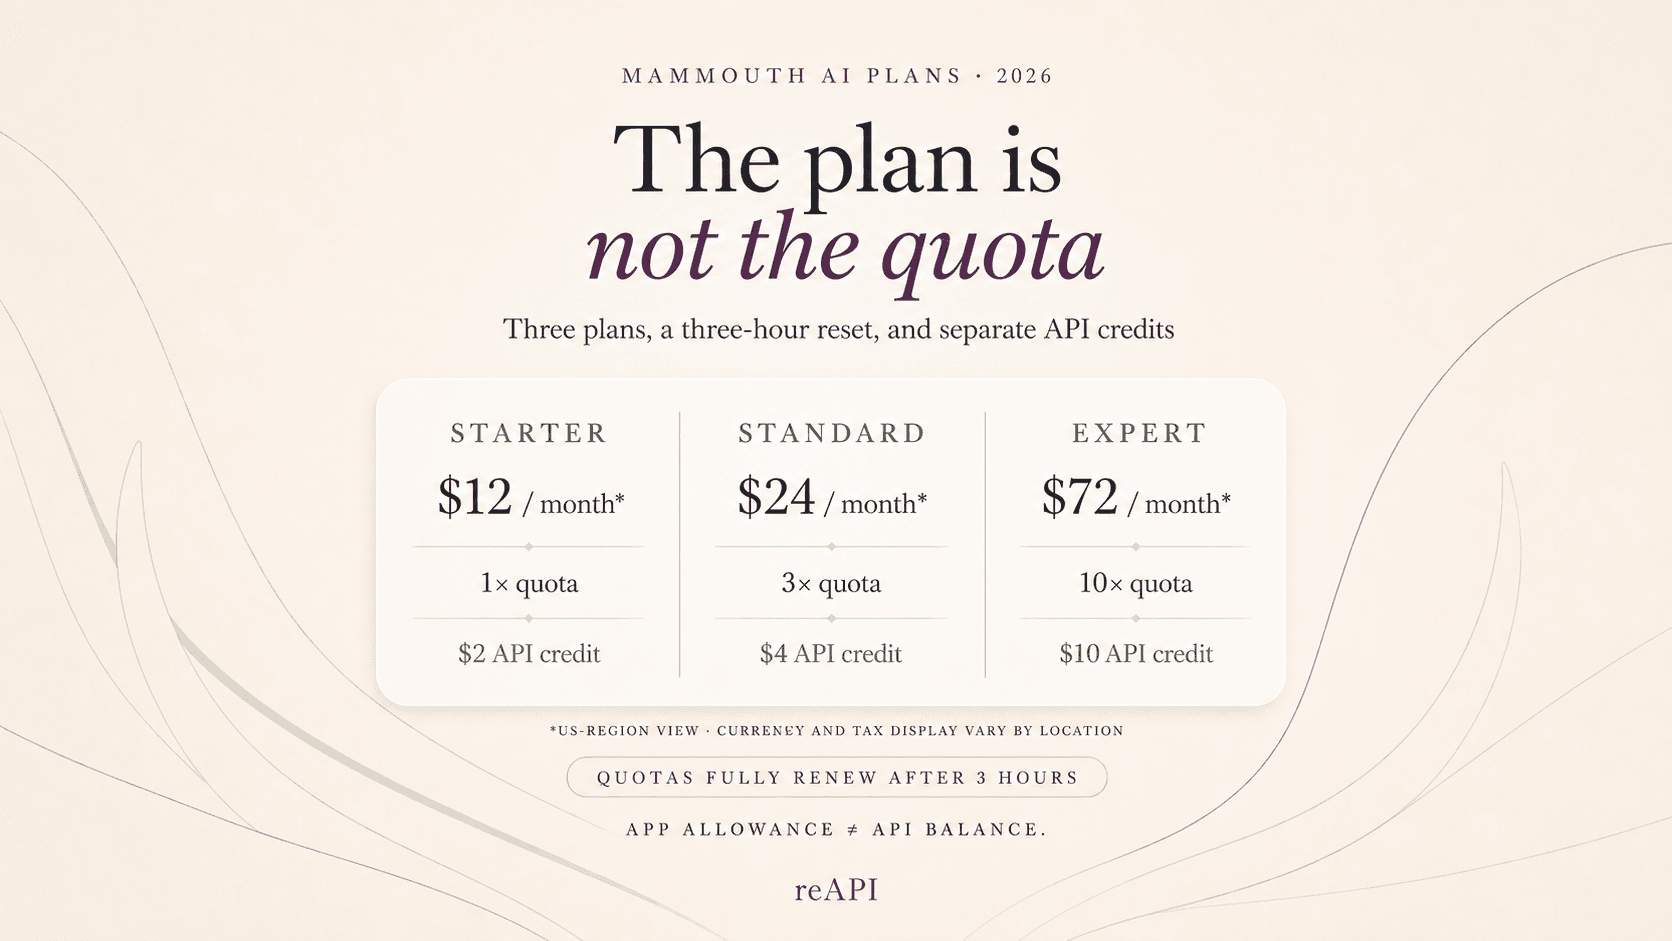
Mammouth AI 定价计划与额度限制详解
Mammouth AI 定价详解:三层订阅计划对比、三小时额度重置规则、包含的 API 积分、按量付费方式、文件上限和最佳使用场景。
Seedance 2.5 最佳替代方案对比
对比 Seedance 2.5 的最佳替代方案,包括 MiniMax H3、Seedance 2.0、Veo 3.1、Sora 2、Runway 和 Kling 3。