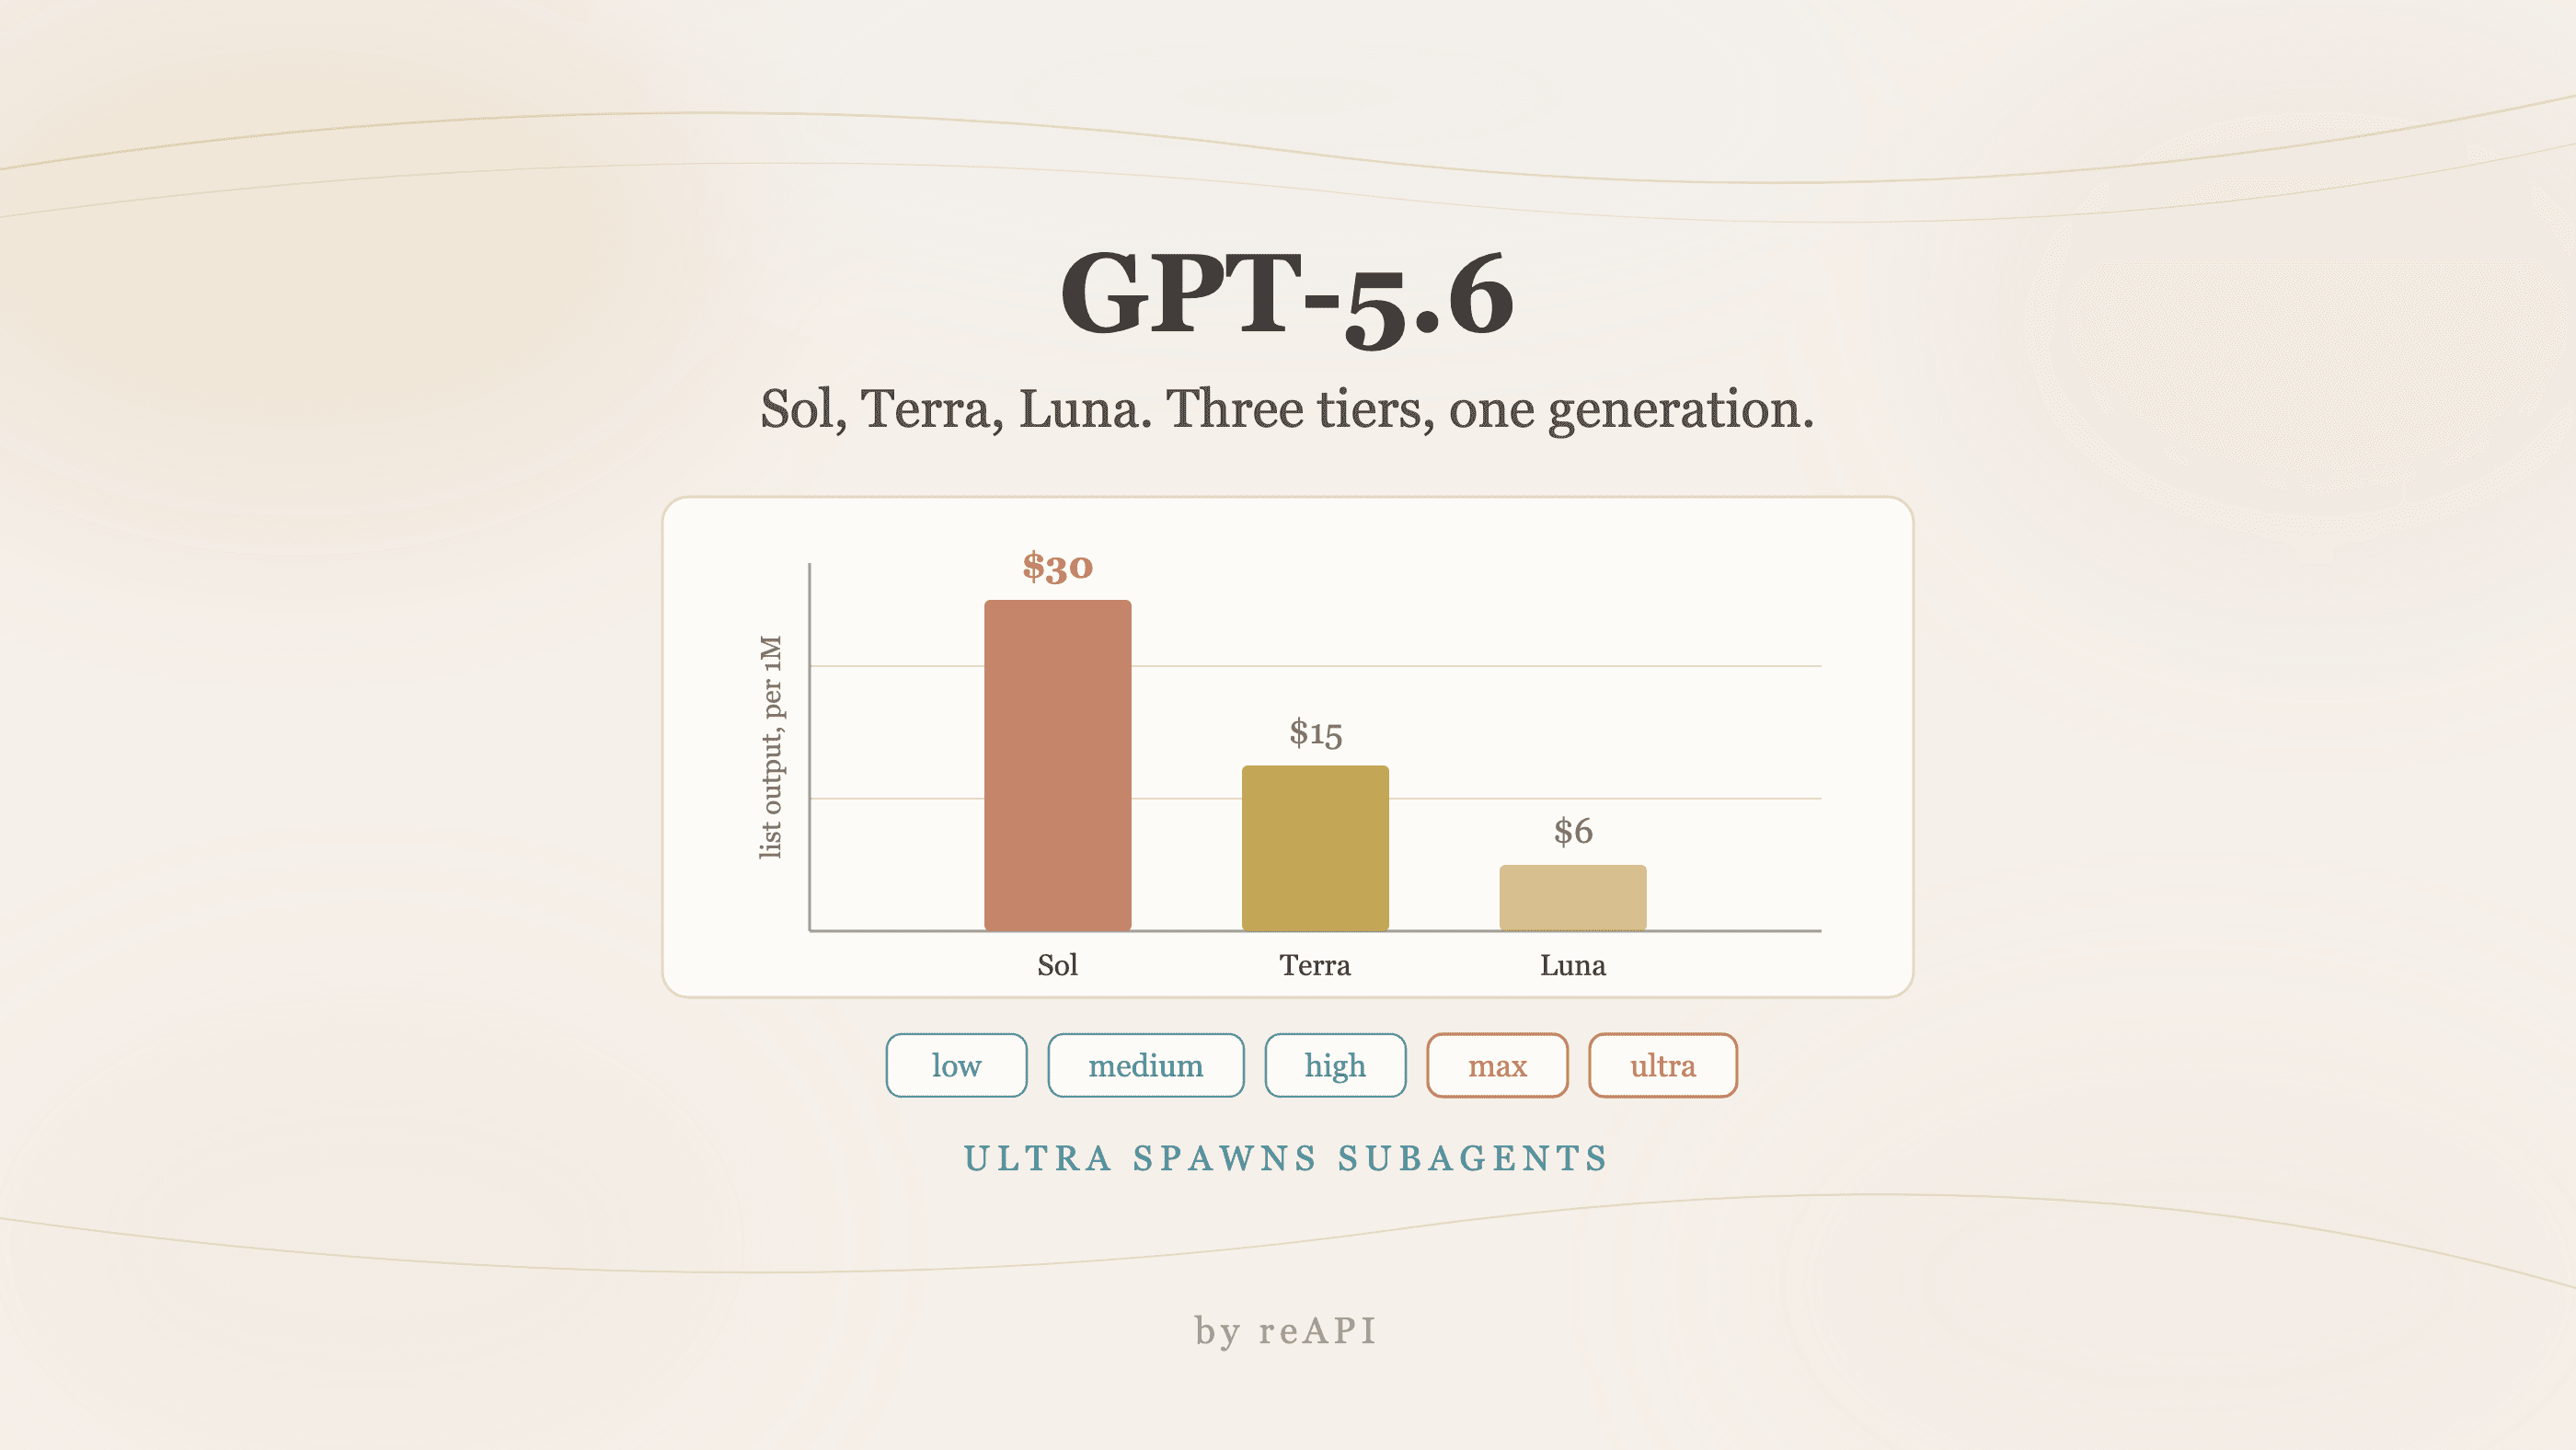
GPT-5.6 사용법: Sol, Terra, Luna 티어 비교
GPT-5.6 사용법: Sol, Terra, Luna 티어의 가격, Terminal-Bench 테이블의 네 개 별표 의미, max와 ultra 모드, 티어 선택 기준을 설명합니다.
GPT-5.6 Sol vs Terra vs Luna를 선택할 때는 자체 품질 검사를 통과하는 가장 저렴한 티어부터 시작하세요. 비용에 민감한 대용량 작업에는 Luna, Luna의 오류나 재시도 비용이 업그레이드를 정당화하면 Terra, 추가 능력에 지불할 가치가 있는 복잡한 전문 작업에는 Sol을 평가합니다. 현재 OpenAI Standard 입력/출력 요금은 입력 프롬프트 272K토큰 이하에서 100만 토큰당 Luna $0.20/$1.20, Terra $2/$12, Sol $4/$20입니다. 세 티어의 공식 컨텍스트 및 출력 한도는 같으므로 더 비싼 티어를 선택한다고 더 큰 창을 얻는 것은 아닙니다.[3][4][5]
아래 가격과 현재 API 한도는 2026년 10월 23일에 확인했습니다. 출시 및 Terminal-Bench 설명은 당시의 맥락으로 보존했습니다. 새로운 벤치마크 실행 결과도 아니고, 출시 평가의 모든 모드가 API 매개변수라는 약속도 아닙니다.
OpenAI는 2026년 6월 26일에 GPT-5.6의 제한된 프리뷰를 시작했고, 그 런칭의 가장 이상한 점은 거의 아무도 이를 사용할 수 없다는 것이었습니다. API와 Codex를 통해 검증된 약 20개 파트너에게만 접근 권한이 주어졌으며, OpenAI는 미국 정부가 요청한 단계적 출시라고 말했습니다[1].
그 게이트는 이후 열렸습니다. GPT-5.6을 사용하는 방법은 이제 대기 게임이 아닌 실질적인 질문이 되었으며, 답변은 주로 세 가지 티어 중 하나를 선택하는 것입니다: Sol 플래그십, Terra 균형잡힌 워크호스, Luna 예산 티어. 각각은 임시 변형이 아닌 하나의 세대 번호 아래의 지속적인 능력 티어입니다.
이 가이드는 현재의 세 티어 선택, 가격과 한도를 다루며, 출시 벤치마크의 네 가지 주의점, 당시 ultra 평가 설정, 출시를 형성한 사이버보안 검토도 함께 설명합니다.
TL;DR
- 동일한 한도를 가진 세 티어. Sol은 플래그십, Terra는 능력과 비용의 균형, Luna는 비용에 민감한 대용량 작업을 지향합니다. 세 티어 모두
max추론 노력을 지원합니다.[3][4][5] - 출시 당시 Terminal-Bench 2.1 표에서 Sol의 점수는 싱글 에이전트 88.8%,
ultra모드 91.9%입니다. Claude Mythos 5 대비 싱글 에이전트 우위는 0.8포인트이며 노이즈 범위 안입니다[1]. ultra는 하나의 에이전트가 아닙니다. 병렬로 서브에이전트를 조율하므로 그 점수는 싱글 에이전트 기준과의 같은 비교가 아닙니다[1].- 티어 이름보다 승인된 작업을 기준으로 선택하세요. 일상적인 대용량 작업은 Luna부터 테스트하고, 실패한 작업에서 Terra를 비교하며, 품질 향상이 추가 비용을 상쇄할 때 Sol을 사용하세요.
- reAPI의 짧은 컨텍스트 입력/출력 가격은 현재 OpenAI Standard 요금의 80%입니다: 100만 토큰당 Sol $3.20 / $16.00, Terra $1.60 / $9.60, Luna $0.16 / $0.96이며 2026년 10월 23일 확인했습니다. 이 비율이 모든 긴 컨텍스트 요금에 적용되는 것은 아닙니다.[8]
- 평가 윈도우는 의도적으로 좁았습니다. OpenAI는 코딩, 생물학, 사이버보안만 공개했으며 SWE-bench, GDPval, 수학, 할루시네이션 숫자는 보류했습니다[1].
gpt 5.6 sol vs terra vs luna
GPT-5.6은 2026년 4월의 완전히 재훈련된 에이전틱 모델인 GPT-5.5를 계승합니다. GPT-5.5가 추론 노력 수준을 가진 하나의 모델이었다면, GPT-5.6은 하나의 세대 번호 아래의 세 가지 티어 패밀리입니다. OpenAI의 표현은 명시적입니다: 숫자는 세대를 식별하는 반면, Sol, Terra, Luna는 자신의 속도로 발전할 수 있는 지속적인 능력 티어를 식별합니다[1].
그 문장은 출시에서 가장 중요한 설계 결정입니다. 이것은 "얼마나 똑똑한가"를 "얼마나 새로운가"와 분리합니다. 미래 세대는 Sol을 건드리지 않고 새로운 Luna를 출시할 수 있으며, Sol 업그레이드는 Terra의 모든 사람이 그들의 파이프라인을 다시 테스트하도록 강제하지 않습니다.
| 티어 | 위치 |
|---|---|
| GPT-5.6 Sol | 복잡한 전문 작업을 위한 플래그십. 어려운 작업에서 더 높은 요금을 정당화하는지 평가 |
| GPT-5.6 Terra | 능력과 비용의 균형. Luna가 작업 요건을 충족하지 못할 때 평가 |
| GPT-5.6 Luna | 빠르고 저렴함, 대용량 일상 작업을 목표 |
gpt 5.6 context window
OpenAI가 현재 문서화한 세 GPT-5.6 티어의 한도는 모두 같습니다. 전체 컨텍스트 창은 1,050,000토큰, 최대 입력은 922,000토큰, 최대 출력은 128,000토큰입니다. 입력 상한과 전체 컨텍스트 창은 다릅니다. 모두 텍스트와 이미지 입력을 받고 텍스트를 출력하며, 모델 페이지는 스트리밍, 구조화된 출력, 함수 호출을 지원한다고 안내합니다. 호스팅 도구 목록에는 Responses API용이라는 조건이 명시되어 있으므로, 모든 호환 엔드포인트가 같은 도구를 제공한다고 해석하면 안 됩니다.[3][4][5]
세 티어 모두 none, low, medium, high, xhigh, max를 지원하며 기본값은 medium입니다. 현재 모델 문서에는 minimal과 ultra가 노력 수준으로 나열되어 있지 않습니다. 추론 토큰은 컨텍스트 공간을 차지하고 출력으로 청구되므로, 출력 예산은 숨겨진 추론과 실제 답변을 모두 포함해야 합니다.[6]
Terminal-Bench 2.1과 그것의 네 개 별표
OpenAI는 프리뷰에서 코딩, 생물학, 사이버보안 세 가지 벤치마크 영역만 공개했으며, 일반 가용성을 위해 나머지를 명시적으로 보류했습니다[1]. 기억하길 원하는 것은 Terminal-Bench 2.1입니다. 이는 계획, 반복, 도구 조율이 필요한 커맨드라인 에이전틱 워크플로우를 테스트합니다.
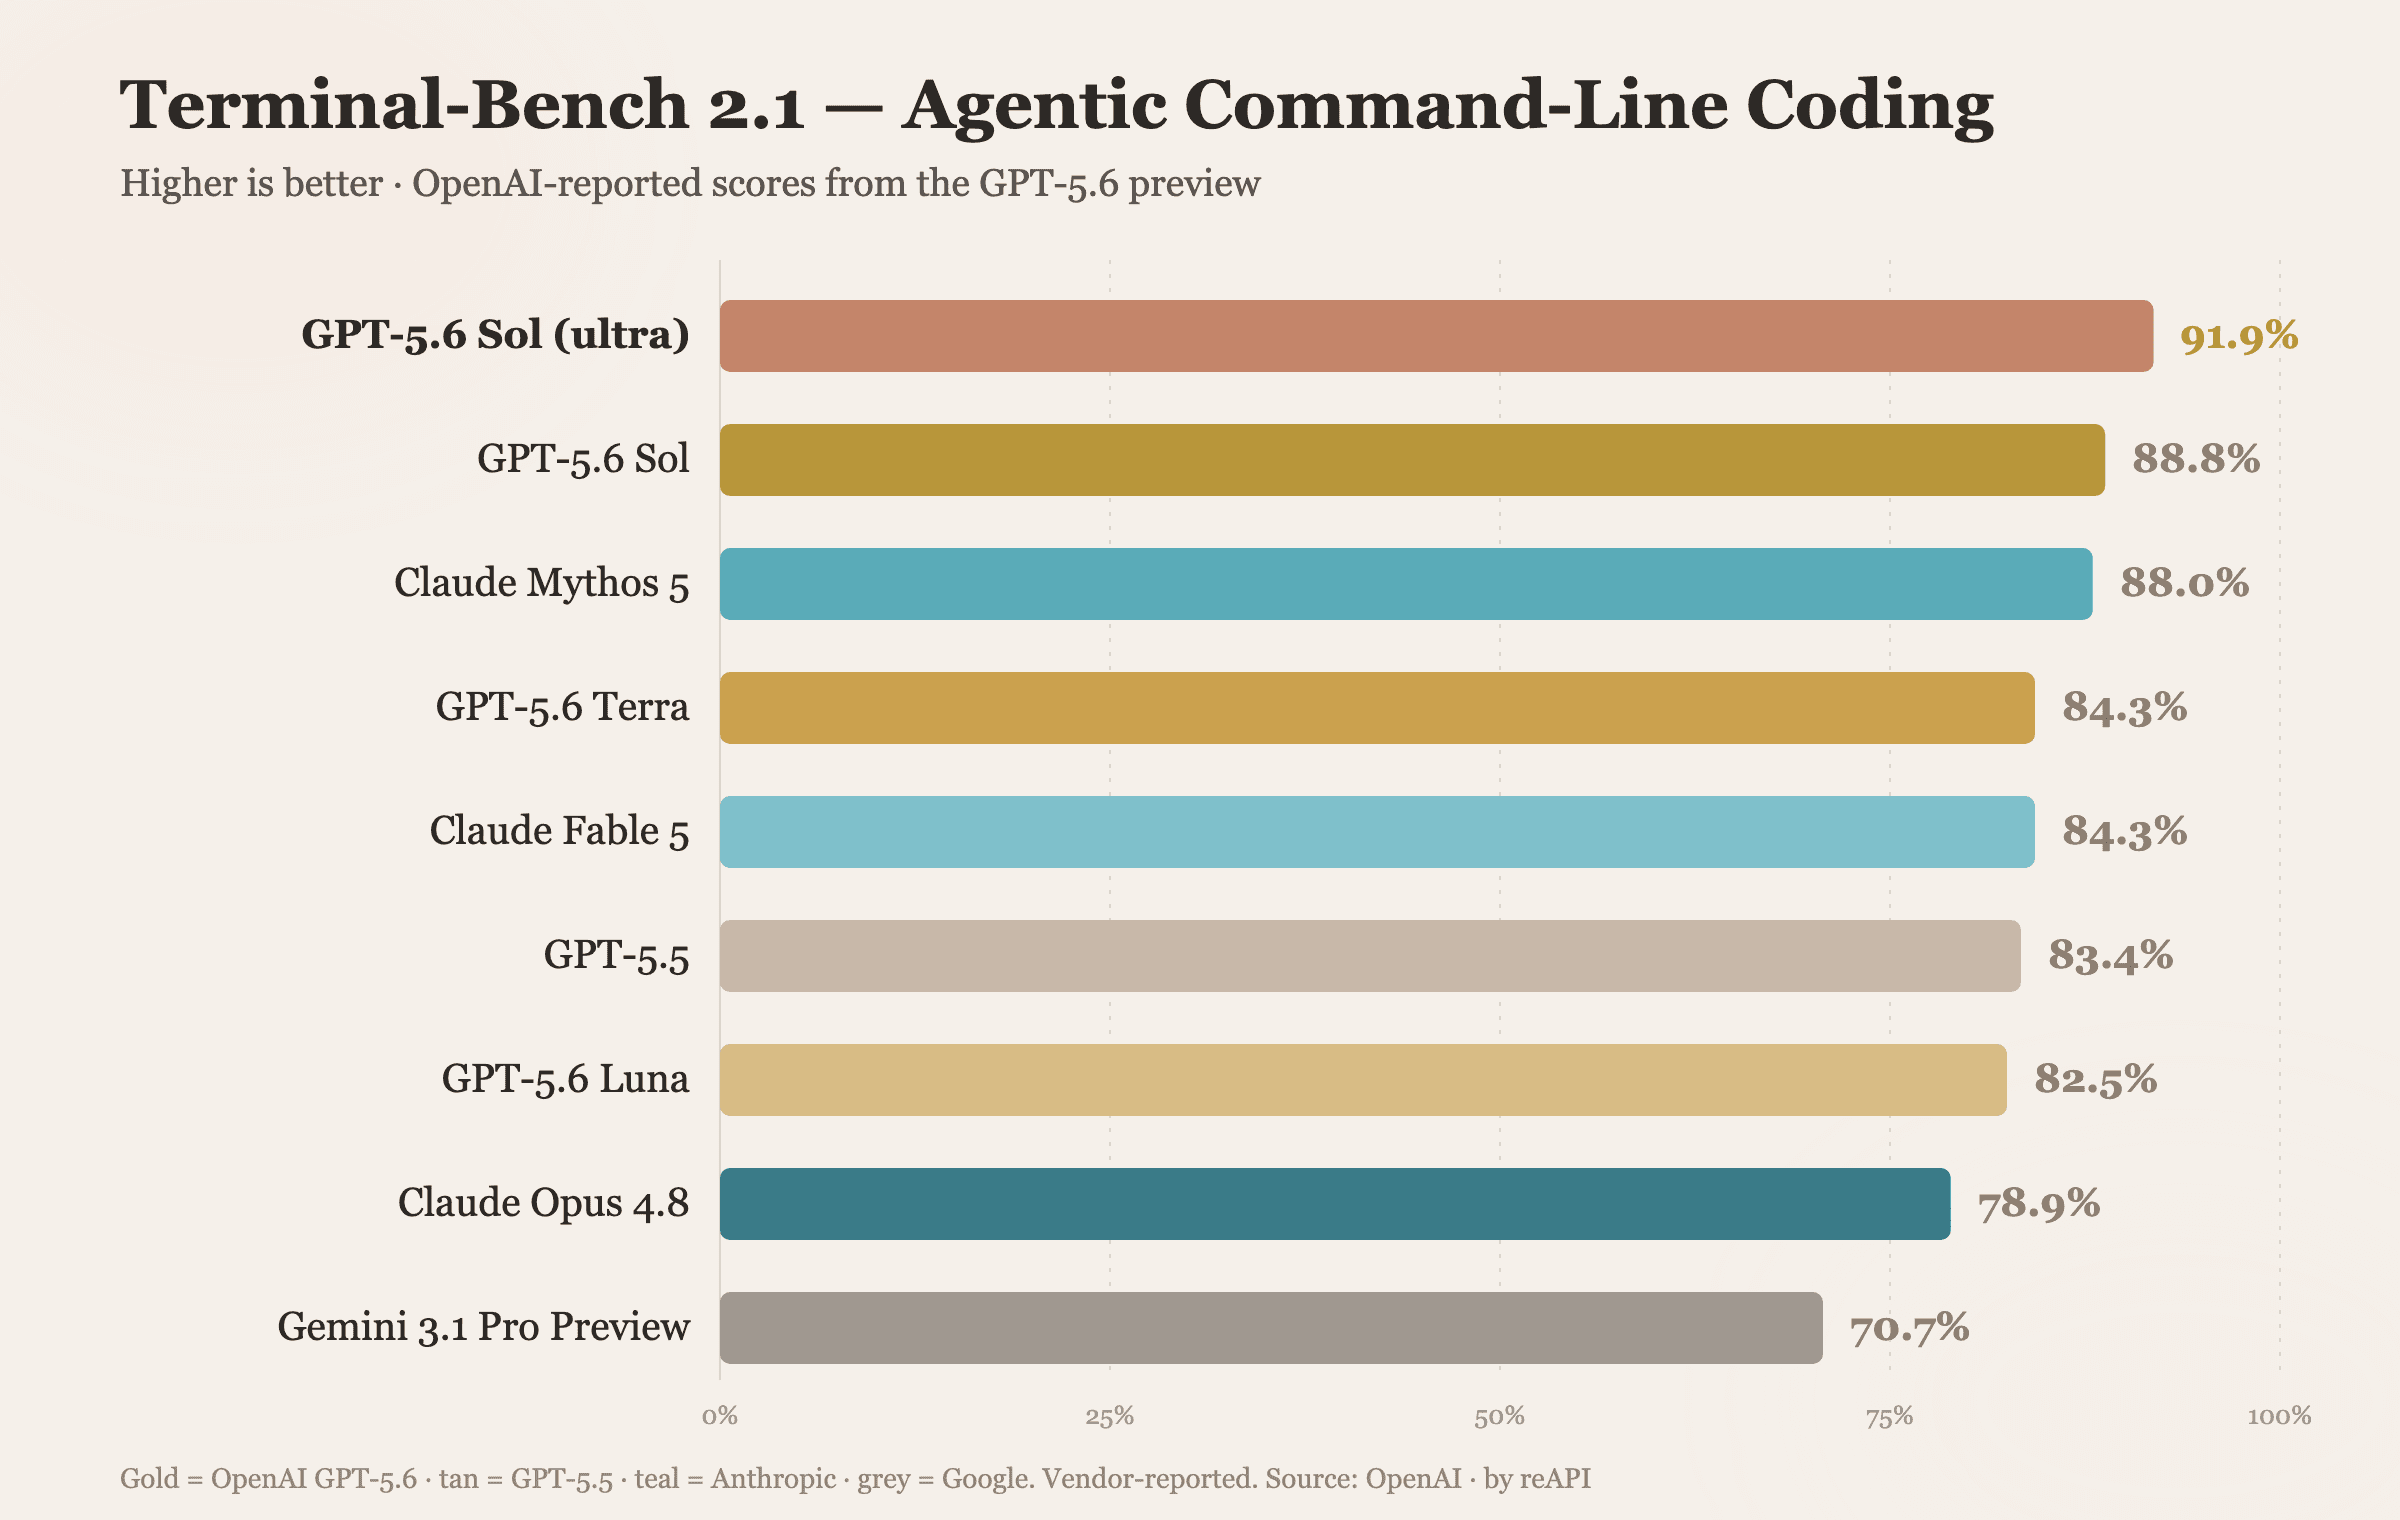
| 모델 | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (ultra 모드) | 91.9% |
| GPT-5.6 Sol | 88.8% |
| Claude Mythos 5 | 88.0% |
| GPT-5.6 Terra | 84.3% |
| Claude Fable 5 | 84.3% |
| GPT-5.5 | 83.4% |
| GPT-5.6 Luna | 82.5% |
| Claude Opus 4.8 | 78.9% |
| Gemini 3.1 Pro Preview | 70.7% |
신중히 읽으세요. 이 테이블은 "새로운 최첨단" 헤드라인이 시사하는 것보다 네 가지 방식으로 더 정직합니다[1].
91.9% 기록은 ultra를 사용하며, 이는 싱글 에이전트가 아닙니다. 이는 Sol이 서브에이전트를 조율하는 것에서 나옵니다. 싱글 에이전트 기준에 대해서는 사과 대 사과 비교가 아닙니다. 공정한 비교는 Sol의 88.8%입니다.
싱글 에이전트 Sol은 Claude Mythos 5를 0.8 포인트로 이깁니다. 같은 모델의 두 번 실행은 그 이상으로 다를 수 있습니다. OpenAI는 코딩 곡선의 상단에서 실제 우위를 가지고 있지만, 이 벤치마크에서는 좁으며 압도적이지 않습니다.
Terra는 Claude Fable 5와 동등하며 GPT-5.5보다 거의 우위가 없습니다. 84.3%는 Fable 5와 정확히 일치하며 그것이 대체하는 모델보다 1포인트 미만입니다. 가격 인하와 함께 읽어야 할 상업적 의미는 더 낮은 출시 가격에서 보고된 Terminal-Bench 결과가 비슷했다는 것입니다. 모든 작업에서 코딩 능력이 같다는 증거는 아닙니다.
Gemini 3.1 Pro Preview는 약 21포인트 뒤떨어집니다. 그 간격은 실제이지만 벤치마크 특정적입니다. Gemini는 여기에 표시되지 않은 긴 컨텍스트 검색 및 멀티모달 작업에서 우위가 있습니다.
생물학에서 OpenAI는 Sol이 GPT-5.5보다 더 강한 GeneBench v1 결과를 달성한다고 보고하지만 원시 숫자를 공개하지 않으므로, 그것은 검증 가능한 점수보다는 방향성 주장입니다[1].
max와 ultra
출시 비교에는 max와 ultra 멀티 에이전트 평가 설정이 사용되었습니다. 현재 API를 통합할 때는 당시의 명칭과 문서화된 매개변수 규약을 분리해야 합니다. max는 Sol, Terra, Luna 모두 지원하며, ultra는 현재 여섯 추론 노력 값에 포함되지 않습니다.[3][4][5]
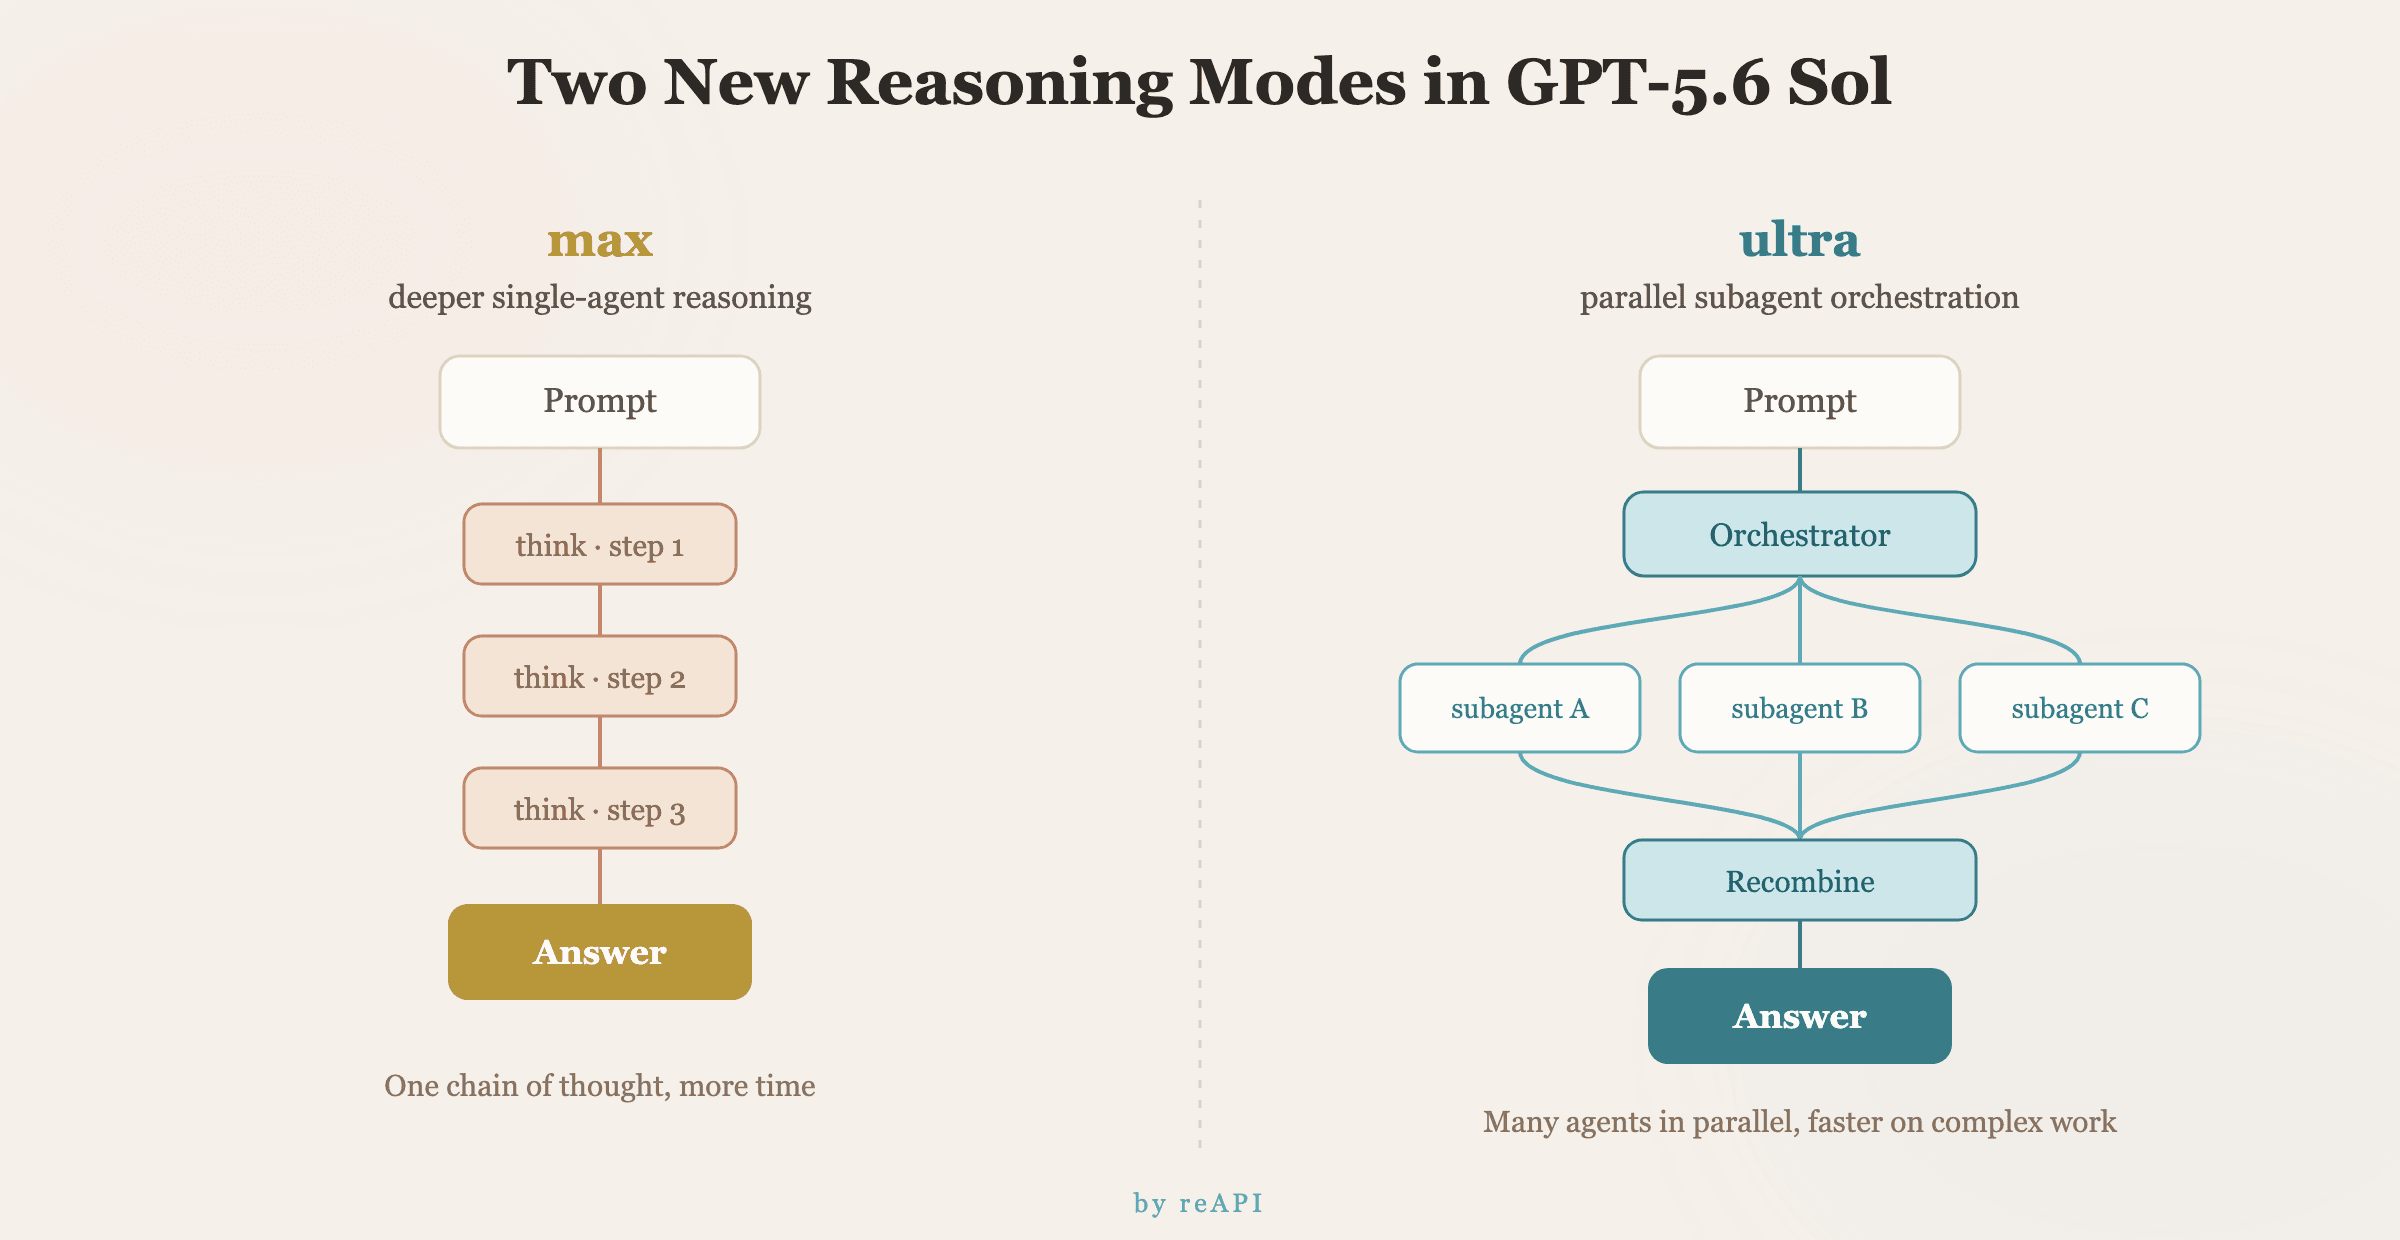
이 그림은 출시 당시 비교를 설명합니다. ultra 점수는 서브에이전트를 사용하므로 싱글 에이전트와 동일 조건의 결과가 아닙니다. 호출 가능한 ultra 매개변수나 reAPI에 내장된 조율 기능을 입증하지도 않습니다.
OpenAI의 현재 Responses API는 추론 노력과 추론 모드를 별도 제어로 문서화합니다. reasoning.mode는 standard 또는 pro를 선택합니다. Pro 모드는 모델이 더 많은 작업을 수행하고 그 토큰을 해당 모델의 표준 토큰 요율로 청구합니다. 따라서 토큰당 요금이 같아도 총비용은 더 높아질 수 있습니다. GPT-5.6에서 두 모드 모두 노력의 기본값은 medium입니다.[6]
reAPI에서 이 모델들의 공개 경로는 Chat Completions이며 reasoning_effort를 사용합니다. OpenAI의 Responses 전용 모드, 추론 유지, 호스팅 에이전트 기능이 해당 요청에 필드를 복사하는 것만으로 활성화된다고 가정하지 마세요.
gpt 5.6 pricing
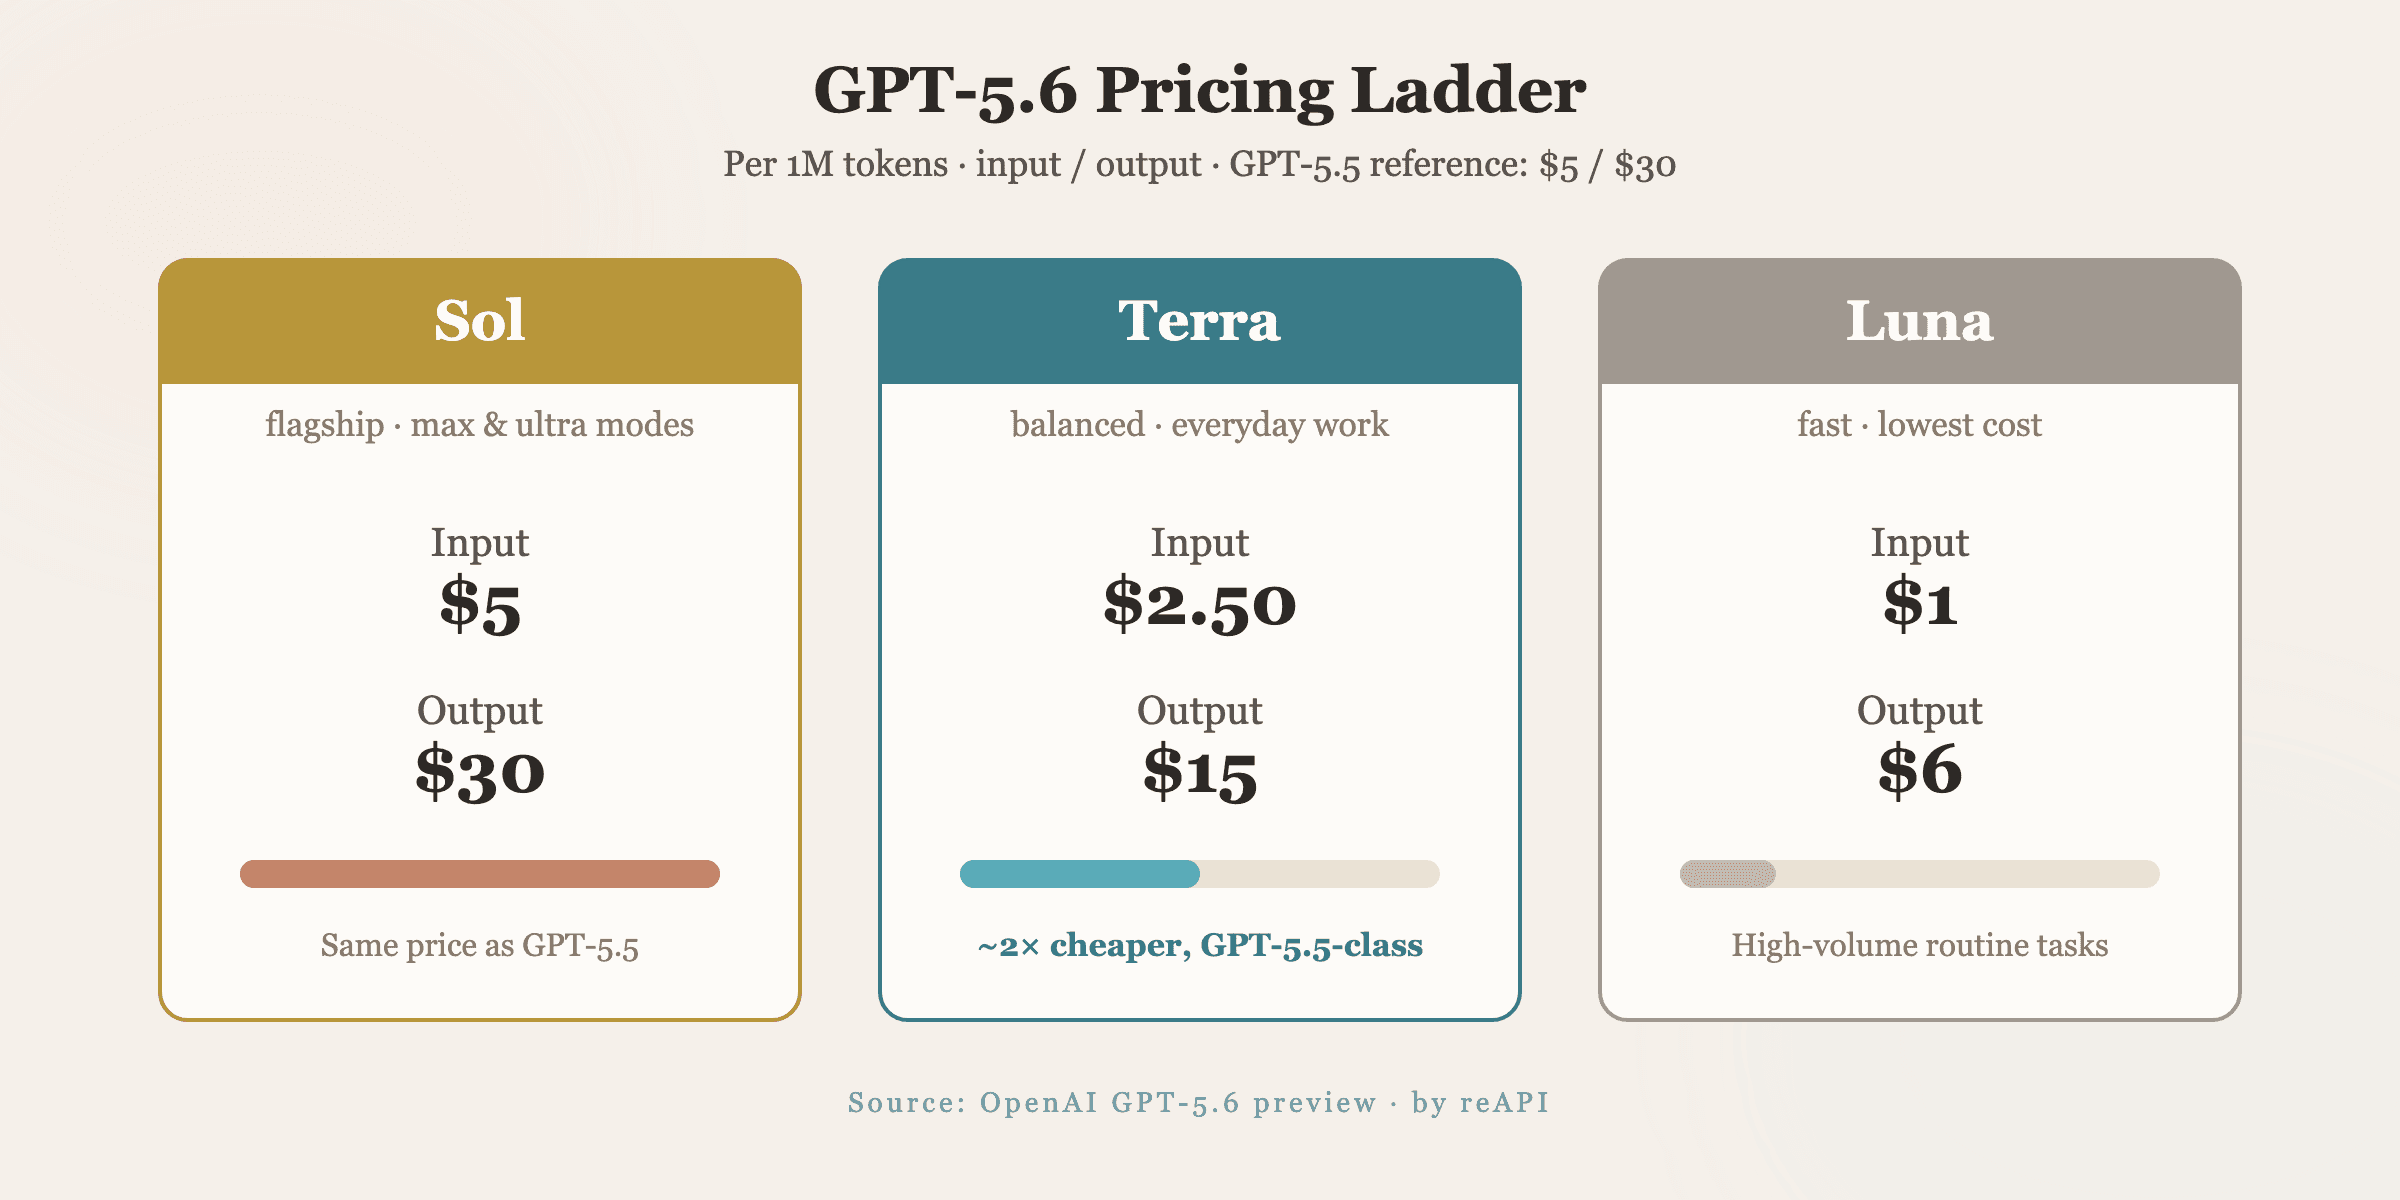
이미지는 출시 당시 가격을 보존합니다. 아래 현재 가격 열은 짧은 컨텍스트의 100만 토큰당 입력/출력 가격이며, 모든 프롬프트 크기나 처리 모드에 공통으로 적용되는 요금은 아닙니다.[2][8]
| 티어 | OpenAI 런칭 시 리스트 (백만당 입력/출력) | OpenAI Standard, 2026년 10월 23일 | reAPI, 2026년 10월 23일 |
|---|---|---|---|
| GPT-5.6 Sol | $5 / $30 | $4 / $20 | $3.20 / $16.00 |
| GPT-5.6 Terra | $2.50 / $15 | $2 / $12 | $1.60 / $9.60 |
| GPT-5.6 Luna | $1 / $6 | $0.20 / $1.20 | $0.16 / $0.96 |
OpenAI의 런칭 시 숫자에서 두 가지가 눈에 띴습니다. Sol은 GPT-5.5의 정확한 $5 / $30 가격을 유지하면서 능력과 새로운 모드를 추가하는데, 이는 같은 금액에 대해 더 많은 것을 얻는 드문 경우였습니다. 그리고 Terra는 더 낮은 출시 가격에서 GPT-5.5와 비슷한 출시 Terminal-Bench 결과를 보고하여 평가할 가치를 보여 주었습니다[1]. Sol의 토큰 효율 향상을 상단에 겹겹이 놓으세요. 이는 비교 가능한 결과에 더 적은 출력 토큰으로 도달하므로, 작업당 비용의 실제 하락은 헤드라인 요율이 암시하는 것보다 큽니다.
OpenAI는 이후 세 공시 요금을 모두 인하했습니다. Sol의 가격은 적어도 2026년 11월 21일까지 유지한다고 밝힌 프로모션입니다[2]. Sol은 이제 GPT-5.5의 $5 / $30과 같은 가격이 아니라 더 낮은 가격입니다. 현재 reAPI의 짧은 컨텍스트 입력/출력 요금은 OpenAI Standard의 80%이지만, 티어 사이의 상대 가격은 바뀌었습니다. Luna의 $0.20/$1.20는 Terra의 $2/$12의 10분의 1이며, 출시 가격에서는 이 비율이 아니었습니다. Sol의 11월 날짜는 프로모션의 최소 기간이지 다음 날 가격이 반드시 오른다는 뜻이 아닙니다. Terra를 자동 기본값으로 삼기보다 측정한 품질 요건을 충족하는 가장 저렴한 티어를 선택하세요.
입력 272K토큰을 초과하면 OpenAI는 초과분만이 아니라 전체 요청에 입력 2배, 출력 1.5배 요금을 적용합니다. 현재 Standard의 캐시 및 긴 컨텍스트 요금은 다음과 같습니다.[2]
| 티어 | 짧은 컨텍스트 캐시 읽기 / 30m 쓰기 / 12h 쓰기 | 긴 컨텍스트 입력 / 출력 | 긴 컨텍스트 캐시 읽기 / 30m 쓰기 / 12h 쓰기 |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI는 암시적 캐싱과 명시적 캐싱을 지원합니다. 기본 30분 쓰기는 일반 입력의 1.25배이며, Responses API에서는 최소 12시간 보존을 2.5배 요금으로 선택할 수 있습니다. 이는 일반 입력에 더하는 추가 요금이 아니라 전체 쓰기 요금입니다. 이 세 모델의 읽기 요금은 0.1배입니다. 캐시 가능한 접두부의 최소 길이는 1,024토큰입니다. 12시간 설정은 최소 수명이지 삭제 기한이 아닙니다.[7]
예시로 캐시되지 않은 입력 20,000토큰과 청구 대상 출력 5,000토큰의 OpenAI Standard 비용은 (20,000 × input rate + 5,000 × output rate) / 1,000,000으로 계산하여 Sol $0.18, Terra $0.10, Luna $0.01입니다. reAPI의 짧은 컨텍스트 입력/출력 요금을 적용하면 각각 $0.144, $0.08, $0.008입니다. 고정한 출력 수에는 추론이 포함되며, 도구, 세금, 캐시 작업은 제외합니다. 이는 계산 예시이지 실제 작업 완료 비용의 측정 결과가 아닙니다.
캐시되지 않은 입력 300,000토큰과 청구 대상 출력 5,000토큰에서는 OpenAI의 전체 요청 긴 컨텍스트 요금에 따라 Sol $2.55, Terra $1.29, Luna $0.129가 됩니다. 더 낮은 짧은 컨텍스트 요금은 더 이상 적용되지 않습니다. 캐시를 쓰는 요청에서는 일반 입력, 캐시 읽기, 캐시 쓰기를 구분한 뒤 각각의 요금을 곱하세요. 캐시 토큰을 일반 입력으로 다시 계산하면 청구액을 과대 추정하게 됩니다.
10월 23일 reAPI에 렌더링된 긴 컨텍스트 입력/출력 요금은 100만 토큰당 Sol $6.40/$24.00, Terra $3.20/$14.50, Luna $0.320/$1.440였습니다. Terra의 긴 출력 표시 요금은 $14.50이므로, 모든 요금이 “80%”라는 주장은 정확하지 않습니다. 모델 페이지에서 정확한 항목을 확인하세요. 이 표는 reAPI에서 OpenAI의 캐시 수명 선택 기능을 사용할 수 있다는 약속이 아닙니다.[8]
위 OpenAI 수치는 Standard 처리를 기준으로 하며, 별도 요금이 있는 도구와 지역 처리 할증은 제외했습니다. Batch, Flex, Fast 모드는 각각 별도 가격표가 있습니다. 서비스 조건이 같은 것처럼 한 모델의 다른 처리 모드와 다른 모델의 Standard 요금을 비교하면 안 됩니다.[2]
출시를 형성한 검토
이 부분은 이제 접근 권한이 열려있어도 이해할 가치가 있는데, 각주가 아닌 선례이기 때문입니다.
OpenAI는 미국 정부의 요청에 따라 약 20개의 검증된 파트너로 초기 출시를 제한했으며, 사이버보안 프레임워크가 개발되는 동안 출시 전에 모델의 능력을 미리 보았습니다[1]. 트리거는 사이버보안 능력이었습니다. Sol은 취약점 연구를 의미있게 발전시키며, Chromium과 Firefox를 포함한 평가에서 테스트된 조건에서 자율적으로 기능하는 전체 체인 익스플로잇을 생성하지 않고 버그와 익스플로잇 프리미티브인 익스플로잇 빌딩 블록을 식별했습니다. OpenAI는 Sol이 자신의 준비 프레임워크에서 사이버 중대 임계값을 넘지 않는다고 명시하며, 그 구별은 출시의 전체 기초입니다[1].
주목할 점은 OpenAI가 그 배치를 영구적이라고 지지하지 않았으며, 이런 종류의 정부 접근 프로세스는 방어자가 필요로 하는 최고의 도구를 유지하기 때문에 장기 기본값이 되어서는 안 된다고 말했습니다[1].
그것과 함께 배치된 안전 스택은 알 가치가 있는데, 고능력 모델이 일반적으로 어떻게 배치될 것인지를 미리 보기 때문입니다: 훈련된 거부, 생성을 더 큰 모델에 의한 검토를 위해 일시 중지할 수 있는 실시간 사이버 및 생물학 분류자, 플래그된 활동의 계정 수준 검토, 그리고 가장 민감한 능력에 대한 차별화된 접근. OpenAI는 보편적 탈옥을 위한 자동화된 적대 팀핑에 700,000 A100 상당 GPU 시간을 전담했습니다[1].
OpenAI는 이러한 보호가 오작동한다는 것을 명시하고 있습니다: 정당한 보안 연구자는 이중 용도 요청에서 거부를 hit할 수 있습니다.
경우가 강한 곳과 약한 곳
강한. 에이전틱 커맨드라인 코딩으로, 여기서 싱글 에이전트 Sol이 벤치마크를 탑하고 ultra가 그것을 확장합니다. 토큰 효율로, 대용량 에이전트에 대해 복합. 중간 티어 가치로, Terra의 가격 인하가 출시에서 가장 광범위하게 유용한 변화. 출시 당시 ultra 결과에는 멀티 에이전트 조율이 포함되므로 현재 reAPI 기능의 약속이 아니라 평가 설정으로 해석해야 합니다[1].
약한. 헤드라인은 하나의 벤치마크에서 0.8포인트 우위입니다. 평가 윈도우는 의도적으로 작았으며, SWE-bench, GDPval, 수학, 또는 할루시네이션 숫자가 공개되지 않아 GPT-5.6이 GPT-5.5를 괴롭혔던 자신감 있는 할루시네이션 문제를 해결했는지 여전히 알 수 없습니다. 그리고 모든 것은 OpenAI의 자신의 하네스 아래 벤더 보도입니다[1].
확장된 스위트와 독립적인 채점이 올 때까지, 일반 능력에 대한 판단은 예약된 상태로 유지되어야 합니다.
GPT-5.6 사용법: 어느 티어를 선택할지
검사를 통과하는 비용 민감형 일상 대용량 작업에는 Luna. 대표적인 분류, 추출, 짧은 답변 작업으로 시작하여 승인된 출력, 재시도, 검토 노력을 기록하세요. 낮은 토큰 가격은 출력이 작업 요건을 충족할 때만 유용합니다.
추가 능력이 가격을 정당화할 만큼 결과를 개선하면 Terra. 모든 프로덕션 요청에 중간 티어가 필요하다고 가정하기보다 Luna가 실제로 실패한 사례에서 비교하세요. 출시 코딩 벤치마크는 해당 평가의 근거이며, 모든 작업에서 같은 능력이라는 증거는 아닙니다.
개선 효과가 추가 비용을 상쇄하는 복잡한 전문 작업에는 Sol. 동일한 도구와 승인 기준으로 어려운 코딩이나 장시간 작업을 테스트하세요. 세 티어 모두 max를 지원하며, 높은 노력 설정이나 더 큰 컨텍스트 창이 Sol에만 있는 것은 아닙니다. ultra가 지원되는 요청 값이라고 가정하여 reAPI 티어를 선택하지 마세요.
reAPI에서 GPT-5.6 호출
세 티어 모두 reAPI의 OpenAI 호환 https://reapi.ai/api/v1/chat/completions 엔드포인트에 등록되어 있습니다. 현재 reAPI 작업 공간의 키를 사용하고 OpenAI의 점을 유지한 정확한 티어 접미사 포함 wire ID를 지정하세요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)gpt-5.6-terra를 gpt-5.6-sol 또는 gpt-5.6-luna로 바꾸면 같은 Chat Completions 형식으로 티어를 비교할 수 있습니다. OpenAI는 접미사 없는 gpt-5.6 별칭을 문서화하지만, 현재 reAPI 등록에는 티어 접미사가 있는 세 ID를 사용하므로 여기서는 그 정확한 문자열을 사용하세요. reAPI에 설정된 출력 상한은 각 모델 128,000토큰이며, 문서화된 노력 값은 none, low, medium, high, xhigh, max입니다.[8]
OpenAI는 이 모델군에서 Chat Completions와 Responses를 모두 지원하며, 추론 워크플로에는 Responses를 권장합니다. reAPI는 /v1/responses 경로를 공개하지 않습니다. 매개변수 전달이 기능의 동등성을 입증하지는 않습니다. OpenAI의 호스팅 도구 모음, Pro 추론 모드, 추론 유지 규약이 이 Chat 엔드포인트에 그대로 구현되어 있다고 가정하면 안 됩니다. 연결된 reAPI 엔드포인트 문서는 해당 통합을 설명하며, 이 글의 업데이트를 위해 프로덕션 생성을 수행하지 않았습니다.[6][8]
현재 요율은 reapi.ai/models/gpt-5-6-sol, reapi.ai/models/gpt-5-6-terra, 그리고 reapi.ai/models/gpt-5-6-luna에 있습니다.
FAQ
max와 ultra 모드의 차이는 무엇인가요?
max는 현재 세 GPT-5.6 티어 모두에서 사용할 수 있는 추론 노력 값입니다. 과거 ultra 벤치마크 결과는 서브에이전트를 사용하여 Terminal-Bench 91.9%라는 수치를 냈으며, 현재의 여섯 노력 값에는 포함되지 않습니다. OpenAI의 별도 reasoning.mode: "pro"는 Responses에 해당하며, ultra 필드나 reAPI Chat 기능과 혼동하면 안 됩니다.[1][3][6]
GPT-5.6 Sol이 코딩에서 Claude보다 나은가요?
Terminal-Bench 2.1에서, 싱글 에이전트 Sol 88.8%는 Claude Mythos 5 88.0%를 0.8 포인트로 누릅니다. 실제이지만 좁은 우위입니다. ultra로 Sol은 91.9%에 도달하지만 서브에이전트를 사용하며 싱글 에이전트 비교가 아닙니다[1].
어느 GPT-5.6 티어를 사용해야 하나요?
일상적인 대용량에는 Luna, Luna가 요건을 충족하지 못하면 Terra, 추가 품질이 비용을 정당화하는 어려운 작업에는 Sol을 평가하세요. 세 티어는 문서화된 컨텍스트 창, 출력 상한, 노력 단계가 같습니다. 가정한 ultra 통합이 아니라 승인된 작업당 비용과 자체 테스트로 선택하세요.
미국 정부가 출시에 관여한 이유는 무엇인가요?
Sol은 사이버보안 능력을 의미있게 발전시키며, 정부의 요청으로 OpenAI는 사이버 프레임워크가 개발되는 동안 약 20개의 검증된 파트너에게 단계적 프리뷰를 실행했습니다[1].
GPT-5.6이 GPT-5.5의 할루시네이션 문제를 해결했나요?
알 수 없습니다. OpenAI는 프리뷰에서 코딩, 생물학, 사이버보안 평가만 공개했으며 할루시네이션과 지식 작업 숫자는 보류했습니다[1]. 고위험 출력에 대해 소스 기반 검증과 모델을 짝하세요.
GPT-5.6 Sol의 컨텍스트 윈도우는 얼마나 큰가요?
OpenAI는 현재 전체 컨텍스트 창 1,050,000토큰, 최대 입력 922,000토큰, 최대 출력 128,000토큰을 문서화합니다. Terra와 Luna의 한도도 같습니다. 과거 150만 토큰 보도는 현재의 공식 사양이 아닙니다.[3][4][5]
프롬프트 캐싱에서 무엇이 변했나요?
OpenAI는 암시적 캐싱과 명시적 캐시 중단점을 지원합니다. 기본 30분 쓰기는 일반 입력의 1.25배이며, Responses API에서 선택 가능한 최소 12시간은 2.5배입니다. 이 세 모델의 읽기 요금은 0.1배입니다. 쓰기 요금은 전체 금액이며 최소 수명은 삭제 기한이 아닙니다. reAPI의 Chat 경로가 동일한 캐시 설정 제어를 제공한다는 뜻도 아닙니다.[7]
OpenAI SDK로 GPT-5.6을 호출하려면 어떻게 하나요?
OpenAI 클라이언트의 주소를 https://reapi.ai/api/v1로 설정하고 reAPI 작업 공간 키를 사용한 뒤 model을 gpt-5.6-sol, gpt-5.6-terra, gpt-5.6-luna 중 하나로 지정하세요. 점과 티어 접미사를 유지해야 합니다. OpenAI의 접미사 없는 별칭은 여기에 등록되어 있지 않습니다.[8]
세 티어 출시 읽기
GPT-5.6은 하나의 공지를 입은 두 출시입니다. 하나는 평범하고 잘 실행된 패밀리 업데이트입니다. 합리적인 이름 재설정, 더 낮은 출시 가격과 GPT-5.5에 근접한 보고 Terminal-Bench 결과를 가진 중간 티어, 멀티 에이전트 조율을 사용한 출시 ultra 벤치마크가 있습니다. 다른 것은 초기 가용성이 정부와 조율되어 설정된 프론티어 모델이며, 700,000 GPU 시간 안전 스택 뒤에 배치되었습니다.
현재 통합에서는 검사를 통과하는 가장 저렴한 티어로 시작하고, 추론과 긴 컨텍스트 요금 기준을 예산에 반영하며, 워크플로에 필요한 API 기능을 확인하세요. 출시 벤치마크는 유용한 역사적 근거이지만, 실제 요청과 예산을 결정하는 기준은 현재 모델 문서와 가격 조건입니다.
세대 간 비교는 GPT-6 Sol vs Luna와 GPT-6 Luna vs GPT-5.6 Luna를 읽어 보세요. 해당 글은 GPT-6 마이그레이션을 다루며, 이 가이드는 세 GPT-5.6 티어 사이의 선택을 별도로 다룹니다.
참고 자료
-
OpenAI. Models — the GPT-5.6 family, reasoning modes, and specifications. Retrieved July 2026 from platform.openai.com/docs/models
-
OpenAI. Pricing — per-token rates by model and tier. Retrieved July 2026 and re-checked October 23, 2026. https://developers.openai.com/api/docs/pricing
-
OpenAI. GPT-5.6 Sol model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI. GPT-5.6 Terra model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI. GPT-5.6 Luna model reference. Checked October 23, 2026. https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI. Reasoning models: effort, mode and token accounting. Checked October 23, 2026. https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI. Prompt caching: minimum lifetime and write/read pricing. Checked October 23, 2026. https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI. Rendered model-page prices and endpoint references, checked October 23, 2026. https://reapi.ai/models/gpt-5-6-sol — https://reapi.ai/models/gpt-5-6-terra — https://reapi.ai/models/gpt-5-6-luna — https://reapi.ai/docs/gpt-5-6-sol — https://reapi.ai/docs/gpt-5-6-terra — https://reapi.ai/docs/gpt-5-6-luna
추가 읽을거리
- reAPI. How to use Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. How to use Claude Fable 5. reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Model catalog. reapi.ai/models
작성자

카테고리
max와 ultragpt 5.6 pricing출시를 형성한 검토경우가 강한 곳과 약한 곳GPT-5.6 사용법: 어느 티어를 선택할지reAPI에서 GPT-5.6 호출FAQmax와 ultra 모드의 차이는 무엇인가요?GPT-5.6 Sol이 코딩에서 Claude보다 나은가요?어느 GPT-5.6 티어를 사용해야 하나요?미국 정부가 출시에 관여한 이유는 무엇인가요?GPT-5.6이 GPT-5.5의 할루시네이션 문제를 해결했나요?GPT-5.6 Sol의 컨텍스트 윈도우는 얼마나 큰가요?프롬프트 캐싱에서 무엇이 변했나요?OpenAI SDK로 GPT-5.6을 호출하려면 어떻게 하나요?세 티어 출시 읽기참고 자료추가 읽을거리더 많은 게시물
AI 이미지 API 콘텐츠 필터: 거부의 메커니즘
이미지 API 필터링은 여러 계층에서 작동합니다. 동일한 프롬프트가 한 호스트는 통과하고 다른 호스트는 실패할 수 있지만, 설정에 관계없이 변하지 않는 경계가 있습니다.
Replicate API 가격: Replicate는 무료일까, 비쌀까?
Replicate API 가격 정리: Replicate가 Seedance 2.0, Wan 3.0 Prime, Nano Banana를 어떻게 과금하는지, Replicate가 무료인지, 같은 모델을 어디서 더 싸게 쓸 수 있는지 알아봅니다.
OpenAI 호환 API로 DeepSeek Harness 활용하기
DeepSeek Harness를 OpenAI 호환 엔드포인트에 연결하고 DeepSeek V4 Flash 또는 Pro를 선택한 뒤 도구 호출을 확인하며 캐시된 에이전트 루프 비용을 추정합니다.