DeepSeek V4 1Mコンテキスト:max_tokens、課金と実行
DeepSeek V4の1Mコンテキストは入力と出力で共有され、最大出力は384K。max_tokens、キャッシュ課金、同時実行制限について解説します。
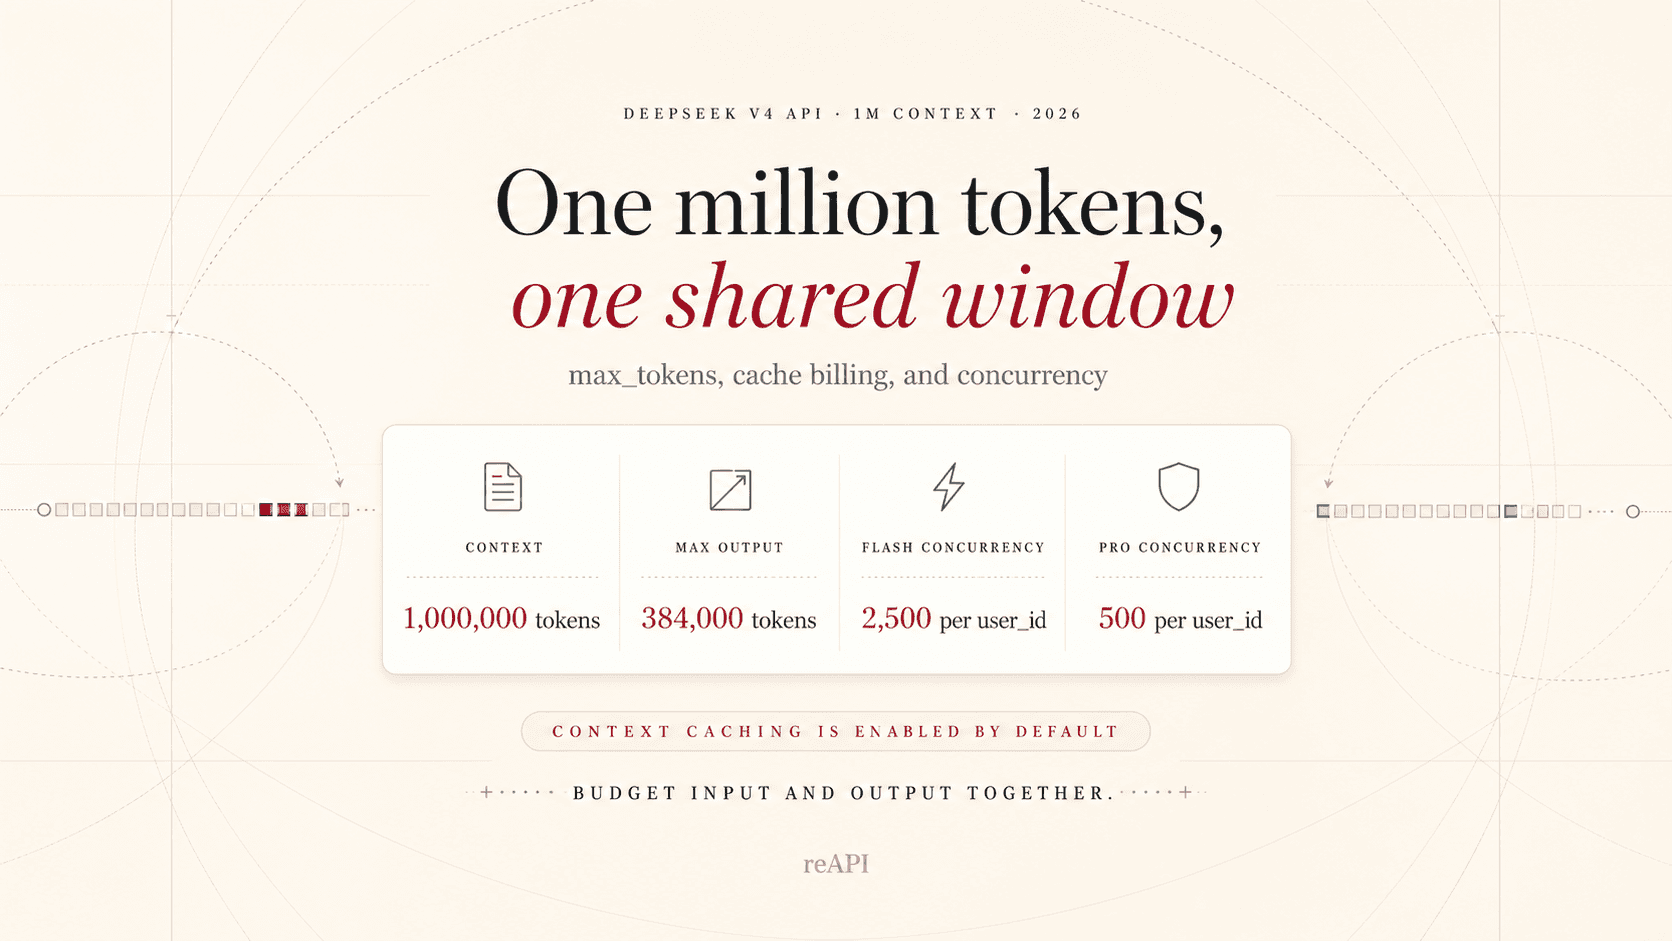
DeepSeek V4の1Mコンテキストウィンドウは、入力と出力で共有される予算です。入力で1M tokens送信してから384K追加生成できるという意味ではありません。 384K は出力の最大値であり、max_tokens は1回のリクエストで選択する出力の上限です。実際の出力は、1Mウィンドウに残っているスペースによっても制限されます[1][2]。
このガイドは、その仕様の背後にある実践的な質問に答えます:入力と出力の予算立て、max_tokensの設定方法、思考トークンが使用量に与える影響、キャッシュ課金の仕組み、FlashとProが異なる同時実行制限を持つ理由です。
DeepSeek V4の制限一覧
| 項目 | 公式仕様 |
|---|---|
| モデルID | deepseek-v4-flash、deepseek-v4-pro |
| コンテキストウィンドウ | 1M tokens、入力と生成出力で共有 |
| 最大出力 | 384K tokens |
max_tokens | リクエストごとの完了上限;残りのコンテキストまたはモデル出力制限を超えることはできません |
| デフォルトモード | 思考が有効;通常のリクエストはデフォルトで reasoning_effort: high |
| キャッシュ | コンテキストディスクキャッシュは自動的に有効 |
| 直接API同時実行 | Flash 2,500;Pro 500(アカウント単位) |
| インターフェース | OpenAI Chat Completions およびAnthropicコンパチブル |
DeepSeekは2026年4月24日にFlashとProのバリアントを備えた1Mコンテキストウィンドウでプレビューをリリースしました[3]。公式の料金ページでは、両方のモデルに対して同じ384K出力上限がリストされ、JSON出力、ツール呼び出し、プリフィックス完了、FIM完了が含まれています[1]。
1Mは入力のみを意味しますか?
いいえ。DeepSeekのChat Completions リファレンスでは、入力トークンと生成トークンの合計長がモデルコンテキスト長で制限されると記載されています[2]。
このメンタルモデルを使用してください:
入力トークン + 生成トークン <= 1Mコンテキスト
生成トークン <= max_tokens
生成トークン <= 384Kモデル出力制限
プロンプトがコンテキストウィンドウをほぼ満たしている場合、モデルは384K の回答も返すことはできません。システム命令、ツールスキーマ、会話履歴、完了のためにスペースを予約してください。
大きなウィンドウは検索とチャンキングの価値も削除しません。より少なく、より良く整理されたコンテキストを送信することで、通常、レイテンシ、コスト、回答の焦点が改善されます。
max_tokensの設定方法
max_tokens は1回のリクエストの最大完了長です。finish_reason が length の場合、リクエストがこの上限に達したか、利用可能なコンテキストを消費したことを意味します[2]。
合理的な開始点:
| ワークロード | 開始上限 |
|---|---|
| 分類、抽出、短い回答 | 1K–4K |
| コードレビューとドキュメント要約 | 4K–16K |
| 長いレポートと移行計画 | 16K–64K |
| 極端な長文生成 | コストと切り詰めを測定した後にのみ増加 |
これらはエンジニアリングの開始点であり、公式の要件ではありません。上限を上げる前に、finish_reason、実際の完了トークン、レイテンシ、有用な出力率を測定してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://api.reapi.ai/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {
            "role": "user",
            "content": "Review this repository inventory and produce a risk-ranked migration plan.",
        }
    ],
    max_tokens=16_384,
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"},
        "group": "default",
    },
)
reAPI リクエストフィールドについては DeepSeek V4 APIリファレンス を、プレイグラウンドとライブゲートウェイ料金については DeepSeek V4 モデルページ を参照してください。
思考トークンと完了使用量
思考モードはデフォルトで有効です。DeepSeekは推論を reasoning_content で返し、使用量オブジェクトは completion_tokens_details.reasoning_tokens として個別に報告できます[4][2]。
推論と目に見える最終回答の両方の周りで完了容量を計画してください。思考モードでは、temperature、top_p、presence_penalty、frequency_penalty は互換性のために受け入れられますが、有効にはなりません[4]。
決定論的抽出または低レイテンシの作業の場合は、思考が無効なFlashをテストしてください。計画、コーディング、追加の推論が有用な多段階のツール使用では思考を有効に保ってください。
ツール呼び出しでは過去の推論を保持しますか?
DeepSeekの現在のルールは、リクエストにtoolsがあるかで変わります。ツールを使う場合は、過去のassistantメッセージにreasoning_contentを含めて返し、その推論もコンテキストに数えられます。ツールを使わない場合は省略でき、送っても無視されます。ツールの処理ループで過去の推論を一律に削除しないでください[4]。
課金の仕組み
**2026年10月22日の料金確認:**下の7月30日の料金表は過去の記録であり、現在の見積もりではありません。DeepSeek の直販 API は、キャッシュ済み入力、未キャッシュ入力、出力それぞれにピーク料金とオフピーク料金を設定しています。ピーク時間は中国の祝日を除く月~金の UTC 01:00–04:00 と 06:00–10:00。それ以外はオフピークで、料金はピーク時の半額です。同ページは現在 deepseek-flash を推奨しています。旧名 deepseek-v4-flash も受け付けますが、処理は DeepSeek-V4.1-Flash-1017 が行い、Flash 料金が適用されます。これは DeepSeek 直販のルールで、reAPI のモデル対応や料金を保証するものではありません。reAPI の対象モデルと現行料金は V4 ページまたは V4.1 Flash ページで確認してください[7]。
DeepSeek Directは3つのトークンバケットを課金します:
- キャッシュされた入力;
- キャッシュされていない入力;
- 出力。
2026年7月30日の公式USD料金は[1]以下の通りです:
| モデル | キャッシュされた入力 / 1M | キャッシュされていない入力 / 1M | 出力 / 1M |
|---|---|---|---|
| DeepSeek V4 Flash | $0.0028 | $0.14 | $0.28 |
| DeepSeek V4 Pro | $0.003625 | $0.435 | $0.87 |
一般的な公式は:
コスト =
  キャッシュ入力 / 1M × キャッシュレート
  + キャッシュなし入力 / 1M × キャッシュなしレート
  + 出力 / 1M × 出力レート
これらはDeepSeekの直接料金です。reAPIはライブUSD料金を持つ別のゲートウェイであるため、ゲートウェイ課金には reAPI DeepSeek V4 ページ の料金カードを使用してください。
コンテキストキャッシュから価値を得る
DeepSeekのディスクキャッシュは自動的に有効になります。後続のリクエストは、保存されたプリフィックスユニットと完全に一致する場合にのみキャッシュヒットを受け取ります。同様の表現では不十分です[5]。
安定したコンテンツを最初に配置します:
安定したシステムプロンプト
+ 安定したツールスキーマ
+ 変更されていないリポジトリまたはドキュメントコーパス
+ リクエストごとに変更される質問
レスポンスフィールド prompt_cache_hit_tokens と prompt_cache_miss_tokens を使用して、実際のヒット率を計算してください。プロンプト類似性だけから節約を推定しないでください。
FlashとProの同時実行
DeepSeek Directはアカウントレベルの同時実行制限を公開しています。Flashは2,500、Proは500(アカウント単位)です。リクエストは応答が終了するまで1つの同時実行スロットを占有します。制限はAPIキーごとではなくアカウントごとで、超過リクエストはHTTP 429を受け取ります[6]。
オプションの user_id は安全性、キャッシュ、スケジューリング動作を分離できますが、通常のアカウントはすべてのuser_idでアカウント同時実行全体を共有します。より多くのキーまたはuser_idを作成しても容量は増加しません。
これらの数値はDeepSeek Directに適用されます。ゲートウェイの同時実行とキューイングは異なる場合があります。reAPIを使用する場合は、reAPIが公開する制限と応答に従ってください。
1Mコンテキストリクエストの本番チェックリスト
- トークンを数えてください。文字をトークンとして扱わないでください。
- 出力、ツールスキーマ、フォローアップターンのためにコンテキストを予約してください。
max_tokensをタスクに設定してください。自動的に384Kに設定しないでください。finish_reasonを記録し、切り詰めを自然停止から区別してください。- 再利用可能なプリフィックスを安定に保ち、キャッシュヒットトークンを追跡してください。
- 目に見える回答長から推論使用量を個別に測定してください。
- 指数関数的バックオフとジッターで429応答を再試行してください。
- 高容量の定型作業をFlashにルーティングし、難しいタスク用にProを予約してください。
- 現在のV4モデルIDを使用してください。DeepSeekが発表した
deepseek-chatとdeepseek-reasonerの廃止予定日は2026年7月24日でした[3]。
FAQ
DeepSeek V4 Flashは1Mコンテキストをサポートしていますか?
はい。FlashとProの両方が1Mコンテキストウィンドウと384K最大出力を持ちます[1]。
1Mコンテキストはすべて入力ですか?
いいえ。入力と生成出力はモデルコンテキスト制限を共有します[2]。
max_tokens を384Kに設定できますか?
384Kはモデル出力上限ですが、リクエストは1Mコンテキストウィンドウに十分なスペースが残っている必要があります。設定は384K完了を保証しません。
推論トークンは完了使用量にカウントされますか?
容量と課金計画にはそれらを含める必要があります。DeepSeekは完了使用量の詳細内で推論トークンを報告します[2]。
同時実行制限はAPIキーごとですか?
いいえ。DeepSeek Directはアカウントごとの同時実行を制限します:Flashは2,500、Proは500[6]。
プロンプトキャッシングを有効にする必要がありますか?
いいえ。コンテキストディスクキャッシュは自動的です。共有プリフィックスを安定に保ち、usage 内のキャッシュヒットフィールドを検査してください[5]。
関連資料
参考文献
-
DeepSeek. Models & Pricing — V4 context, output, features, prices, and concurrency. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/pricing
-
DeepSeek. Create Chat Completion — max_tokens, context limits, finish reasons, and usage. Retrieved July 30, 2026 from api-docs.deepseek.com/api/create-chat-completion
-
DeepSeek. DeepSeek-V4 preview release. April 24, 2026. api-docs.deepseek.com/news/news260424
-
DeepSeek. Thinking Mode — controls, reasoning effort, and reasoning content. Retrieved September 8, 2026 from api-docs.deepseek.com/guides/thinking_mode
-
DeepSeek. Context Caching — prefix matching and usage fields. Retrieved July 30, 2026 from api-docs.deepseek.com/guides/kv_cache
-
DeepSeek. Rate Limit & Isolation — account-level concurrency and user_id. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/rate_limit
-
DeepSeek. Models & Pricing. 2026年10月22日に再確認. api-docs.deepseek.com/quick_start/pricing
著者

カテゴリ
max_tokensの設定方法思考トークンと完了使用量ツール呼び出しでは過去の推論を保持しますか?課金の仕組みコンテキストキャッシュから価値を得るFlashとProの同時実行1Mコンテキストリクエストの本番チェックリストFAQDeepSeek V4 Flashは1Mコンテキストをサポートしていますか?1Mコンテキストはすべて入力ですか?max_tokens を384Kに設定できますか?推論トークンは完了使用量にカウントされますか?同時実行制限はAPIキーごとですか?プロンプトキャッシングを有効にする必要がありますか?関連資料参考文献他の記事
Seedance 2.5の使用場所:公式アプリとAPIアクセス
Seedance 2.5の公式アプリ、BytePlus、Volcengine、reAPI、Higgsfieldの入口を整理。アカウント条件と地域ごとの利用制限を確認できます。
OpenRouter の料金:手数料、無料モデルの制限、より安い選択肢
OpenRouter の料金を解説:定価ベースのトークン課金、クレジット購入時の 5.5% 手数料、無料モデルの 1 日あたりの制限、クレジットの有効期限と返金、reAPI のほうがトークン単価の安いモデル。
LLMの最大出力トークン数を比較:モデル別APIの生成上限とコンテキスト予算、推論トークンの計算方法
LLMの最大出力トークン数を、コンテキストウィンドウ、推論予算、APIパラメータと分けて比較。既定値と推奨値、リクエスト上限を整理し、Claudeのバッチ限定出力拡張も解説します。提供元のネイティブAPI仕様とreAPIの公開インターフェースを正しく区別し、長文やコード生成に必要な予算を確認できます。