Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5:跑分对比
Gemini 4 Argon、GPT-6 Astra 与 Claude Opus 5.5 怎么选?本文保留谷歌 9 月 30 日发布的 19 项历史跑分,解释编码、知识工作、长上下文与视频任务的结果、厂商测试方法和比较局限,并结合当前共享上下文、单次输出限制与客户端续写规则,帮助你设计自己的任务评估。
Gemini 4 Argon 在谷歌 9 月 30 日发布时的对比中领先多数项目,但并非全部。在 2026 年 9 月 30 日公布的 19 行表格中,相对 GPT-6 Astra 和 Claude Opus 5.5,Argon 有 13 行最高、1 行并列、5 行落后:3 行输给 Astra,2 行输给 Opus 5.5[1]。落后项集中于终端工作、较难的软件基准和电脑操作,这些也正是许多开发者关注的任务。
本文列出谷歌表格中的每个数字,补充当前文档中的请求限制,解释评测方法的局限。发布后的需求包括“gemini 4 argon benchmarks”“gemini 4 argon performance relative to other models”“gemini 4 vs gpt 6 astra”和“gemini 4 vs claude”。谷歌现已公布 Gemini API 与 Google AI Studio 入口[2]。以下保留发布时的历史结果,不是新的独立测试,也不代表今天的排行榜。
要点速览
- 总体:三个模型中,Gemini 4 Argon 在 19 行里有 13 行最高,GPT-6 Astra 3 行,Claude Opus 5.5 2 行,另有 1 行并列[1]。
- Argon 的明显优势项:Harvey's Legal Agent Benchmark(19.6% 对 5.4% 和 3.8%)、GraphWalks 256K–1M(84.2% 对 71.8% 和 66.8%)及长视频 LVBench(91.7%)[1]。
- 落后项:Opus 5.5 领先 Terminal-bench 4.0(66.4% 对 57.4%)和 PostTrainBench;Astra 领先 FrontierSWE v2、Terminal-Bench Science 与 OSWorld-2.0[1]。
- 上下文与输出:Argon 的输入、思考和输出共享 1,048,576 token。原生 JSON 单次上限 32,768,流式 65,536;长生成跨请求续写[3]。
- 成本:应比较当前价格和任务总用量,包括思考与续写。Gemini 4 Argon 价格指南解释各计费维度。
Gemini 4 Argon 跑分:完整表格
数字来自谷歌发布公告中的表格,其中也包含 Claude Fable 5.1,单独列出以回答与 Fable 对比的问题。Argon、Astra 和 Opus 5.5 三者中的最高分加粗;破折号表示谷歌没有报告结果[1]。
| 领域 | 基准 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 63.1% | 67.0% | 65.8% |
| 知识工作 | AutomationBench | 51.3% | 41.4% | 42.5% | 31.4% |
| 知识工作 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% | 58.9% |
| 知识工作 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 3.8% | 6.7% |
| 智能体编程 | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% | 67.4% |
| 智能体编程 | FrontierSWE v2 | 55.0% | 65.5% | 62.3% | 56.3% |
| 智能体编程 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 智能体编程 | Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% | 57.9% |
| 机器学习工程 | PostTrainBench | 45.3% | 44.3% | 49.3% | 40.2% |
| 科学与数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 63.3% | 52.6% |
| 科学与数学 | LABBench 2 | 88.8% | 85.4% | 73.1% | 68.6% |
| 科学与数学 | RiemannBench | 76.0% | 72.0% | 69.6% | 65.6% |
| 长上下文 | GraphWalks,最高 128K | 99.7% | 98.7% | 90.6% | 91.4% |
| 长上下文 | GraphWalks,256K 至 1M | 84.2% | 71.8% | 66.8% | 65.0% |
| 电脑操作 | Agent's Last Exam | 39.5% | 34.2% | 38.2% | — |
| 电脑操作 | OSWorld-2.0(离线子集) | 69.2% | 72.6% | — | — |
| 多模态 | Chartography | 71.6% | 71.0% | 66.3% | 46.2% |
| 多模态 | LVBench | 91.7% | 87.5% | 83.7% | 79.7% |
| 网络安全 | CWE-bench v1 | 68.0% | 68.0% | 67.0% | 58.0% |
单独对比 Claude Opus 5.5,在两者都有分数的 18 行中,Gemini 4 Argon 领先 14 行,落后 4 行:FrontierSWE v2、Terminal-bench 4.0、PostTrainBench 和 Terminal-Bench Science[1]。
结合谷歌的评测方法读表
每个分数都来自谷歌公告,方法说明页解释各数字的来源。三个细节会影响如何判断差距[4]:
- 大多数对手分数由厂商自报。 谷歌表示,除另有说明外,非 Gemini 模型使用各厂商自行报告的数字;有记录时采用对手可用的最高推理档位。
- 部分 Argon 分数由谷歌测试。 DeepSWE v1.1 和 Terminal-bench 4.0 的 Argon 结果由谷歌运行,而 Astra、Fable、Opus 数据来自公开排行榜或系统卡。这是常见做法,但测试框架不一定完全相同。
- 输入并不总是相同。 LVBench 中,Gemini 使用每秒 1 帧;受 API 限制,Astra 用 800 帧、Opus 5.5 用 600 帧、Fable 5.1 用 300 帧。输入帧预算不同,长视频差距需要谨慎解释。
表格适合用来选择测试方向,但没有提供每行的置信区间或统一测试框架。小幅领先不保证会在实际任务上重现;较大差距可以支持定向评估,也不能证明应用中的排名一定相同。
Gemini 4 Argon 独立跑分对比
Artificial Analysis 对其收录的每个模型都运行自己的 Intelligence Index,因此所有模型都使用同一套测试。它的排名与谷歌表格不同。以下数字来自其 2026 年 11 月 4 日的模型页面[5]:
| 模型(测试档位) | Intelligence Index | 在所列 62 个模型中的排名 | 指数测试所用输出 token | 每项指数任务成本 | 输出速度 |
|---|---|---|---|---|---|
| Claude Opus 5.5(Max) | 59 | 2 | 220M | $10.04 | 94.2 tokens/s |
| GPT-6 Astra(Max) | 57 | 5 | 54M | $6.24 | 67.1 tokens/s |
| Gemini 4 Argon(High) | 50 | 15 | 110M | $7.68 | 81.9 tokens/s |
测试档位并不完全相同。Argon 仅有 High 档结果,Astra 和 Opus 5.5 列出的是 Max 档。同一榜单中,GPT-6 Astra 的 High 档仍排名第七,领先 High 档的 Argon。Artificial Analysis 还采用每百万 token 输入 $4、输出 $20 的 Argon 价格,这是谷歌从 12 月 1 日起适用的费率,而非我们在 Gemini 4 Argon 价格指南中介绍的输入 $2、输出 $10 的引入价格。
可以得出两个合理判断:在谷歌的 19 项任务基准中,Argon 领先多数项目;在这一项独立指数中,Opus 5.5 和 Astra 得分更高。Astra 也是三者中 token 使用效率最高的:完成同一指数测试,其输出 token 用量约为 Argon 的一半、Opus 5.5 的四分之一。
上下文与输出会影响接入选择
本文旧版本曾写 Argon 上下文窗口未公布,并把输出描述为单个响应一百万 token。当前谷歌开发者指南已给出更具体的限制[2][3]。
| Gemini 4 Argon 属性 | 当前文档行为 |
|---|---|
| 开发者入口 | Gemini API 和 Google AI Studio |
| 模型 ID | gemini-4-argon |
| 共享上下文 | 输入、思考和输出合计 1,048,576 token |
| 原生 JSON 单次请求 | 最多 32,768 个生成 token |
| 原生流式单次请求 | 最多 65,536 个生成 token |
| 更长生成 | 在共享窗口剩余空间内跨请求续写 |
| 原生思考档位 | low、medium(默认)、high;不能完全关闭思考 |
长生成给大任务提供了空间,但不保证单个 HTTP 响应包含完整报告。reAPI 不会在服务端自动续写;客户端必须显式处理续写、记录每次请求,并保留恢复所需的信息。
发布时的对比使用了 Astra 与 Opus 自家文档中的输出规格。不能把那些历史限制与 Argon 的长生成上限并列,当作同一种单次请求的比较。规划所需输出长度时,请查看当前 GPT-6 Astra 和 Claude Opus 5.5 页面;当前价格也以这些模型页为准。
Gemini 4 Argon vs GPT-6 Astra
相对 Astra,Argon 领先多数知识工作与长上下文项目;法律和金融智能体差距较大,Harvey's 为 19.6% 对 5.4%,Vals Finance Agent v2 为 65.4% 对 53.5%[1]。要得出成本判断,还需结合自己评估中的 token 用量与当前价格。
任务类似表中电脑操作与软件基准时,值得先测试 Astra。它领先 OSWorld-2.0(72.6% 对 69.2%)、FrontierSWE v2(65.5% 对 55.0%)和 Terminal-Bench Science(68.1% 对 57.6%)[1]。后两项的 10.5 个百分点是 Argon 在发布表中的最大落后差距;任务相近的团队切换前应实测。Astra 在 Terminal-bench 4.0 也以 58.2% 对 57.4% 小幅领先。
Gemini 4 Argon vs Claude Opus 5.5
编程方面,这一组更接近。Argon 领先 DeepSWE v1.1(77.9% 对 74.2%)和 Vibe Code Bench(91.9% 对 90.3%);Opus 5.5 在 Terminal-bench 4.0 领先 9 个百分点(66.4% 对 57.4%),PostTrainBench 领先 4 个百分点(49.3% 对 45.3%)[1]。如果智能体主要在 shell 中工作,Opus 5.5 仍值得纳入比较。
编程以外,Argon 的法律基准领先 15.8 个百分点,GraphWalks 256K–1M 领先 17.4,LABBench 2 领先 15.7[1]。生产选型应让两个模型处理相同材料并接受相同验收。跑分领先并不决定哪个模型完成任务需要更少 token。
不同任务优先测试哪个模型
- 法律、金融研究、长文档和视频:将 Gemini 4 Argon 纳入评估,这些是谷歌历史表中领先较多的项目。用自己的材料检查来源准确性与完整性。
- 长篇迁移或报告:使用能处理续写的客户端评估 Argon 长生成,同时为思考和回答留空间;共享窗口不是独立输出额度。
- 终端为主的编程智能体:同时测试 Claude Opus 5.5 与 Argon。Opus 在本表 Terminal-bench 4.0 领先,但还需结合自己的工具与任务核验。
- 电脑操作和困难软件任务:纳入 GPT-6 Astra,它在这份历史表中领先 OSWorld-2.0 和 FrontierSWE v2。
保持比较可复现:使用相同提示词和材料,记录推理设置与预算,区分未完成回答和完成但错误的回答。工具调用应验证完整往返流程,不能止步于模型返回工具调用。
reAPI 的 Gemini 4 Argon 模型页提供当前价格和请求文档。现在的问题已不是等待谷歌公布 API,而是哪个模型能在可接受成本下完成实际任务。
常见问题
Gemini 4 Argon 比 GPT-6 Astra 更强吗?
在谷歌表格的多数项目上:19 行中 Argon 领先 Astra 14 行,1 行并列。Astra 领先 FrontierSWE v2、Terminal-Bench Science、OSWorld-2.0,并在 Terminal-bench 4.0 小幅领先[1]。
Gemini 4 Argon 比 Claude Opus 5.5 更强吗?
谷歌表中可比的 18 行里,Argon 领先 14 行。Opus 5.5 领先 Terminal-bench 4.0、PostTrainBench、FrontierSWE v2 与 Terminal-Bench Science[1]。
与 Claude Fable 5.1 相比如何?
双方都有分数的 17 行中,Argon 领先 15 行。Fable 5.1 在 FrontierSWE v2(56.3% 对 55.0%)和 Terminal-bench 4.0(57.9% 对 57.4%)稍高[1]。
Gemini 4 Argon 最好的跑分是什么?
最高分是 GraphWalks 最高 128K 的 99.7%。更值得关注的是大差距项目:Harvey's 为 19.6%,Astra 和 Opus 5.5 分别为 5.4% 和 3.8%;GraphWalks 256K–1M 为 84.2%[1]。
这些跑分是独立测评吗?
不完全是。它们来自谷歌公告;谷歌说明多数对手分数由厂商自报,部分 Argon 测试由谷歌运行[4]。Artificial Analysis 使用同一指数测试了三者:2026 年 11 月 4 日,Opus 5.5 得分为 59,Astra 为 57,Argon 为 50[5]。
哪个模型最便宜?
请查各模型页当前价格,比较获得可验收结果的成本。输入长度、缓存命中、推理与续写都会改变费用。价格指南说明如何比较,避免依赖旧静态价表。
如何在 Argon、Astra 与 Opus 5.5 之间选择
谷歌 9 月的表格说明,知识工作与长上下文评估值得纳入 Gemini 4 Argon;终端和电脑操作任务也有理由保留 Opus 5.5 与 Astra。这些是来自注明日期的厂商对比、值得验证的判断。
最终决定应依靠应用能够评分的任务:修改能否通过测试、报告论断是否有依据、智能体是否完成指定动作。同时记录预算与续写行为,才能把发布时的跑分变成对 Gemini 4 Argon 的实用评估。
参考资料
-
Google. Gemini 4 Argon: our next era of frontier intelligence (including benchmark table). 2026 年 10 月检索自 blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
-
Google. What's new in Gemini 4 Argon. 2026 年 10 月 14 日检索自 ai.google.dev/gemini-api/docs/generate-content/latest-model
-
Google. Gemini thinking. 2026 年 10 月 14 日检索自 ai.google.dev/gemini-api/docs/generate-content/thinking
-
Google DeepMind. Gemini 4 Argon model evaluation: approach, methodology and results. 2026 年 10 月检索自 deepmind.google/models/evals-methodology/gemini-4-argon
-
Artificial Analysis. Gemini 4 Argon (High), GPT-6 Astra (Max) and Claude Opus 5.5 (Max) model pages. 2026 年 11 月 4 日获取自 artificialanalysis.ai/models/gemini-4-argon、gpt-6-astra 和 claude-opus-5-5
作者

分类
更多文章
GPT-6 Luna vs 5.6 Luna vs 5.6 Terra:价格对比与选型建议
GPT-6 Luna 对比 5.6 Luna 与 5.6 Terra:OpenAI 官方刊例价、Luna 降价的官方理由、基准测试与早期 A/B 测试结果,以及该选哪一个。
Seedream 5.0 Lite 与 Pro:价格、编辑、质量对比
对比 Seedream 5.0 Lite 和 Pro 在价格、分辨率、图像编辑、参考图、批量生成和 API 应用中的差异。
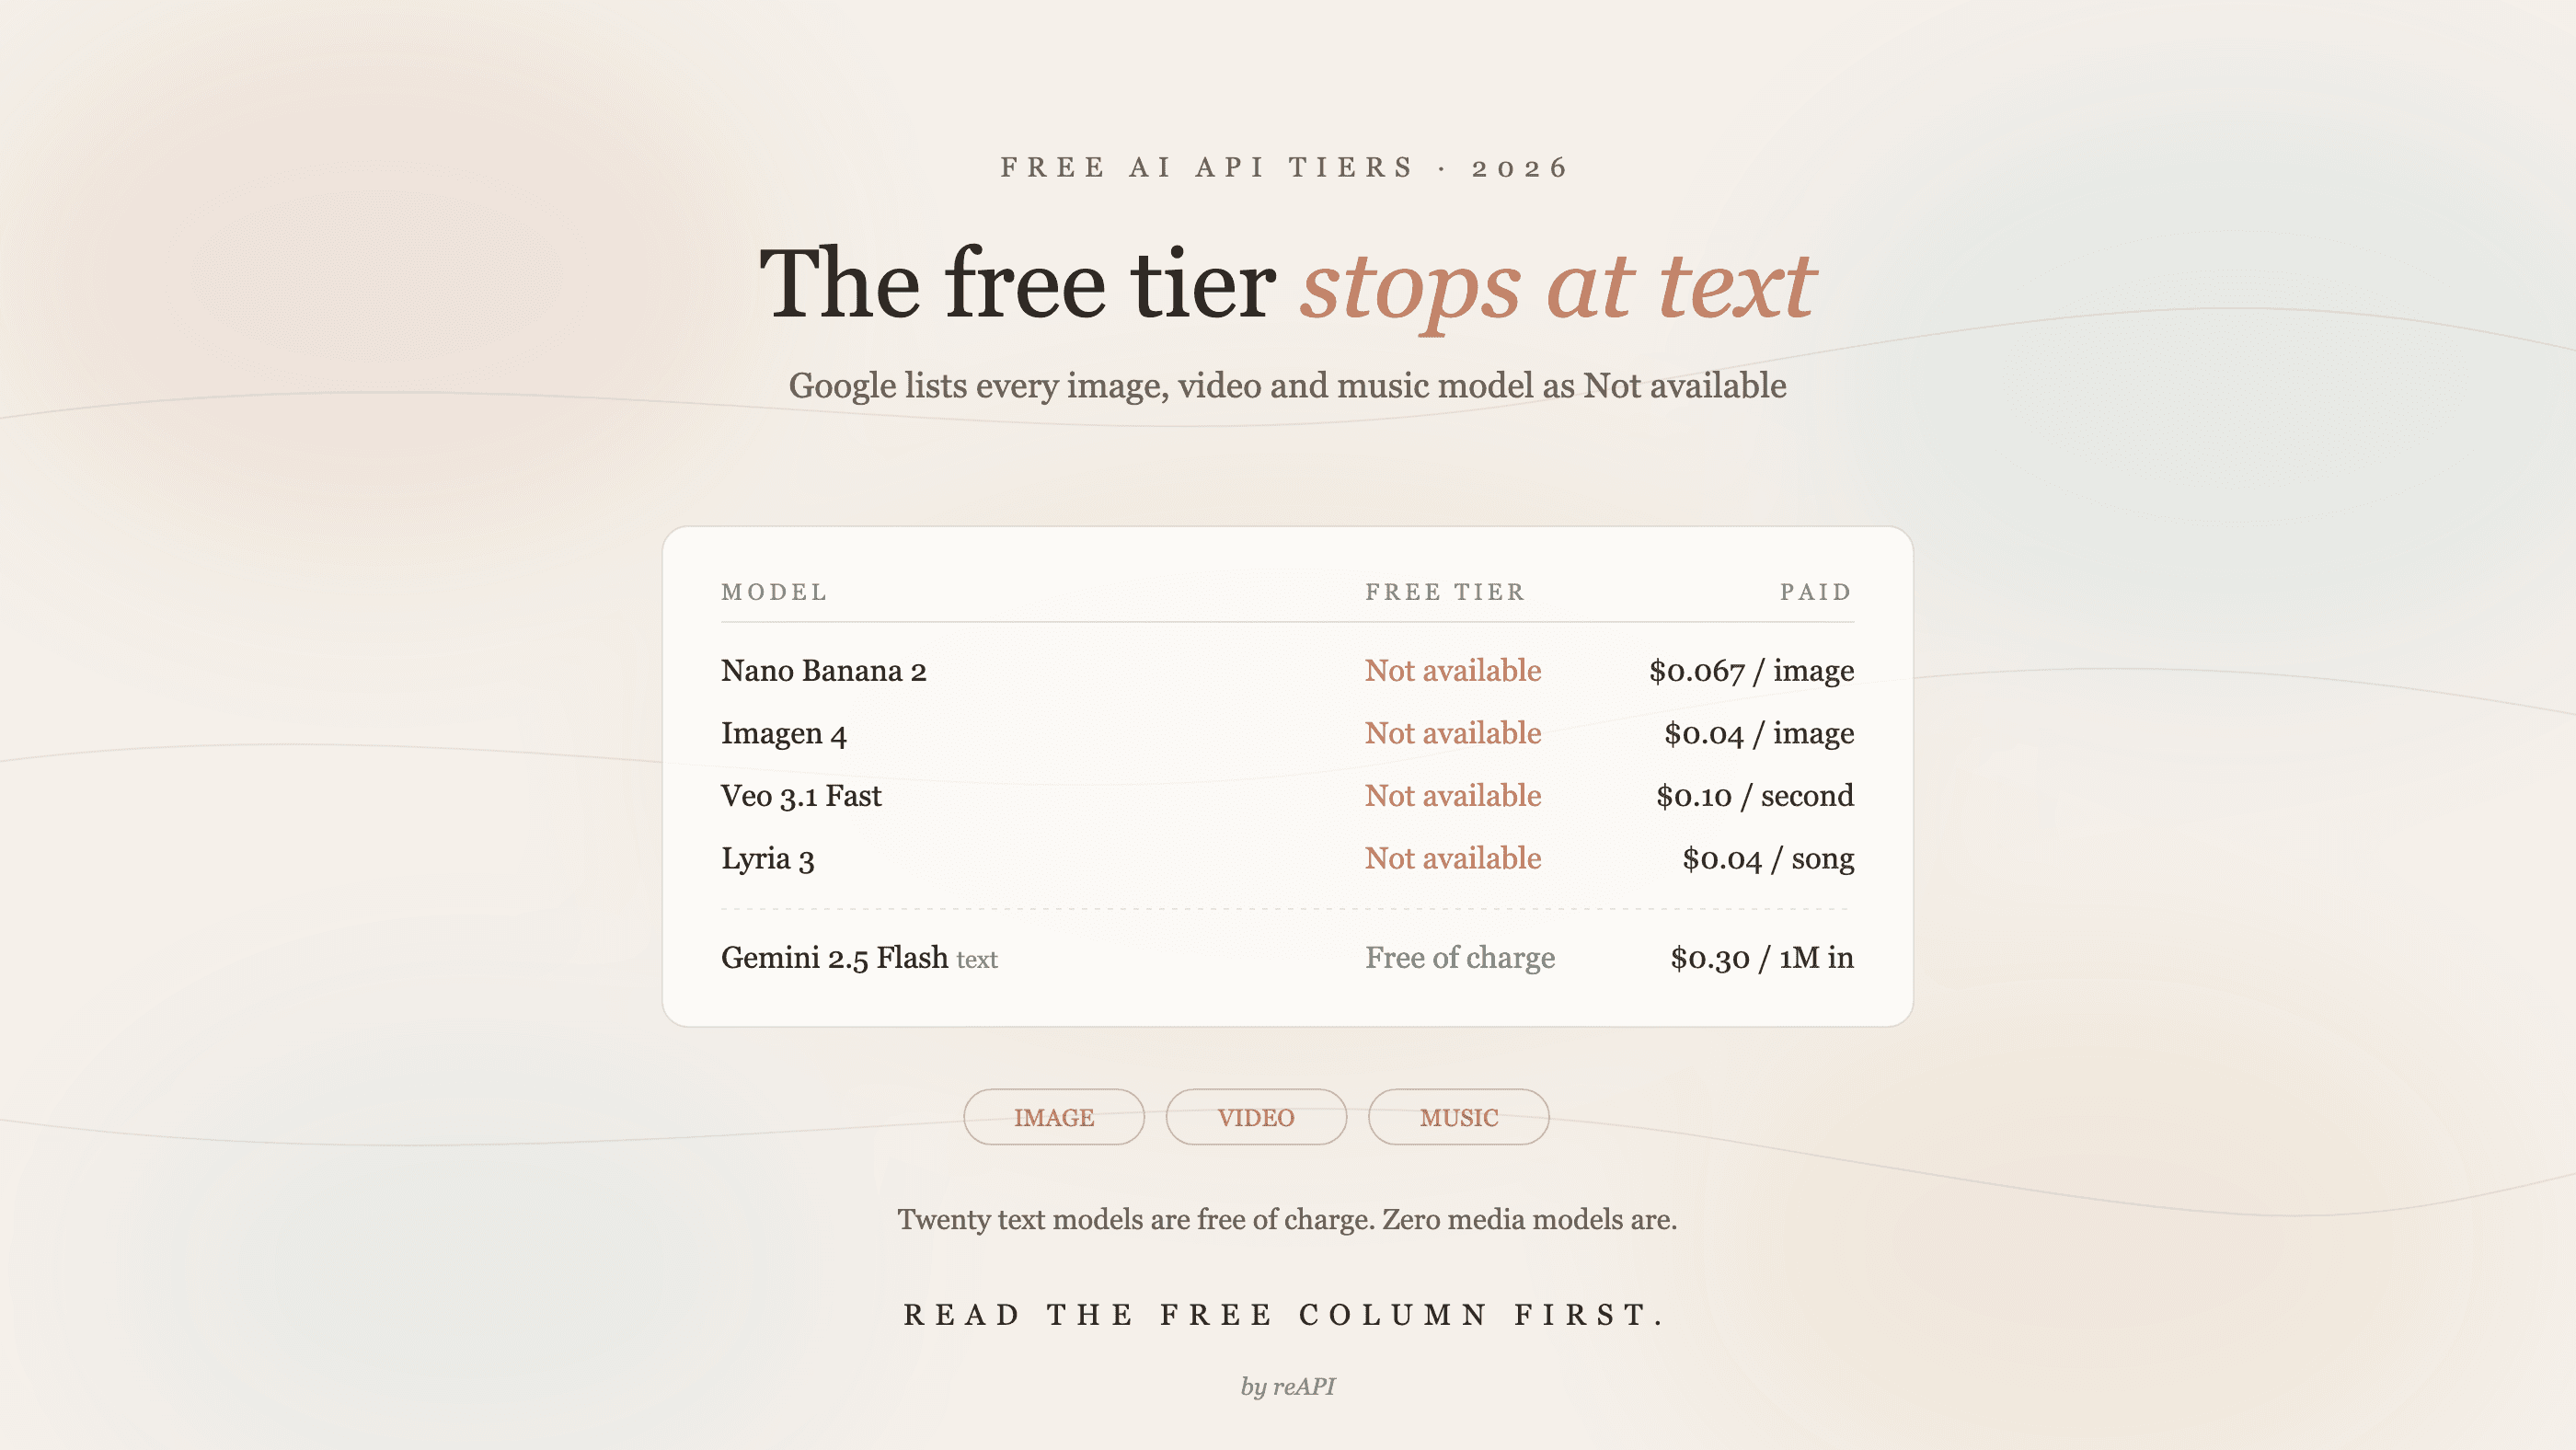
2026 年免费 AI API 限制:各家实际开放什么
Google 免费 AI API 层不包含任何图像、视频和音乐生成模型。了解 2026 年各大厂商免费层的真实限额、价格和对应规则。