Как использовать GPT-5.6: сравнение уровней Sol, Terra и Luna
Как использовать GPT-5.6: стоимость Sol, Terra и Luna, таблица Terminal-Bench и четыре звёздочки, новые режимы max и ultra, и какой уровень выбрать.
При выборе GPT-5.6 Sol vs Terra vs Luna начните с самого дешёвого уровня, проходящего ваши проверки качества: Luna для больших объёмов с ограниченным бюджетом, Terra — когда ошибки или повторные попытки Luna оправдывают повышение уровня, Sol — для сложной профессиональной работы, где дополнительные возможности окупаются. Текущие ставки OpenAI Standard за миллион входных/выходных токенов составляют $0.20/$1.20 для Luna, $2/$12 для Terra и $4/$20 для Sol при запросах до 272K входных токенов. Все три модели имеют одинаковые документированные ограничения контекста и выхода; более высокая цена не даёт большего окна.[3][4][5]
Приведённые ниже цены и текущие ограничения API проверены 23 октября 2026 года. Обсуждение запуска и Terminal-Bench сохранено как исторический контекст; это не новый прогон тестов и не обещание, что каждый режим оценки при запуске является параметром API.
OpenAI начала ограниченный превью GPT-5.6 26 июня 2026 года, и самым странным в этом запуске было то, что его почти никто не мог использовать. Доступ получили примерно двадцать проверенных партнёров через API и Codex в поэтапном развёртывании, которое, как утверждает OpenAI, запросило правительство США[1].
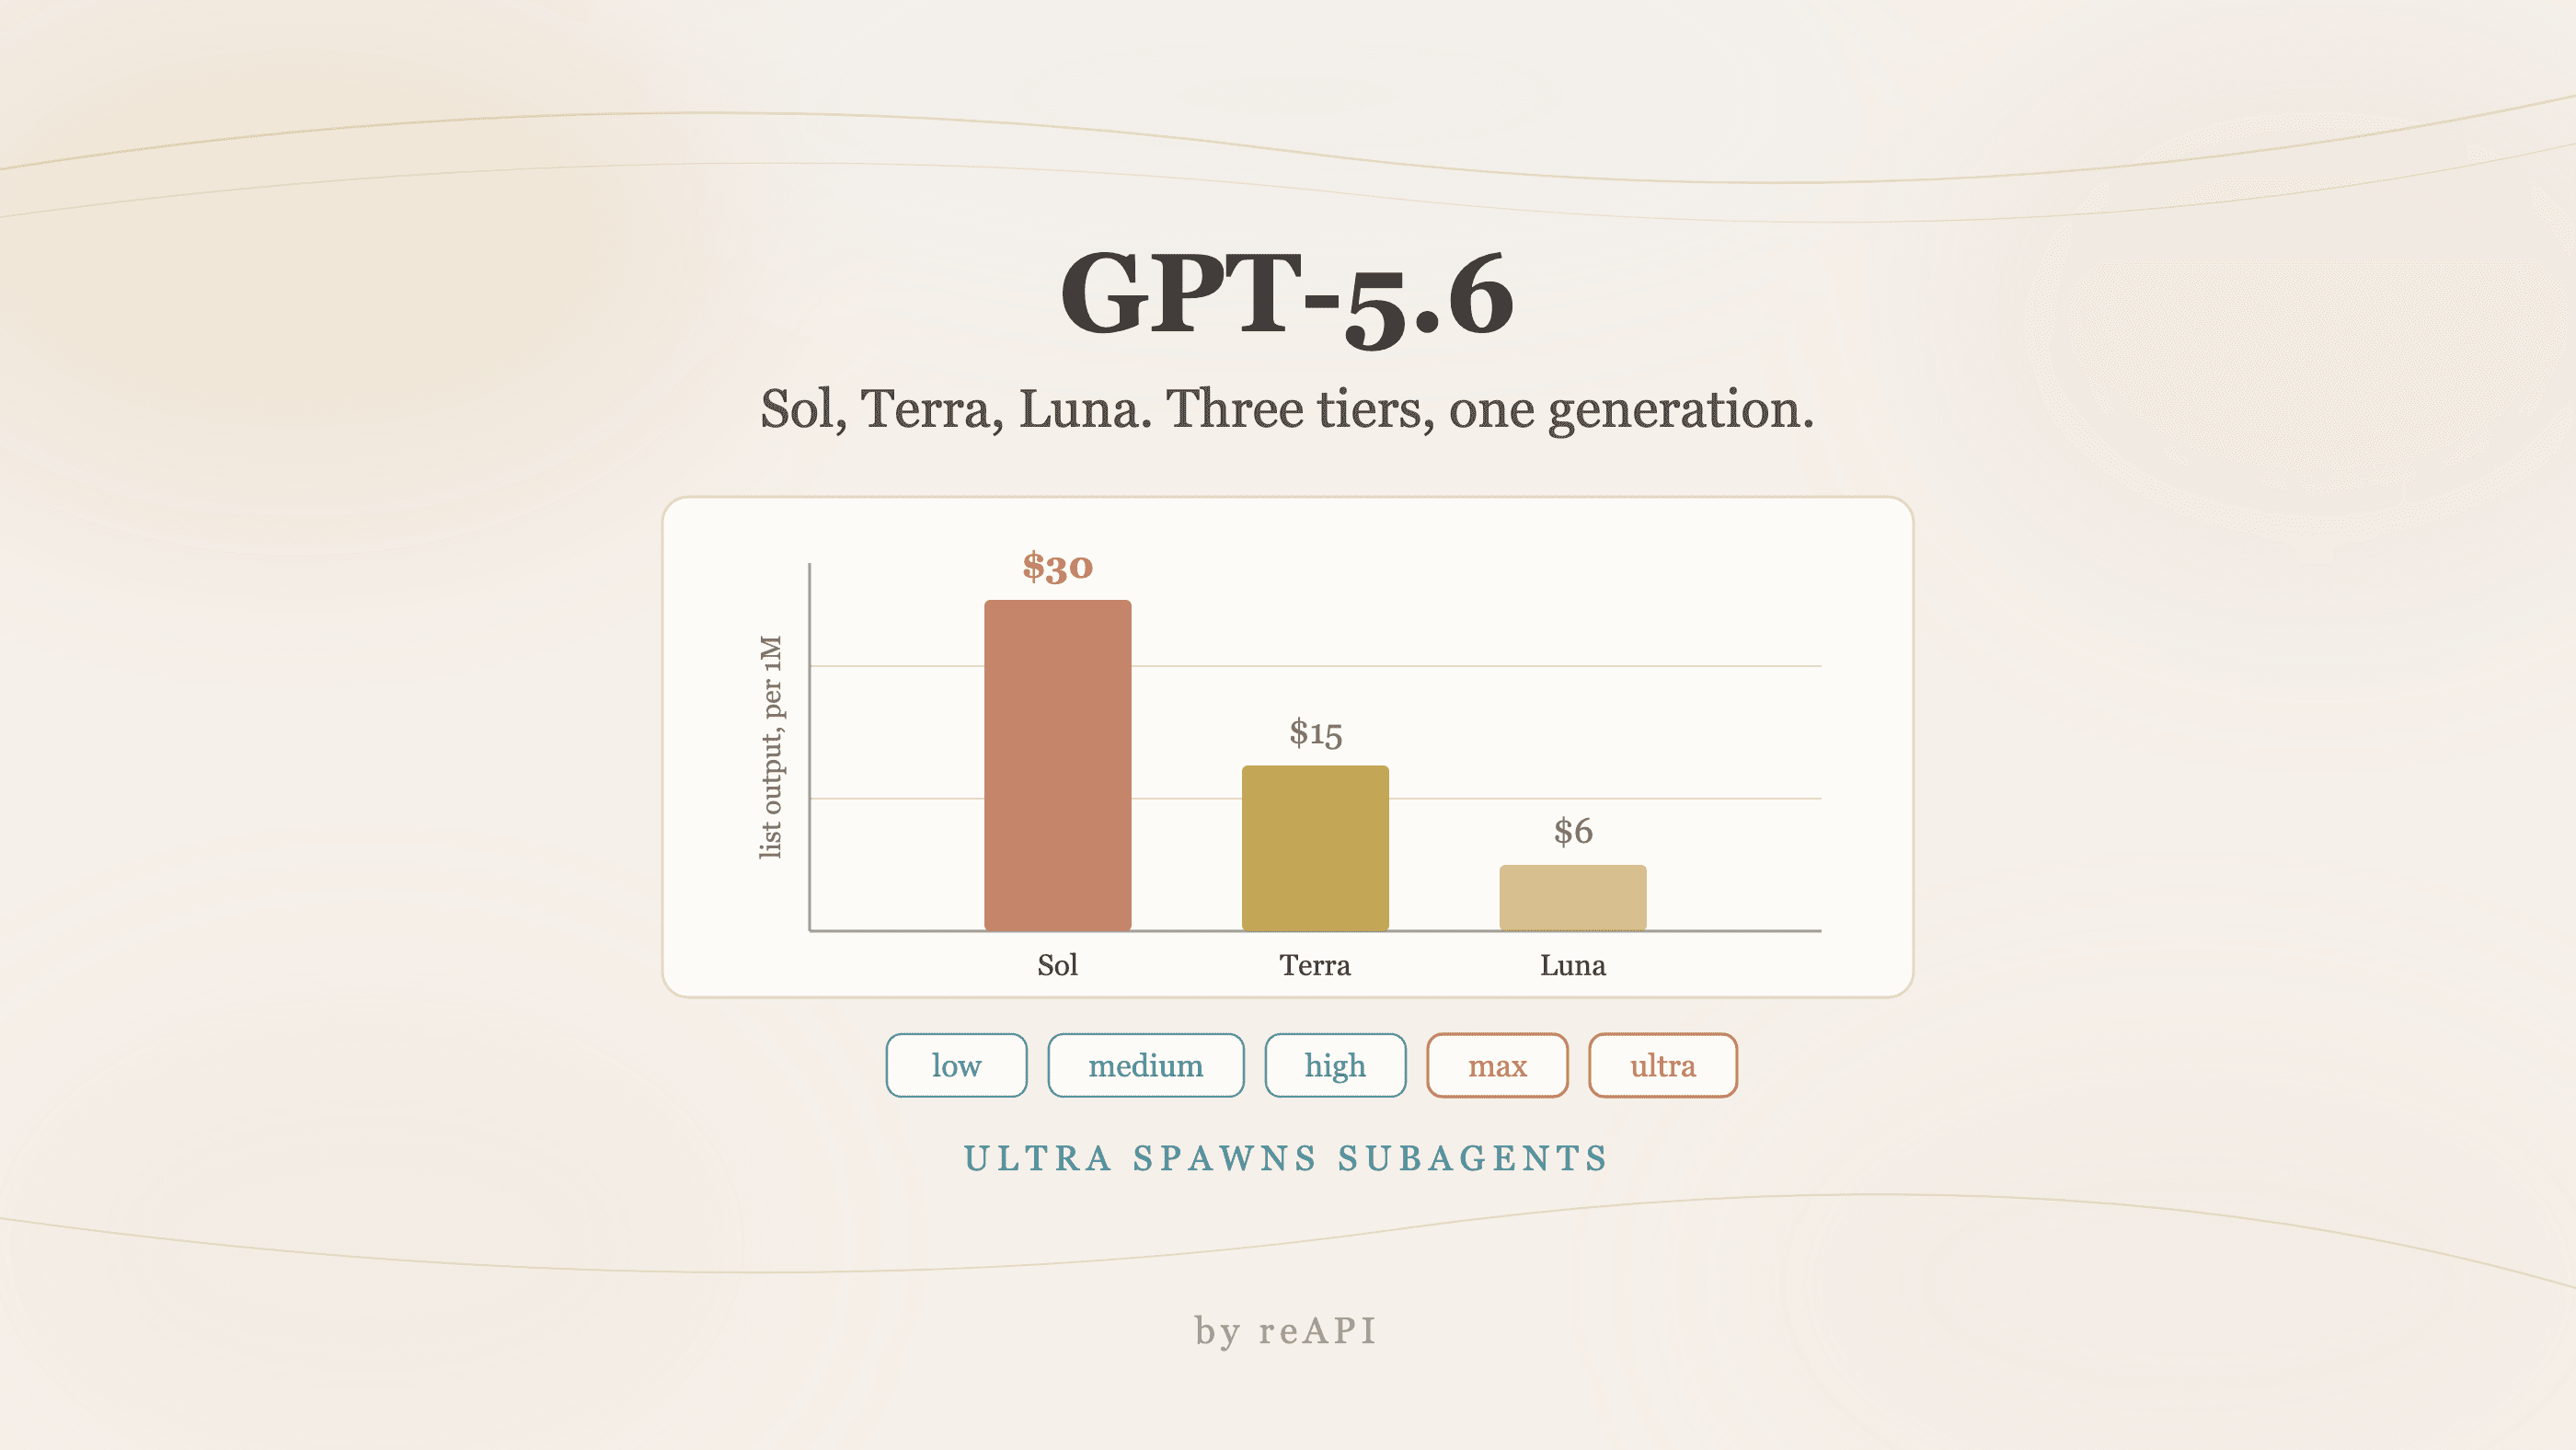
С тех пор это ограничение снято. Вопрос о том, как использовать GPT-5.6, теперь имеет практический смысл, а не просто игра в ожидание. Ответ в основном сводится к выбору одного из трёх уровней: Sol — флагман, Terra — сбалансированный рабочий вариант и Luna — бюджетный уровень. Каждый — прочная функциональная категория под одним номером поколения, а не временный вариант.
Руководство охватывает текущий выбор между тремя уровнями, цены и ограничения, а также тест запуска с четырьмя оговорками, историческую настройку оценки ultra и проверку кибербезопасности, определившую порядок выпуска.
TL;DR
- Три уровня с одинаковыми пределами. Sol — флагман, Terra балансирует интеллект и стоимость, Luna рассчитана на объём при ограниченном бюджете. Все три поддерживают усилие рассуждения
max.[3][4][5] - В стартовой таблице Terminal-Bench 2.1 Sol набирает 88.8% с одним агентом или 91.9% в режиме
ultra. Одноагентное преимущество над Claude Mythos 5 — 0.8 пункта, что находится в пределах шума[1]. ultra— не один агент. Он оркеструет подагентов параллельно, поэтому его результат не является прямым сравнением с одноагентными базовыми значениями[1].- Выбирайте по принятой задаче, а не названию уровня. Сначала проверяйте Luna на обычных объёмах, сравнивайте Terra на её ошибках и используйте Sol, когда улучшение покрывает повышенную стоимость.
- В reAPI цены короткого входа/выхода составляют 80% текущих ставок OpenAI Standard: Sol $3.20 / $16.00, Terra $1.60 / $9.60, Luna $0.16 / $0.96 за миллион токенов (проверено 23 октября 2026 года). Этот процент не описывает все ставки длинного контекста.[8]
- Окно оценки было намеренно узким. OpenAI опубликовала только кодирование, биологию и кибербезопасность, удержав SWE-bench, GDPval, математику и цифры галлюцинаций[1].
gpt 5.6 sol vs terra vs luna
GPT-5.6 преемник GPT-5.5, полностью переученной агентной модели из апреля 2026 года. Если GPT-5.5 была одной моделью с уровнями усилий рассуждения, то GPT-5.6 — это семейство трёх уровней под одним номером поколения. Формулировка OpenAI явна: номер определяет поколение, а Sol, Terra и Luna определяют прочные функциональные уровни, которые могут развиваться независимо[1].
Это предложение — самое значимое решение в области проектирования этого выпуска. Оно разделяет «насколько умно» от «насколько ново». Будущее поколение могло бы выпустить новый Luna без изменения Sol, и обновление Sol не заставляет всех на Terra переоценивать свои пайплайны.
| Уровень | Позиционирование |
|---|---|
| GPT-5.6 Sol | Флагман для сложной профессиональной работы; оценивайте, когда трудные задачи оправдывают повышенную цену |
| GPT-5.6 Terra | Баланс интеллекта и стоимости; оценивайте, когда Luna не отвечает требованиям задачи |
| GPT-5.6 Luna | Быстрая и доступная модель для обычных задач большого объёма |
gpt 5.6 context window
OpenAI теперь документирует одинаковые пределы для трёх уровней GPT-5.6: 1,050,000 токенов общего окна контекста, 922,000 входных токенов максимум и 128,000 выходных токенов максимум. Потолок входа не равен общему окну контекста. Каждая модель принимает текст и изображения, а выдаёт текст; страницы моделей перечисляют потоковую передачу, структурированный вывод и вызовы функций. Списки инструментов на стороне провайдера явно относятся к Responses API, поэтому не гарантируют те же инструменты у любого совместимого эндпоинта.[3][4][5]
Все три поддерживают none, low, medium, high, xhigh и max, с medium по умолчанию. Текущие справочники не перечисляют minimal или ultra как значения усилия. Токены рассуждения занимают контекст и оплачиваются как выход; лимит выхода должен покрывать и скрытое рассуждение, и видимый ответ.[6]
Terminal-Bench 2.1 и четыре звёздочки
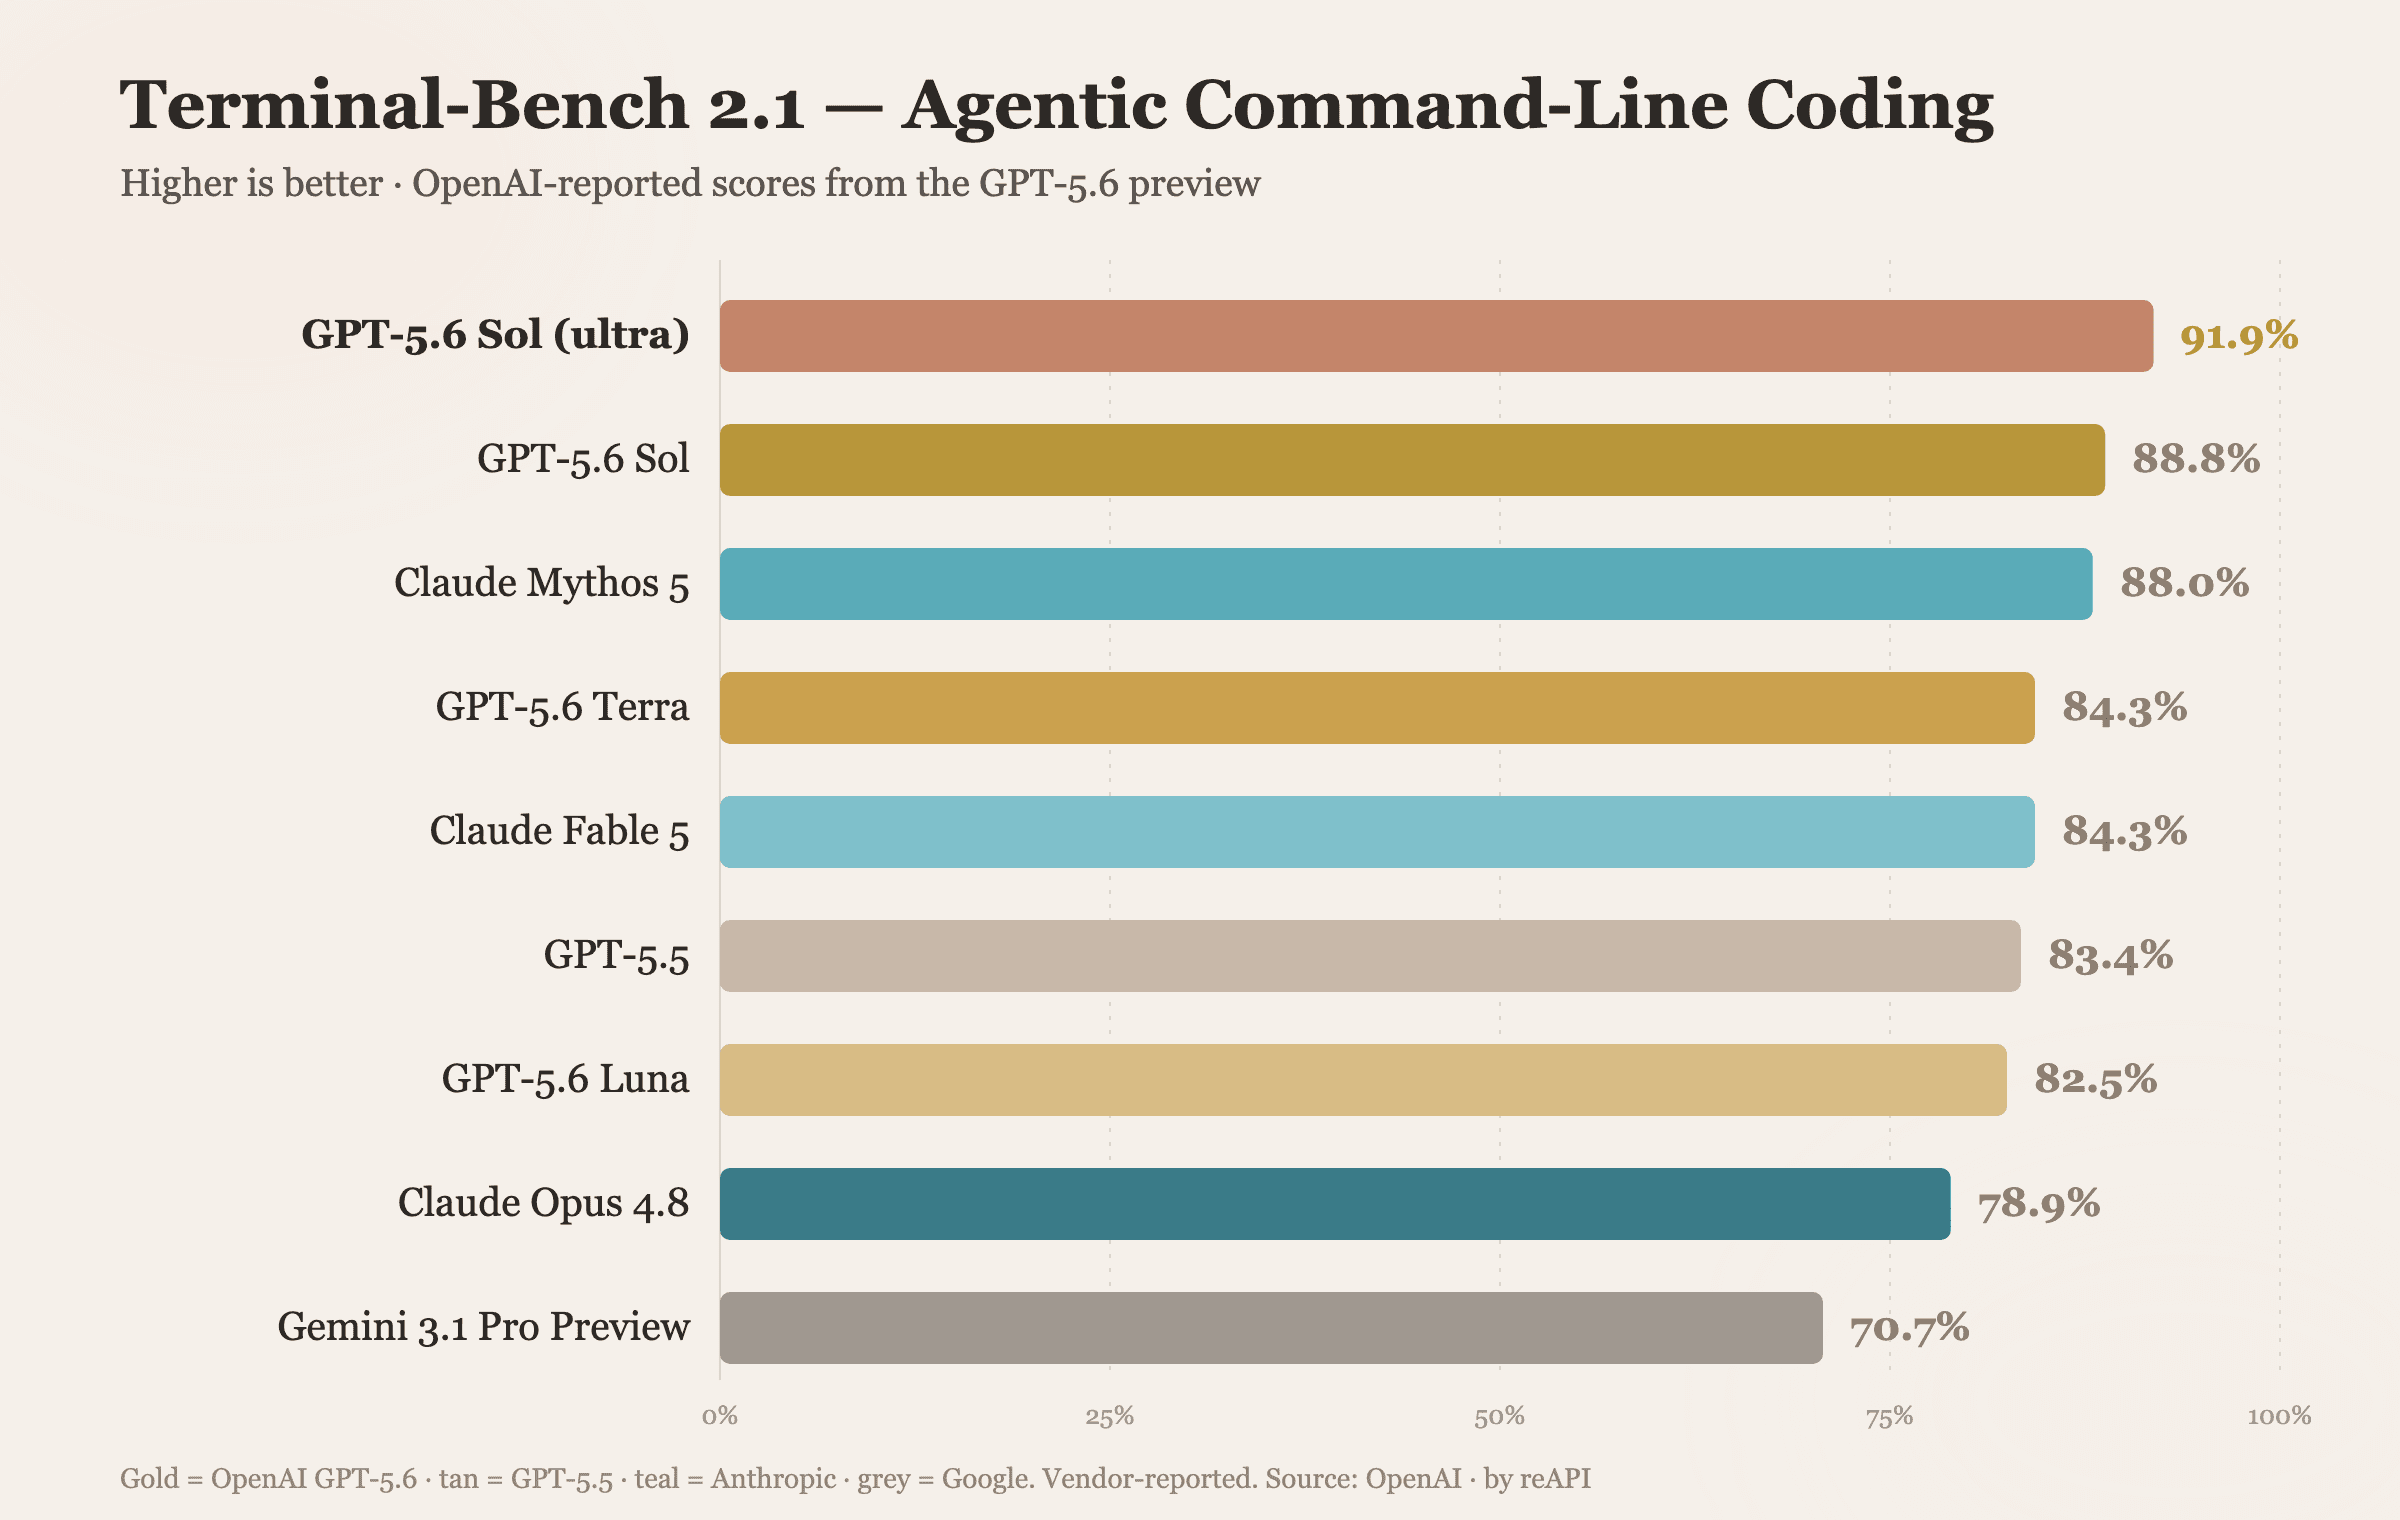
OpenAI опубликовала только три области бенчмарков в превью: кодирование, биология и кибербезопасность, явно удержав остальное до общей доступности[1]. Тот, на который она хочет, чтобы вы обратили внимание — это Terminal-Bench 2.1, который тестирует агентные рабочие потоки командной строки, требующие планирования, итерации и координации инструментов.
| Модель | Terminal-Bench 2.1 |
|---|---|
GPT-5.6 Sol (режим ultra) | 91,9% |
| GPT-5.6 Sol | 88,8% |
| Claude Mythos 5 | 88,0% |
| GPT-5.6 Terra | 84,3% |
| Claude Fable 5 | 84,3% |
| GPT-5.5 | 83,4% |
| GPT-5.6 Luna | 82,5% |
| Claude Opus 4.8 | 78,9% |
| Gemini 3.1 Pro Preview | 70,7% |
Читайте внимательно: эта таблица честнее, чем заголовок «новое состояние искусства» предполагает, четырьмя способами[1].
Рекорд 91,9% использует ultra, который не является одним агентом. Он исходит из Sol, оркеструющего подагентов. Против одноагентных базовых значений это не яблоки к яблокам. Справедливое сравнение — 88,8% Sol.
Одноагентный Sol опережает Claude Mythos 5 на 0,8 пункта. Два прогона одной и той же модели могут различаться больше, чем на это. OpenAI держит настоящее преимущество в верхней части кривой кодирования, но на этом бенчмарке оно узкое, не крайнее.
Terra равна Claude Fable 5 и немного опережает GPT-5.5. Результат 84.3% точно совпадает с Fable 5 и менее чем на пункт выше заменяемой модели. Вместе со снижением цены это и есть конкретный коммерческий смысл: похожий опубликованный результат Terminal-Bench при меньшей стартовой цене, а не доказательство равной способности программировать в любых задачах.
Gemini 3.1 Pro Preview отстаёт примерно на 21 пункт. Этот разрыв реален, но специфичен для бенчмарка. Gemini лидирует в других местах по долгоконтекстному поиску и мультимодальной работе, не показанной здесь.
По биологии OpenAI сообщает, что Sol достигает более сильных результатов GeneBench v1, чем GPT-5.5, использую меньше токенов, не публикуя сырые числа, так что это направленное утверждение, а не проверяемая оценка[1].
max и ultra
В сравнении при запуске использовались max и многоагентная настройка оценки ultra. Для текущей интеграции отделяйте историческое название от документированного контракта параметров: max поддерживают Sol, Terra и Luna, а ultra не входит в их шесть текущих значений усилия рассуждения.[3][4][5]
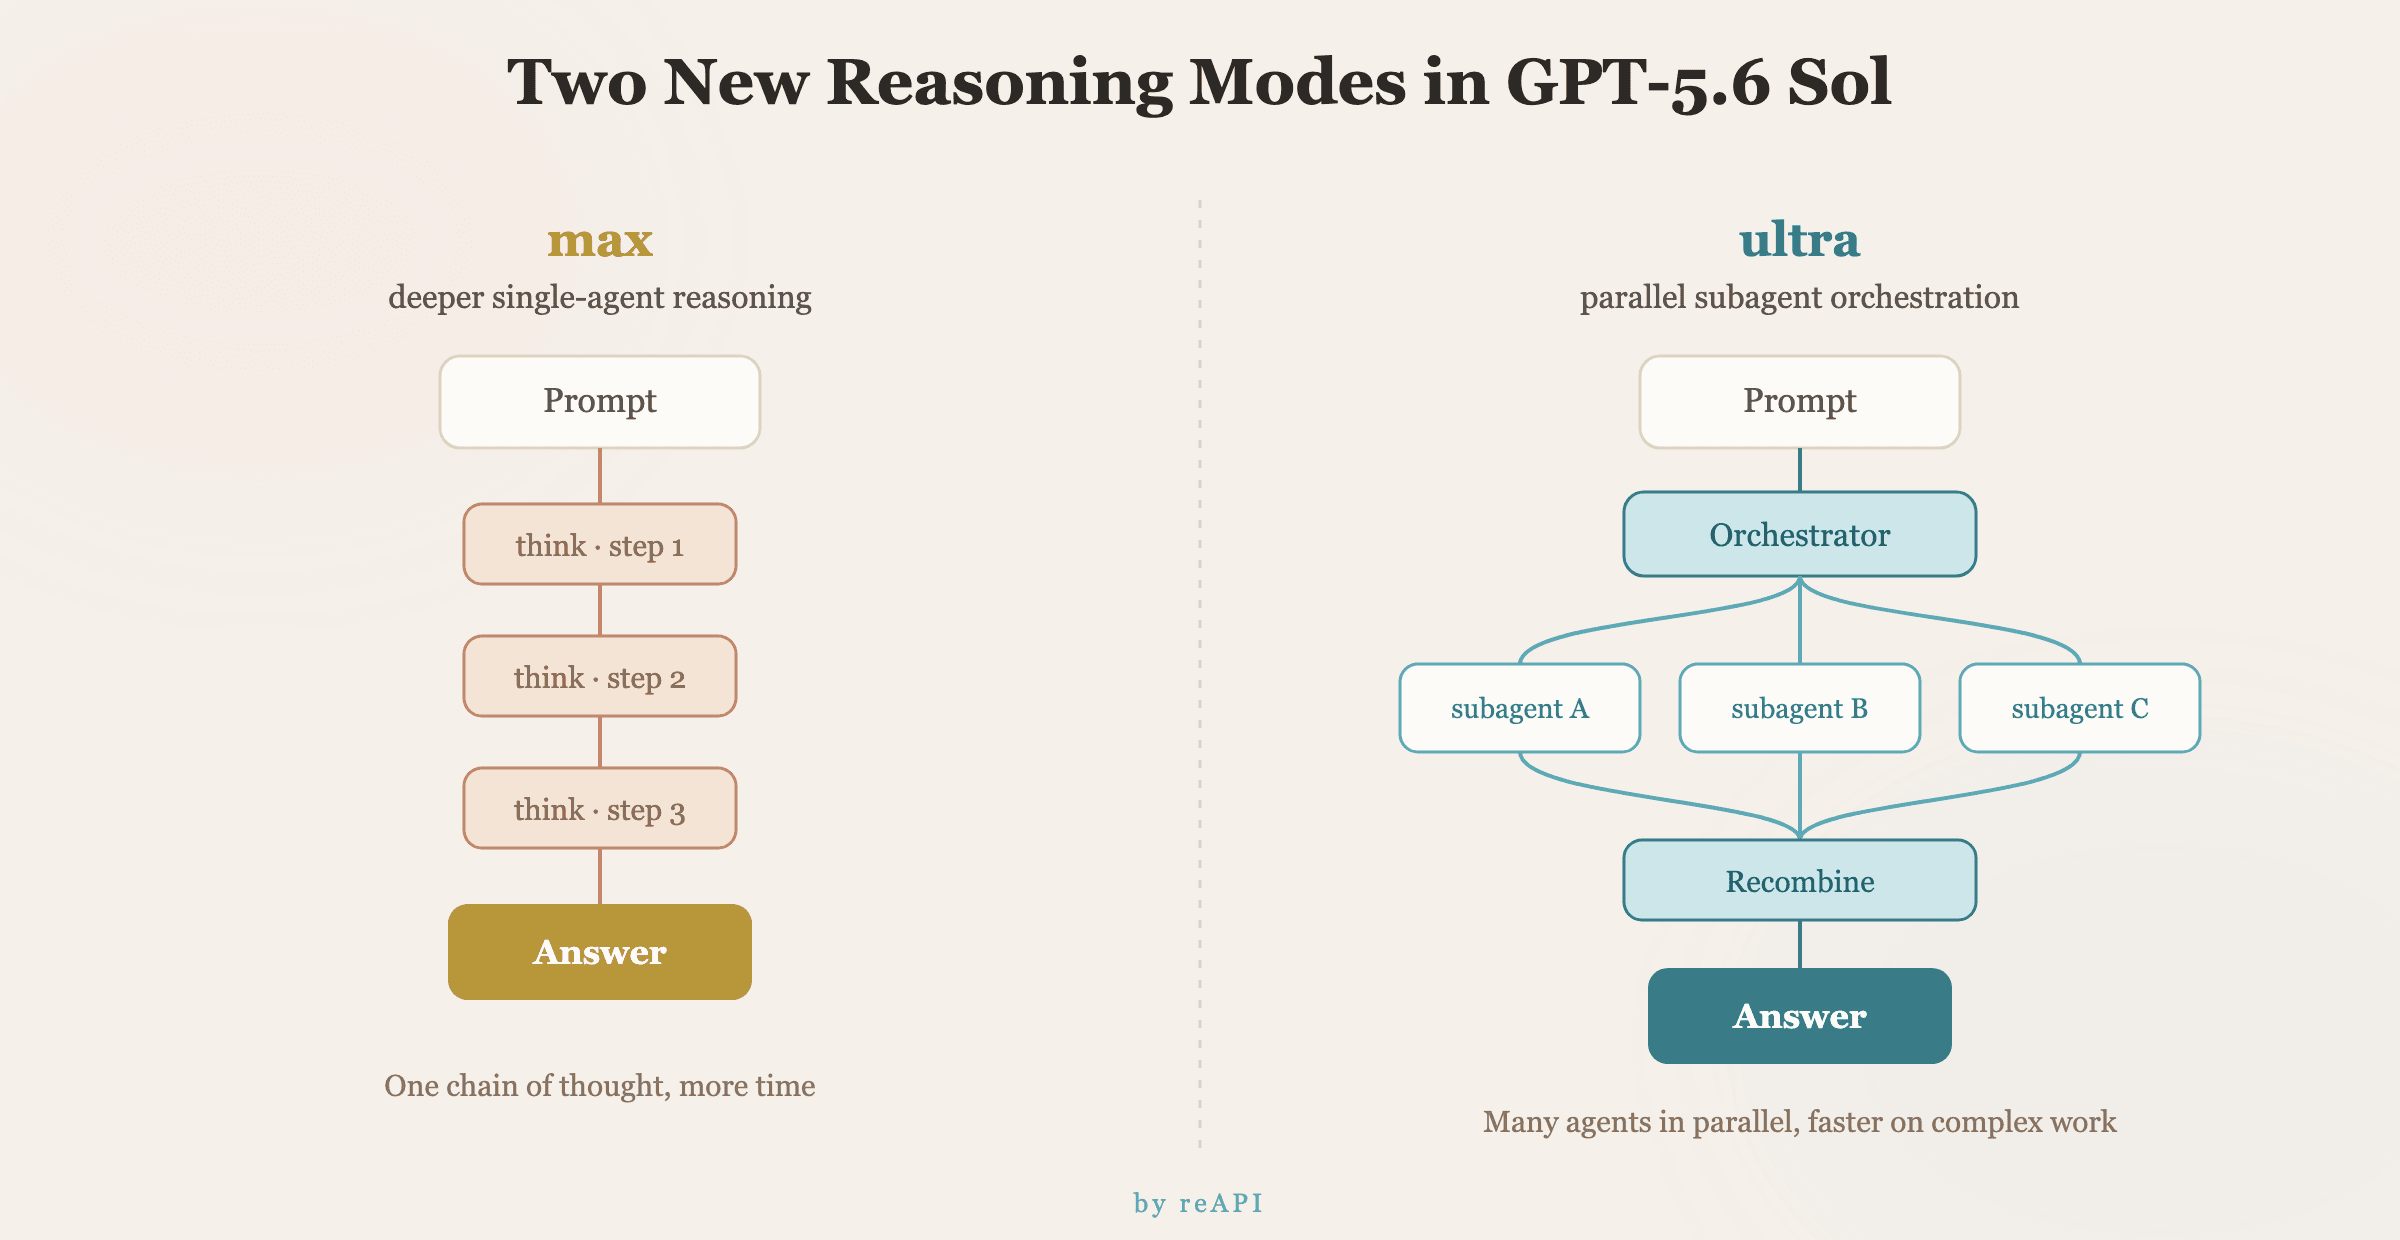
Иллюстрация описывает сравнение при запуске. Результат ultra использует подагентов и не сопоставим напрямую с одноагентным результатом. Он не подтверждает доступный для вызова параметр ultra или встроенную оркестрацию через reAPI.
Текущий OpenAI Responses API документирует независимые усилие рассуждения и режим рассуждения. reasoning.mode выбирает standard или pro; режим Pro выполняет больше модельной работы и тарифицирует полученные токены по стандартным ставкам этой модели. Поэтому он может стоить дороже и без другой цены за токен. Для GPT-5.6 в обоих режимах усилие по умолчанию — medium.[6]
Публичный маршрут reAPI для этих моделей — Chat Completions. Он предоставляет reasoning_effort; не предполагайте, что копирование полей в этот запрос включит режим OpenAI только для Responses, сохранённое рассуждение или функции размещённых у провайдера агентов.
gpt 5.6 pricing
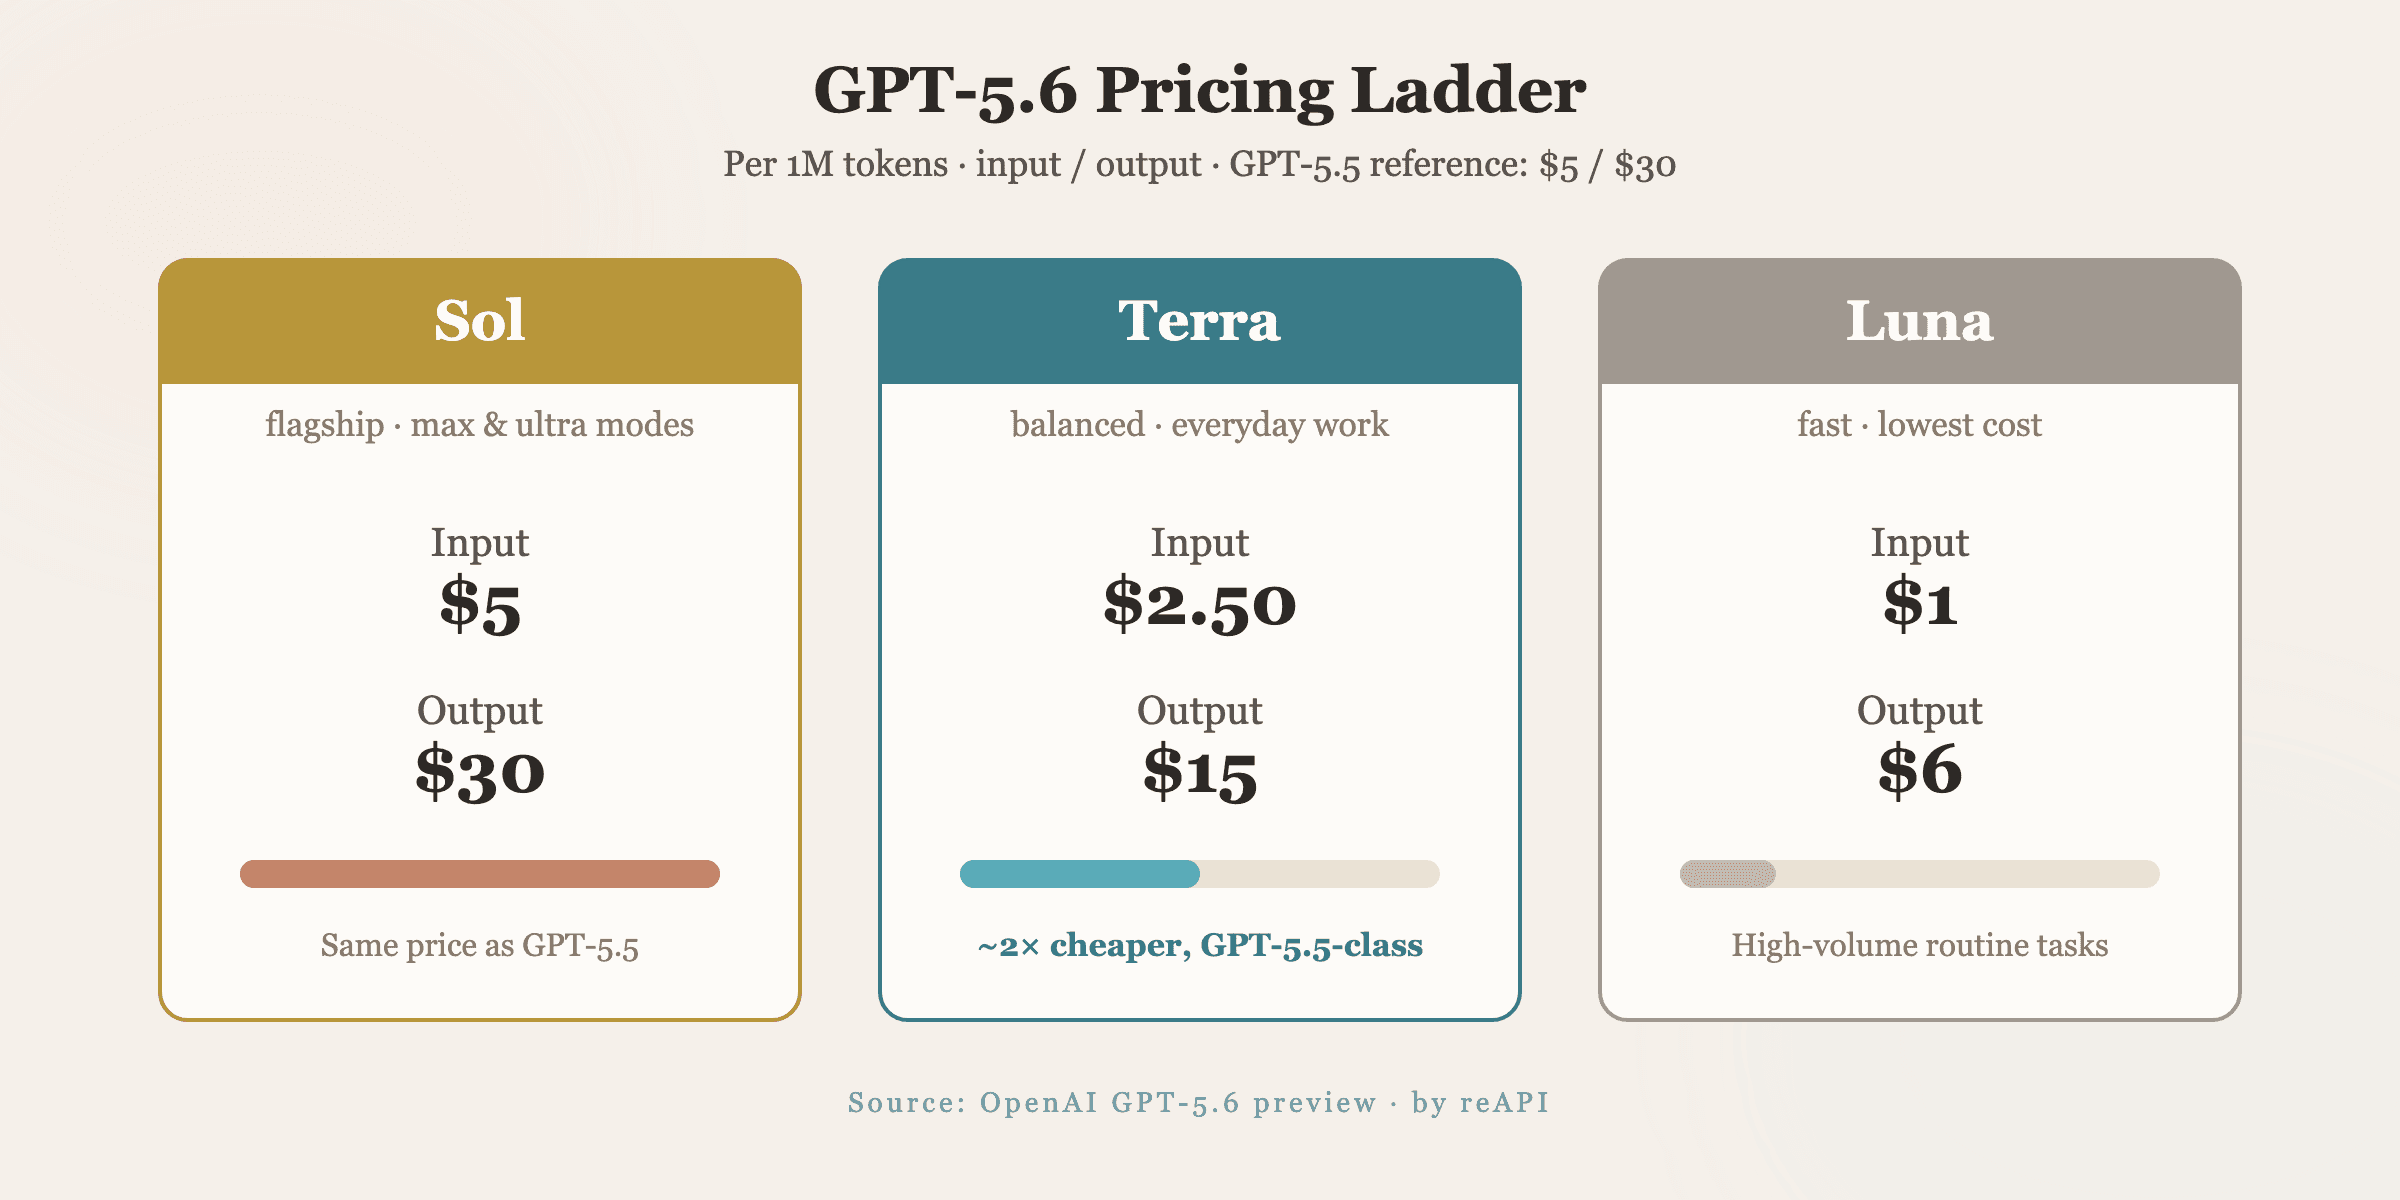
Изображение сохраняет стартовые цены. Текущие столбцы ниже — это цены входа/выхода для короткого контекста за миллион токенов, а не универсальные ставки для любого размера запроса и режима обработки.[2][8]
| Уровень | Стартовая цена OpenAI (вход / выход за 1M) | OpenAI Standard, 23 октября 2026 | В reAPI, 23 октября 2026 |
|---|---|---|---|
| GPT-5.6 Sol | $5 / $30 | $4 / $20 | $3.20 / $16.00 |
| GPT-5.6 Terra | $2.50 / $15 | $2 / $12 | $1.60 / $9.60 |
| GPT-5.6 Luna | $1 / $6 | $0.20 / $1.20 | $0.16 / $0.96 |
В стартовых цифрах OpenAI выделялись два момента. Sol сохранила точные $5 / $30 GPT-5.5, добавив возможности и новые режимы — редкий случай большего за ту же сумму. Terra сообщила похожий на GPT-5.5 результат стартового Terminal-Bench при меньших стартовых ценах, что делало её достойной оценки[1]. С учётом эффективности Sol, достигающей сопоставимых результатов с меньшим количеством выходных токенов, фактическое снижение стоимости задачи больше, чем предполагают одни ставки.
OpenAI с тех пор снизила все три цены; ставка Sol акционная и, по её словам, действует как минимум до 21 ноября 2026 года[2]. Теперь Sol стоит меньше $5 / $30 GPT-5.5. Текущие ставки входа/выхода reAPI для короткого контекста составляют 80% OpenAI Standard, но соотношения уровней изменились: $0.20/$1.20 Luna — десятая часть $2/$12 Terra, тогда как стартовые цены не имели такого отношения. Ноябрьская дата Sol — минимальный период акции, а не гарантированное подорожание на следующий день. Выбирайте самый дешёвый уровень, удовлетворяющий измеренному требованию качества, вместо автоматического выбора Terra.
При более чем 272K входных токенов OpenAI взимает 2x за вход и 1.5x за выход всего запроса, а не только токенов сверх порога. Текущие ставки Standard для кеша и длинного контекста таковы:[2]
| Уровень | Короткий кеш: чтение / запись 30m / запись 12h | Длинный вход / выход | Длинный кеш: чтение / запись 30m / запись 12h |
|---|---|---|---|
| GPT-5.6 Sol | $0.40 / $5.00 / $10.00 | $8.00 / $30.00 | $0.80 / $10.00 / $20.00 |
| GPT-5.6 Terra | $0.20 / $2.50 / $5.00 | $4.00 / $18.00 | $0.40 / $5.00 / $10.00 |
| GPT-5.6 Luna | $0.02 / $0.25 / $0.50 | $0.40 / $1.80 | $0.04 / $0.50 / $1.00 |
OpenAI поддерживает неявное и явное кеширование. Запись по умолчанию на 30 минут стоит 1.25x обычного входа; Responses API также предлагает минимум 12 часов за 2.5x. Это полные ставки записи, а не надбавки поверх обычного входа. Чтение для трёх моделей стоит 0.1x. Минимальный кешируемый префикс — 1,024 токена. Настройка 12 часов задаёт минимальное время жизни, а не срок удаления.[7]
Для примера с 20,000 некешированных входных токенов и 5,000 оплачиваемых выходных стоимость OpenAI Standard равна (20,000 × input rate + 5,000 × output rate) / 1,000,000: Sol $0.18, Terra $0.10, Luna $0.01. Цены короткого входа/выхода reAPI дают соответственно $0.144, $0.08 и $0.008. Фиксированные количества включают рассуждение в оплачиваемом выходе и исключают инструменты, налоги и операции кеша; это расчёты, а не измеренные затраты на завершение задач.
При 300,000 некешированных входных токенов и 5,000 оплачиваемых выходных длинные ставки OpenAI для всего запроса дают Sol $2.55, Terra $1.29 и Luna $0.129. Более низкие короткие ставки уже не применяются. Для кешированных запросов разделяйте обычный вход, чтения и записи кеша перед умножением на соответствующие ставки; повторный учёт кешированных токенов как обычного входа завысит счёт.
Отрисованные цены длинного входа/выхода reAPI 23 октября составляли Sol $6.40/$24.00, Terra $3.20/$14.50, Luna $0.320/$1.440 за миллион токенов. Показанная ставка длинного выхода Terra равна $14.50, поэтому утверждение «80% для всех ставок» было бы неточным. Проверяйте точную категорию на странице модели; эта таблица не обещает выбора сроков кеша OpenAI через reAPI.[8]
Цифры OpenAI выше относятся к обработке Standard и исключают отдельно оплачиваемые инструменты и региональные надбавки. Batch, Flex и режим Fast имеют отдельные таблицы цен; не сравнивайте альтернативный режим одной модели со Standard другой так, будто условия обслуживания одинаковы.[2]
Проверка, которая сформировала развёртывание
Эта часть стоит понимать даже теперь, когда доступ открыт, потому что это прецедент, а не сноска.
OpenAI ограничила начальный выпуск примерно двадцатью проверенными партнёрами по запросу правительства США после предварительного просмотра возможностей моделей перед запуском[1]. Триггер был функциональностью кибербезопасности. Sol значительно продвигает исследование уязвимостей и в оценках, участвующих Chromium и Firefox, он определил ошибки и примитивы эксплуатации, строительные блоки эксплуатации, без автономного создания функционального полного цепного эксплуатационного кода при протестированных условиях. OpenAI заявляет, что Sol не пересекает порог Cyber Critical в своем Preparedness Framework, и это различие — вся основа для его выпуска[1].
Примечательно, что OpenAI не поддержала договоренность как постоянную, сказав, что этот вид процесса доступа правительства не должен становиться долгосрочным по умолчанию, потому что он удерживает лучшие инструменты от защитников, которые им нужны[1].
Стек безопасности, поставляемый вместе с ней, стоит узнать, потому что он предварительно просматривает, как модели высокой способности будут вообще поставляться: обученные отказы, классификаторы киберугроз и биологии в реальном времени, которые могут приостановить генерацию на рассмотрение более крупной модели, проверка активности на уровне аккаунта и дифференцированный доступ к наиболее конфиденциальным возможностям. OpenAI посвятила более 700 000 часов GPU A100-эквивалента автоматизированному красному командованию для универсальных jailbreak'ов[1].
OpenAI откровенна, что эти гарды давят неверно: законные исследователи безопасности могут столкнуться с отказами на двойного использования запросах.
Где аргумент сильный и где он слабый
Сильные стороны. Агентное программирование в командной строке, где одноагентная Sol лидирует в тесте, а ultra повышает результат. Эффективность токенов, накапливающая эффект у агентов с большим объёмом работы. Выгода среднего уровня, где снижение цены Terra — наиболее широко полезное изменение запуска. Стартовый результат ultra включает многоагентную оркестрацию; его следует читать как настройку оценки, а не обещание текущей функции reAPI[1].
Слабый. Заголовок — это победа на 0,8 пункта на одном бенчмарке. Окно оценки было намеренно мало, без опубликованных цифр SWE-bench, GDPval, математики или галлюцинаций, поэтому решила ли GPT-5.6 проблему уверенных галлюцинаций, которая преследовала GPT-5.5, остаётся неизвестным. И всё поставщик-сообщено под собственной шлейфом OpenAI[1].
До расширенного люка и независимой оценки, суждение по общей способности должно остаться зарезервированным.
Как использовать GPT-5.6: какой уровень выбрать
Luna для больших объёмов обычных задач с ограниченным бюджетом, если проходит ваши проверки. Начните с репрезентативных задач классификации, извлечения данных или коротких ответов и фиксируйте принятые результаты, повторные попытки и усилия проверки. Низкая цена токена полезна только при соответствии результата требованиям задачи.
Terra, когда дополнительные возможности улучшают результат достаточно для оправдания цены. Сравнивайте на реальных ошибках Luna вместо предположения, что каждому производственному запросу нужен средний уровень. Стартовый тест программирования даёт сведения о конкретной оценке, а не доказывает равные возможности на любой задаче.
Sol для сложной профессиональной работы, где улучшение покрывает дополнительные расходы. Проверяйте сложное программирование и длинные задачи с одинаковыми инструментами и критериями приёмки. Все три уровня поддерживают max; ни большее усилие, ни большее окно контекста не являются исключительными для Sol. Не выбирайте уровень reAPI в предположении, что ultra поддерживается как значение запроса.
Вызов GPT-5.6 на reAPI
Все три уровня зарегистрированы на совместимом с OpenAI эндпоинте reAPI https://reapi.ai/api/v1/chat/completions. Используйте ключ текущего рабочего пространства reAPI и точный идентификатор с суффиксом, сохраняя точки OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

resp = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[{"role": "user", "content": "Refactor this module and add tests."}],
    max_tokens=16000,
    stream=True,
)
Замените gpt-5.6-terra на gpt-5.6-sol или gpt-5.6-luna, чтобы сравнить уровни в том же формате Chat Completions. OpenAI документирует простой псевдоним gpt-5.6, но текущая регистрация reAPI использует три ID с суффиксами; здесь нужны именно эти строки. Настроенный предел выхода reAPI — 128,000 токенов для каждой модели, а документированные усилия — none, low, medium, high, xhigh и max.[8]
OpenAI поддерживает Chat Completions и Responses для этого семейства и рекомендует Responses для процессов рассуждения. reAPI не публикует маршрут /v1/responses. Передача параметров не устанавливает равенство функций: не предполагайте, что этот Chat-эндпоинт воспроизводит набор инструментов OpenAI на стороне провайдера, режим Pro или контракт сохранённого рассуждения. Связанные справочники reAPI описывают интеграцию; для обновления статьи генерация в production не выполнялась.[6][8]
Текущие тарифы находятся на reapi.ai/models/gpt-5-6-sol, reapi.ai/models/gpt-5-6-terra и reapi.ai/models/gpt-5-6-luna.
FAQ
Какова разница между режимами max и ultra?
max — текущее значение усилия рассуждения на всех трёх уровнях GPT-5.6. Исторический результат ultra использовал подагентов и дал заголовочный показатель 91.9% Terminal-Bench; это не одно из шести текущих значений усилия. Отдельный reasoning.mode: "pro" OpenAI относится к Responses и не должен смешиваться с полем ultra или функцией Chat reAPI.[1][3][6]
Является ли GPT-5.6 Sol лучше, чем Claude для кодирования?
На Terminal-Bench 2.1 одноагентный Sol при 88,8% опережает Claude Mythos 5 при 88,0% на 0,8 пункта, реальное, но узкое преимущество. С ultra Sol достигает 91,9%, но это использует подагентов и не является прямым одноагентным сравнением[1].
Какой уровень GPT-5.6 я должен использовать?
Оценивайте Luna для обычных задач большого объёма, Terra — когда Luna не отвечает требованиям, Sol — для сложной работы, где качество оправдывает затраты. У всех трёх одинаковые документированные окно контекста, потолок выхода и ступени усилия; выбирайте по стоимости принятой задачи и собственным тестам, а не по предполагаемой интеграции ultra.
Почему правительство США участвовало в выпуске?
Sol значительно продвигает функциональность кибербезопасности, включая исследование уязвимостей, не пересекая порог Cyber Critical OpenAI. По запросу правительства OpenAI провела поэтапный превью примерно двадцати проверенным партнёрам, пока была разработана киберрамка[1].
Решает ли GPT-5.6 проблему галлюцинаций GPT-5.5?
Неизвестно. OpenAI опубликовала только оценки кодирования, биологии и кибербезопасности в превью и удержала цифры галлюцинаций и знаний[1]. Используйте модель с верификацией, заземлённой на источнике, для высокорисковых результатов.
Насколько велико контекстное окно GPT-5.6 Sol?
OpenAI теперь документирует общее окно контекста 1,050,000 токенов, максимум 922,000 входных и 128,000 выходных токенов. Terra и Luna имеют те же пределы. Старое сообщение о 1.5 миллиона токенов не является текущей официальной спецификацией.[3][4][5]
Что изменилось в кешировании промпта?
OpenAI поддерживает неявное кеширование и явные точки разделения кеша, с записью по умолчанию на 30 минут за 1.25x обычного входа и дополнительным минимумом 12 часов в Responses API за 2.5x. Чтения для этих трёх моделей стоят 0.1x. Ставки записи полные, а минимальное время жизни не является сроком удаления; Chat-маршрут reAPI не обещает те же настраиваемые параметры кеша.[7]
Как я вызываю GPT-5.6 с OpenAI SDK?
Направьте клиент OpenAI на https://reapi.ai/api/v1, используйте ключ рабочего пространства reAPI и задайте model как gpt-5.6-sol, gpt-5.6-terra или gpt-5.6-luna. Сохраните точки и суффикс уровня; простой псевдоним OpenAI здесь не зарегистрирован.[8]
Чтение трёхуровневого выпуска
GPT-5.6 объединяет два выпуска в одном анонсе. Первый — обычное качественное обновление семейства: разумная смена названий, средний уровень с меньшими стартовыми ценами и похожим на GPT-5.5 опубликованным результатом Terminal-Bench, а также стартовый тест ultra с многоагентной оркестрацией. Второй — передовая модель, чью начальную доступность согласовывали с государством и выпустили с системой безопасности, потребовавшей 700,000 GPU-часов.
Для текущей интеграции начните с самого дешёвого уровня, проходящего проверки, заложите в бюджет рассуждение и порог длинного контекста и проверьте нужные функции API. Стартовый тест остаётся полезным историческим свидетельством, но текущие справочники моделей и ценовые условия определяют, что запрашивать и как планировать бюджет.
Для сравнения поколений прочитайте GPT-6 Sol vs Luna и GPT-6 Luna vs GPT-5.6 Luna. Эти статьи отвечают на вопрос миграции к GPT-6; здесь выбор между тремя уровнями GPT-5.6 рассматривается отдельно.
References
-
OpenAI. Models — семейство GPT-5.6, режимы рассуждения и спецификации. Получено в июле 2026 г. из platform.openai.com/docs/models
-
OpenAI. Цены: ставки за токен по модели и уровню. Получено в июле 2026 года и повторно проверено 23 октября 2026 года. https://developers.openai.com/api/docs/pricing
-
OpenAI. Справочник модели GPT-5.6 Sol. Проверено 23 октября 2026 года. https://developers.openai.com/api/docs/models/gpt-5.6-sol
-
OpenAI. Справочник модели GPT-5.6 Terra. Проверено 23 октября 2026 года. https://developers.openai.com/api/docs/models/gpt-5.6-terra
-
OpenAI. Справочник модели GPT-5.6 Luna. Проверено 23 октября 2026 года. https://developers.openai.com/api/docs/models/gpt-5.6-luna
-
OpenAI. Модели рассуждения: усилие, режим и учёт токенов. Проверено 23 октября 2026 года. https://developers.openai.com/api/docs/guides/reasoning
-
OpenAI. Кеширование запросов: минимальное время жизни и цены записи/чтения. Проверено 23 октября 2026 года. https://developers.openai.com/api/docs/guides/prompt-caching
-
reAPI. Отрисованные цены страниц моделей и справочники эндпоинтов, проверено 23 октября 2026 года. https://reapi.ai/models/gpt-5-6-sol — https://reapi.ai/models/gpt-5-6-terra — https://reapi.ai/models/gpt-5-6-luna — https://reapi.ai/docs/gpt-5-6-sol — https://reapi.ai/docs/gpt-5-6-terra — https://reapi.ai/docs/gpt-5-6-luna
Further reading
- reAPI. Как использовать Claude Opus 5. reapi.ai/blog/how-to-use-claude-opus-5
- reAPI. Как использовать Claude Fable 5. reapi.ai/blog/how-to-use-claude-fable-5
- reAPI. Каталог моделей. reapi.ai/models
Автор

Категории
max и ultragpt 5.6 pricingПроверка, которая сформировала развёртываниеГде аргумент сильный и где он слабыйКак использовать GPT-5.6: какой уровень выбратьВызов GPT-5.6 на reAPIFAQКакова разница между режимами max и ultra?Является ли GPT-5.6 Sol лучше, чем Claude для кодирования?Какой уровень GPT-5.6 я должен использовать?Почему правительство США участвовало в выпуске?Решает ли GPT-5.6 проблему галлюцинаций GPT-5.5?Насколько велико контекстное окно GPT-5.6 Sol?Что изменилось в кешировании промпта?Как я вызываю GPT-5.6 с OpenAI SDK?Чтение трёхуровневого выпускаReferencesFurther readingЕщё статьи
DeepSeek V4 с контекстом 1М: max_tokens, биллинг и паралелизм
DeepSeek V4 делит контекст 1М между входом и выходом с максимумом 384К на выход. Разберись с max_tokens, кешированием и лимитами параллелизма.
MiniMax H3 против Seedance 2.5: какую модель видео выбрать?
Сравни MiniMax H3 и Seedance 2.5 по продолжительности, выводу 2K, встроенному аудио, ссылкам, редактированию, ценам, доступу API и применению.
Генерация изображений для игр: кэширование для экономии
Постройте конвейер генерации изображений с кэшем, семантическими ключами, одиночными запросами, асинхронным опросом, лимитами бюджета и долговечным хранилищем.