· reAPI Team
Gemini 4 Argon vs Opus 5.5: 화제가 된 테스트에 반론이 나온 이유
Gemini 4 Argon vs Opus 5.5 젤리 곰 테스트는 왜 반론을 불렀을까요? 원본 시연, 재현했다는 게시물, 제작자의 답변을 살펴보며 코딩 비교의 근거와 아직 확인되지 않은 조건을 정리합니다.
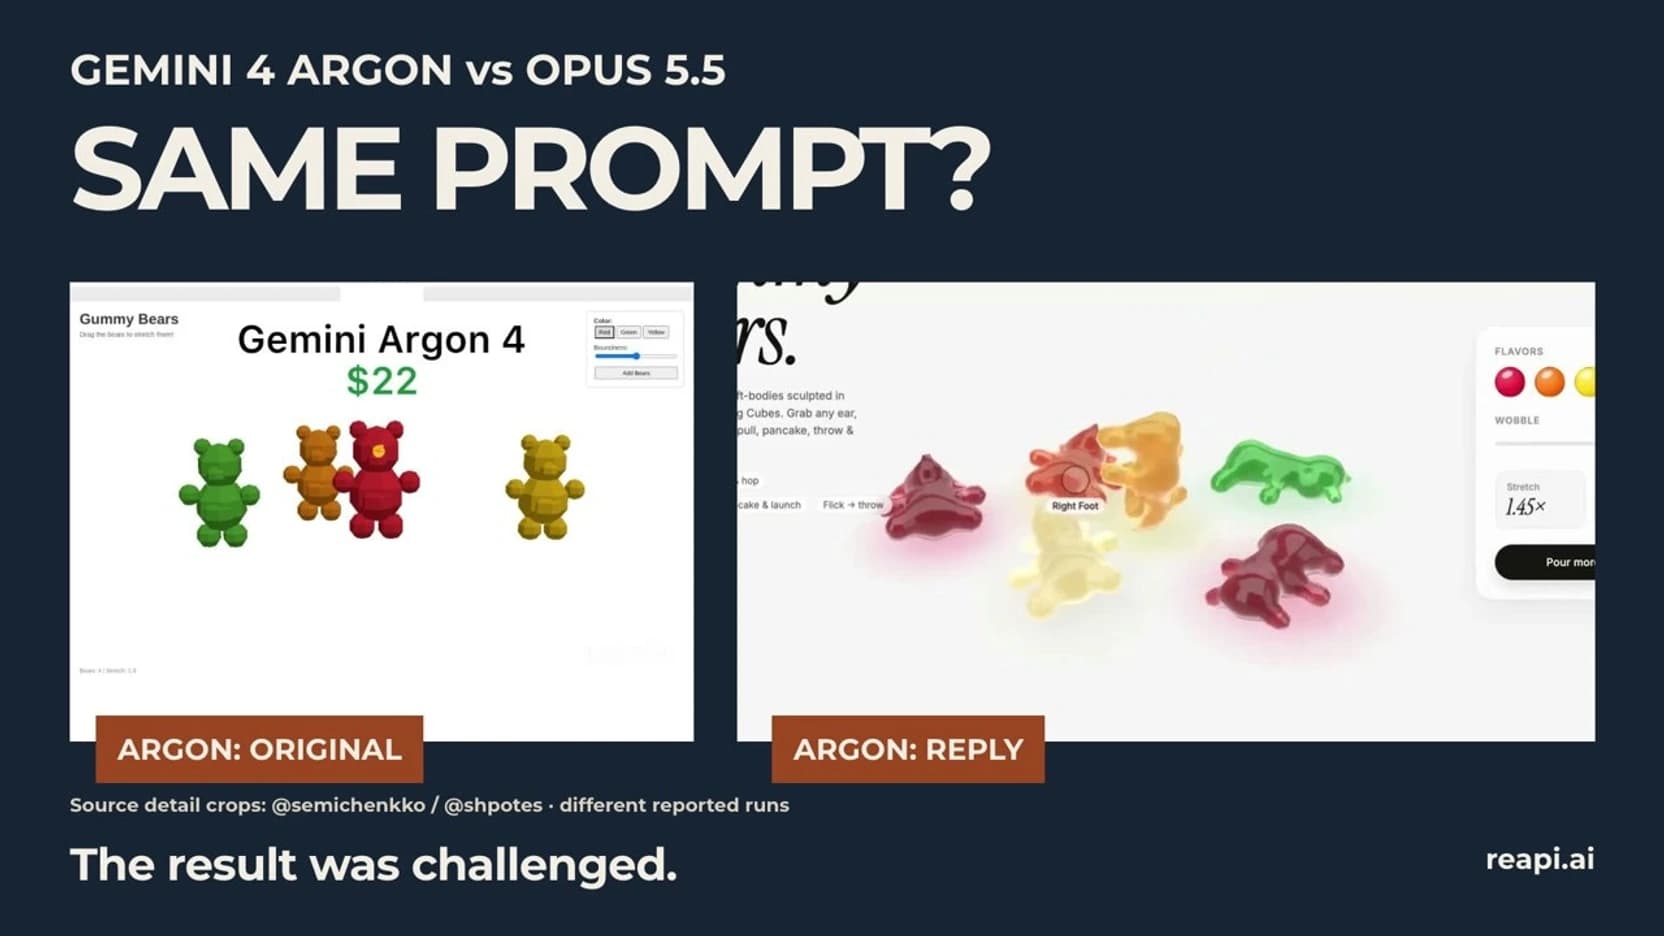
젤리 곰 시뮬레이션 하나가 Gemini 4 Argon vs Opus 5.5 비교를 코딩 시연으로 어디까지 입증할 수 있는지에 관한 논쟁으로 바꿨습니다. Semichenko가 올린 비교에서는 Claude Opus 5.5로 표시된 결과가 Gemini 4 Argon(제미나이 4 아르곤)으로 표시된 결과보다 더 그럴듯하게 늘어나고 눌렸습니다. 제작자는 두 모델에 같은 프롬프트를 입력했다고 밝혔습니다[1]. 이후 다른 개발자가 눈에 띄게 다른 Argon 결과를 게시했고, 역시 같은 프롬프트를 사용했다고 설명했습니다[2].
후속 반응은 최초 영상만큼 중요합니다. Semichenko는 Gemini 실행이 실패했을 가능성을 인정하며 추가 테스트가 필요하다고 말했습니다[3]. 공개된 게시물은 특정 결과를 둘러싼 의견 차이를 보여줍니다. 모델 전반의 순위까지 정해 주지는 않습니다. 이 글에서는 관련 근거와 제작자의 답변을 정리하고, 다음 비교를 판단할 때 사용할 수 있는 방법을 제안합니다.
핵심 요약
- Semichenko의 원본 게시물은 조작 가능한 젤리 곰 시뮬레이션 두 개를 보여 주며 같은 프롬프트를 썼다고 설명합니다. 큰 시각적 차이는 제작자가 보고한 해당 실행 결과 사이의 차이입니다[1].
- @shpotes는 Antigravity에서 Argon을 사용해 다른 결과를 얻었다고 보고했습니다. 이 사례는 첫 영상만으로 Argon의 한계를 알 수 있다는 추론에 의문을 제기합니다[2].
- 원본 제작자는 Gemini 실행이 실패했을 가능성을 명시적으로 인정하고 더 많은 테스트가 필요하다고 밝혔습니다[3].
- 다른 답변에서는 다음 비교 때 각 모델을 세 번씩 실행한 뒤 가장 좋은 결과를 고르자고 제안했습니다. 이는 방법에 대한 제안이며, 그 방식으로 재실험을 마쳤다는 뜻은 아닙니다[4].
- 함께 제공하는 영상은 이러한 제삼자의 사례를 살펴봅니다. reAPI는 조건을 통제한 새 벤치마크를 수행하지 않았으며, 전체 실행 환경이나 보고된 비용을 독립적으로 검증하지도 않았습니다[5].
원본 비교와 후속 반응을 영상으로 보기
당사의 2분 18초 영상은 원본 시연, 재현했다고 보고한 사례, 제작자의 답변을 순서대로 다룹니다. 이 글을 보완하는 영상이며, 설명란에 출처를 표시했습니다[5].
0:19의 원본 시연, 0:46의 재현 보고 사례, 1:11의 제작자 답변으로 바로 이동할 수 있습니다.
영상에 등장하는 것은 코드로 만든 대화형 시뮬레이션입니다. 코딩 과제로 평가해야 합니다. 완성된 애니메이션을 녹화했다고 해서 텍스트를 영상으로 만드는 모델 간 비교가 되지는 않습니다. 위 표지는 이 영상의 썸네일입니다. 게시물에서 보고한 결과를 확인하려면 영상과 연결된 원본 게시물을 살펴보세요.
Gemini 4 Argon vs Opus 5.5 시연이 보여 준 것
원본 게시물은 Opus를 위쪽에, Argon을 아래쪽에 배치하고 당기기, 압축하기, 던지기, 곰 추가하기라는 일련의 동작을 설명합니다. 제작자의 비판에는 물체가 변형되는 방식, 물체끼리 상호작용하는 방식, 재질의 시각적 표현이 함께 포함되어 있습니다[1].
이 요소들은 나누어 살펴보는 것이 유용합니다. 이 과제라면 곰을 드래그할 때 형태가 바뀌는지, 놓으면 돌아오는지, 물체가 많아져도 사용할 수 있는지, 표면이 요청한 재질처럼 보이는지를 평가할 수 있습니다. 이는 권장하는 평가 기준이며, 당사가 원본 애플리케이션에서 수집한 측정 결과는 아닙니다.
기준을 나누면 보기 좋은 표면만으로 코딩 비교 전체의 승패를 결정하지 않을 수 있습니다. 한쪽의 조명 표현을 더 좋아하더라도 상호작용이 제대로 되는지는 따로 확인해야 합니다. 반대로 덜 다듬어진 외형의 물체도 기능 요구 사항을 만족할 수 있습니다. 어느 영상이 더 나은지 고르기 전에 중요한 요구 사항부터 정하세요.
제시된 결과를 평가하는 일과 그런 결과가 나온 이유를 설명하는 일도 다릅니다. 녹화 영상은 화면에 보이는 현상에 대한 제한적인 관찰을 뒷받침할 수 있습니다. 원인을 규명하려면 지시문, 생성된 프로젝트, 실행 이력, 설정이 필요합니다. 당사는 원본의 두 실행을 서로 대조할 수 있는 완전한 기록을 확보하지 못했으므로, 이 차이의 원인을 모델 하나로 좁힐 수 없습니다.
재현했다는 후속 게시물이 논쟁을 어떻게 바꿨나
@shpotes는 자신의 결과를 이렇게 설명했습니다(번역). “같은 프롬프트로 Argon + Antigravity에서 완전히 다른 결과를 얻었다.” 첨부된 시연에서는 Argon의 결과로 소개된 물체가 늘어나고 변형됩니다[2]. 첫 결과가 이 과제에서 Argon이 만들 수 있는 것을 대표하는지 시청자가 의문을 제기할 구체적인 이유를 제공합니다.
@Caxvalencia의 별도 게시물에는 “Argon - Medium”이라는 표시와 함께 또 다른 조작 예시가 담겨 있습니다[6]. 그 표시는 게시자가 보고한 설정입니다. 지시문, 시작 파일, 도구 호출 순서까지 같았다는 사실을 독립적으로 입증하지는 않습니다.
| 공개 기록 | 제공하는 정보 | 이 글에서 아직 검증하지 않은 부분 |
|---|---|---|
| Semichenko의 원본 비교 | 모델명이 표시된 두 결과의 눈에 보이는 차이와 같은 프롬프트를 썼다는 설명 | 두 실행을 대조할 수 있는 완전한 실행 기록 |
| @shpotes의 후속 게시물 | Antigravity에서 같은 프롬프트로 얻었다고 보고한 Argon 결과 | 전체 환경이 원본 비교와 같은지 여부 |
| @Caxvalencia의 예시 | Argon으로 표시되고 Medium 설정이 명시된 또 다른 조작 예시 | 모든 조건을 맞춘 재현 절차 |
| Semichenko의 답변 | 불확실성 인정과 세 번 중 최상의 결과를 고르자는 제안 | 그 제안에 따라 완료한 비교의 결과 |
출처: 원본 게시물과 답변[1][2][3][4][6].
원본 게시물에는 독자를 재현 사례로 안내하는 Community Note(커뮤니티 노트)도 달려 있습니다[1]. 해당 링크를 따라가 근거를 확인하세요. 노트는 추가 맥락을 제공하며, 그 안의 주장도 원자료와 대조해야 합니다.
후속 게시물의 설명을 그대로 받아들이면, Argon으로는 변형되는 곰을 만들 수 없다는 포괄적인 주장은 설득력이 약해집니다. 하지만 각 모델이 얼마나 자주 성공하는지, 어느 정도의 개입이 필요한지, 다른 코딩 과제에서 어느 쪽이 더 나은지는 알 수 없습니다. 강한 반례는 단정적인 주장에 이의를 제기할 수 있지만, 모델 전반의 순위를 정해 주지는 않습니다.
제작자의 답변도 함께 다뤄야 한다
Semichenko는 이렇게 썼습니다(번역). “음, 제 Gemini 실행이 실패했을 수도 있겠네요. 더 테스트해야겠습니다”[3]. 앞선 답변에서는 다른 테스트 참여자에게 감사를 전하고, 향후 비교에서 각 모델을 세 번씩 실행해 가장 좋은 결과를 쓰자고 제안했습니다[4].
이 답변은 논쟁의 범위를 좁혀 줍니다. 원본 영상의 차이가 사라진 것처럼 다룰 필요는 없으며, 이 게시물들만으로 기만 의도를 단정할 근거도 없습니다. 제작자는 해당 실행에 불확실성이 있음을 인정했습니다. 독자는 평가하려는 영상과 함께 그 인정도 확인해야 합니다.
세 번 중 최상의 결과를 고르는 방식은 특정한 질문에 답합니다. 정해진 규칙 아래에서 각 모델이 세 번 안에 얼마나 좋은 결과를 낼 수 있는가입니다. 그러나 가장 좋은 시도 하나만 공개하면 첫 시도의 신뢰성은 여전히 알 수 없습니다. 향후 테스트에서는 모든 시도를 공개하고 어떤 결과를 선택했는지 명시할 것을 제안합니다. 가장 좋은 결과와 실패 기록을 모두 살펴볼 수 있게 하기 위해서입니다.
코딩 결과를 더 유용하게 비교하는 방법
아래는 편집상의 판단에 따라 제안하는 테스트 방식입니다. 당사가 실행한 테스트가 아니며, 제작자들의 비공개 세션을 재구성한 것도 아닙니다. 다음 결과를 더 쉽게 해석하도록 돕는 것이 목적입니다.
시작 상태를 빠짐없이 저장하세요. 정확한 프롬프트, 첨부 자료, 초기 프로젝트, 추가 지시 사항을 보관합니다. 빈 디렉터리에서 시작한다면 그 사실도 적습니다. 같은 프롬프트를 다른 프로젝트에 복사했다는 사실만으로 모델에 동일한 맥락이 주어졌다고 볼 수는 없습니다.
환경과 설정을 기록하세요. 실제 사용한 모델, 애플리케이션 또는 코딩 에이전트, 사용 가능한 도구, 설정을 명시합니다. 가능하다면 요청이나 세션 기록도 보관합니다. 모르는 설정은 알 수 없다고 기록하고, 결과의 완성도를 보고 추정하지 마세요. 후속 게시물에서 Antigravity를 언급한 것은 유용한 공개 정보이지만, 다른 세션에서 빠진 세부 사항을 채워 주지는 못합니다.
시도 규칙을 미리 정하세요. 첫 시도, 정해진 횟수의 시도, 또는 일정 예산 내 완료 여부 중 무엇을 비교하는지 결정합니다. 개입 규칙도 동일하게 적용합니다. 한 결과에 수정용 프롬프트가 필요했다면 이를 공개하고 추가 작업에 포함하세요. 최종 애플리케이션을 아무런 수정도 하지 않은 첫 응답처럼 제시해서는 안 됩니다.
같은 상호작용을 검사하세요. 젤리 곰 과제라면 팔다리 드래그하기, 놓기, 몸통 누르기, 다른 곰과 부딪히게 하기, 물체 여러 개 추가하기처럼 반복 가능한 순서를 정합니다. 요청된 각 상호작용이 작동하는지, 어디서 실패하는지, 애플리케이션을 계속 사용할 수 있는지 기록합니다. 이는 제안하는 검수 항목이며, 소개된 시뮬레이션이 물리적으로 정확한 재질을 구현한다는 주장은 아닙니다.
과제를 채점한 뒤 품질과 비용을 함께 비교하세요. 원본 영상에는 제작자가 보고한 비용 수치가 나옵니다. 당사는 해당 청구 기록이나 그 비용에 포함된 전체 작업을 독립적으로 검증하지 않았습니다[5]. 직접 테스트할 때는 평가에 포함한 모든 시도의 사용량과 비용을 보관하고, 같은 검수 기준에 맞춰 지출을 비교하세요. 실패한 시도 역시 평가 기록의 일부입니다.
reAPI를 통해 평가하려면 Gemini 4 Argon 모델 페이지와 Claude Opus 5.5 모델 페이지에서 현재 모델 정보와 요금을 확인하세요. 이 페이지들은 자신의 평가 환경을 구성하기 위한 출발점이며, 소셜 게시물에 등장하는 도구나 세션을 재현하지는 않습니다.
공개된 모델 벤치마크가 궁금하다면 Gemini 4 Argon, GPT-6 Astra, Claude Opus 5.5 비교를 참고하세요. 그 글은 특정 날짜의 공급사 공개 벤치마크 표를 다룹니다. 이 글은 해당 젤리 곰 사례를 둘러싼 논쟁에 집중합니다.
자주 묻는 질문
화제가 된 테스트는 Opus 5.5의 코딩 성능이 더 좋다는 것을 입증했나요?
해당 시각적 비교에서는 Opus에 유리한 결과가 제시됩니다. 하지만 확인한 게시물에는 코딩 전반의 우위를 확립할 만한 통제된 반복 평가가 없습니다[1][3].
후속 Argon 사례는 같은 프롬프트를 썼나요?
@shpotes는 그렇다고 명시했습니다. 이는 해당 출처의 주장입니다. 당사는 프롬프트 전체 내용, 주변 맥락, 설정, 실행 단계를 원본 세션과 대조해 독립적으로 검증하지 않았습니다[2].
재현 사례는 반대로 Argon의 승리를 입증하나요?
이 사례들만으로 전반적인 승자를 정할 수는 없습니다. 보고된 재현은 첫 Argon 결과에서 도출한 추론에 이의를 제기할 뿐, 성공률이나 여러 코딩 과제에 걸친 우위를 확립하지는 않습니다[2].
제작자가 비판에 답했나요?
그렇습니다. Semichenko는 Gemini 실행이 실패했을 가능성을 언급하며 추가 테스트가 필요하다고 말했습니다. 향후 비교에서는 세 번 중 가장 좋은 결과를 선택하자는 제안도 했습니다[3][4].
AI 영상 생성 테스트였나요?
공개된 사례는 코딩으로 만든 대화형 시뮬레이션입니다. 당사의 영상은 그 결과를 녹화한 화면을 다룹니다. 텍스트를 영상으로 생성하는 모델을 비교하는 테스트는 아닙니다[5].
reAPI가 이 벤치마크를 다시 실행했나요?
아닙니다. 이 글과 연결된 영상은 제삼자가 보고한 실행 결과를 분석합니다. 당사는 전체 환경을 독립적으로 재현하거나 전체 청구 기록을 확인하지 않았고, 새로운 벤치마크 점수도 산출하지 않았습니다[5].
승자를 고르기 전에 확인할 것
먼저 원본 시연을 본 뒤 재현했다고 보고한 게시물과 제작자의 답변을 읽으세요. 모델을 선택해야 한다면, 전체 환경과 명시된 평가 규칙에 따라 진행한 모든 시도의 기록을 요청하세요. 이 자료들이 갖춰지기 전까지 Gemini 4 Argon vs Opus 5.5 젤리 곰 테스트는 더 조사할 가치가 있는 구체적인 사례입니다. 자신의 업무에 쓸 모델은 반복 가능한 조건에서 필요한 동작을 확인한 뒤 선택하세요.
참고 자료
-
Semichenko (@semichenkko). 원본 젤리 곰 비교와 첨부된 Community Note. 2026년 10월 19일 확인: x.com/semichenkko/status/2110131790136401989
-
@shpotes. 같은 프롬프트를 사용했다고 보고한 Argon + Antigravity 재현. 2026년 10월 19일 확인: x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko). Gemini 실행이 실패했을 가능성과 추가 테스트의 필요성을 인정한 답변. 2026년 10월 19일 확인: x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko). 향후 비교에서 세 번 중 최상의 결과를 고르자고 제안한 답변. 2026년 10월 19일 확인: x.com/semichenkko/status/2110282000246472931
-
reAPI. Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged. 2026년 10월 19일 확인: youtu.be/QR9HChbtym0
-
@Caxvalencia. Argon - Medium 상호작용 예시. 2026년 10월 19일 확인: x.com/Caxvalencia/status/2110170790444269766