Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 벤치마크 비교
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: 18개 벤치마크, 출력 한도, 가격, 작업별 추천 모델 비교.
Gemini 4 Argon은 Google 자체 벤치마크 표에서 선두지만, 모든 항목에서 그런 것은 아닙니다. Google이 2026년 9월 30일 출시와 함께 공개한 19행짜리 표에서, Argon은 자신과 GPT-6 Astra, Claude Opus 5.5 가운데 13개 행에서 최고 점수를 기록했고, 1개 행은 동률, 5개 행은 졌습니다. Astra에 3개, Opus 5.5에 2개입니다[1]. 진 항목은 터미널 작업, 더 어려운 소프트웨어 벤치마크, 컴퓨터 사용에 몰려 있는데, 바로 많은 개발자가 모델을 평가하는 영역입니다.
이 비교는 Google 표의 모든 숫자를 나란히 놓고, 각 제공사가 공개한 사양과 가격을 더한 뒤, Google 방법론의 주의점을 설명합니다. 출시 후 검색 관심도 같은 것을 물었습니다: "gemini 4 argon benchmarks", "gemini 4 argon performance relative to other models", "gemini 4 vs gpt 6 astra", "gemini 4 vs claude". 모든 점수보다 앞서는 실질적인 차이가 하나 있습니다. Astra와 Opus 5.5는 일반 공개되어 있고, Argon은 그렇지 않습니다[1].
TL;DR
- 전체: 세 모델 중 Google 표 19개 행에서 Gemini 4 Argon이 13개, GPT-6 Astra가 3개, Claude Opus 5.5가 2개에서 최고 점수이며, 1개는 동률입니다[1].
- Argon이 가장 확실하게 앞서는 항목: Harvey's Legal Agent Benchmark(19.6% vs 5.4%, 3.8%), 긴 컨텍스트 GraphWalks 256K–1M(84.2% vs 71.8%, 66.8%), 긴 동영상 LVBench(91.7%)[1].
- Argon이 뒤지는 항목: Opus 5.5는 Terminal-bench 4.0(66.4% vs 57.4%)과 PostTrainBench에서 앞서고, Astra는 FrontierSWE v2, Terminal-Bench Science, OSWorld-2.0에서 앞섭니다[1].
- 출력: Argon은 한 번의 응답으로 100만 토큰을 반환할 수 있습니다. Astra와 Opus 5.5는 표준 API에서 128K에서 멈춥니다[1][2][4].
- 1M 토큰당 가격: Argon은 출시 기념가 $2/$10, 이후 $4/$20, Opus 5.5는 $4/$20, Astra는 $10/$50입니다[1][2][3].
Gemini 4 Argon 벤치마크 전체 표
다음은 Google 발표문의 벤치마크 표에 실린 숫자입니다. Google 표에는 Claude Fable 5.1도 포함되어 있어, "vs Fable" 질문에도 답할 수 있도록 별도 열로 넣었습니다. Argon, Astra, Opus 5.5 중 최고 점수는 굵게 표시했고, 대시는 Google이 결과를 보고하지 않은 항목입니다[1].
| 분야 | 벤치마크 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| 지식 업무 | Vals Index | 68.9% | 63.1% | 67.0% | 65.8% |
| 지식 업무 | AutomationBench | 51.3% | 41.4% | 42.5% | 31.4% |
| 지식 업무 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% | 58.9% |
| 지식 업무 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 3.8% | 6.7% |
| 에이전트 코딩 | DeepSWE v1.1 | 77.9% | 74.1% | 74.2% | 67.4% |
| 에이전트 코딩 | FrontierSWE v2 | 55.0% | 65.5% | 62.3% | 56.3% |
| 에이전트 코딩 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 에이전트 코딩 | Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% | 57.9% |
| ML 엔지니어링 | PostTrainBench | 45.3% | 44.3% | 49.3% | 40.2% |
| 과학·수학 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 63.3% | 52.6% |
| 과학·수학 | LABBench 2 | 88.8% | 85.4% | 73.1% | 68.6% |
| 과학·수학 | RiemannBench | 76.0% | 72.0% | 69.6% | 65.6% |
| 긴 컨텍스트 | GraphWalks, 128K까지 | 99.7% | 98.7% | 90.6% | 91.4% |
| 긴 컨텍스트 | GraphWalks, 256K~1M | 84.2% | 71.8% | 66.8% | 65.0% |
| 컴퓨터 사용 | Agent's Last Exam | 39.5% | 34.2% | 38.2% | — |
| 컴퓨터 사용 | OSWorld-2.0 (오프라인 하위 세트) | 69.2% | 72.6% | — | — |
| 멀티모달 | Chartography | 71.6% | 71.0% | 66.3% | 46.2% |
| 멀티모달 | LVBench | 91.7% | 87.5% | 83.7% | 79.7% |
| 사이버 보안 | CWE-bench v1 | 68.0% | 68.0% | 67.0% | 58.0% |
Claude Opus 5.5와 일대일로만 보면, Gemini 4 Argon은 둘 다 점수가 있는 18개 행 중 14개에서 앞서고 4개에서 뒤집니다. FrontierSWE v2, Terminal-bench 4.0, PostTrainBench, Terminal-Bench Science입니다[1].
Google 방법론을 알고 표 읽기
표의 모든 점수는 Google 발표문에서 나왔고, Google의 방법론 페이지가 각 숫자의 출처를 설명합니다. 격차를 얼마나 중요하게 볼지 바꾸는 세부 사항이 세 가지 있습니다[5]:
- 경쟁 모델 점수 대부분은 자체 보고 수치입니다. Google은 Gemini 외 모델의 결과가 "sourced from providers' self reported numbers unless otherwise mentioned"(별도 언급이 없으면 제공사의 자체 보고 수치에서 가져옴)라고 밝히며, 보고된 경우 각 경쟁 모델의 최대 추론 설정을 사용했습니다.
- Argon 점수 일부는 Google이 직접 측정했습니다. Argon의 DeepSWE v1.1과 Terminal-bench 4.0 결과는 Google이 실행했고, Astra, Fable, Opus 수치는 공개 리더보드나 시스템 카드에서 가져왔습니다. 흔한 관행이지만, 평가 하네스가 항상 동일하지는 않다는 뜻입니다.
- 입력 조건이 항상 같지는 않았습니다. LVBench에서 Google은 Gemini에 초당 1프레임을 썼지만, "due to API limitations"(API 제한 때문에) Astra는 800프레임, Opus 5.5는 600프레임, Fable 5.1은 300프레임을 사용했습니다. 모델들이 같은 프레임 예산을 받지 않았으므로 긴 동영상 격차는 다소 신중하게 보세요.
그렇다고 표가 틀린 것은 아닙니다. 다만 Vals Index나 CWE-bench처럼 1포인트 차이는 실무적으로 동률이고, Harvey's Legal Agent Benchmark나 256K1M GraphWalks처럼 1217포인트 격차는 실제 신호라는 뜻입니다.
사양과 가격 비교
벤치마크는 판단의 절반일 뿐입니다. 각 제공사가 한도와 가격에 대해 공개한 내용은 다음과 같습니다.
| Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | |
|---|---|---|---|
| 이용 가능 여부 | Fairwind Program 파트너 한정, 개발자에게는 "as soon as possible"(가능한 한 빨리)[1] | 일반 공개[2] | 일반 공개[4] |
| 컨텍스트 윈도 | 미공개 | 1,050,000 토큰[2] | 1M 토큰[4] |
| 응답당 최대 출력 | 1M 토큰[1] | 128,000 토큰[2] | 128K (Batch API 베타로 300K)[4] |
| 입력 유형 | 텍스트와 차트, 문서, 긴 동영상(Google 발표 기준)[1] | 텍스트, 이미지[2] | 텍스트, 이미지[4] |
| 1M 토큰당 입력 / 출력 | 출시 기념가 $2 / $10, 이후 $4 / $20[1] | $10 / $50, 입력 272K 초과 시 더 높음[2] | $4 / $20[3] |
| 1M 토큰당 캐시 입력 | 출시 기념 기간 $0.10[1] | $1[2] | 캐시 적중 $0.20[3] |
토큰당 가격과 작업당 가격은 다릅니다. Gemini 4 Argon 가격 분석에서 세 모델의 작업 형태 네 가지를 계산해 두었습니다.
Gemini 4 Argon vs GPT-6 Astra
Astra와 비교하면 Argon은 지식 업무와 긴 컨텍스트 행 대부분에서 이기며, 법률·금융 에이전트 테스트에서는 큰 차이로 앞섭니다. Harvey's 벤치마크에서 19.6% vs 5.4%, Vals Finance Agent v2에서 65.4% vs 53.5%입니다[1]. 가격도 출시 기념 기간에는 Astra 정가의 5분의 1, 이후에는 5분의 2입니다[1][2].
컴퓨터 사용과 더 어려운 소프트웨어 벤치마크에서는 Astra가 더 강합니다. OSWorld-2.0(72.6% vs 69.2%), FrontierSWE v2(65.5% vs 55.0%), Terminal-Bench Science(68.1% vs 57.6%)에서 앞섭니다[1]. FrontierSWE v2와 Terminal-Bench Science의 10.5포인트 격차는 Argon이 자체 출시 표에서 기록한 가장 큰 패배이므로, 이런 벤치마크와 비슷한 작업을 하는 팀은 전환 전에 테스트해 보는 것이 좋습니다. Astra는 Terminal-bench 4.0에서도 58.2% 대 57.4%로 Argon을 근소하게 앞섭니다.
Gemini 4 Argon vs Claude Opus 5.5
코딩에서는 가장 팽팽한 조합입니다. Argon은 DeepSWE v1.1(77.9% vs 74.2%)과 Vibe Code Bench(91.9% vs 90.3%)에서 Opus 5.5를 근소하게 앞서고, Opus 5.5는 Terminal-bench 4.0에서 9포인트(66.4% vs 57.4%), PostTrainBench에서 4포인트(49.3% vs 45.3%) 앞섭니다[1]. 에이전트가 셸 안에서 일한다면 Opus 5.5는 더 새로운 모델과 비교해도 충분히 버팁니다.
코딩 밖에서는 Argon이 크게 앞서 나갑니다. 법률 벤치마크 격차는 15.8포인트, 256K~1M 긴 컨텍스트 GraphWalks는 17.4포인트, LABBench 2는 15.7포인트입니다[1]. Argon의 출시 기념 기간이 끝나면 두 모델 모두 100만 토큰당 $4와 $20로 같은 정가가 되므로[1][3], 선택은 가격이 아니라 작업에 달려 있습니다.
작업별로 어떤 모델을 쓸까
- 법률·금융 리서치, 긴 문서 묶음, 긴 동영상: Gemini 4 Argon. 쓸 수 있게 되면요. 가장 큰 격차로 앞서는 영역입니다.
- 전체 마이그레이션이나 128K 토큰을 넘는 보고서처럼 아주 긴 단일 출력: 세 모델 중 한 번의 응답으로 해낼 수 있는 것은 Gemini 4 Argon뿐입니다.
- 터미널 중심 코딩 에이전트: Terminal-bench 4.0에서 확실한 차이로 앞서는 Claude Opus 5.5.
- 컴퓨터 사용과 가장 어려운 SWE 작업: OSWorld-2.0과 FrontierSWE v2에서 앞서는 GPT-6 Astra.
- 이번 달 안에 출시해야 하는 모든 것: Astra나 Opus 5.5. Gemini 4 Argon에는 아직 공개 API가 없습니다[1].
reAPI에서는 Claude Opus 5.5와 GPT-6 Astra를 하나의 API 키와 하나의 chat completions 엔드포인트로 모두 사용할 수 있으므로, 지금 두 모델에서 같은 평가를 돌리고 Gemini 4 Argon이 나오면 추가하면 됩니다. Argon의 이용 가능 여부는 Gemini 4 Argon 모델 페이지에서 추적합니다.
FAQ
Gemini 4 Argon이 GPT-6 Astra보다 나은가요?
Google 표의 대부분에서는 그렇습니다. Astra와 비교해 Argon은 19개 행 중 14개에서 점수가 높고 1개는 동률입니다. Astra는 FrontierSWE v2, Terminal-Bench Science, OSWorld-2.0, 그리고 근소한 차이로 Terminal-bench 4.0에서 앞섭니다[1].
Gemini 4 Argon이 Claude Opus 5.5보다 나은가요?
Google 표에서 비교 가능한 18개 행 중 14개에서 그렇습니다. Opus 5.5는 Terminal-bench 4.0, PostTrainBench, FrontierSWE v2, Terminal-Bench Science에서 앞섭니다[1].
Gemini 4 Argon과 Claude Fable 5.1을 비교하면 어떤가요?
Google이 두 모델 점수를 모두 보고한 17개 행 중 15개에서 Argon이 Fable 5.1보다 높습니다. Fable 5.1은 FrontierSWE v2(56.3% vs 55.0%)와 Terminal-bench 4.0(57.9% vs 57.4%)에서 근소하게 앞섭니다[1].
Gemini 4 Argon의 최고 벤치마크 결과는 무엇인가요?
128K까지의 GraphWalks에서 기록한 99.7%입니다. 가장 의미 있는 승리는 격차가 큰 항목입니다. Harvey's Legal Agent Benchmark에서 Astra 5.4%, Opus 5.5 3.8%에 대한 19.6%, 그리고 256K~1M GraphWalks의 84.2%입니다[1].
이 벤치마크 점수는 독립적인 결과인가요?
완전히 그렇지는 않습니다. 점수는 Google 발표문에서 나왔고, Google은 경쟁 모델 점수 대부분이 각 제공사의 자체 보고 수치이며 Argon 테스트 일부는 직접 실행했다고 밝혔습니다[5].
Gemini 4 Argon, GPT-6 Astra, Claude Opus 5.5 중 가장 저렴한 것은?
출시 기념가 $2/$10의 Gemini 4 Argon입니다. 그 이후에는 Argon과 Opus 5.5 모두 $4/$20, Astra는 1M 토큰당 $10/$50입니다[1][2][3].
Argon, Astra, Opus 5.5 중 고르기
Google 표는 Gemini 4 Argon이 세 모델 중 가장 뛰어난 범용 모델이라는 강한 근거를 제시합니다. 법률, 금융, 긴 컨텍스트, 긴 동영상에서 가장 크게 앞서고, 누구도 따라오지 못하는 100만 토큰 출력을 갖췄습니다. 동시에 근거가 가장 약한 곳도 보여 줍니다. 터미널 에이전트와 컴퓨터 사용 에이전트에서는 여전히 Opus 5.5와 Astra가 이깁니다.
이것이 최종 결론이 될 수 없는 이유가 두 가지 있습니다. 점수는 대부분의 항목에서 이긴 모델의 제조사가 낸 것이고, Argon은 비교 대상 중 유일하게 아직 호출할 수 없는 모델입니다. 지금은 Astra와 Opus 5.5로 평가 체계를 만들고, Gemini 4 Argon이 개발자에게 열리면 다시 돌려 보세요.
참고 자료
- Google. Gemini 4 Argon: our next era of frontier intelligence (including benchmark table). 2026년 10월 확인, 출처: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- OpenAI. GPT-6 Astra model page. 2026년 10월 확인, 출처: developers.openai.com/api/docs/models/gpt-6-astra
- Anthropic. Pricing. 2026년 10월 확인, 출처: platform.claude.com/docs/en/about-claude/pricing
- Anthropic. Models overview. 2026년 10월 확인, 출처: platform.claude.com/docs/en/about-claude/models/overview
- Google DeepMind. Gemini 4 Argon model evaluation: approach, methodology and results. 2026년 10월 확인, 출처: deepmind.google/models/evals-methodology/gemini-4-argon
작성자

카테고리
더 많은 게시물
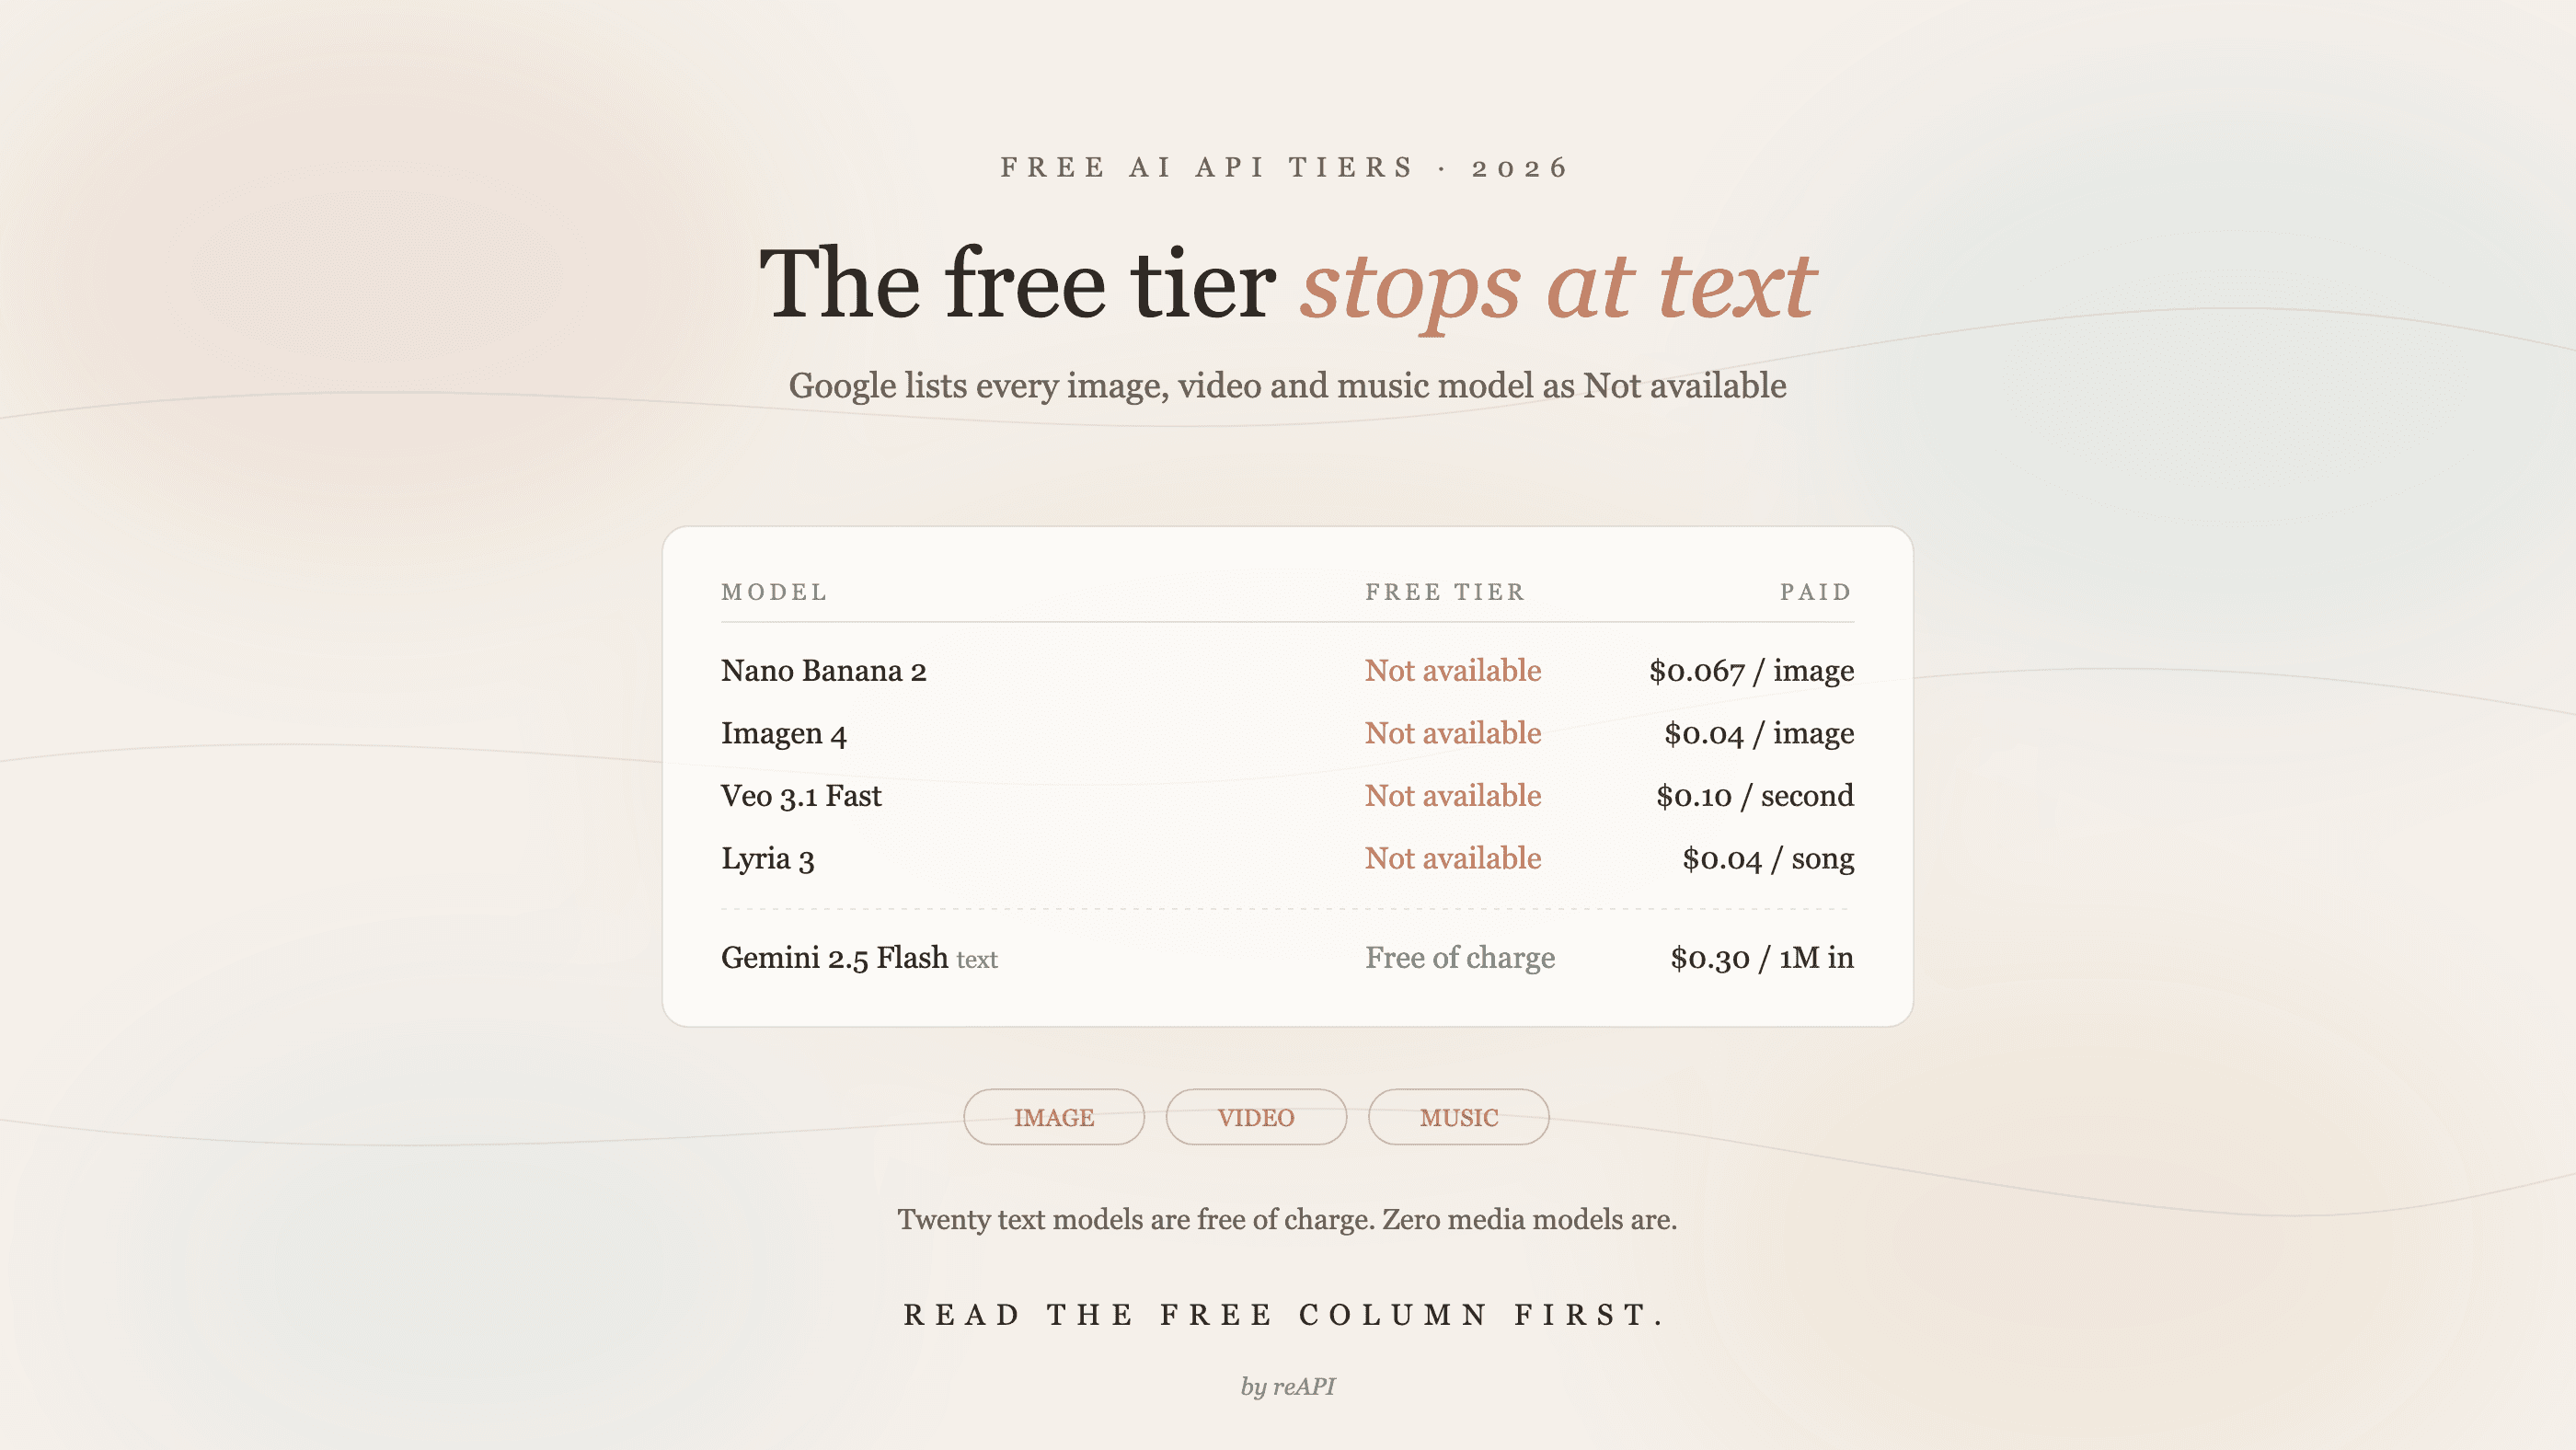
2026년 무료 AI API: 각 사의 무료 범위는 실제 어디까지인가
Google 무료 tier는 이미지, 동영상, 음악 모델을 전부 제외합니다. 각 프로바이더의 무료 범위와 2026년 7월 현재 공식 가격을 정리했습니다.
LLM 최대 출력 토큰 비교: 모델별 API 출력 한도와 컨텍스트, 추론 예산을 구분하는 방법
LLM 최대 출력 토큰을 컨텍스트 윈도우, 추론 예산, API 매개변수와 구분해 비교합니다. 요청 한도와 기본값·권장값의 차이, Claude의 배치 전용 출력 확장 조건을 확인하고, 제공사 자체 API 사양을 reAPI 인터페이스와 혼동하지 않도록 명확하게 정리했습니다.
Seedance 2.0 무료 사용법: 실제로 가능한 선택지
2026년 실제 무료 경로는 Dreamina 일일 크레딧과 Krea 무료 등급입니다. 무료 이용의 제한과 1달러 API 크레딧이 더 나은 시점도 설명합니다.