DeepSeek V4 1M 컨텍스트와 요금 청구
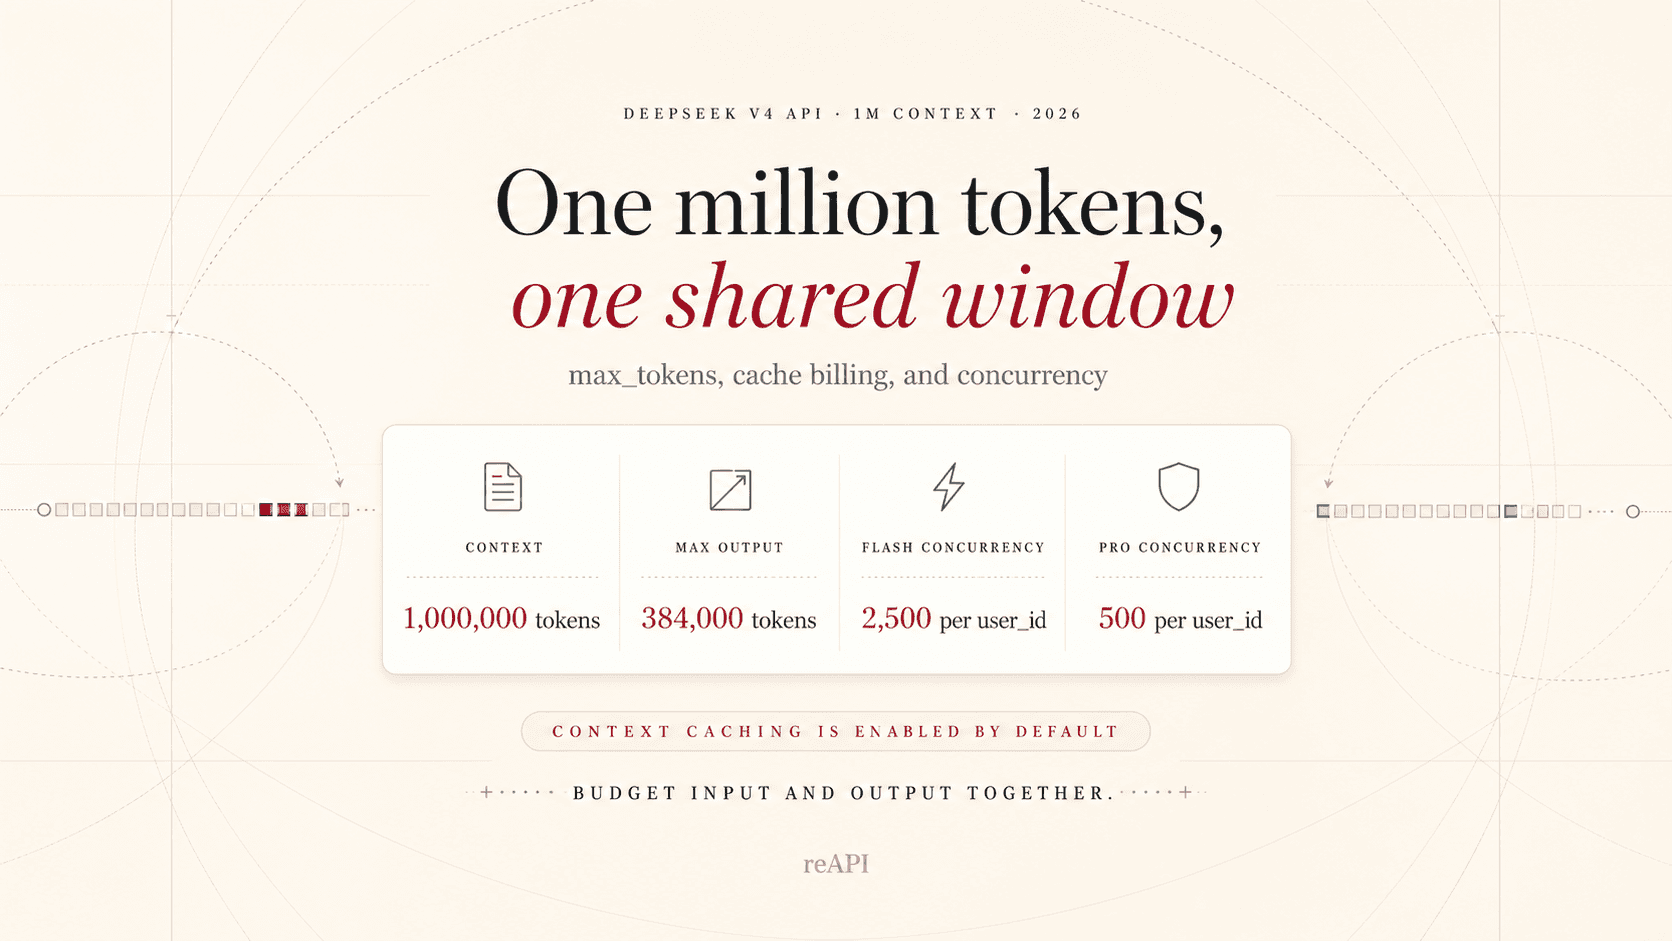
DeepSeek V4의 1M 컨텍스트는 입력과 출력이 공유하며 384K까지 출력 가능합니다. max_tokens, 캐시 청구 방식, 동시성 제한을 설명합니다.
DeepSeek V4의 1M 컨텍스트 윈도우는 입력과 출력이 공유하는 예산입니다. 1M 입력 토큰을 보낸 후 별도로 384K를 생성할 수 있다는 의미가 아닙니다. 384K 수치는 최대 출력이고, max_tokens는 한 번의 요청에서 선택할 수 있는 출력 상한입니다. 실제 출력은 1M 윈도우에 남은 공간으로도 제한됩니다[1][2].
이 가이드는 그 명세 뒤에 숨은 실무 질문에 답합니다. 입력과 출력을 어떻게 예산 편성할지, max_tokens는 어떻게 설정할지, 생각 토큰이 사용량에 미치는 영향, 캐시 요금 청구 방식, Flash와 Pro의 동시 요청 제한이 다른 이유까지입니다.
DeepSeek V4 제한 한눈에 보기
| 항목 | 공식 명세 |
|---|---|
| 모델 ID | deepseek-v4-flash, deepseek-v4-pro |
| 컨텍스트 윈도우 | 1M 토큰, 입력과 생성된 출력이 공유 |
| 최대 출력 | 384K 토큰 |
max_tokens | 요청당 완성 상한선; 남은 컨텍스트나 모델 출력 제한을 초과할 수 없음 |
| 기본 모드 | 생각 활성화됨; 일반 요청은 기본값 reasoning_effort: high |
| 캐시 | 컨텍스트 디스크 캐시는 자동 활성화 |
| Direct API 동시 요청 | Flash 2,500; Pro 500, 계정당 |
| 인터페이스 | OpenAI Chat Completions 및 Anthropic 호환 |
DeepSeek은 2026년 4월 24일에 Flash와 Pro 변형 및 1M 컨텍스트 윈도우를 포함한 V4 프리뷰를 출시했습니다[3]. 공식 가격 페이지에는 두 모델 모두에 대해 384K 출력 상한, JSON 출력, 도구 호출, 접두사 완성, FIM 완성이 같이 나열되어 있습니다[1].
1M이 입력 전용을 의미하나요?
아니요. DeepSeek의 Chat Completions 참조 문서에 따르면 입력 토큰과 생성된 토큰의 총 길이는 모델 컨텍스트 길이로 제한됩니다[2].
이런 멘탈 모델을 사용하세요:
입력 토큰 + 생성 토큰 <= 1M 컨텍스트
생성 토큰 <= max_tokens
생성 토큰 <= 384K 모델 출력 제한
프롬프트가 컨텍스트 윈도우를 거의 채우면 모델은 384K 답변을 돌려줄 수 없습니다. 시스템 지시사항, 도구 스키마, 대화 기록, 완성을 위해 공간을 남겨두세요.
큰 윈도우라도 검색과 청킹의 가치를 제거하지는 못합니다. 더 적지만, 더 잘 정리된 컨텍스트를 보내는 것이 종종 지연 시간, 비용, 답변 집중도를 개선합니다.
max_tokens를 설정하는 방법
max_tokens는 한 번의 요청에 대한 최대 완성 길이입니다. finish_reason이 length인 경우 요청이 이 상한을 도달했거나 이용 가능한 컨텍스트를 소진했음을 의미할 수 있습니다[2].
합리적인 시작점:
| 작업 | 시작 상한 |
|---|---|
| 분류, 추출, 짧은 답변 | 1K–4K |
| 코드 리뷰 및 문서 요약 | 4K–16K |
| 긴 보고서 및 마이그레이션 계획 | 16K–64K |
| 극단적 장문 생성 | 비용과 절단을 측정한 후에만 상한 증가 |
이는 공식 요구사항이 아닌 엔지니어링 시작점입니다. 상한을 높이기 전에 finish_reason, 실제 완성 토큰, 지연 시간, 유용한 출력률을 측정하세요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://api.reapi.ai/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {
            "role": "user",
            "content": "Review this repository inventory and produce a risk-ranked migration plan.",
        }
    ],
    max_tokens=16_384,
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"},
        "group": "default",
    },
)
DeepSeek V4 API 참조에서 reAPI 요청 필드를 보고, DeepSeek V4 모델 페이지에서 플레이그라운드와 실시간 게이트웨이 가격을 확인하세요.
생각 토큰과 완성 사용량
생각 모드는 기본값으로 활성화됩니다. DeepSeek은 reasoning_content에 추론을 반환하고, 사용량 객체는 completion_tokens_details.reasoning_tokens로 따로 보고할 수 있습니다[4][2].
추론과 보이는 최종 답변을 모두 포함하여 완성 용량을 계획하세요. 생각 모드에서는 temperature, top_p, presence_penalty, frequency_penalty가 호환성을 위해 허용되지만 실제 효과는 없습니다[4].
결정론적 추출이나 저 지연 시간 작업의 경우 생각을 비활성화한 Flash를 테스트하세요. 추가 추론이 유용한 계획, 코딩, 다단계 도구 사용의 경우 생각을 활성화된 상태로 유지하세요.
도구 호출에서 이전 추론을 보존해야 하나요?
DeepSeek의 현재 규칙은 요청에 tools가 포함되는지에 따라 다릅니다. 도구를 사용할 때는 이전 assistant 메시지의 reasoning_content를 함께 보내야 하며 이 추론도 컨텍스트에 포함됩니다. 도구가 없으면 이전 추론은 생략해도 되고, 보내도 무시됩니다. 도구 호출 루프에서 이전 추론을 일괄 삭제하면 안 됩니다[4].
요금 청구 방식
2026년 10월 22일 요금 확인: 아래 7월 30일 표는 과거 기록이며 현재 견적이 아닙니다. DeepSeek 직접 API의 현행 요금표는 캐시 적중 입력, 캐시 미적중 입력, 출력을 각각 피크와 비피크 요금으로 구분합니다. 피크 시간은 중국 공휴일을 제외한 월요일부터 금요일까지 UTC 01:00–04:00 및 06:00–10:00입니다. 나머지는 모두 비피크이며 요금은 피크의 절반입니다. 같은 페이지는 현재 deepseek-flash를 권장합니다. 기존 deepseek-v4-flash 이름도 허용하지만 요청은 DeepSeek-V4.1-Flash-1017이 처리하고 Flash 요금이 적용됩니다. 이는 DeepSeek 직접 서비스의 규칙이며 reAPI의 모델 매핑이나 요금을 보장하지 않습니다. reAPI의 정확한 모델과 현행 과금은 V4 페이지 또는 V4.1 Flash 페이지에서 확인하세요[7].
DeepSeek Direct는 세 개의 토큰 버킷을 청구합니다:
- 캐시된 입력;
- 캐시되지 않은 입력;
- 출력.
2026년 7월 30일의 공식 USD 요금은[1]:
| 모델 | 캐시된 입력 / 1M | 캐시되지 않은 입력 / 1M | 출력 / 1M |
|---|---|---|---|
| DeepSeek V4 Flash | $0.0028 | $0.14 | $0.28 |
| DeepSeek V4 Pro | $0.003625 | $0.435 | $0.87 |
일반 공식은:
비용 =
  캐시된_입력 / 1M × 캐시된_요금
  + 캐시되지않은_입력 / 1M × 캐시되지않은_요금
  + 출력 / 1M × 출력_요금
이는 DeepSeek의 직접 가격입니다. reAPI는 자체 실시간 USD 요금을 가진 별도의 게이트웨이이므로 reAPI DeepSeek V4 페이지의 가격 카드를 게이트웨이 청구에 사용하세요.
컨텍스트 캐싱에서 가치 얻기
DeepSeek의 디스크 캐시는 자동 활성화됩니다. 이후 요청은 저장된 접두사 단위를 완전히 일치할 때만 캐시 적중을 받습니다. 유사한 표현만으로는 충분하지 않습니다[5].
안정적인 내용을 먼저 배치하세요:
안정적인 시스템 프롬프트
+ 안정적인 도구 스키마
+ 변하지 않은 저장소 또는 문서 모음
+ 요청마다 변하는 질문
응답 필드 prompt_cache_hit_tokens과 prompt_cache_miss_tokens을 사용하여 실제 적중률을 계산하세요. 프롬프트 유사도만으로 절감액을 추정하지 마세요.
Flash와 Pro 동시 요청
DeepSeek Direct는 계정 수준의 동시 요청 제한을 Flash 2,500, Pro 500으로 발표했습니다. 요청은 응답이 끝날 때까지 하나의 동시 요청 슬롯을 차지합니다. 제한은 API 키가 아닌 계정당이고, 초과 요청은 HTTP 429를 받습니다[6].
선택적인 user_id는 안전, 캐시, 스케줄링 행동을 격리할 수 있지만, 일반 계정은 여전히 모든 사용자 ID에 걸쳐 총 계정 동시 요청을 공유합니다. 더 많은 키나 사용자 ID를 만드는 것은 용량을 증가시키지 않습니다.
이 수치는 DeepSeek Direct에 적용됩니다. 게이트웨이 동시 요청과 큐잉은 다를 수 있습니다. reAPI를 사용할 때는 reAPI에서 발표한 제한과 응답을 따르세요.
1M 컨텍스트 요청을 위한 프로덕션 체크리스트
- 문자를 토큰으로 취급하지 말고 토큰을 세세요.
- 출력, 도구 스키마, 후속 차례를 위해 컨텍스트를 남겨두세요.
max_tokens를 작업에 설정하세요, 384K로 자동 설정하지 마세요.finish_reason을 기록하고 절단과 자연스러운 중단을 구분하세요.- 재사용 가능한 접두사를 안정적으로 유지하고 캐시 적중 토큰을 추적하세요.
- 생각 사용량을 보이는 답변 길이와 따로 측정하세요.
- 429 응답을 지수 백오프와 지터를 사용하여 재시도하세요.
- 높은 부피의 일상적인 작업을 Flash로 라우팅하고 더 어려운 작업을 위해 Pro를 예약하세요.
- 현재 V4 모델 ID를 사용하세요. DeepSeek의 발표한
deepseek-chat과deepseek-reasoner의 지원 중단 날짜는 2026년 7월 24일이었습니다[3].
FAQ
DeepSeek V4 Flash가 1M 컨텍스트를 지원하나요?
네. Flash와 Pro 모두 1M 컨텍스트 윈도우와 384K 최대 출력을 갖습니다[1].
1M 컨텍스트가 모두 입력인가요?
아니요. 입력과 생성된 출력이 모델 컨텍스트 제한을 공유합니다[2].
max_tokens를 384K로 설정할 수 있나요?
384K는 모델 출력 상한이지만, 요청은 1M 컨텍스트 윈도우에 충분한 공간도 있어야 합니다. 이 설정이 384K 완성을 보장하지는 않습니다.
생각 토큰이 완성 사용량에 카운트되나요?
용량과 청구 계획이 포함되어야 합니다. DeepSeek은 완성 사용량 세부사항 내에서 생각 토큰을 보고합니다[2].
동시 요청 제한이 API 키당인가요?
아니요. DeepSeek Direct는 계정당 동시 요청을 제한합니다: Flash 2,500, Pro 500[6].
프롬프트 캐싱을 활성화해야 하나요?
아니요. 컨텍스트 디스크 캐시는 자동입니다. 공유 접두사를 안정적으로 유지하고 usage의 캐시 적중 필드를 검사하세요[5].
추가 읽을거리
참고 자료
-
DeepSeek. Models & Pricing — V4 context, output, features, prices, and concurrency. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/pricing
-
DeepSeek. Create Chat Completion — max_tokens, context limits, finish reasons, and usage. Retrieved July 30, 2026 from api-docs.deepseek.com/api/create-chat-completion
-
DeepSeek. DeepSeek-V4 preview release. April 24, 2026. api-docs.deepseek.com/news/news260424
-
DeepSeek. Thinking Mode — controls, reasoning effort, and reasoning content. Retrieved September 8, 2026 from api-docs.deepseek.com/guides/thinking_mode
-
DeepSeek. Context Caching — prefix matching and usage fields. Retrieved July 30, 2026 from api-docs.deepseek.com/guides/kv_cache
-
DeepSeek. Rate Limit & Isolation — account-level concurrency and user_id. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/rate_limit
-
DeepSeek. Models & Pricing. 2026년 10월 22일 재확인. api-docs.deepseek.com/quick_start/pricing
작성자

카테고리
max_tokens를 설정하는 방법생각 토큰과 완성 사용량도구 호출에서 이전 추론을 보존해야 하나요?요금 청구 방식컨텍스트 캐싱에서 가치 얻기Flash와 Pro 동시 요청1M 컨텍스트 요청을 위한 프로덕션 체크리스트FAQDeepSeek V4 Flash가 1M 컨텍스트를 지원하나요?1M 컨텍스트가 모두 입력인가요?max_tokens를 384K로 설정할 수 있나요?생각 토큰이 완성 사용량에 카운트되나요?동시 요청 제한이 API 키당인가요?프롬프트 캐싱을 활성화해야 하나요?추가 읽을거리참고 자료더 많은 게시물
Claude Fable 5.1이 더 싼가? 캐시 비용 계산
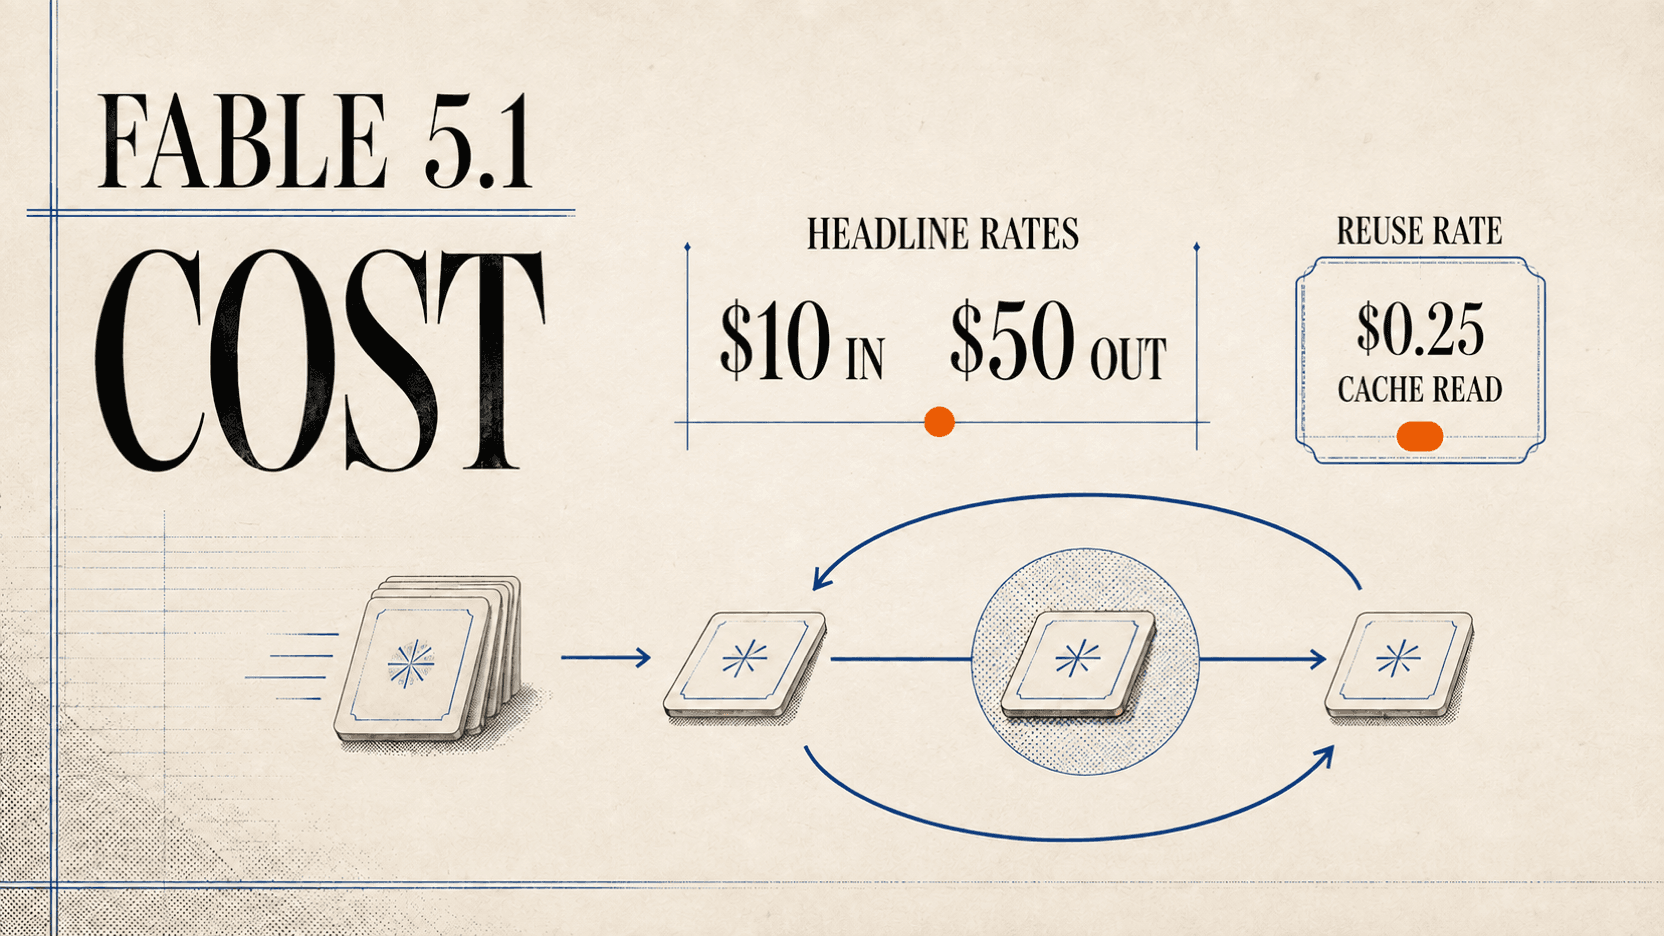
Claude Fable 5.1은 기본 요금 $10/$50을 유지하지만 캐시 읽기를 $0.25로 인하합니다. 실제 작업 비용을 계산하고 구독 요금제 혼동을 피하세요.
Atlas Cloud AI 대안: 리뷰, 가격 비교, 믿을 만한지 점검
Atlas Cloud AI 대안을 찾고 계신가요? Nano Banana Pro, Seedance, Wan 가격을 비교하고 Atlas Cloud AI가 믿을 만한 서비스인지 점검한 리뷰입니다.
GPT-6 Luna vs 5.6 Luna vs 5.6 Terra: 가격 비교와 선택 가이드
GPT-6 Luna vs 5.6 Luna, 5.6 Terra: OpenAI 공시 가격, Luna가 저렴해진 공식 이유, 벤치마크와 초기 A/B 테스트 결과, 그리고 무엇을 고를지.