API GPT 20% moins cher sur reAPI : cinq modèles à comparer
Cinq modèles GPT coûtent maintenant 20% moins cher sur reAPI qu'aux tarifs standard OpenAI. Comparez les tarifs de GPT-5.4, GPT-5.5 et tous les niveaux GPT-5.6.
La récente réduction des tarifs de l'API GPT est facile à mal interpréter, car deux prix ont changé. OpenAI a baissé ses propres tarifs de liste pour la famille GPT-5.6 après la première publication de cet article, tandis que GPT-5.4 et GPT-5.5 ont conservé les leurs.[5] Séparément, reAPI énumère les cinq modèles GPT actuels en dessous des tarifs standards d'OpenAI pour les tokens d'entrée et de sortie : quatre d'entre eux à 20% en dessous, et GPT-5.4 à 60% en dessous. Tous les tarifs de cet article ont été revérifiés le 22 octobre 2026.
La réduction concerne GPT-5.4, GPT-5.5 et la famille complète GPT-5.6 — Sol, Terra et Luna. Il n'y a aucun SDK nouveau ni projet de migration. Le code compatible avec OpenAI existant peut utiliser les tarifs réduits en changeant simplement l'URL de base et, si nécessaire, l'identifiant du modèle.
Ce guide compare chaque tarif, calcule les économies sur une charge réelle et explique quand l'API Batch ou la mise en cache des requêtes OpenAI peuvent encore influer sur le calcul.
Résumé
- Les cinq modèles GPT coûtent moins cher que le tarif standard OpenAI sur reAPI : GPT-5.5, GPT-5.6 Sol, GPT-5.6 Terra et GPT-5.6 Luna à 20% en dessous, et GPT-5.4 à 60% en dessous.
- Les tarifs de liste propres à OpenAI pour GPT-5.6 ont aussi baissé. Sol est désormais $4/$20, Terra $2/$12 et Luna $0.20/$1.20 par million de tokens ; OpenAI étiquète le tarif de Sol comme promotionnel jusqu'au moins le 21 novembre 2026.[5]
- La route la moins chère est GPT-5.6 Luna à $0.16 à l'entrée et $0.96 à la sortie par million de tokens sur reAPI.
- GPT-5.4 est maintenant moins cher que Terra sur reAPI : $1 à l'entrée et $6 à la sortie par million de tokens, contre $1.60 et $9.60. Testez les deux avant de choisir.
- GPT-5.6 Sol est maintenant moins cher que GPT-5.5 : $3.20 à l'entrée et $16 à la sortie par million de tokens sur reAPI, contre $4 et $24.
- Une réduction de 20% sur les tokens produit une réduction de 20% sur la facture quand le mélange de requêtes et l'utilisation des tokens demeurent identiques. Un modèle qui utilise moins de tokens de sortie peut réduire le coût par tâche complétée de davantage.
Tarifs de l'API GPT avant et après réduction
Tous les tarifs ci-dessous sont en dollars américains par million de tokens. « Tarif OpenAI » signifie traitement standard, sans Batch, Flex, Priorité, traitement régional ni contrat entreprise négocié. Les chiffres d'OpenAI proviennent de sa page de tarification et les chiffres de reAPI proviennent de ses pages de modèle en direct, tous deux vérifiés le 22 octobre 2026.[3][5]
| Modèle | Entrée OpenAI | Entrée reAPI | Sortie OpenAI | Sortie reAPI | Réduction |
|---|---|---|---|---|---|
| GPT-5.4 | $2.50 | $1.00 | $15.00 | $6.00 | 60% |
| GPT-5.5 | $5.00 | $4.00 | $30.00 | $24.00 | 20% |
| GPT-5.6 Sol | $4.00 | $3.20 | $20.00 | $16.00 | 20% |
| GPT-5.6 Terra | $2.00 | $1.60 | $12.00 | $9.60 | 20% |
| GPT-5.6 Luna | $0.20 | $0.16 | $1.20 | $0.96 | 20% |
OpenAI publie un tarif distinct pour l'entrée en cache pour ces modèles. Les pages de modèle de reAPI énumèrent maintenant les tarifs de lecture et d'écriture du cache pour les trois niveaux de GPT-5.6, aussi à 80% de celui d'OpenAI (Sol : $0.32 par million de tokens d'entrée en cache et $4 par million de tokens d'écriture de cache). Les pages de GPT-5.4 et GPT-5.5 ne répertorient pas un tarif d'entrée en cache, donc cette comparaison n'en invente pas une. Pour ces deux-là, considérez les préfixes de requête répétés comme un test de performance distinct.
Ce que la réduction de l'API GPT signifie pour une vraie facture
Supposons qu'un agent traite 100 millions de tokens d'entrée et génère 20 millions de tokens de sortie chaque mois. Avec un usage identique de tokens, le calcul mensuel est :
monthly cost = input MTok × input rate + output MTok × output rate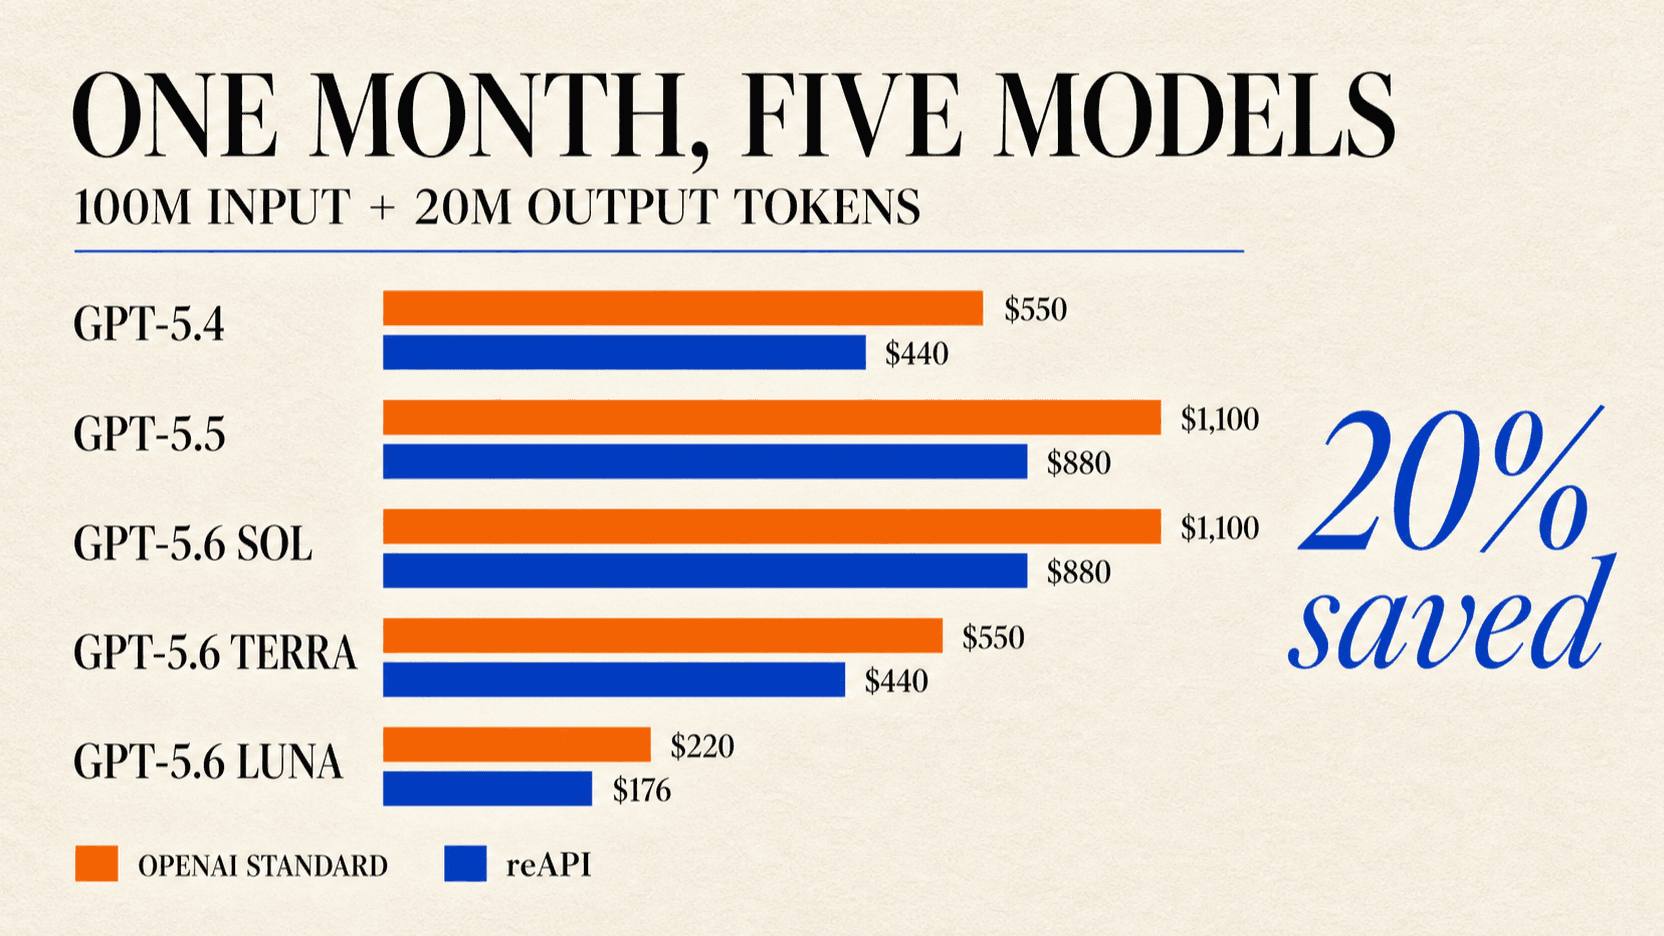
| Modèle | Standard OpenAI | reAPI | Économies mensuelles |
|---|---|---|---|
| GPT-5.4 | $550 | $220 | $330 |
| GPT-5.5 | $1,100 | $880 | $220 |
| GPT-5.6 Sol | $800 | $640 | $160 |
| GPT-5.6 Terra | $440 | $352 | $88 |
| GPT-5.6 Luna | $44 | $35.20 | $8.80 |
Pour les quatre modèles à 20% de réduction, le pourcentage est constant et l'impact en dollars croît avec les dépenses. Une équipe qui paie actuellement $10.000 par mois pour le même mélange de trafic standard non mis en cache conserverait à peu près $2.000 après migration, ou environ $6.000 sur GPT-5.4, sans considérer aucun changement dans le comportement du modèle ou la consommation de tokens.
Cette dernière condition compte. Le coût de l'API n'est pas seulement le prix par token :
cost per successful task
= price per token × tokens per attempt × attempts per success
Un modèle moins cher qui a besoin de deux tentatives peut coûter plus cher qu'un modèle coûteux qui réussit une seule fois. Un modèle plus concis peut surpasser le tableau en émettant moins de tokens de sortie facturables. OpenAI déclare que GPT-5.6 améliore l'efficacité des tokens, donc une migration soigneusement évaluée peut économiser plus que la réduction de titre de 20% par token.[1]
Quel modèle GPT réduit devriez-vous utiliser ?
Quand cet article a été publié pour la première fois, le tableau avait deux paires au même tarif. Les tarifs actuels cassent les deux : sur reAPI l'ancien GPT-5.4 est maintenant moins cher que Terra, et le plus récent Sol est moins cher que GPT-5.5.
GPT-5.6 Luna : le modèle par défaut pour le volume
Luna est le modèle au tarif le plus bas de ce groupe. OpenAI le positionne pour un travail à fort volume sensible aux coûts, avec une fenêtre de contexte de 1,05 million de tokens et une sortie maximale de 128K. C'est le candidat de première ligne pour la classification, l'extraction, le classement, le support courant et les sous-tâches d'agent bon marché.[4]
À $0.16 à l'entrée et $0.96 à la sortie par million de tokens sur reAPI, Luna coûte 90% moins cher que Terra sur les deux dimensions. Utilisez l'écart de tarif pour mener une évaluation appropriée, pas pour la sauter : mesurez l'accomplissement des tâches, les tentatives, la latence et le total de tokens de sortie.
GPT-5.6 Terra versus GPT-5.4 : niveau plus récent, prix reAPI plus élevé
Sur reAPI, GPT-5.4 coûte $1 à l'entrée et $6 à la sortie par million de tokens et Terra coûte $1.60 et $9.60, donc Terra est 60% plus cher par token. Aux tarifs de liste d'OpenAI l'ordre s'inverse : $2/$12 de Terra est en dessous de $2.50/$15 de GPT-5.4.[5] Terra reste le test naturel première pour un nouveau travail car OpenAI la décrit comme le niveau équilibré GPT-5.6, compétitif face au GPT-5.5 mais au prix inférieur à celui de l'emblématique.[1]
GPT-5.4 est l'option la moins chère sur reAPI, et reste utile quand une requête de production existante a déjà été validée contre lui. Passer à Terra coûte plus par token et n'est pas automatiquement mieux : le comportement du modèle, les défauts de raisonnement, le comportement du cache et la longueur de sortie peuvent changer. Menez une comparaison en arrière-plan avant de basculer tout le trafic.
GPT-5.6 Sol versus GPT-5.5 : modèle plus récent, tarif plus bas
Sur reAPI, Sol coûte $3.20 à l'entrée et $16 à la sortie par million de tokens contre $4 et $24 de GPT-5.5 : 20% moins en entrée et un tiers moins en sortie. La liste d'OpenAI montre le même écart, $4/$20 contre $5/$30, avec le tarif de Sol étiqueté comme promotionnel jusqu'au moins le 21 novembre 2026.[5] Sol est le nouvel emblématique et ajoute le raisonnement mis à jour, l'utilisation d'outils et les contrôles de mise en cache des requêtes de la génération GPT-5.6, tandis que GPT-5.5 est la base stable pour les équipes qui l'ont déjà affinée.[1][2]
Pour les nouveaux déploiements haute complexité, commencez l'évaluation avec Sol. Ne conservez GPT-5.5 que si les tests de régression montrent que son comportement établi gagne sur votre charge.
Quand 20% de réduction n'est pas l'option la moins chère
Une table de tarification nette est utile, mais trois détails de facturation peuvent inverser une comparaison étroite.
Traitement Batch et Flex
OpenAI propose le traitement Batch et Flex à 50% des tarifs standards pour GPT-5.4, GPT-5.5 et les niveaux de GPT-5.6.[2][5]Si une charge peut attendre et n'a pas besoin de réponse immédiate, comparez ces tarifs asynchrones avec le tarif en direct de reAPI au lieu de comparer uniquement le traitement standard.
À 50% de réduction, OpenAI Batch surpasse une réduction de 20%. GPT-5.4 est l'exception : $1/$6 de reAPI est en dessous du tarif Batch d'OpenAI de $1.25/$7.50.[5] Sinon, la réduction de 20% de reAPI s'applique plus directement au trafic d'API synchrone et standard. Un travail d'enrichissement hors ligne nocturne a une économie différente d'un agent de codage en direct.
Mise en cache des requêtes
OpenAI liste les lectures en cache pour GPT-5.6 à 10% du tarif d'entrée sans cache. GPT-5.6 facture aussi les écritures de cache explicites à 1,25 fois le tarif d'entrée sans cache, donc le résultat net dépend de la fréquence de réutilisation du préfixe.[1]
Pour une longue requête système réutilisée des centaines de fois, le taux de réussite du cache peut importer plus qu'une réduction de 20% du tarif d'entrée ordinaire. Suivez séparément l'entrée sans cache, les tokens d'écriture de cache, les tokens de lecture de cache et la sortie.
Requêtes long contexte
Pour GPT-5.4 et les modèles GPT-5.6 avec des fenêtres de contexte de 1,05 million, OpenAI tarifie les requêtes au-dessus de 272K tokens d'entrée à 2x l'entrée et 1,5x la sortie pour toute la requête.[4][6]Les pages de modèle de reAPI énumèrent les tarifs long contexte pour les niveaux de GPT-5.6 (Sol : $6.40 à l'entrée et $24 à la sortie par million de tokens) mais pas pour GPT-5.4 ou GPT-5.5. Si vos requêtes dépassent ce seuil, testez une requête représentative et vérifiez l'utilisation facturée avant de projeter les économies.
Comment utiliser les tarifs d'API GPT réduits
reAPI expose une extrémité compatible OpenAI, donc le client Python a besoin d'une URL de base différente. Cet exemple utilise Terra, le niveau équilibré :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://api.reapi.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-5.6-terra",
    messages=[
        {"role": "user", "content": "Review this pull request for data-loss risks."}
    ],
)

print(response.choices[0].message.content)
Les identifiants de modèle disponibles sont :
gpt-5.4gpt-5.5gpt-5.6-solgpt-5.6-terragpt-5.6-luna
Ne remplacez pas les points par des traits d'union dans les requêtes d'API. Le site web de reAPI utilise des slugs de page avec traits d'union, mais les identifiants de modèle wire conservent les numéros de version pointés d'OpenAI.
Liste de contrôle de migration sûre
Déplacer une route d'API est simple ; prouver que la nouvelle route est économique demande un peu plus de travail.
- Exportez un échantillon représentatif. Incluez des requêtes courtes et longues, des appels d'outils, une sortie structurée et des cas d'échec connus.
- Épinglez l'identifiant du modèle. Ne comparez pas le déplacement d'alias si vous avez besoin d'un résultat avant-après stable.
- Exécutez les deux routes. Mesurez la qualité de réponse, la latence du premier token, la latence totale, les tokens d'entrée, les tokens de sortie, les tentatives et les erreurs.
- Calculez le coût par résultat accepté. Le prix des tokens seul masque les tentatives et l'examen manuel.
- Inspectez la compatibilité des fonctionnalités. Validez les outils, les sorties structurées, le streaming et l'entrée d'images utilisés par l'application.
- Déplacez le trafic progressivement. Commencez avec un petit pourcentage et gardez l'ancienne route disponible jusqu'à ce que les taux d'erreur et les factures correspondent au test.
- Vérifiez la table de tarification en direct. Les tarifs peuvent changer après la publication d'un article ; traitez la page du modèle et la table de tarification de l'API comme source de vérité.
Questions fréquemment posées
OpenAI a-t-il baissé les tarifs de l'API GPT ?
Pour la famille GPT-5.6, oui. La page de tarification d'OpenAI, vérifiée le 22 octobre 2026, énumère GPT-5.6 Sol à $4/$20 (étiqueté comme promotionnel jusqu'au moins le 21 novembre 2026), Terra à $2/$12 et Luna à $0.20/$1.20 par million de tokens d'entrée et de sortie, tous inférieurs à la première publication de cet article. GPT-5.4 ($2.50/$15) et GPT-5.5 ($5/$30) sont inchangés. Les réductions décrites ici sont les tarifs reAPI par rapport à ces tarifs standards actuels.[5]
Quels modèles GPT coûtent 20% moins cher sur reAPI ?
GPT-5.5, GPT-5.6 Sol, GPT-5.6 Terra et GPT-5.6 Luna sont 20% en dessous des tarifs standards d'OpenAI pour l'entrée et la sortie. GPT-5.4 est 60% en dessous. Les tarifs s'appliquent aux tarifs de tokens d'entrée et de sortie publiés sur les routes par défaut de reAPI.[3]
Quel est le modèle GPT-5.6 API le moins cher ?
GPT-5.6 Luna. Il coûte $0.20 à l'entrée et $1.20 à la sortie par million de tokens au tarif standard d'OpenAI, ou $0.16 à l'entrée et $0.96 à la sortie sur la route par défaut actuelle de reAPI.[3][4]
GPT-5.6 Terra coûte-t-il moins cher que GPT-5.4 ?
Non sur reAPI, où GPT-5.4 est $1/$6 et Terra est $1.60/$9.60. Aux tarifs de liste d'OpenAI c'est l'inverse : Terra $2/$12, GPT-5.4 $2.50/$15. Terra est plus récent, mais la meilleure valeur dépend du succès des tâches, de l'efficacité des tokens et du risque de migration.
GPT-5.6 Sol coûte-t-il moins cher que GPT-5.5 ?
Oui. Sur reAPI Sol est $3.20/$16 par million de tokens d'entrée/sortie contre $4/$24 de GPT-5.5, et au tarif standard d'OpenAI c'est $4/$20 contre $5/$30. Sol offre le niveau de capacité le plus récent au prix par token le plus bas.[1]
reAPI offre-t-il l'entrée en cache réduite ?
Pour les niveaux de GPT-5.6, oui : les pages de modèle énumèrent les lectures de cache à $0.32 (Sol), $0.16 (Terra) et $0.016 (Luna) par million de tokens, 80% de les tarifs d'entrée en cache d'OpenAI. GPT-5.4 et GPT-5.5 n'ont pas un tarif d'entrée en cache publié sur reAPI, donc ne supposez pas une. Comparez une vraie charge en cache et vérifiez la facturation en direct avant migration.
Puis-je continuer à utiliser le SDK Python OpenAI ?
Oui. Définissez base_url à https://api.reapi.ai/v1, utilisez une clé reAPI et conservez l'identifiant de modèle GPT en pointillés canonique.
La réduction de prix est utile ; le coût par résultat est le facteur décisif
Une réduction de 20% est inhabituellement facile à budgéter. Gardez la charge et le modèle fixes, et une facture de $1.000 de tokens standards devient environ $800, ou environ $400 sur GPT-5.4. L'opportunité plus précieuse est l'acheminement du modèle : Luna pour le volume courant, Terra par défaut équilibré, et Sol uniquement où la capacité frontière améliore suffisamment le taux de succès pour se payer elle-même.
Le titre honnête est donc plus étroit que « OpenAI a baissé les prix » et plus utile aux développeurs : cinq modèles GPT actuels s'exécutent en dessous des tarifs de tokens standards OpenAI sur reAPI, quatre à 80% et GPT-5.4 à 40%. Vérifiez votre motif de cache, votre utilisation du long contexte et vos options asynchrones, puis mesurez le coût par résultat accepté avant de déplacer le trafic de production.
Références
- OpenAI. GPT-5.6: Frontier intelligence that scales with your ambition. Pricing and tier details. openai.com/index/gpt-5-6
- OpenAI. Introducing GPT-5.5. API pricing and processing options. openai.com/index/introducing-gpt-5-5
- reAPI. GPT model pages and live rates. Retrieved October 22, 2026. reapi.ai/models
- OpenAI. GPT-5.6 Luna model. Specifications, pricing, caching, and long-context rules. developers.openai.com/api/docs/models/gpt-5.6-luna
- OpenAI. API pricing. Standard, Batch, Flex, and Fast processing rates. Retrieved October 22, 2026. developers.openai.com/api/docs/pricing
- OpenAI. GPT-5.4 model. Pricing and long-context rules. developers.openai.com/api/docs/models/gpt-5.4
Lectures complémentaires
- reAPI. How to use GPT-5.6. reapi.ai/blog/how-to-use-gpt-5-6
- reAPI. How to use GPT-5.5. reapi.ai/blog/how-to-use-gpt-5-5
- reAPI. GPT-5.6 model catalog. reapi.ai/models
Auteur

Catégories
Plus d'articles
CLAUDE.md : le fichier qui améliore les agents de codage
Découvrez ce que CLAUDE.md fait, pourquoi quatre règles simples sont populaires, ce qu'inclure et comment construire des instructions de projet.
Seedance 2.0 "Not Eligible" : causes et solutions efficaces
L’erreur not eligible de Seedance 2.0 vient de la détection des visages et de la propriété intellectuelle : déclencheurs, vérifications et solutions.
Seedream 5.0 Pro : limites documentées et retests
Distinguez limites documentées et paramètres par défaut de Seedream 5.0 Pro des défauts visuels. Mesurez via tests reproductibles plutôt qu'un seul résultat.