DeepSeek V4 1M : max_tokens, facturation et concurrence
DeepSeek V4 partage 1M tokens entre entrée et sortie (384K max). Découvrez max_tokens, la facturation du cache et les limites de concurrence.
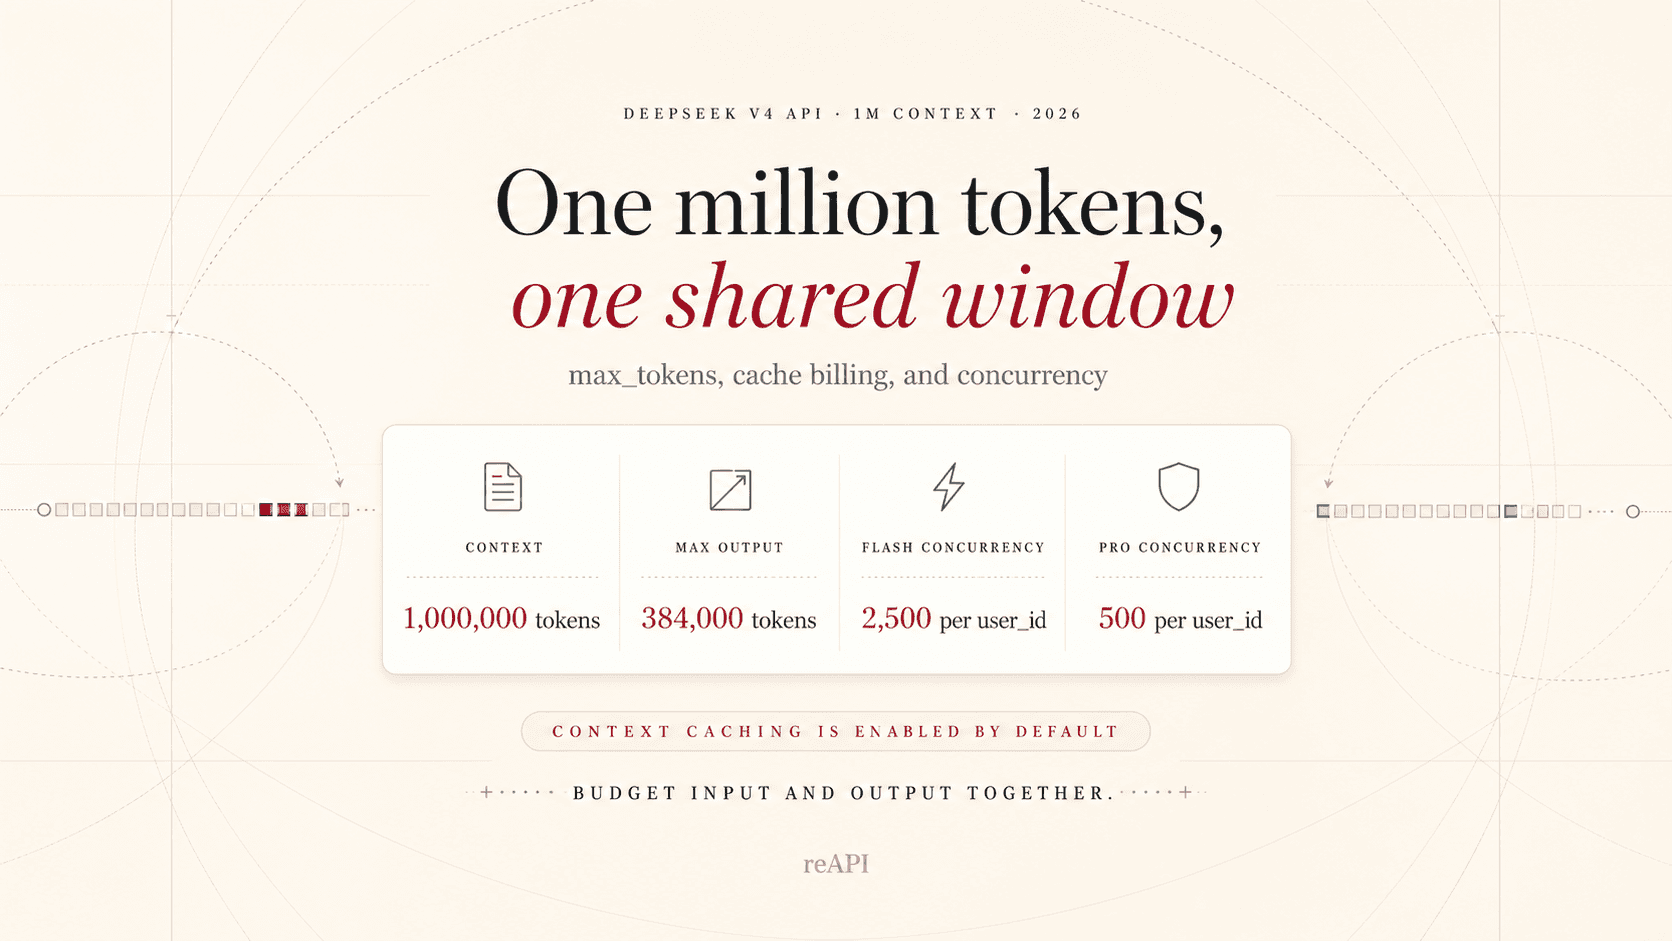
La fenêtre de contexte 1M de DeepSeek V4 est un budget partagé entre l'entrée et la sortie. Cela ne signifie pas que vous pouvez envoyer 1M tokens en entrée et générer ensuite 384K supplémentaires. La figure de 384K est le maximum de sortie, tandis que max_tokens est le plafond de sortie que vous fixez pour une requête. La sortie réelle est également limitée par l'espace restant dans la fenêtre 1M[1][2].
Ce guide répond aux questions pratiques derrière cette spécification : comment budgétiser l'entrée et la sortie, comment fixer max_tokens, ce que les tokens de raisonnement font de l'utilisation, comment fonctionne la facturation du cache, et pourquoi Flash et Pro ont des limites de concurrence différentes.
Limites de DeepSeek V4 en un coup d'œil
| Élément | Spécification officielle |
|---|---|
| Identifiants de modèle | deepseek-v4-flash, deepseek-v4-pro |
| Fenêtre de contexte | 1M tokens, partagée par l'entrée et la sortie générée |
| Sortie maximale | 384K tokens |
max_tokens | Plafond de complément par requête; ne peut pas dépasser le contexte restant ou la limite de sortie du modèle |
| Mode par défaut | Raisonnement activé; les requêtes ordinaires prennent par défaut reasoning_effort: high |
| Cache | Le cache disque du contexte est activé automatiquement |
| Concurrence API directe | Flash 2 500; Pro 500, par compte |
| Interfaces | Chat Completions OpenAI et compatible Anthropic |
DeepSeek a publié l'aperçu V4 le 24 avril 2026 avec les variantes Flash et Pro et une fenêtre de contexte 1M[3]. La page de tarification officielle liste le même plafond de sortie 384K pour les deux modèles, ainsi que la sortie JSON, les appels d'outils, la complément préfixée et la complément FIM[1].
1M signifie-t-il uniquement l'entrée ?
Non. La référence Chat Completions de DeepSeek indique que la longueur totale des tokens d'entrée et des tokens générés est limitée par la longueur du contexte du modèle[2].
Utilisez ce modèle mental :
tokens d'entrée + tokens générés <= contexte 1M
tokens générés <= max_tokens
tokens générés <= limite de sortie du modèle 384K
Si l'invite remplit presque la fenêtre de contexte, le modèle ne peut pas aussi retourner une réponse 384K. Réservez de l'espace pour les instructions système, les schémas d'outils, l'historique de conversation et la complément.
Une grande fenêtre ne supprime pas non plus la valeur de la récupération et de la segmentation. L'envoi de moins de contexte, mieux organisé, améliore souvent la latence, le coût et la pertinence des réponses.
Comment fixer max_tokens
max_tokens est la longueur de complément maximale pour une requête. Un finish_reason de length peut signifier que la requête a atteint ce plafond ou épuisé le contexte disponible[2].
Points de départ raisonnables :
| Charge de travail | Plafond de départ |
|---|---|
| Classification, extraction, réponses brèves | 1K–4K |
| Revue de code et résumés de documents | 4K–16K |
| Longs rapports et plans de migration | 16K–64K |
| Génération extrême de long-forme | Augmentez seulement après mesure du coût et de la troncature |
Ce sont des points de départ d'ingénierie, pas des exigences officielles. Mesurez finish_reason, les tokens de complément réels, la latence et le taux de sortie utile avant d'augmenter le plafond.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://api.reapi.ai/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {
            "role": "user",
            "content": "Review this repository inventory and produce a risk-ranked migration plan.",
        }
    ],
    max_tokens=16_384,
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"},
        "group": "default",
    },
)
Consultez la référence API DeepSeek V4 pour les champs de requête reAPI, et la page du modèle DeepSeek V4 pour le playground et les tarifs de passerelle en direct.
Tokens de raisonnement et utilisation de complément
Le mode raisonnement est activé par défaut. DeepSeek retourne le raisonnement dans reasoning_content, et l'objet d'utilisation peut le rapporter séparément comme completion_tokens_details.reasoning_tokens[4][2].
Planifiez la capacité de complément autour du raisonnement ainsi que de la réponse finale visible. En mode raisonnement, temperature, top_p, presence_penalty et frequency_penalty sont acceptés pour la compatibilité mais n'entrent pas en vigueur[4].
Pour l'extraction déterministe ou le travail à faible latence, testez Flash avec le raisonnement désactivé. Gardez le raisonnement activé pour la planification, la programmation et l'utilisation d'outils multi-étapes où le raisonnement supplémentaire est utile.
Faut-il conserver le raisonnement précédent avec les outils ?
La règle actuelle de DeepSeek dépend de la présence de tools dans la requête. Avec les outils, renvoyez les messages précédents de l’assistant avec leur reasoning_content ; ce raisonnement compte dans le contexte. Sans outils, il peut être omis et sera ignoré même s’il est transmis. Une boucle d’outils ne doit donc pas supprimer systématiquement tout le raisonnement précédent[4].
Comment fonctionne la facturation
Vérification des prix du 22 octobre 2026 : le tableau du 30 juillet ci-dessous est un relevé historique, pas un devis actuel. L'API directe de DeepSeek distingue les heures pleines et creuses pour les entrées en cache, les entrées hors cache et les sorties. Les heures pleines vont de 01:00–04:00 et de 06:00–10:00 UTC, du lundi au vendredi, hors jours fériés chinois. Toutes les autres heures sont creuses, avec des tarifs réduits de moitié. La même page recommande désormais deepseek-flash : l'ancien nom deepseek-v4-flash reste accepté, mais les requêtes sont traitées par DeepSeek-V4.1-Flash-1017 au tarif Flash. Ces règles concernent DeepSeek Direct et ne garantissent ni le modèle servi ni le tarif de reAPI. Pour reAPI, consultez le modèle exact et la facturation actuelle sur la page V4 ou la page V4.1 Flash[7].
DeepSeek Direct facture trois buckets de tokens :
- entrée mise en cache;
- entrée non mise en cache;
- sortie.
Les tarifs USD officiels au 30 juillet 2026 étaient[1] :
| Modèle | Entrée mise en cache / 1M | Entrée non mise en cache / 1M | Sortie / 1M |
|---|---|---|---|
| DeepSeek V4 Flash | $0,0028 | $0,14 | $0,28 |
| DeepSeek V4 Pro | $0,003625 | $0,435 | $0,87 |
La formule générale est :
coût =
  entrée_mise_en_cache / 1M × tarif_mise_en_cache
  + entrée_non_mise_en_cache / 1M × tarif_non_mise_en_cache
  + sortie / 1M × tarif_sortie
Ce sont les tarifs directs de DeepSeek. reAPI est une passerelle distincte avec ses propres tarifs USD en direct, donc utilisez la carte de tarification sur la page reAPI DeepSeek V4 pour la facturation de passerelle.
Tirer parti du cache de contexte
Le cache disque de DeepSeek est activé automatiquement. Une requête ultérieure ne reçoit un cache hit que lorsqu'elle correspond complètement à une unité préfixe stockée; une formulation similaire ne suffit pas[5].
Mettez le contenu stable en premier :
invite système stable
+ schémas d'outils stables
+ corpus de référentiel ou de document inchangé
+ la question qui change par requête
Utilisez les champs de réponse prompt_cache_hit_tokens et prompt_cache_miss_tokens pour calculer le taux de hit réel. N'estimez pas les économies à partir de la similarité d'invite seule.
Concurrence Flash et Pro
DeepSeek Direct publie des limites de concurrence au niveau du compte de 2 500 pour Flash et 500 pour Pro. Une requête occupe un créneau de concurrence jusqu'à ce que sa réponse se termine. La limite est par compte, pas par clé API, et les requêtes excédentaires reçoivent HTTP 429[6].
Le user_id optionnel peut isoler le comportement de sécurité, de cache et de planification, mais les comptes ordinaires partagent toujours la concurrence de compte total entre tous les user_id. La création de clés ou d'user_id supplémentaires n'augmente pas la capacité.
Ces chiffres s'appliquent à DeepSeek Direct. La concurrence et la mise en file d'attente de passerelle peuvent différer; lors de l'utilisation de reAPI, respectez les limites et réponses publiées par reAPI.
Liste de contrôle de production pour les requêtes de contexte 1M
- Comptez les tokens au lieu de traiter les caractères comme des tokens.
- Réservez le contexte pour la sortie, les schémas d'outils et les tours de suivi.
- Fixez
max_tokensà la tâche, pas automatiquement à 384K. - Enregistrez
finish_reasonet distinguez la troncature des arrêts naturels. - Gardez les préfixes réutilisables stables et suivez les tokens de hit du cache.
- Mesurez l'utilisation du raisonnement séparément de la longueur de réponse visible.
- Réessayez les réponses 429 avec backoff exponentiel et gigue.
- Routez le travail routinier à fort volume vers Flash et réservez Pro pour les tâches plus difficiles.
- Utilisez les identifiants de modèle V4 actuels; la date de dépréciation annoncée par DeepSeek pour
deepseek-chatetdeepseek-reasonerétait le 24 juillet 2026[3].
FAQ
DeepSeek V4 Flash prend-il en charge le contexte 1M ?
Oui. Flash et Pro ont tous deux une fenêtre de contexte 1M et un maximum de sortie 384K[1].
Le contexte 1M est-il entièrement l'entrée ?
Non. L'entrée et la sortie générée partagent la limite de contexte du modèle[2].
Puis-je fixer max_tokens à 384K ?
384K est le plafond de sortie du modèle, mais la requête doit aussi avoir suffisamment d'espace dans la fenêtre de contexte 1M. Le paramètre ne garantit pas une complément 384K.
Les tokens de raisonnement comptent-ils vers l'utilisation de complément ?
Les plans de capacité et de facturation doivent les inclure. DeepSeek rapporte les tokens de raisonnement dans les détails d'utilisation de complément[2].
Les limites de concurrence sont-elles par clé API ?
Non. DeepSeek Direct limite la concurrence par compte : 2 500 pour Flash et 500 pour Pro[6].
Dois-je activer la mise en cache du prompt ?
Non. Le cache disque de contexte est automatique. Gardez les préfixes partagés stables et inspectez les champs de cache hit dans usage[5].
Lectures complémentaires
- Modèle DeepSeek V4 et tarification en direct
- Référence API DeepSeek V4
- Parcourir les modèles de chat reAPI
Références
-
DeepSeek. Models & Pricing — V4 context, output, features, prices, and concurrency. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/pricing
-
DeepSeek. Create Chat Completion — max_tokens, context limits, finish reasons, and usage. Retrieved July 30, 2026 from api-docs.deepseek.com/api/create-chat-completion
-
DeepSeek. DeepSeek-V4 preview release. April 24, 2026. api-docs.deepseek.com/news/news260424
-
DeepSeek. Thinking Mode — controls, reasoning effort, and reasoning content. Retrieved September 8, 2026 from api-docs.deepseek.com/guides/thinking_mode
-
DeepSeek. Context Caching — prefix matching and usage fields. Retrieved July 30, 2026 from api-docs.deepseek.com/guides/kv_cache
-
DeepSeek. Rate Limit & Isolation — account-level concurrency and user_id. Retrieved July 30, 2026 from api-docs.deepseek.com/quick_start/rate_limit
-
DeepSeek. Models & Pricing. Vérifié à nouveau le 22 octobre 2026. api-docs.deepseek.com/quick_start/pricing
Auteur

Catégories
max_tokensTokens de raisonnement et utilisation de complémentFaut-il conserver le raisonnement précédent avec les outils ?Comment fonctionne la facturationTirer parti du cache de contexteConcurrence Flash et ProListe de contrôle de production pour les requêtes de contexte 1MFAQDeepSeek V4 Flash prend-il en charge le contexte 1M ?Le contexte 1M est-il entièrement l'entrée ?Puis-je fixer max_tokens à 384K ?Les tokens de raisonnement comptent-ils vers l'utilisation de complément ?Les limites de concurrence sont-elles par clé API ?Dois-je activer la mise en cache du prompt ?Lectures complémentairesRéférencesPlus d'articles
Alternative à Kie AI : prix, fiabilité et crédits gratuits comparés
Vous cherchez une alternative à Kie AI ? Comparez les prix de kie.ai et reAPI pour Seedance, Wan 3.0, GPT Image et Nano Banana, et voyez si Kie AI est fiable ou gratuit.
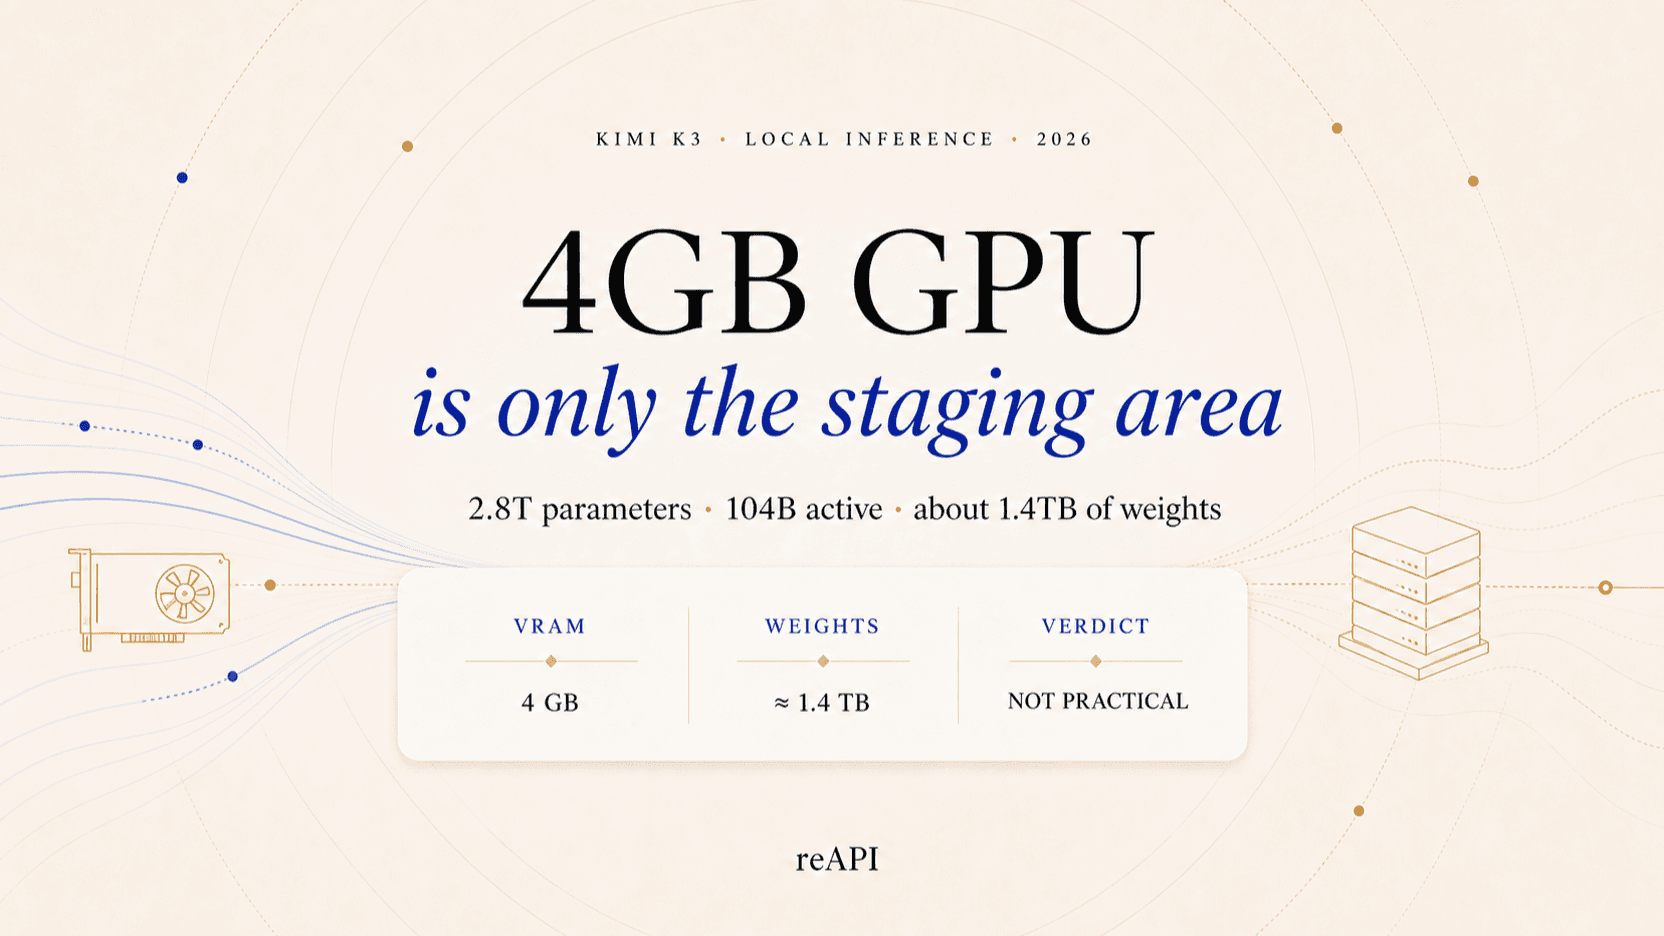
Kimi K3 sur 4GB : démêler 2,8 trillions de paramètres
Kimi K3 tient-il réellement sur 4GB ? Comprenez les calculs de 1,4TB, le déchargement par couche, le support logiciel et la route API pratique.
Guide d'intégration et de tarification de l'API Kling
Comparez les tarifs actuels de l'API Kling, choisissez Kling 3.0 ou Turbo, et implémentez la génération vidéo, l'interrogation, les tentatives et le stockage.