GPT-6 Luna API и temperature: почему приходит 400 и что отправлять
Как задать temperature в GPT-6 Luna API? Почему GPT-6 Luna и Sol отвечают 400 на temperature и top_p, точный ID модели и исправленный запрос.
Если вы попробуете задать temperature в GPT-6 Luna API, обычно получите HTTP 400, а не более сдержанный ответ. Руководство OpenAI по переходу на GPT-6 предписывает убирать temperature, top_p и top_logprobs, если reasoning effort отличен от none, а в Chat Completions — ещё и logprobs[1]. По умолчанию GPT-6 Luna работает с effort medium[2], поэтому запрос, в который добавили temperature: 0.2 и не тронули effort, оказывается по неправильную сторону этого правила.
В статье разберём, что именно говорит правило, какие точные тексты ошибок разработчики публиковали из Amazon Bedrock, Azure и клиентов OpenAI, какой ID модели правильный, и покажем запрос к эндпоинту Chat Completions в reAPI до и после исправления. Те же правила действуют и для GPT-6 Sol.
Коротко
- Уберите
temperatureиtop_p. Руководство OpenAI требует убирать их, а такжеtop_logprobs, когда reasoning effort не равенnone[1]. Effort по умолчанию у Luna —medium[2]. - В reAPI правило проще:
temperature,top_p,frequency_penaltyиpresence_penaltyвозвращают400и наgpt-6-luna, и наgpt-6-sol. Не передавайте их ни в одном запросе[3][4]. - Даже
temperature: 1может не пройти. В баг-репорте Langflow выяснилось, что Converse API в Amazon Bedrock отклоняет это поле при любом значении, включая 1[5]. - Рычаг, который у вас остаётся, —
reasoning_effort:none,low,medium,high,xhighилиmax[2]. Значенияautoнет. - ID модели —
gpt-6-luna(иgpt-6-sol), ровно в таком написании[2][3]. - Первый результат с Microsoft Q&A — про другой баг. Он о том, что Azure AI Foundry отклоняет
reasoning.effort, а не о temperature[6].
Почему GPT-6 Luna отклоняет temperature
GPT-6 Luna — reasoning-модель. На странице модели OpenAI указаны "Reasoning token support" и шесть уровней effort, по умолчанию medium[2]. В чек-листе "Update API and model parameters" из руководства OpenAI по GPT-6 параметры сэмплирования вынесены под отдельный заголовок[1]:
Unsupported parameters: When reasoning effort is not none, remove temperature, top_p, and top_logprobs. For Chat Completions, also remove logprobs.
Обратите внимание на условие. Руководство привязывает удаление к reasoning effort, а не к названию модели. Там же отмечено, что GPT-6 Sol и GPT-6 Luna поддерживают none, а GPT-6 Astra и GPT-6.1 Sol — нет[1]. На практике большинство запросов идёт на medium по умолчанию, поэтому большинство запросов с temperature завершается ошибкой.
В документации reAPI зафиксирован более строгий результат. Таблица параметров для gpt-6-luna, измеренная на эндпоинте 2026-09-24, помечает temperature, top_p, frequency_penalty и presence_penalty как "Not supported by this model — sending any of them returns 400. Leave them out of the request."[3] На странице gpt-6-sol та же строка[4]. Исключения для effort none документация не описывает, так что не стройте на нём расчёт: просто вырезайте эти поля.
Какие ошибки 400 разработчики получают на самом деле
В выдаче по этой проблеме перемешаны несколько разных ошибок. Ниже — строки, которые люди публиковали открыто, откуда каждая взялась и что её исправляет.
| Текст ошибки, как в отчёте | Где | Исправление |
|---|---|---|
| "Only the default (1) value is supported." | OpenAI-совместимый эндпоинт Bedrock, Langflow отправляет temperature 0.1[5] | Уберите temperature |
| "This model doesn't support the temperature field. Remove temperature and try again." | Bedrock Converse, из Langflow (по умолчанию 0.7) и Phoenix (по умолчанию 1)[5][7] | Уберите temperature, затем top_p — Converse отклоняет его так же[5] |
| "Unsupported parameter: 'reasoning.effort' is not supported with this model." | Агенты Azure AI Foundry и project-эндпоинт Foundry[6][8] | Дело не в temperature; см. ответ про Azure в FAQ |
| "Function tools with reasoning_effort are not supported for gpt-6-luna in /v1/chat/completions. To use function tools, use /v1/responses or set reasoning_effort to 'none'." | OpenAI Chat Completions, Ruby-клиент с tools[9] | Используйте Responses API или effort none, как указано на странице модели OpenAI[2] |
| "Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22" | Определение агента в Foundry[10] | Сообщено для Azure; дело не в temperature |
Два из этих отчётов показывают, что поле попадает в запрос без чьего-либо решения. Playground Phoenix для AWS начинает каждый запуск с temperature: 1 из конфигурации по умолчанию, и очистить его слайдер нельзя[7]. Компонент Bedrock в Langflow по умолчанию отправляет Temperature 0.7 и Top P 0.9[5]. Так что если в вашем коде temperature не упоминается, а ошибка всё равно есть, проверьте значения по умолчанию во фреймворке.
Как задать temperature в GPT-6 Luna API на reAPI: до и после
reAPI отдаёт GPT-6 Luna через POST https://reapi.ai/api/v1/chat/completions, ключ reAPI передаётся как bearer-токен[3]. Этот запрос несёт привычки от старых чат-моделей и будет отклонён:
# Rejected: temperature and top_p return 400 on gpt-6-luna
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "temperature": 0.2,
    "top_p": 0.9
  }'
Исправленная версия убирает оба поля и задаёт те параметры, которые модель действительно учитывает. reasoning_effort в reAPI принимает все шесть уровней, а max_completion_tokens применяется вплоть до 128,000[3]:
# Accepted: no sampling fields, explicit effort and output cap
curl https://reapi.ai/api/v1/chat/completions \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      { "role": "user", "content": "Classify this ticket as billing, bug or account access: I was charged twice." }
    ],
    "reasoning_effort": "low",
    "max_completion_tokens": 1000
  }'
Reasoning-токены входят в max_completion_tokens и тарифицируются как выходные, поэтому лимит, рассчитанный только на видимый ответ, может обрезать ответ на более сложный промпт[3]. Актуальные тарифы за токен — на странице модели GPT-6 Luna.
Остальные параметры в reAPI, как они задокументированы для обеих моделей GPT-6[3][4]:
| Поле | Результат на gpt-6-luna и gpt-6-sol |
|---|---|
temperature, top_p, frequency_penalty, presence_penalty | 400, не передавайте |
seed, stop, logprobs, verbosity | Принимаются (200), но ни на что не влияют |
n | Только 1; большее значение возвращает 400 |
reasoning_effort | none, low, medium, high, xhigh, max; medium, если не указан |
response_format | Применяется, включая json_schema со strict |
tools, tool_choice | tool_calls возвращаются как при effort medium, так и при none |
Строка tools расходится с собственным правилом OpenAI для Chat Completions, где function calling разрешён только при reasoning_effort: "none"[2]. На эндпоинте reAPI при замере 2026-09-24 tools возвращали tool_calls на medium[3].
Чем заменить temperature
Temperature управляла случайностью при сэмплировании. Прямой замены в GPT-6 Luna нет, поэтому выбирайте параметр под ту задачу, ради которой вы ставили temperature.
Нужен стабильный, разбираемый вывод. Используйте response_format с JSON-схемой и strict: true. reAPI применяет его на обеих моделях GPT-6[3], а строгая схема фиксирует форму ответа — именно этого и добивались многие настройки temperature: 0.
Нужны более быстрые или дешёвые ответы. Понизьте reasoning_effort. Руководство OpenAI по reasoning описывает none для задач, критичных к задержке, вроде классификации и быстрого поиска, а low — для работы с инструментами, сценариев поддержки и черновиков[11]. Меньше reasoning-токенов — меньше и оплачиваемых выходных токенов[3].
Нужны разнообразные ответы. Ни seed, ни n в reAPI здесь не помогут. seed принимается без эффекта, а n ограничен 1[3]. Отправляйте отдельные запросы или просите несколько вариантов в одном промпте.
Нужен другой стиль. Скажите об этом в system- или developer-сообщении. Параметры сэмплирования всегда были грубым инструментом для управления тоном, и инструкции — единственный оставшийся рычаг.
Как вырезать эти поля в Python
Если общий хелпер или конфиг подставляет значения сэмплирования по умолчанию, удаляйте их перед вызовом, а не правьте каждое место вызова. Здесь используется официальный OpenAI SDK, направленный на reAPI, как в Python-примере reAPI[3]:
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://reapi.ai/api/v1")

REJECTED = {"temperature", "top_p", "frequency_penalty", "presence_penalty"}

def gpt6_params(params: dict) -> dict:
    """Drop fields that gpt-6-luna and gpt-6-sol answer with 400."""
    return {k: v for k, v in params.items() if k not in REJECTED}

params = {"temperature": 0.2, "top_p": 0.9, "max_completion_tokens": 1000}

resp = client.chat.completions.create(
    model="gpt-6-luna",
    messages=[{"role": "user", "content": "Summarize this refund policy in two sentences."}],
    reasoning_effort="low",
    **gpt6_params(params),
)
print(resp.choices[0].message.content)
Если непонятно, откуда берётся поле, во время тестов логируйте ключи итогового сериализованного тела запроса. Отчёты Phoenix и Langflow выше — как раз случаи значения по умолчанию, которое вызывающий код никогда не писал[5][7].
FAQ
GPT-6 Luna API: как задать temperature — обсуждения на GitHub
Issues на GitHub по этой теме в основном про баги в инструментах, которые отправляют temperature по умолчанию. Компонент Bedrock в Langflow отправляет 0.7 и 0.9 для temperature и top_p[5], а playground Phoenix для AWS отправляет temperature: 1 при каждом запуске[7]. В обоих отчётах запрос начинает работать, как только поля убраны. В вашем коде исправление то же: не отправляйте temperature и top_p в GPT-6 Luna.
GPT-6 Luna API: как задать temperature в Python
Никак. Не передавайте temperature и top_p в client.chat.completions.create(...), вместо них передайте reasoning_effort. В reAPI оба поля возвращают 400[3]. Хелпер на Python выше отфильтрует их, если они приходят из общего конфига.
GPT-6 Luna API: пример запроса вместо temperature
Пример — исправленный cURL-запрос выше: model со значением gpt-6-luna, массив messages, reasoning_effort: "low" и max_completion_tokens: 1000, без temperature и top_p. Он соответствует правилам для полей из документации reAPI по GPT-6 Luna[3].
Как называется модель в GPT-6 Luna API
ID модели в API — gpt-6-luna. OpenAI указывает его и как ID модели, и как единственный snapshot, с инструкцией "Use gpt-6-luna in your API requests."[2] reAPI использует ту же строку и считает её моделью, отличной от gpt-5.6-luna и gpt-6-sol[3]. В сообщениях об ошибках Azure упоминается и версия модели, gpt-6-luna-2026-09-22[10].
Есть ли reasoning auto в GPT-6 Luna API
Значения reasoning effort auto нет. Для GPT-6 Luna OpenAI перечисляет none, low, medium, high, xhigh и max, по умолчанию medium[2]. Чтобы получить значение модели по умолчанию, просто не указывайте reasoning_effort. В руководстве OpenAI по reasoning auto встречается, но для других настроек: reasoning summaries и поля reasoning.context[11].
GPT-6 Luna в Azure
Самая цитируемая проблема в Azure — не temperature. В посте на Microsoft Q&A от 29 сентября 2026 года описано, что агенты Foundry падают с ошибкой "Unsupported parameter: 'reasoning.effort' is not supported with this model"[6]. Issue на GitHub воспроизводит её на project-эндпоинте Foundry: обычные вызовы там возвращают 500, а с effort — 400, тогда как resource-эндпоинт работает с reasoning effort. Обходной путь автора — вызывать resource-эндпоинт; на момент нашей проверки 7 октября 2026 года issue оставался открытым[8].
Какой effort выбрать для GPT-6 Sol
GPT-6 Sol принимает те же шесть значений, что и Luna, по умолчанию medium[4][12]. Общая рекомендация OpenAI: none для задач, критичных к задержке, low для работы с инструментами и черновиков, medium для большинства нагрузок, high для сложной отладки и планирования, а xhigh — только если evals оправдывают дополнительные задержку и стоимость[11]. В reAPI Sol отклоняет temperature и top_p точно так же, как Luna[4].
Запросы к GPT-6 Luna, которые проходят с первого раза
Чистый запрос к GPT-6 Luna содержит model со значением gpt-6-luna, массив messages, осознанно выбранный reasoning_effort и лимит вывода с запасом на рассуждения. В нём нет temperature, top_p и полей штрафов. Если вы пришли сюда, чтобы задать temperature в GPT-6 Luna API, ответ такой: перестаньте её задавать. Стоимостью и задержкой управляйте через effort, формой ответа — через строгую JSON-схему, и проверьте, что ваш фреймворк добавляет по умолчанию. Та же структура запроса работает и для GPT-6 Sol. Параметры — в документации GPT-6 Luna и документации GPT-6 Sol, актуальные тарифы — на страницах моделей GPT-6 Luna и GPT-6 Sol.
References
- OpenAI. Using GPT-6. Дата обращения: октябрь 2026, developers.openai.com/api/docs/guides/latest-model
- OpenAI. GPT-6 Luna model page. Дата обращения: октябрь 2026, developers.openai.com/api/docs/models/gpt-6-luna
- reAPI. gpt-6-luna API documentation. Дата обращения: октябрь 2026, reapi.ai/docs/gpt-6-luna
- reAPI. gpt-6-sol API documentation. Дата обращения: октябрь 2026, reapi.ai/docs/gpt-6-sol
- Langflow on GitHub. Amazon Bedrock Converse: OpenAI GPT-6 Sol/Luna/Astra calls fail with 400 because Temperature and Top P are sent by default (#15349). Дата обращения: октябрь 2026, github.com/langflow-ai/langflow/issues/15349
- Microsoft Q&A. GPT-6-Luna agents fail with Unsupported parameter: 'reasoning.effort' error. Дата обращения: октябрь 2026, learn.microsoft.com/en-us/answers/questions/6018360
- Arize Phoenix on GitHub. Playground can't run OpenAI GPT-6 Sol/Luna/Astra on AWS Bedrock: default temperature=1 is always sent and rejected with 400 (#16430). Дата обращения: октябрь 2026, github.com/Arize-ai/phoenix/issues/16430
- Azure SDK for Python on GitHub. azure-ai-projects: gpt-6-luna returns 500 on project endpoint, works on resource endpoint (#49169). Дата обращения: октябрь 2026, github.com/Azure/azure-sdk-for-python/issues/49169
- redmine_ai_helper on GitHub. Chat fails with gpt-6 models (gpt-6-luna, gpt-6-sol): "Function tools with reasoning_effort are not supported" (#480). Дата обращения: октябрь 2026, github.com/haru/redmine_ai_helper/issues/480
- Microsoft Agent Framework on GitHub. Invalid parameter: 'text.format' of type 'json_schema' is not supported with model version gpt-6-luna-2026-09-22 (#8718). Дата обращения: октябрь 2026, github.com/microsoft/agent-framework/issues/8718
- OpenAI. Reasoning models. Дата обращения: октябрь 2026, developers.openai.com/api/docs/guides/reasoning
- OpenAI. GPT-6 Sol model page. Дата обращения: октябрь 2026, developers.openai.com/api/docs/models/gpt-6-sol
Что почитать дальше
- reAPI. GPT-6 Sol vs GPT-6 Luna. reapi.ai/blog/gpt-6-sol-vs-luna
- reAPI. GPT-6 Luna API pricing. reapi.ai/blog/gpt-6-luna-api-pricing
Автор

Категории
Ещё статьи
Seedance 2.5: 53% дороже за токен, чем Seedance 2.0
Цена Seedance 2.5 составляет $10.70 за миллион токенов на BytePlus. Смотрите перевод в цену за секунду, расчёт видео и актуальные тарифы reAPI.
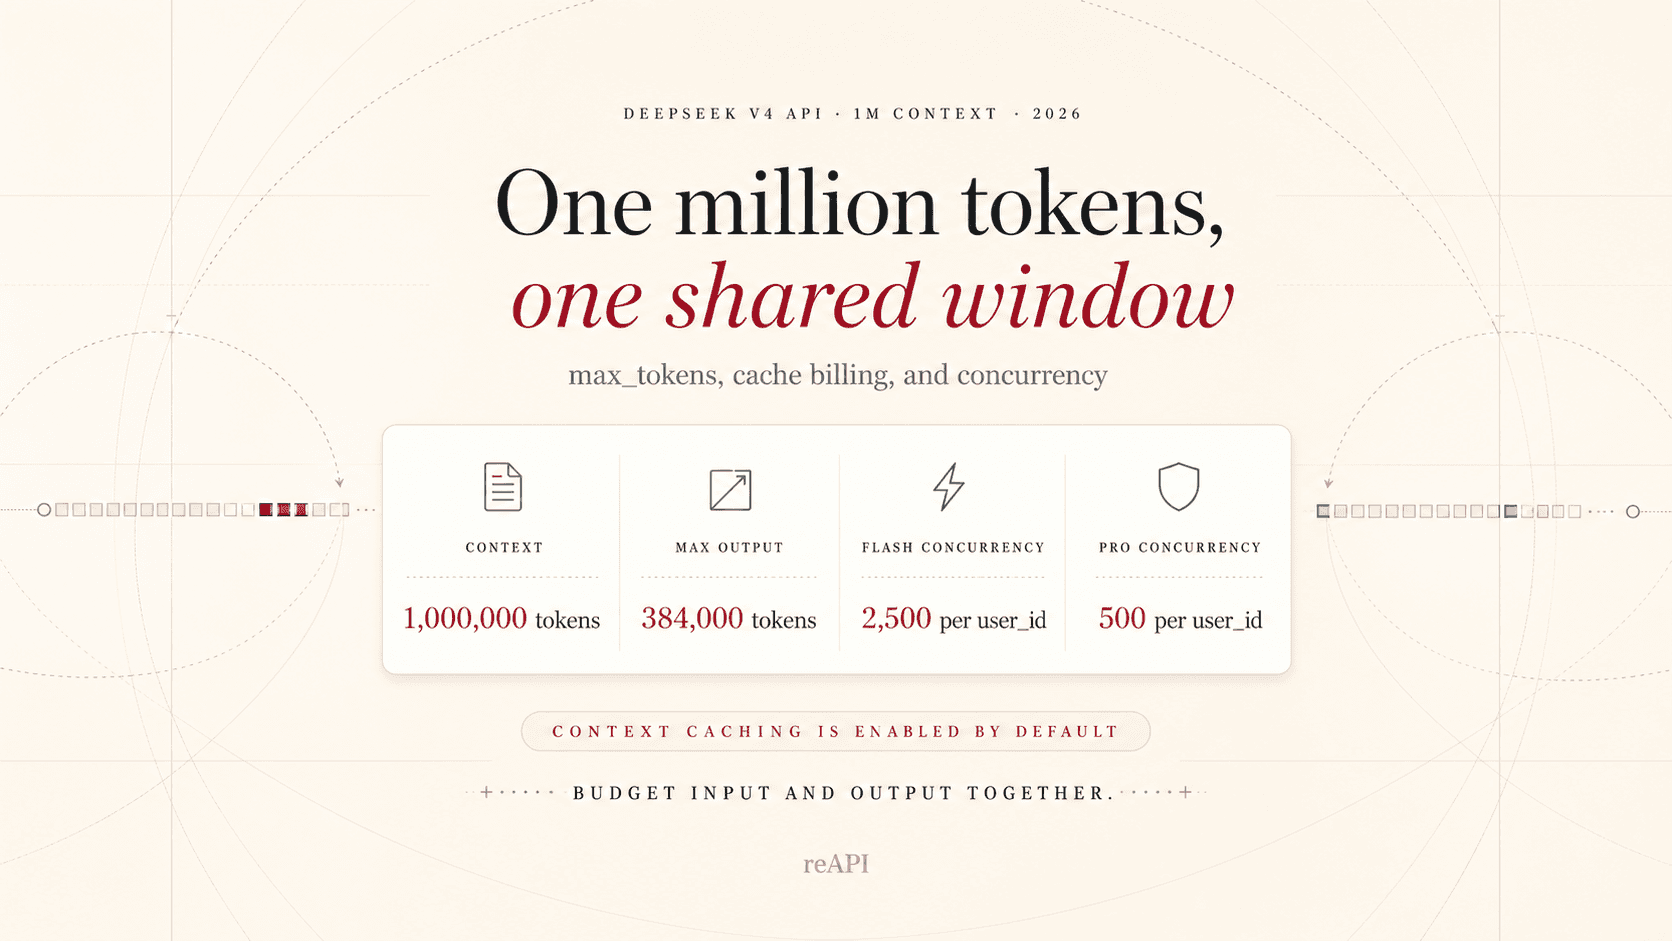
DeepSeek V4 с контекстом 1М: max_tokens, биллинг и паралелизм
DeepSeek V4 делит контекст 1М между входом и выходом с максимумом 384К на выход. Разберись с max_tokens, кешированием и лимитами параллелизма.
ИИ видеогенератор с реальными людьми: что работает
Видеогенератор ИИ с реальными людьми: согласие, документированные референсы, встроенный диалог, проверка материалов и полный возврат при отказе.