· reAPI Team
Gemini 4 Argon vs Opus 5.5:一场走红后遭到质疑的测试
Gemini 4 Argon vs Opus 5.5 软糖熊测试为何引发反驳?结合原始演示、其他开发者报告的复现和作者回应,梳理这次编程对比的证据、未核实条件与结论边界。
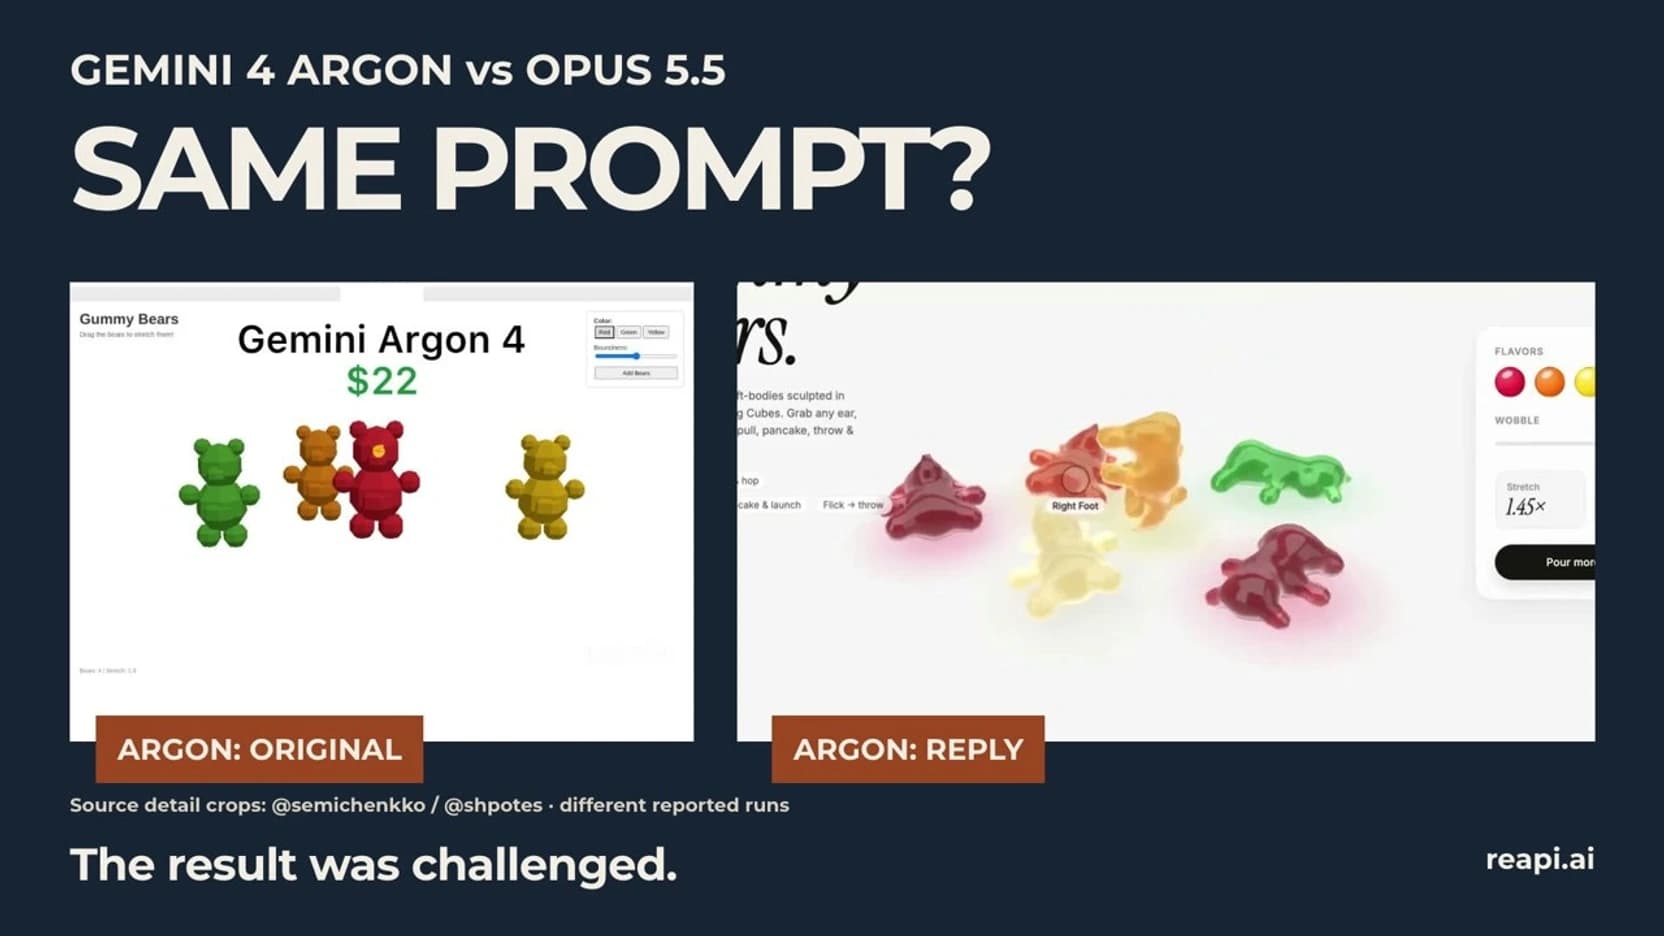
一个软糖熊模拟程序,让 Gemini 4 Argon vs Opus 5.5 的讨论变成了另一个问题:一段编程演示究竟能证明多少?在 Semichenko 发布的对比中,标注为 Claude Opus 5.5 的结果在拉伸和挤压时,比标注为 Gemini 4 Argon 的结果更有说服力。作者称,两者使用了相同的提示词[1]。随后,另一位开发者发布了一个明显不同的 Argon 结果,也表示使用了同一提示词[2]。
后续回应和最初的视频同样值得看:Semichenko 承认,这次 Gemini 运行可能失败了,需要做更多测试[3]。现有帖子记录的是围绕几个具体结果的分歧,还无法确定模型的整体排名。下面梳理相关证据、作者的回应,以及判断下一次对比时可以采用的方法。
要点速览
- Semichenko 的原帖展示了两个可交互的软糖熊模拟程序,并称使用了相同提示词。显著的视觉差异对应的是作者报告的这两次运行[1]。
- @shpotes 表示,在 Antigravity 中使用 Argon 得到了不同结果。这一示例对“第一段视频已经说明 Argon 的能力上限”的推断提出了质疑[2]。
- 原作者明确表示,Gemini 的这次运行可能失败了,需要继续测试[3]。
- 在另一条回复中,作者提议下次让每个模型各尝试三次,再选取最好的结果。这是一项方法提议,并非已经完成的重测[4]。
- 配套视频梳理了这些第三方示例。reAPI 没有开展新的受控基准测试,也没有独立核实完整测试环境及所报告的费用[5]。
观看原始对比与后续回应
我们的 2 分 18 秒视频依次介绍原始演示、其他开发者报告的复现和作者回复。它与本文相互补充,视频简介中列有素材来源[5]。
可以直接跳转到 0:19 的原始演示、0:46 的复现示例,或 1:11 的作者回应。
画面展示的是通过代码实现的交互模拟,应按编程任务来评估。把运行后的动画录成视频,并不会使它成为文生视频模型对比。上方封面采用本视频的缩略图;如需查看帖子所报告的实际结果,请看视频和链接中的原始帖子。
Gemini 4 Argon vs Opus 5.5 演示展示了什么
原帖将 Opus 的画面放在上方、Argon 放在下方,并描述了拉伸、挤压、抛掷和增加软糖熊等一系列操作。作者的批评涉及物体如何变形、如何相互作用,以及材质看起来是否合适[1]。
这些方面值得分开检查。对这项任务,我们建议评估:拖动时熊是否变形,松手后能否恢复,场景中物体增多后是否仍可正常操作,以及表面是否像所要求的材质。这些是建议采用的评估标准,并非我们对原始应用测得的结果。
把标准拆开,可以避免仅凭漂亮的表面效果决定整场编程对比。观众可能更喜欢某个结果的光照,但仍需检查交互是否正常。反过来,外观不够精致的物体也可能满足功能要求。先确定哪些要求重要,再选出你认为更好的演示。
评价展示出来的结果,与解释差异为何产生,也是两件不同的事。录屏能支持对画面中表现的有限观察。要确定原因,还需要指令、生成的项目、执行历史和设置。我们没有取得原始两次运行的完整对应记录,因此无法将这段差距单独归因于模型。
其他开发者报告的复现改变了什么
@shpotes 这样描述自己的结果(译):“同样的提示词,在 Argon + Antigravity 上得到了截然不同的结果。”附带演示中,归于 Argon 的结果出现了拉伸和变形[2]。这给观众提供了一个具体理由,去质疑第一个结果是否能代表 Argon 在这项任务上能做出的效果。
@Caxvalencia 的另一条帖子标注了“Argon - Medium”,并展示了另一个交互示例[6]。这个标签是发布者对设置的描述,不能独立证明它使用了相同指令、相同初始文件或相同的工具调用顺序。
| 公开记录 | 提供的信息 | 本文尚未核实的部分 |
|---|---|---|
| Semichenko 的原始对比 | 两个带模型标签的结果有明显视觉差异;作者称提示词相同 | 两次运行完整且可对应核对的执行记录 |
| @shpotes 的后续示例 | 报告称在 Antigravity 中用相同提示词得到了另一个 Argon 结果 | 完整环境是否与原始对比一致 |
| @Caxvalencia 的示例 | 另一个标注为 Argon、设置标为 Medium 的交互示例 | 完整一致的复现流程 |
| Semichenko 的回复 | 承认存在不确定性,并提议三次尝试取最佳结果 | 按该提议完成对比后的结果 |
原帖还附有一条引导读者查看复现结果的 Community Note(社区笔记)[1]。可以沿着其中的链接查看证据。社区笔记提供了补充背景,其中的说法仍需对照底层来源核实。
如果按这些后续帖子的表述来理解,它们削弱了“Argon 做不出可变形软糖熊”这一笼统判断。但它们不能说明两个模型各自有多高的成功率、需要多少人工干预,也不能确定谁在另一类编程任务中表现更好。一个有力的反例可以质疑绝对化结论,却不等于建立了整体排名。
作者的回应也应完整呈现
Semichenko 写道(译):“嗯,也许我的 Gemini 这次失败了,我需要再多测一些”[3]。在更早的一条回复中,作者感谢了另一位测试者,并提议在未来对比中,让每个模型各尝试三次,再选取其中最好的结果[4]。
这段回应缩小了争议的范围。没有必要假装原始画面中的差异不存在,也没有依据凭这些帖子认定作者有欺骗意图。作者已经承认这次运行存在不确定性。读者在判断那段视频时,也应看到这份承认。
“三次取最佳”回答的是一个特定问题:在选定规则下,每个模型最多尝试三次,能做出多好的结果?如果只展示胜出的那一次,首次尝试的可靠性仍然没有答案。对于今后的测试,我们建议公开所有尝试,并标明选中了哪一次,让最佳结果和失败记录都能被查看。
怎样让编程结果对比更有参考价值
以下是本文提出的测试建议。我们没有实际执行它,也没有据此还原创作者的私人会话。它的目的是让下一次结果更容易解释。
保留完整的起点。 保存准确的提示词、附件、初始项目和所有额外指令。如果从空目录开始测试,也要写明。仅仅把同一提示词复制到另一个项目里,并不能证明模型收到的上下文相同。
记录环境与设置。 写明实际使用的模型、应用或编程智能体、可用工具和设置。尽可能保存请求或会话记录。不知道的设置就标为未知,不要根据结果好不好看来反推。后续帖子提到 Antigravity,是一个有用的已披露细节,但它无法补上其他会话中缺失的信息。
提前确定尝试规则。 先决定比较的是首次尝试、固定次数内的结果,还是在规定预算内完成任务的能力。人工干预也应采用相同规则。如果某个结果需要额外的修复提示词,就公开该提示词,并计入新增工作量,不要把最终应用呈现为未经修改的首次响应。
采用相同的交互检查。 对软糖熊任务,可以定义一套可重复的操作顺序:拖动一条肢体、松手、挤压身体、让一只熊碰到另一只,再增加若干物体。记录每项要求的交互是否有效、在哪里失败,以及应用是否仍可使用。这是一份建议的验收清单,并不表示演示中的模拟已经实现物理准确的材质。
先按任务标准评分,再比较质量与花费。 原始视频中包含创作者报告的费用数字。我们没有独立核实这些数字对应的账单记录和完整工作过程[5]。自己测试时,应保留每次纳入评估的尝试所产生的用量和费用,再按相同验收标准比较花费。失败的尝试也属于评估记录的一部分。
如果准备通过 reAPI 进行评估,可以查看 Gemini 4 Argon 模型页和 Claude Opus 5.5 模型页,了解当前模型信息与价格。这些页面可以作为搭建自己测试环境的起点,但并不复现社交帖子展示的工具或会话。
如果你关心的是已发布的模型基准测试,可以阅读我们的 Gemini 4 Argon、GPT-6 Astra 与 Claude Opus 5.5 对比。那篇文章讨论特定日期的厂商基准测试表;本文关注的是这次具体的软糖熊争议。
常见问题
这场走红的测试证明 Opus 5.5 编程更强了吗?
在这一次具体的视觉对比中,展示的结果更有利于 Opus。但我们查阅的帖子没有提供经过条件控制、反复测试的评估,无法据此确定普遍的编程优势[1][3]。
后续 Argon 示例真的用了相同提示词吗?
@shpotes 明确表示用了相同提示词。这是该来源的说法。我们没有将全部提示词内容、周边上下文、设置和执行步骤,与原始会话逐项独立核对[2]。
复现结果反过来证明 Argon 获胜了吗?
这些示例无法得出普遍适用的胜者。报告中的复现质疑了从第一个 Argon 结果推导出的结论,但并没有建立成功率,也没有证明它在各类编程任务上占优[2]。
原作者回应质疑了吗?
回应了。Semichenko 表示,Gemini 的这次运行可能失败了,需要更多测试。作者还提议在未来对比中采用三次尝试取最佳结果的方式[3][4]。
这是 AI 视频生成测试吗?
公开示例涉及通过编程构建的交互模拟。我们的视频讨论的是这些结果的录屏,不是在比较文生视频模型[5]。
reAPI 重新运行了这项基准测试吗?
没有。本文和链接视频分析的是第三方报告的运行结果。我们没有独立复现完整环境、核查全部账单记录,也没有生成新的基准测试分数[5]。
选出胜者之前,还需要哪些信息
先看原始演示,再读复现帖子和作者回应。如果需要据此选择模型,应要求提供完整环境,以及在明确评估规则下的所有尝试。在这些资料齐备之前,Gemini 4 Argon vs Opus 5.5 软糖熊测试适合作为一个具体案例继续研究。为自己的工作选择模型时,应在可重复的条件下检查真正需要的行为。
参考资料
-
Semichenko (@semichenkko)。原始软糖熊对比及附带的 Community Note。 检索于 2026 年 10 月 19 日:x.com/semichenkko/status/2110131790136401989
-
@shpotes。报告使用相同提示词的 Argon + Antigravity 复现。 检索于 2026 年 10 月 19 日:x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko)。承认 Gemini 这次运行可能失败、需要更多测试的回复。 检索于 2026 年 10 月 19 日:x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko)。提议在未来对比中三次尝试取最佳结果的回复。 检索于 2026 年 10 月 19 日:x.com/semichenkko/status/2110282000246472931
-
reAPI。Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged。 检索于 2026 年 10 月 19 日:youtu.be/QR9HChbtym0
-
@Caxvalencia。Argon - Medium 交互示例。 检索于 2026 年 10 月 19 日:x.com/Caxvalencia/status/2110170790444269766