· reAPI Team
Gemini 4 Argon vs Opus 5.5: вирусный тест под вопросом
Gemini 4 Argon vs Opus 5.5: тест с мармеладными мишками вызвал возражения. Разбираем исходную демонстрацию, сообщения о повторных опытах и ответы автора.
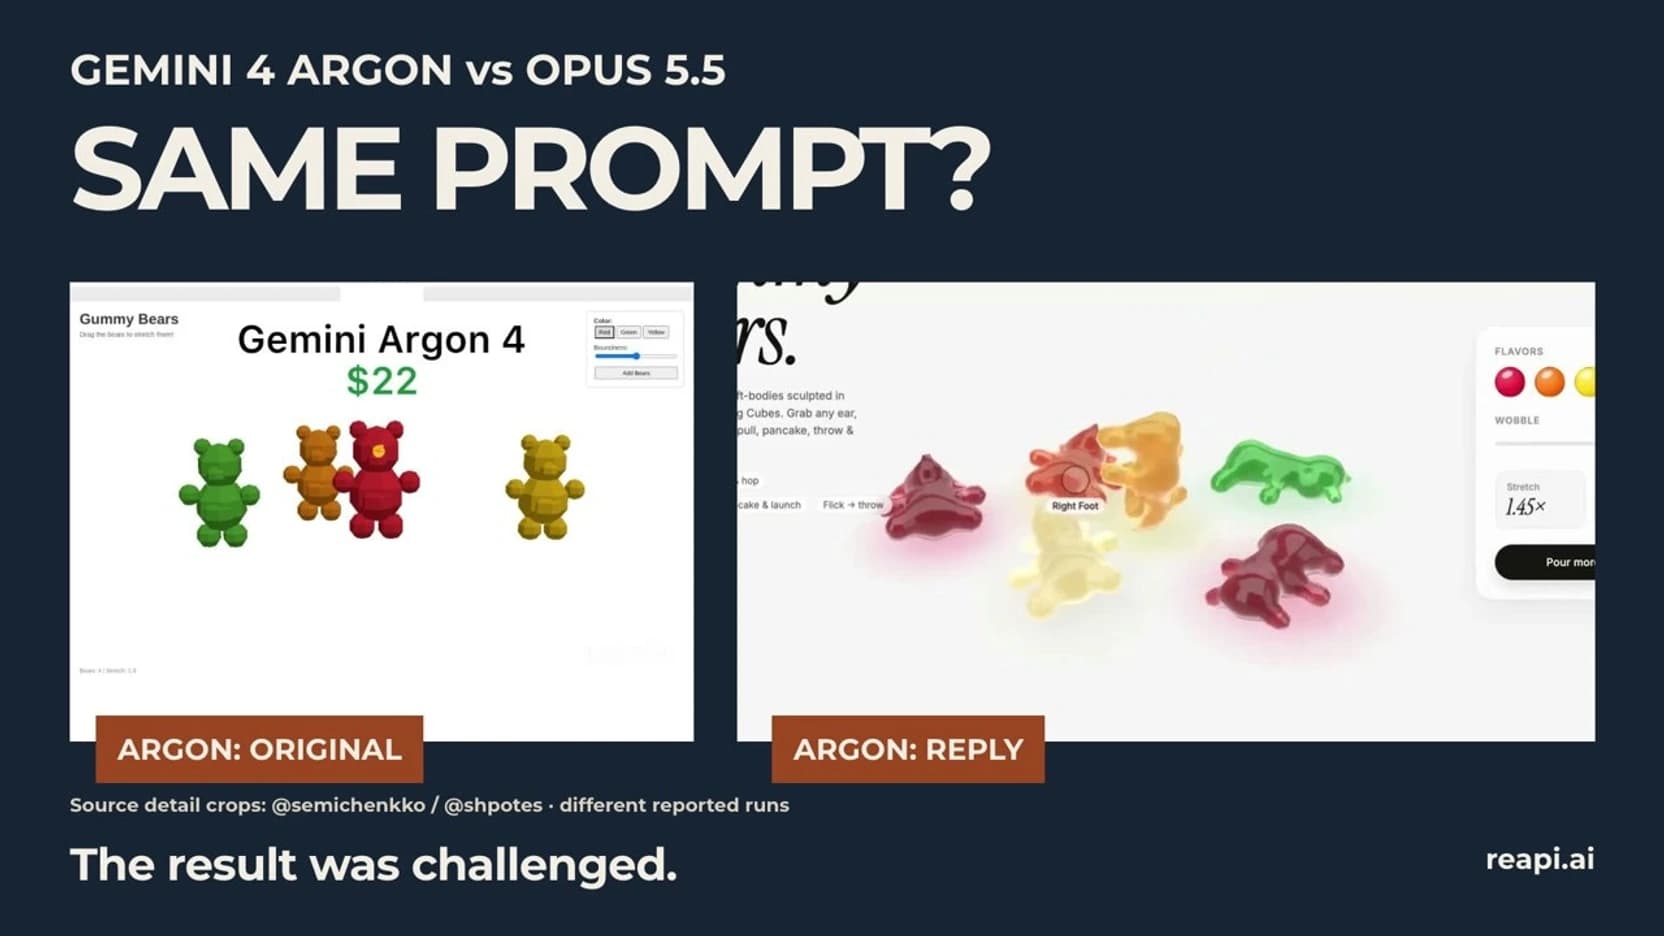
Симуляция мармеладных мишек превратила Gemini 4 Argon vs Opus 5.5 в спор о том, что способна доказать демонстрация кода. В сравнении, опубликованном Semichenko, результат с пометкой Claude Opus 5.5 растягивался и сжимался убедительнее, чем результат с пометкой Gemini 4 Argon. Автор сообщил, что обе модели получили один и тот же промпт[1]. Затем другой разработчик опубликовал заметно отличающийся результат Argon и также заявил, что использовал этот промпт[2].
Продолжение истории не менее важно, чем исходный ролик: Semichenko признал, что запуск Gemini мог оказаться неудачным и что нужны дополнительные тесты[3]. Доступные публикации фиксируют разногласие по поводу конкретных результатов. Вопрос об общем рейтинге моделей остаётся открытым. Разберём свидетельства, ответ автора и практический способ оценить следующее сравнение.
Кратко
- В исходной публикации Semichenko показаны две интерактивные симуляции мармеладных мишек и заявлено использование одинакового промпта. Яркий визуальный контраст относится именно к этим описанным запускам[1].
- @shpotes сообщает о другом результате Argon в Antigravity. Этот пример ставит под сомнение вывод о том, что первый ролик устанавливает пределы возможностей Argon[2].
- Автор исходного сравнения прямо допустил неудачный запуск Gemini и указал на необходимость дополнительных тестов[3].
- В другом ответе автор предложил в следующий раз выбирать лучший из трёх результатов каждой модели. Это предложение о методике, а не уже проведённый повторный тест[4].
- Наш сопроводительный ролик разбирает эти сторонние примеры. reAPI не проводил новый контролируемый бенчмарк и не проверял независимо полные конфигурации и заявленные расходы[5].
Посмотрите сравнение и ответы
В нашем ролике длительностью 2 минуты 18 секунд собраны исходная демонстрация, заявленное повторение и ответы автора. Он дополняет этот разбор; источники указаны в описании видео[5].
Перейдите к исходной демонстрации на 0:19, заявленному повторению на 0:46 или ответу автора на 1:11.
На записи показан результат работы кода, создающего интерактивную симуляцию. Оценивать его следует как задачу программирования. Видеозапись получившейся анимации не превращает её в сравнение моделей генерации видео по тексту. В качестве обложки использована миниатюра нашего видео. Для оценки заявленных результатов смотрите видео и исходные публикации по ссылкам.
Что показала демонстрация Gemini 4 Argon vs Opus 5.5
В исходной публикации Opus расположен над Argon; описана последовательность действий: растягивание, сжатие, броски и добавление новых мишек. Критика объединяет то, как деформируются объекты, как они взаимодействуют и как выглядит материал[1].
Эти свойства полезно проверять по отдельности. В данной задаче мы бы оценивали, меняет ли мишка форму при перетаскивании, восстанавливается ли после отпускания, остаётся ли сцена с большим числом объектов пригодной для взаимодействия и похожа ли поверхность на запрошенный материал. Это предлагаемые критерии оценки, а не измерения, которые мы провели в исходных приложениях.
Разделение критериев не позволяет привлекательной поверхности определить весь результат сравнения программирования. Зрителю может больше нравиться освещение, но взаимодействия всё равно нужно проверить. И наоборот, не самый проработанный внешне объект может выполнять функциональное требование. Определите, какие требования важны, прежде чем выбирать ролик-победитель.
Есть и различие между оценкой показанного результата и объяснением его причин. Запись может подтвердить узкое наблюдение о том, что видно на экране. Для установления причины потребовались бы инструкции, сгенерированный проект, история выполнения и настройки. Мы не получили полные сопоставимые записи обоих исходных запусков, поэтому не можем выделить модель как причину различия.
Как сообщения о повторении изменили спор
@shpotes описал свой результат так, в переводе: «Тот же промпт дал радикально иной результат на Argon + Antigravity». В приложенной демонстрации у результата, приписываемого Argon, видны растяжение и деформация[2]. Это конкретный повод усомниться в том, что первый результат отражает всё, что Argon способен создать в этой задаче.
Отдельная публикация @Caxvalencia помечена «Argon - Medium» и содержит ещё один пример взаимодействия[6]. Эта пометка — указание автора на использованную настройку. Она не подтверждает независимо, что инструкции, исходные файлы или последовательность вызовов инструментов были одинаковыми.
| Публичный материал | Что он даёт | Что здесь не проверено |
|---|---|---|
| Исходное сравнение Semichenko | Видимый контраст между двумя подписанными результатами; заявление об одинаковом промпте | Полные сопоставимые истории выполнения обоих запусков |
| Последующая публикация @shpotes | Результат Argon в Antigravity, по словам автора полученный с тем же промптом | Совпадение всей конфигурации с исходным сравнением |
| Пример @Caxvalencia | Ещё один пример взаимодействия с пометками Argon и Medium | Полностью совпадающий протокол повторения |
| Ответы Semichenko | Признание неопределённости и предложение выбирать лучший из трёх результатов | Результаты завершённого сравнения по этой методике |
Источники: исходные публикации и ответы[1][2][3][4][6].
У исходной публикации также есть примечание сообщества, которое направляет читателей к повторным опытам[1]. Перейдите по этим ссылкам и изучите свидетельства. Примечание даёт дополнительный контекст, но его утверждения всё равно нужно сверять с первоисточниками.
Если принять последующие сообщения такими, как они представлены, они ослабляют безоговорочное утверждение, что Argon не способен создавать деформируемых мишек. Они не устанавливают, как часто каждая модель добивается успеха, сколько вмешательств ей требуется и какая лучше справится с другой задачей программирования. Убедительный контрпример может поставить под сомнение абсолютное утверждение, не создавая общего рейтинга.
Ответ автора — часть этой истории
Semichenko написал, в переводе: «Хм, возможно, мой Gemini не справился, нужно больше тестировать»[3]. В более раннем ответе он поблагодарил другого участника тестирования и предложил в будущем сравнении использовать лучший из трёх результатов каждой модели[4].
Этот ответ сужает предмет спора. Нет необходимости делать вид, что исходное визуальное различие исчезло; при этом публикации не дают оснований приписывать автору намерение обмануть. Он признал неопределённость в отношении своего запуска. Читателям следует видеть это признание вместе с роликом, который им предлагают оценить.
Выбор лучшего из трёх попыток ответил бы на конкретный вопрос: насколько хороший результат каждая модель может получить за три попытки по выбранным правилам? Если показать только победившую попытку, надёжность первого результата всё ещё останется неизвестной. В будущем тесте мы бы публиковали все попытки и отмечали выбранную, чтобы и лучший результат, и история неудач оставались доступными для проверки.
Более полезный способ сравнить результаты программирования
Ниже предлагается редакционная методика тестирования. Мы её не выполняли, и она не реконструирует закрытые сессии авторов. Её цель — сделать следующий результат понятнее для оценки.
Сохраните полную исходную точку. Оставьте точный промпт, вложения, стартовый проект и дополнительные инструкции. Если тест начинается в пустом каталоге, укажите это. Один лишь перенос промпта в другой проект не подтверждает, что модели получили эквивалентный контекст.
Зафиксируйте окружение и настройки. Укажите модель, приложение или агента программирования, доступные инструменты и фактически использованные настройки. По возможности сохраните запрос или запись сессии. Неизвестную настройку так и пометьте: не пытайтесь определить её по качеству результата. Упоминание Antigravity в последующей публикации — полезная раскрытая деталь, но оно не восполняет недостающие сведения о других сессиях.
Заранее определите правила попыток. Решите, сравниваются ли первые попытки, фиксированное число попыток или выполнение в пределах заданного бюджета. Применяйте одинаковые правила вмешательства. Если результат потребовал корректирующего промпта, включите его в запись и учтите дополнительную работу вместо того, чтобы представлять готовое приложение как нетронутый первый ответ.
Проведите одинаковые проверки взаимодействия. Для задачи с мармеладными мишками задайте повторяемую последовательность: потянуть за конечность, отпустить её, сжать тело, придвинуть одного мишку к другому и добавить несколько объектов. Запишите, работает ли каждое запрошенное действие, где возникают сбои и остаётся ли приложение пригодным для использования. Это предлагаемый список приёмочных проверок, а не утверждение о том, что показанные симуляции воспроизводят физически точные свойства материалов.
Разделяйте качество и расходы до оценки задачи. В исходном ролике приведены расходы со слов автора. Мы не проверяли независимо платёжные записи и весь объём работы за этими цифрами[5]. В собственном тесте сохраняйте данные об использовании и стоимости каждой включённой попытки, а затем сопоставляйте расходы по одинаковым критериям приёмки. Неудачная попытка тоже относится к материалам оценки.
Если вы хотите провести оценку через reAPI, актуальная информация о моделях и ценах приведена на странице Gemini 4 Argon и странице Claude Opus 5.5. Эти страницы — отправные точки для вашей конфигурации; они не воспроизводят инструменты или сессии из публикаций в соцсетях.
Отдельный вопрос опубликованных бенчмарков рассматривается в нашем сравнении Gemini 4 Argon, GPT-6 Astra и Claude Opus 5.5. Оно посвящено таблице бенчмарков разработчиков моделей на определённую дату. Эта статья разбирает конкретный спор о мармеладных мишках.
Частые вопросы
Доказал ли вирусный тест, что Opus 5.5 лучше программирует?
Он показывает результат в пользу Opus в этом конкретном визуальном сравнении. В рассмотренных нами публикациях нет контролируемой оценки с повторными испытаниями, которая установила бы общее преимущество в программировании[1][3].
В повторном опыте с Argon использовался тот же промпт?
@shpotes прямо утверждает, что да. Это заявление данного источника. Мы не проверяли независимо совпадение всего содержимого промпта, сопутствующего контекста, настроек и этапов выполнения с исходными сессиями[2].
Доказывает ли повторение, что побеждает Argon?
Из этих примеров не следует общий победитель. Сообщение о повторении ставит под сомнение вывод из первого результата Argon, но не устанавливает частоту успеха или преимущество в разных задачах программирования[2].
Признал ли автор критику?
Да. Semichenko сказал, что запуск Gemini мог оказаться неудачным и нужны дополнительные тесты. Он также предложил в будущем сравнении выбирать лучший из трёх результатов[3][4].
Был ли это тест генерации видео с помощью ИИ?
Опубликованные примеры относятся к интерактивным симуляциям, созданным посредством программирования. Наш ролик обсуждает видеозаписи этих результатов. Он не сравнивает модели генерации видео по тексту[5].
Проводил ли reAPI бенчмарк заново?
Нет. Статья и видео по ссылке анализируют запуски, о которых сообщили сторонние авторы. Мы не воспроизводили независимо полные конфигурации, не изучали все платёжные записи и не получали новый результат бенчмарка[5].
Что запросить, прежде чем выбирать победителя
Начните с исходной демонстрации, затем прочитайте сообщение о повторении и ответ автора. Если вам нужно выбрать модель, запросите полную конфигурацию и все попытки, выполненные по явно указанным правилам оценки. Пока этих сведений нет, тест с мишками Gemini 4 Argon vs Opus 5.5 полезен как конкретный случай для изучения. Выбирайте модель для своей работы после проверки нужного поведения в условиях, которые можете повторить.
Источники
-
Semichenko (@semichenkko). Исходное сравнение мармеладных мишек и прикреплённое примечание сообщества. Дата обращения: 19 октября 2026 года. x.com/semichenkko/status/2110131790136401989
-
@shpotes. Сообщение о повторении с тем же промптом в Argon + Antigravity. Дата обращения: 19 октября 2026 года. x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko). Ответ с признанием возможного неудачного запуска Gemini и необходимости дальнейших тестов. Дата обращения: 19 октября 2026 года. x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko). Ответ с предложением выбирать лучший из трёх результатов для будущего сравнения. Дата обращения: 19 октября 2026 года. x.com/semichenkko/status/2110282000246472931
-
reAPI. Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged. Дата обращения: 19 октября 2026 года. youtu.be/QR9HChbtym0
-
@Caxvalencia. Пример взаимодействия «Argon - Medium». Дата обращения: 19 октября 2026 года. x.com/Caxvalencia/status/2110170790444269766