Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: benchmarks
Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5 en los 19 benchmarks de lanzamiento de Google. Compara resultados, límites de contexto y acceso antes de elegir.
Gemini 4 Argon encabezó la mayoría de filas de la comparación de lanzamiento de Google del 30 de septiembre de 2026, con excepciones. Entre Argon, GPT-6 Astra y Claude Opus 5.5, obtiene la mejor puntuación en 13 de 19 filas, empata una y pierde cinco: tres frente a Astra y dos frente a Opus[1]. Los retrocesos se concentran en terminal, software difícil y uso del ordenador, tareas relevantes para muchos desarrolladores.
Aquí se reproducen todas las cifras de Google, se añaden límites documentados y se explican las reservas metodológicas. Las búsquedas posteriores al lanzamiento incluían «gemini 4 argon benchmarks», «gemini 4 argon performance relative to other models», «gemini 4 vs gpt 6 astra» y «gemini 4 vs claude». Google ya documenta acceso por Gemini API y Google AI Studio[2]. Estas cifras conservan la fecha del lanzamiento: no son una evaluación independiente nueva ni la clasificación actual.
Resumen
- Total: Argon lidera 13 de 19 filas, Astra 3 y Opus 5.5 2, con un empate[1].
- Ventajas claras de Argon: Harvey's Legal Agent Benchmark (19.6% frente a 5.4% y 3.8%), GraphWalks 256K–1M (84.2% frente a 71.8% y 66.8%) y LVBench de vídeo largo (91.7%)[1].
- Desventajas: Opus encabeza Terminal-bench 4.0 (66.4% frente a 57.4%) y PostTrainBench; Astra, FrontierSWE v2, Terminal-Bench Science y OSWorld-2.0[1].
- Contexto y salida: Argon comparte 1,048,576 tokens entre entrada, pensamiento y salida. Cada solicitud nativa permite 32,768 para JSON o 65,536 en streaming; la generación larga continúa entre peticiones[3].
- Coste: compara tarifas actuales y uso total, incluido razonamiento y continuación. La guía de precios explica cómo.
Benchmarks de Gemini 4 Argon: tabla completa
Los números proceden del anuncio de Google. También se incluye Claude Fable 5.1 para responder a «vs Fable». La mejor puntuación entre Argon, Astra y Opus aparece en negrita; el guion indica un resultado no publicado[1].
| Área | Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|
| Trabajo del conocimiento | Vals Index | 68,9 % | 63,1 % | 67,0 % | 65,8 % |
| Trabajo del conocimiento | AutomationBench | 51,3 % | 41,4 % | 42,5 % | 31,4 % |
| Trabajo del conocimiento | Vals Finance Agent v2 | 65,4 % | 53,5 % | 58,6 % | 58,9 % |
| Trabajo del conocimiento | Harvey's Legal Agent Benchmark | 19,6 % | 5,4 % | 3,8 % | 6,7 % |
| Programación agéntica | DeepSWE v1.1 | 77,9 % | 74,1 % | 74,2 % | 67,4 % |
| Programación agéntica | FrontierSWE v2 | 55,0 % | 65,5 % | 62,3 % | 56,3 % |
| Programación agéntica | Vibe Code Bench | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| Programación agéntica | Terminal-bench 4.0 | 57,4 % | 58,2 % | 66,4 % | 57,9 % |
| Ingeniería de ML | PostTrainBench | 45,3 % | 44,3 % | 49,3 % | 40,2 % |
| Ciencia y matemáticas | Terminal-Bench Science 0.1 | 57,6 % | 68,1 % | 63,3 % | 52,6 % |
| Ciencia y matemáticas | LABBench 2 | 88,8 % | 85,4 % | 73,1 % | 68,6 % |
| Ciencia y matemáticas | RiemannBench | 76,0 % | 72,0 % | 69,6 % | 65,6 % |
| Contexto largo | GraphWalks, hasta 128K | 99,7 % | 98,7 % | 90,6 % | 91,4 % |
| Contexto largo | GraphWalks, de 256K a 1M | 84,2 % | 71,8 % | 66,8 % | 65,0 % |
| Uso del ordenador | Agent's Last Exam | 39,5 % | 34,2 % | 38,2 % | — |
| Uso del ordenador | OSWorld-2.0 (subconjunto offline) | 69,2 % | 72,6 % | — | — |
| Multimodal | Chartography | 71,6 % | 71,0 % | 66,3 % | 46,2 % |
| Multimodal | LVBench | 91,7 % | 87,5 % | 83,7 % | 79,7 % |
| Ciberseguridad | CWE-bench v1 | 68,0 % | 68,0 % | 67,0 % | 58,0 % |
Frente solo a Opus 5.5, Argon gana 14 de las 18 filas con puntuaciones para ambos. Pierde FrontierSWE v2, Terminal-bench 4.0, PostTrainBench y Terminal-Bench Science[1].
Leer los resultados con la metodología de Google
Todas las puntuaciones vienen del anuncio. La metodología explica su origen; tres detalles condicionan cuánto peso dar a las diferencias[4]:
- La mayoría de cifras rivales son autodeclaradas. Salvo indicación contraria, Google usa resultados de cada fabricante y su máximo nivel de razonamiento disponible cuando consta.
- Google calculó parte de los resultados de Argon. DeepSWE v1.1 y Terminal-bench 4.0 se ejecutaron internamente; los de Astra, Fable y Opus vienen de clasificaciones públicas o fichas del sistema. El entorno de pruebas no siempre es idéntico.
- Las entradas difieren. En LVBench, Gemini recibió un fotograma por segundo, Astra 800 fotogramas, Opus 600 y Fable 300 por limitaciones de API. Las diferencias de presupuesto visual exigen cautela al comparar vídeo largo.
La tabla ayuda a elegir qué probar. No ofrece intervalos de confianza ni un entorno común para todas las filas. Una ventaja pequeña no garantiza una diferencia en tu aplicación; una grande justifica una evaluación centrada, sin asegurar el mismo orden final.
Benchmarks de Gemini 4 Argon en una evaluación independiente
Artificial Analysis ejecuta su propio Intelligence Index en cada modelo de su lista, por lo que todos pasan por el mismo conjunto de pruebas. Su clasificación difiere de la tabla de Google. Estas cifras figuraban en sus páginas de modelos el 4 de noviembre de 2026[5]:
| Modelo (configuración evaluada) | Intelligence Index | Puesto en su lista de 62 | Tokens de salida usados para el índice | Coste por tarea del índice | Velocidad de salida |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 59 | 2 | 220M | $10,04 | 94,2 tokens/s |
| GPT-6 Astra (Max) | 57 | 5 | 54M | $6,24 | 67,1 tokens/s |
| Gemini 4 Argon (High) | 50 | 15 | 110M | $7,68 | 81,9 tokens/s |
Las configuraciones no son idénticas. Argon solo aparece en High, mientras que Astra y Opus 5.5 figuran en Max. Aun así, la misma clasificación sitúa a GPT-6 Astra en High en séptimo lugar, por delante de Argon en High. Artificial Analysis también asigna a Argon un precio de $4 de entrada y $20 de salida por millón de tokens, la tarifa que Google aplica a partir del 1 de diciembre, en lugar de los $2 y $10 introductorios descritos en nuestra guía de precios de Gemini 4 Argon.
Hay dos lecturas válidas. En los 19 benchmarks de tareas de Google, Argon lidera la mayoría de filas. En un único índice independiente, Opus 5.5 y Astra obtienen puntuaciones mayores. Astra también es el más eficiente en tokens de los tres: utilizó aproximadamente la mitad de los tokens de salida de Argon y una cuarta parte de los de Opus 5.5 para completar el mismo índice.
Contexto y salida influyen en la integración
La versión anterior describía el contexto de Argon como no publicado y la salida como un millón de tokens en una respuesta. Las guías actuales precisan los límites[2][3].
| Propiedad de Gemini 4 Argon | Comportamiento documentado actual |
|---|---|
| Acceso para desarrolladores | Gemini API y Google AI Studio |
| ID | gemini-4-argon |
| Contexto compartido | 1,048,576 tokens entre entrada, razonamiento y salida |
| Solicitud JSON nativa | Hasta 32,768 tokens generados |
| Solicitud nativa con streaming | Hasta 65,536 tokens generados |
| Generación más larga | Continuación entre solicitudes dentro del espacio restante |
| Niveles nativos | low, medium (predeterminado), high; no se puede desactivar del todo |
Fuentes: guías actuales de migración y razonamiento de Google[2][3].
Long Decode da margen a tareas grandes, pero no garantiza un informe completo en una sola respuesta HTTP. reAPI no continúa automáticamente en el servidor. El cliente debe enviar continuaciones, registrar cada petición y conservar los datos para reanudar.
La comparación inicial empleaba especificaciones de Astra y Opus tomadas de sus documentos. Esos límites históricos no deben mezclarse con Long Decode de Argon como si todos describieran una solicitud única. Consulta las páginas actuales de GPT-6 Astra y Claude Opus 5.5 para requisitos de salida y precios.
Gemini 4 Argon vs GPT-6 Astra
Argon gana la mayoría de filas de conocimiento y contexto largo. Las diferencias son amplias en Harvey's (19.6% frente a 5.4%) y Vals Finance Agent v2 (65.4% frente a 53.5%)[1]. Antes de hacer una afirmación sobre costes, combina esa ventaja con el uso y las tarifas de tu evaluación.
Conviene probar Astra pronto si tu trabajo se parece a los benchmarks de ordenador y software que lidera: OSWorld-2.0 (72.6% frente a 69.2%), FrontierSWE v2 (65.5% frente a 55.0%) y Terminal-Bench Science (68.1% frente a 57.6%)[1]. Las dos últimas brechas de 10.5 puntos son las mayores pérdidas de Argon en su propia tabla. Prueba tareas similares antes de cambiar. Astra también supera ligeramente a Argon en Terminal-bench 4.0, 58.2% frente a 57.4%.
Gemini 4 Argon vs Claude Opus 5.5
En programación, este emparejamiento está más igualado. Argon gana DeepSWE v1.1 (77.9% frente a 74.2%) y Vibe Code Bench (91.9% frente a 90.3%). Opus gana Terminal-bench 4.0 por 9 puntos (66.4% frente a 57.4%) y PostTrainBench por 4 (49.3% frente a 45.3%)[1]. Si tus agentes trabajan sobre todo en shell, Opus sigue siendo un candidato sólido.
Fuera de programación, Argon saca 15.8 puntos en el benchmark legal, 17.4 en GraphWalks 256K–1M y 15.7 en LABBench 2[1]. Para producción, usa el mismo material y criterios en ambos. La ventaja en benchmarks no determina cuántos tokens necesitarán para terminar tu tarea.
Qué modelo probar para cada trabajo
- Derecho, finanzas, documentos largos y vídeo: incluye Argon por sus mayores ventajas históricas. Comprueba exactitud de fuentes y exhaustividad con tus materiales.
- Migraciones o informes largos: evalúa Long Decode con un cliente que gestione continuación. Reserva espacio para pensamiento y respuesta; el contexto no es una cuota independiente de salida.
- Agentes centrados en terminal: prueba Opus 5.5 junto a Argon. Su ventaja en Terminal-bench debe contrastarse con tus herramientas y tareas.
- Ordenador y software difícil: incluye Astra, que lidera OSWorld-2.0 y FrontierSWE v2 en esta tabla fechada.
Haz reproducible la comparación: mismos prompts y materiales, nivel de razonamiento y presupuesto registrados. Distingue una respuesta incompleta de una terminada pero incorrecta. Con herramientas, comprueba el ciclo completo, no solo la emisión de una llamada.
La página de Argon de reAPI enlaza precios y referencia de solicitudes. Ya no se trata de esperar a que Google publique una API, sino de encontrar el modelo que termine tu tarea con condiciones asumibles.
Preguntas frecuentes
¿Argon es mejor que GPT-6 Astra?
En 14 de las 19 filas de Google tiene más puntuación, con un empate. Astra gana FrontierSWE v2, Terminal-Bench Science, OSWorld-2.0 y, por poco, Terminal-bench 4.0[1].
¿Es mejor que Claude Opus 5.5?
En 14 de las 18 filas comparables. Opus gana Terminal-bench 4.0, PostTrainBench, FrontierSWE v2 y Terminal-Bench Science[1].
¿Cómo se compara con Claude Fable 5.1?
Argon supera a Fable en 15 de 17 filas con ambas cifras. Fable gana ligeramente FrontierSWE v2 (56.3% frente a 55.0%) y Terminal-bench 4.0 (57.9% frente a 57.4%)[1].
¿Cuál es el mejor resultado de Argon?
GraphWalks hasta 128K con 99.7%. Destacan las brechas de Harvey's, 19.6% frente a 5.4% de Astra y 3.8% de Opus, y GraphWalks 256K–1M con 84.2%[1].
¿Son benchmarks independientes?
No del todo. Proceden de Google; la mayoría de resultados rivales son autodeclarados y Google ejecutó algunos tests de Argon[4]. Artificial Analysis evalúa los tres en un mismo índice: el 4 de noviembre de 2026 asignó 59 a Opus 5.5, 57 a Astra y 50 a Argon[5].
¿Cuál de los tres es más barato?
Consulta tarifas actuales y compara el coste de un resultado aceptable. Entrada, caché, pensamiento y continuación cambian la factura. La guía de precios evita depender de una tabla antigua.
Elegir entre Argon, Astra y Opus 5.5
La tabla de septiembre justifica evaluar Gemini 4 Argon en conocimiento y contexto largo, y conservar Opus y Astra para terminal y ordenador. Son hipótesis útiles de una comparación histórica publicada por un fabricante.
Decide con tareas que puedas puntuar: si el cambio pasa los tests, el informe respalda sus afirmaciones o el agente completa la acción. Registra también presupuesto y continuación. Así conviertes el lanzamiento en una evaluación útil de Gemini 4 Argon.
Referencias
-
Google. Gemini 4 Argon: our next era of frontier intelligence (including benchmark table). Consultado en octubre de 2026 en blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
-
Google. What's new in Gemini 4 Argon. Consultado el 14 de octubre de 2026 en ai.google.dev/gemini-api/docs/generate-content/latest-model
-
Google. Gemini thinking. Consultado el 14 de octubre de 2026 en ai.google.dev/gemini-api/docs/generate-content/thinking
-
Google DeepMind. Gemini 4 Argon model evaluation: approach, methodology and results. Consultado en octubre de 2026 en deepmind.google/models/evals-methodology/gemini-4-argon
-
Artificial Analysis. Gemini 4 Argon (High), GPT-6 Astra (Max) and Claude Opus 5.5 (Max) model pages. Consultado el 4 de noviembre de 2026 en artificialanalysis.ai/models/gemini-4-argon, gpt-6-astra y claude-opus-5-5
Autor

Categorías
Más publicaciones
Gemini 3.6 Flash vs 3.1 Pro
Gemini 3.6 Flash vs 3.1 Pro: precios actuales de API, umbral de 200K tokens, benchmarks de programación, contexto y límites de integración con reAPI.
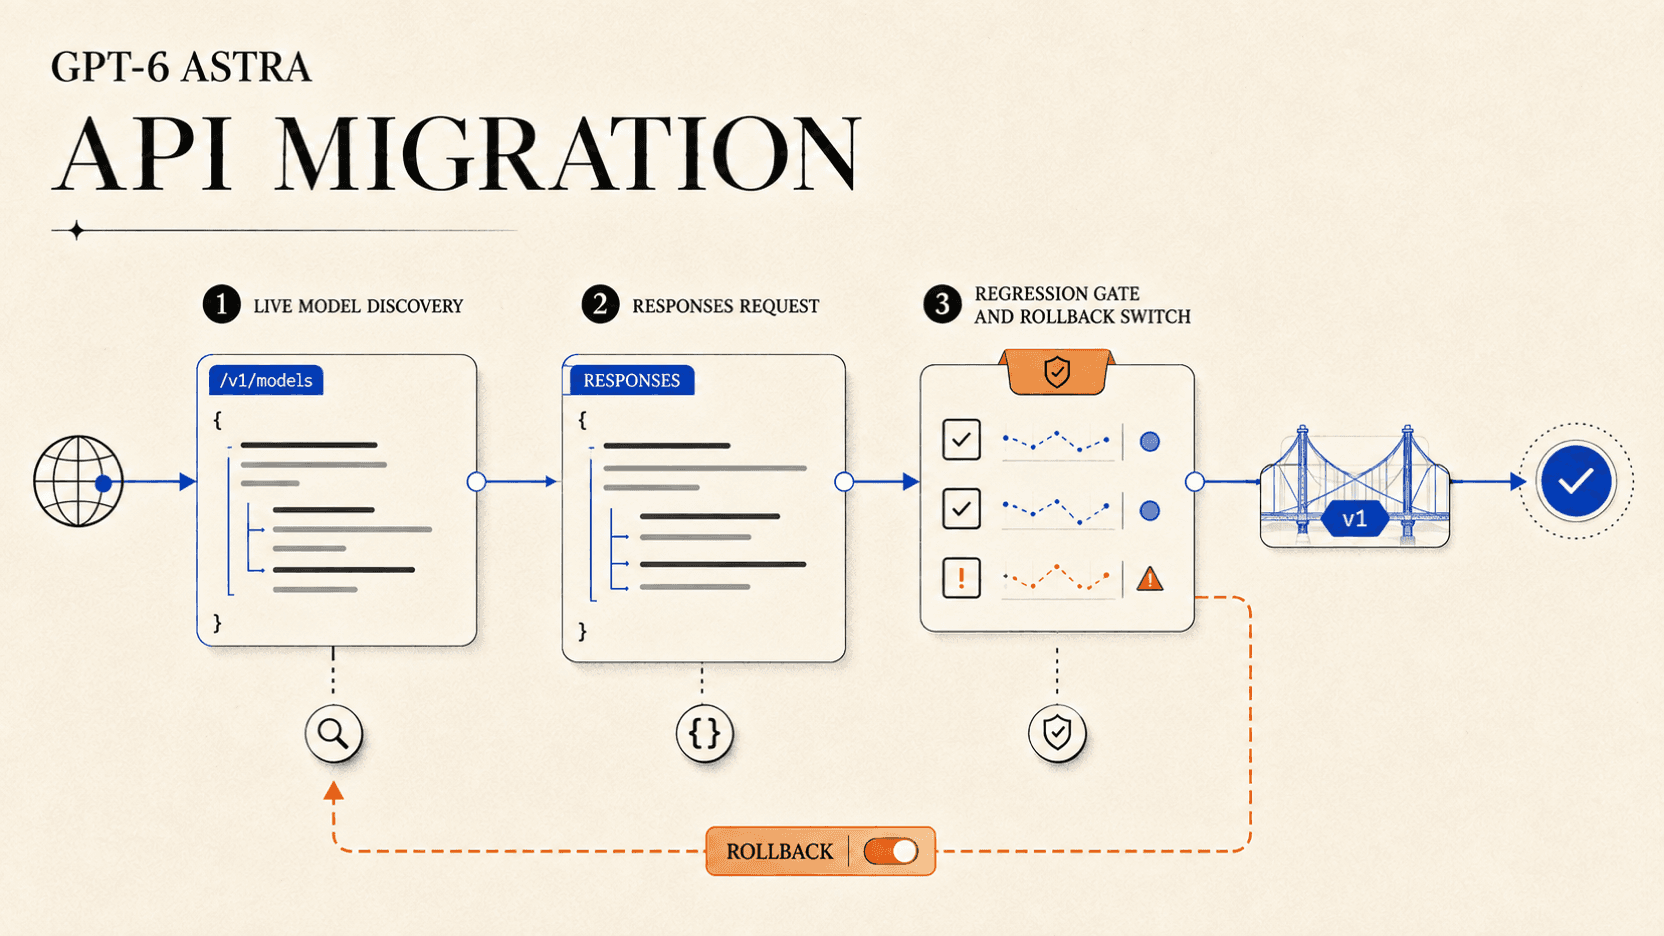
Migración a GPT-6 Astra: Responses, tools y rollback
Migración a GPT-6 Astra: descubrimiento de modelos, API de Responses, controles de razonamiento, validación de herramientas y plan de reversión.
Seedance 2.5 vs Veo 3.1: duración, audio y costo
Compara Seedance 2.5 y Veo 3.1: tomas de 30 segundos, generación de 8 s, referencias, 4K, audio nativo y distintas unidades de facturación de la API.