DeepSeek V4 1M 上下文怎么用?输入、输出、max_tokens、计费与并发
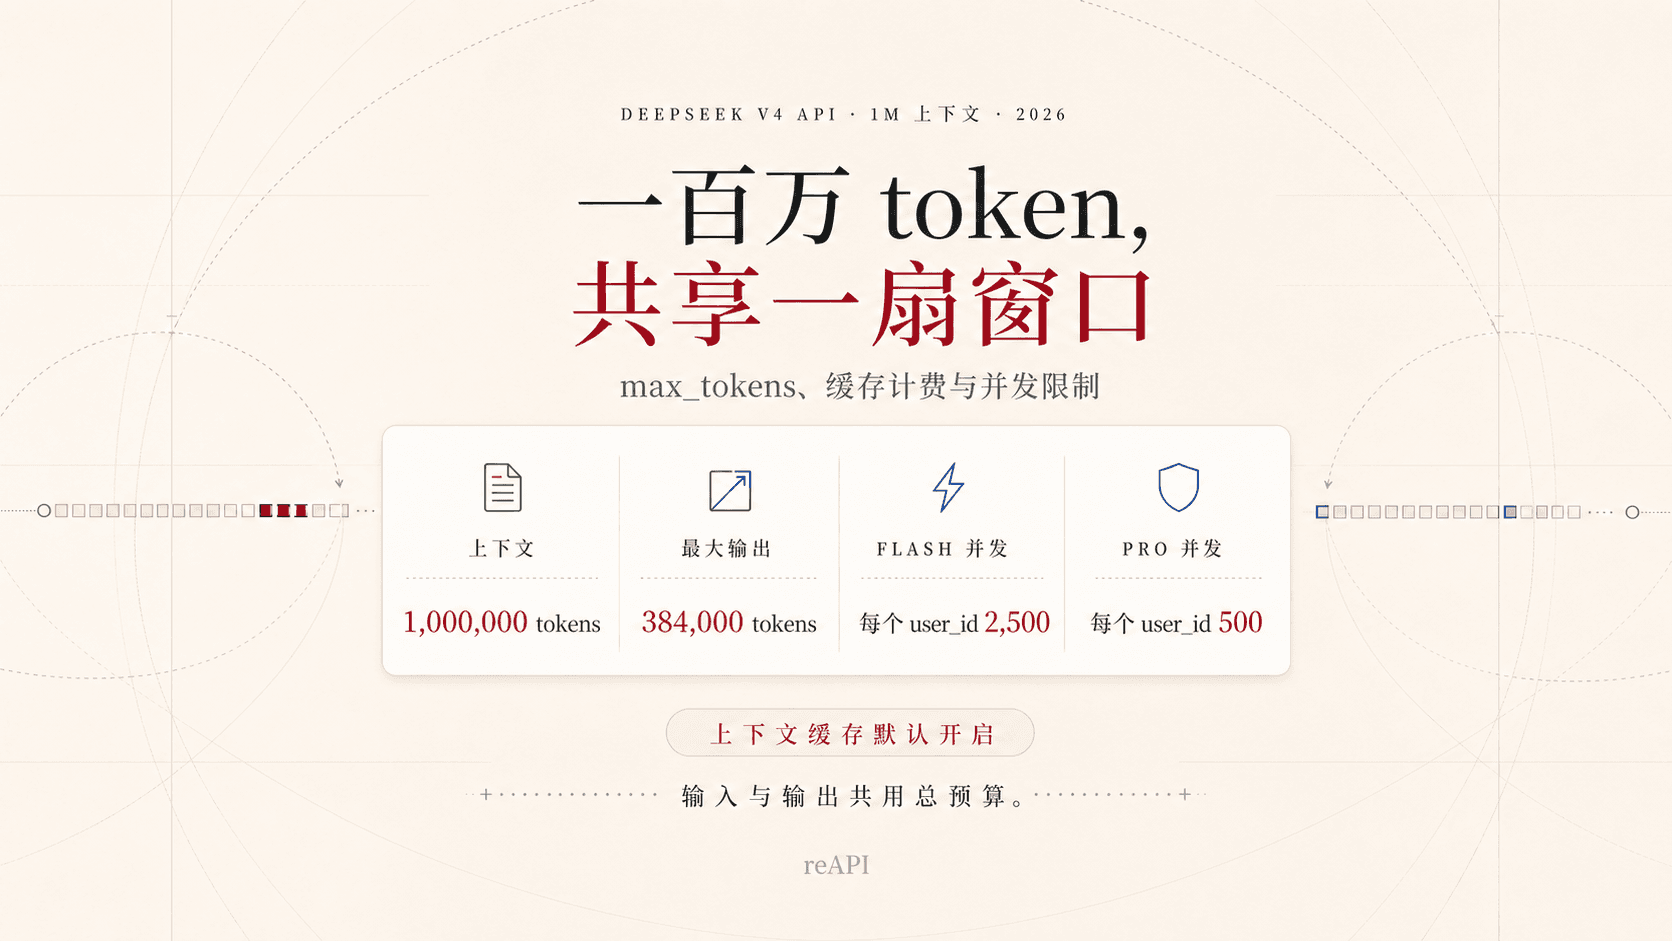
DeepSeek V4 的 1M 上下文是输入与输出共享的总预算,最大输出为 384K。本文讲清 max_tokens、缓存计费、Flash/Pro 并发与 API 配置。
DeepSeek API 价格取决于模型、缓存命中情况以及实际计费的平台。 2026 年 10 月 23 日核实,DeepSeek Direct 的非高峰未缓存输入/输出价格按每百万 token 计,为 Flash $0.15/$0.60、Pro $0.66/$1.98;高峰费率是这些数字的两倍。缓存输入另有较低费率。reAPI 公布的是下文所列的独立网关价格,因此 Direct 报价不等于 reAPI 报价[8][9]。
DeepSeek V4 的 1M 上下文不是“可以输入 1M,再额外输出 384K”。输入 token 与生成 token 共享同一个 1M 上下文预算;384K 是单次响应的最大输出上限。 max_tokens 只是你为本次响应设置的输出天花板,实际可生成长度还会受剩余上下文、停止条件和模型行为限制[1][2]。
这是理解 DeepSeek V4 长上下文 API 的关键。下面把 Bing 用户集中搜索的几个问题一次讲清:1M 到底算输入还是输入加输出、max_tokens 怎么设、超长请求如何计费,以及 Flash 和 Pro 的并发限制有什么区别。
先看结论
| 问题 | 官方规格 |
|---|---|
| 模型 ID | deepseek-v4-flash、deepseek-v4-pro |
| 上下文窗口 | 1M token,输入与输出共享 |
| 最大输出 | 384K token |
max_tokens | 本次 completion 的输出上限,不能突破剩余上下文或模型最大输出 |
| 默认模式 | 思考模式开启,普通请求默认 reasoning_effort: high |
| 缓存 | 上下文硬盘缓存默认开启,按缓存命中与未命中分别计费 |
| DeepSeek 直连并发 | Flash 2500,Pro 500,按账号而不是 API Key 计算 |
| 接口 | OpenAI Chat Completions 与 Anthropic 格式 |
DeepSeek 在 2026 年 4 月 24 日发布 V4 预览版,提供 Flash 和 Pro 两个模型,并把 1M 长上下文作为官方服务规格[3]。官方价格页同时列出两者的 384K 最大输出、JSON Output、Tool Calls、前缀续写和 FIM 补全能力[1]。
1M 上下文是输入还是输入加输出?
是输入加输出的总长度。DeepSeek Chat Completions API 文档写明,输入 token 与生成 token 的总长度受模型上下文长度限制[2]。
可以把它理解成一个共享预算:
输入 token + 实际生成 token <= 1M 上下文窗口
实际生成 token <= max_tokens
实际生成 token <= 384K 模型输出上限
因此:
- 输入接近 1M 时,留给回答的空间会很小。
- 想让模型最多输出 100K,就必须在请求中为这部分输出预留上下文。
- 把
max_tokens设成 384K,并不保证能得到 384K;如果输入已经占掉大部分窗口,响应仍会受剩余空间限制。 - 384K 是“最大输出”,不是默认输出,也不是每次请求都应该追求的目标。
工程上不要把输入硬塞到窗口边缘。还要给系统消息、工具 schema、历史消息和模型生成留出余量。对于代码库分析,先估算 token,再按任务拆分;1M 窗口减少了分块需求,但没有取消检索、去重和上下文整理的价值。
max_tokens 应该怎么设?
max_tokens 限制本次 completion 最多生成多少 token。DeepSeek 的 API 参考还说明:当 finish_reason 为 length 时,可能是达到了 max_tokens,也可能是对话碰到了上下文限制[2]。
一个实用的设置方法:
| 任务 | 建议起点 | 原因 |
|---|---|---|
| 分类、抽取、短问答 | 1K–4K | 输出结构短,没必要预留巨大预算 |
| 代码评审、文档总结 | 4K–16K | 足够容纳分段分析与建议 |
| 长报告、多文件改造方案 | 16K–64K | 需要更长的结构化输出 |
| 超长生成 | 按实测逐步提高 | 先确认成本、延迟、截断与下游处理能力 |
这不是官方硬性推荐,而是工程起点。正式上线前应记录 finish_reason、usage.completion_tokens 与业务侧的有效输出率,再调整上限。
下面的请求把输出上限设为 16K,并显式开启思考模式:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_REAPI_KEY",
    base_url="https://reapi.ai/api/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {
            "role": "user",
            "content": "分析这份代码库清单,给出按风险排序的迁移计划。",
        }
    ],
    max_tokens=16_384,
    reasoning_effort="high",
    extra_body={
        "thinking": {"type": "enabled"},
        "group": "default",
    },
)
这个 Chat Completions 示例使用统一工作区的 reAPI key 和余额。DeepSeek Direct 有自己的账户、key 和 https://api.deepseek.com base;它支持 Anthropic 和 Responses,并不代表 reAPI 也提供这两种协议。reAPI 请求字段见 DeepSeek V4 API 文档,playground 和网关价格见 DeepSeek V4 模型页。[8][10]
思考 token 会占用输出吗?
DeepSeek 的思考模式默认开启。思维内容通过 reasoning_content 返回,API 的 usage 还会在 completion_tokens_details.reasoning_tokens 中单独列出推理 token[4][2]。
这意味着做容量规划时,不能只看最终 content 的可见长度。复杂推理会消耗 completion 预算。思考模式下,temperature、top_p、presence_penalty 和 frequency_penalty 即使传入也不会生效[4]。
简单抽取、格式转换或低延迟请求可以测试非思考模式:
{
  "model": "deepseek-v4-flash",
  "thinking": {"type": "disabled"},
  "messages": [
    {"role": "user", "content": "把下面三行日志转成 JSON。"}
  ],
  "max_tokens": 2048
}
不要为了省 token 一律关闭思考。正确做法是把任务分层:确定性强的轻任务走 Flash 非思考,需要规划、编码或多步工具调用的任务再开启思考并考虑 Pro。
工具调用时要保留以前的 reasoning_content 吗?
DeepSeek 当前规则取决于请求是否包含 tools:带工具时,历史 assistant 的 reasoning_content 应随消息回传,并计入上下文;不带工具时可以省略,即使传入也会被忽略。工具循环不能统一套用“删除所有历史思考”的处理[4]。
deepseek api pricing
价格核实日期:2026 年 10 月 23 日。 DeepSeek Direct 将缓存输入、未缓存输入和输出分别按高峰与非高峰计费。高峰为周一至周五 UTC 01:00–04:00 和 06:00–10:00,中国公共节假日除外;其他时间均为非高峰。非高峰费率为高峰的一半。推荐的 Flash ID 是 deepseek-flash,由 DeepSeek-V4.1-Flash-1017 提供服务;旧 deepseek-v4-flash 请求也由该版本处理并按 Flash 费率计费。deepseek-v4-pro 列出的版本为 DeepSeek-V4-Pro-0813。这些映射和时段属于 DeepSeek Direct,不会自动适用于 reAPI[8]。
当前 DeepSeek Direct 价格,单位为美元/100 万 token:
| 模型 ID | 时段 | 缓存命中 | 缓存未命中 | 输出 |
|---|---|---|---|---|
deepseek-flash | 非高峰 | $0.003 | $0.15 | $0.60 |
deepseek-flash | 高峰 | $0.006 | $0.30 | $1.20 |
deepseek-v4-pro | 非高峰 | $0.022 | $0.66 | $1.98 |
deepseek-v4-pro | 高峰 | $0.044 | $1.32 | $3.96 |
两个 reAPI 模型页展示了三个分别命名的请求选项。下列 reAPI 价格读取自 2026 年 10 月 23 日页面实际渲染的 Pricing 区域,单位同样为美元/100 万 token。页面没有将其标为 DeepSeek Direct 的高峰/非高峰费率[9]。
| reAPI 请求模型 ID | 缓存命中/读取 | 未缓存输入 | 输出 |
|---|---|---|---|
deepseek-v4-flash | $0.028 | $0.100 | $0.200 |
deepseek-v4-pro | 未列出 | $0.400 | $0.900 |
deepseek-v4.1-flash | $0.015 | $0.400 | $1.300 |
前两个 ID 请使用 V4 页面,deepseek-v4.1-flash 请使用 V4.1 Flash 页面;三者都通过 reAPI 的统一 Chat Completions 路由调用。Direct 的别名规则不能证明 reAPI 中分别命名的选项使用相同权重。Pro 未列缓存费率不代表价格为零,也不能借用 Flash 的费率[9][10]。
假设某请求有 100,000 个输入 token,其中 80,000 个命中缓存、20,000 个未命中,另有 20,000 个输出 token,Direct Flash 非高峰费用为 0.08 × $0.003 + 0.02 × $0.15 + 0.02 × $0.60 = $0.01524,高峰为 $0.03048。将相同 token 数套入 reAPI 的 V4.1 Flash 类别,得到 0.08 × $0.015 + 0.02 × $0.400 + 0.02 × $1.300 = $0.0352。这里比较的是公开 token 费用,不是实测模型等同性、保证的缓存命中或实际观察到的账单。缓存 token 不再按未缓存输入费率重复计费[8][9]。
下方保留的 2026 年 7 月 30 日表格是 Direct 价格的历史快照。新的估算请使用上方按平台区分的当前价格表。
DeepSeek 直连 API 按三类 token 分开计费:
- 缓存命中的输入 token;
- 缓存未命中的输入 token;
- 输出 token。
官方人民币价格如下,单位均为每 100 万 token,读取时间为 2026 年 7 月 30 日[1]:
| 模型 | 输入:缓存命中 | 输入:缓存未命中 | 输出 |
|---|---|---|---|
| DeepSeek V4 Flash | ¥0.02 | ¥1 | ¥2 |
| DeepSeek V4 Pro | ¥0.025 | ¥3 | ¥6 |
计费公式是:
费用 =
  缓存命中输入 / 1,000,000 × 命中单价
  + 缓存未命中输入 / 1,000,000 × 未命中单价
  + 输出 / 1,000,000 × 输出单价
例如一次 Flash 请求包含 80 万缓存未命中输入、5 万缓存命中输入和 2 万输出,按官方直连价格估算:
0.8 × ¥1 + 0.05 × ¥0.02 + 0.02 × ¥2 = ¥0.841这是按公开单价做的数学示例,不含其他平台的路由或加价。通过 reAPI 调用时,应以 DeepSeek V4 模型页 的实时美元价格卡为准,不要把 DeepSeek 直连人民币价格直接套到聚合网关账单。
1M 长上下文怎样提高缓存命中?
DeepSeek 的上下文硬盘缓存对所有用户默认开启,不需要额外开关。后续请求只有完整复用已经落盘的前缀单元时才会命中;仅仅“内容相似”并不够[5]。
适合缓存的请求结构:
稳定的 system prompt
+ 固定工具 schema
+ 不变的长文档或代码库
+ 每次变化的问题
把稳定内容放在前面,把每轮变化的指令放在后面。响应的 usage 会给出:
prompt_cache_hit_tokensprompt_cache_miss_tokenscompletion_tokenstotal_tokens
用这些字段计算真实命中率。不要通过猜测“应该缓存了”来估算成本。
Flash 和 Pro 的并发限制
DeepSeek 官方直连 API 按账号限制并发:
| 模型 | 每账号并发上限 |
|---|---|
deepseek-v4-flash | 2500 |
deepseek-v4-pro | 500 |
一个请求从发出到模型响应结束都占一个并发位。限制按账号计算,与创建了多少个 API Key 无关;超过限制会返回 HTTP 429[6]。
user_id 可以帮助做内容安全、KV Cache 和调度隔离,但对普通账号,所有 user_id 仍合并计算总并发[6]。所以“多建几个 key”或“多传几个 user_id”都不是扩容方案。
还要区分供应商额度与网关额度。2500/500 是 DeepSeek 官方直连账号的公开限制;通过 reAPI 时,实际并发、排队和上游渠道策略以 reAPI 控制台、文档和响应为准。
1M 请求上线前的检查清单
- 先估算输入 token,不要用字符数代替 token 数。
- 为输出、工具 schema 和后续轮次预留空间。
- 根据任务设置
max_tokens,不要无条件填 384K。 - 记录
finish_reason,区分自然停止、max_tokens截断和上下文耗尽。 - 固定可复用前缀,并监控缓存命中与未命中 token。
- 分开统计 reasoning token 和最终回答的有效长度。
- 对 429 做指数退避和抖动,不要立即并发重试。
- 在高并发轻任务中优先测试 Flash,把 Pro 留给复杂推理。
- 使用当前模型 ID;DeepSeek 公告中的旧
deepseek-chat与deepseek-reasoner弃用日期是 2026 年 7 月 24 日[3]。
FAQ
DeepSeek V4 Flash 支持 1M 上下文吗?
支持。Flash 和 Pro 的官方上下文长度都是 1M,最大输出都是 384K[1]。
1M context 是纯输入长度吗?
不是。输入 token 和生成 token 的总长度受 1M 上下文限制[2]。需要输出多少,就应为输出预留多少窗口空间。
max_tokens 最大可以设多少?
模型规格的最大输出是 384K,但本次实际输出还受剩余上下文限制。设置 384K 不代表一定生成 384K。
max_tokens 包含思考 token 吗?
容量与计费时应把推理 token 视为 completion 使用量。DeepSeek 在 completion_tokens_details.reasoning_tokens 中单独报告它们[2]。
超过 1M 会发生什么?
请求的输入与输出总长度不能超过模型上下文。应用应在提交前控制输入并预留输出;如果生成碰到限制,finish_reason 可能返回 length[2]。
DeepSeek V4 的并发是按 API Key 计算吗?
不是。DeepSeek 官方说明并发按账号计算,与 API Key 无关。Flash 为 2500,Pro 为 500;超限返回 429[6]。
缓存需要手动开启吗?
不需要。DeepSeek 上下文硬盘缓存默认开启。想提高命中率,应保持长内容前缀稳定,并检查响应里的命中 token 字段[5]。
DeepSeek V4 在 reAPI 上怎么收费?
reAPI 以美元按 token 用量计费,Flash 与 Pro、缓存命中与未命中、输出分别定价。当前数值请看 DeepSeek V4 中文模型页 的实时价格卡。
参考与下一步
- DeepSeek V4 中文模型页 — Playground、能力和实时价格。
- DeepSeek V4 API 文档 — reAPI 请求与响应字段。
- reAPI 模型目录 — 用同一个接口比较其他聊天模型。
References
-
DeepSeek. 模型 & 价格 — V4 上下文、最大输出、功能与人民币价格。 Retrieved July 30, 2026 from api-docs.deepseek.com/zh-cn/quick_start/pricing
-
DeepSeek. 对话补全 API — max_tokens、上下文约束、finish_reason 与 usage。 Retrieved July 30, 2026 from api-docs.deepseek.com/zh-cn/api/create-chat-completion
-
DeepSeek. DeepSeek-V4 预览版:迈入百万上下文普惠时代。 April 24, 2026. api-docs.deepseek.com/zh-cn/news/news260424
-
DeepSeek. 思考模式 — 开关、reasoning_effort 与 reasoning_content。 Retrieved September 8, 2026 from api-docs.deepseek.com/zh-cn/guides/thinking_mode
-
DeepSeek. 上下文硬盘缓存 — 命中规则与 usage 字段。 Retrieved July 30, 2026 from api-docs.deepseek.com/zh-cn/guides/kv_cache
-
DeepSeek. 限速与隔离 — Flash/Pro 账号级并发与 user_id。 Retrieved July 30, 2026 from api-docs.deepseek.com/zh-cn/quick_start/rate_limit
-
DeepSeek. Models & Pricing. 重新核查于 2026 年 10 月 22 日. api-docs.deepseek.com/quick_start/pricing
-
DeepSeek. 模型与价格——当前模型版本、高峰/非高峰费率及官方 API 接口。 2026 年 10 月 23 日核实。api-docs.deepseek.com/quick_start/pricing
-
reAPI. 页面实际渲染的 Pricing 区域。 2026 年 10 月 23 日核实。DeepSeek V4、DeepSeek V4.1 Flash。
-
reAPI. 请求模型 ID、Chat Completions 端点及鉴权。 2026 年 10 月 23 日核实。DeepSeek V4 文档、DeepSeek V4.1 Flash 文档。
作者

分类
max_tokens 应该怎么设?思考 token 会占用输出吗?工具调用时要保留以前的 reasoning_content 吗?deepseek api pricing1M 长上下文怎样提高缓存命中?Flash 和 Pro 的并发限制1M 请求上线前的检查清单FAQDeepSeek V4 Flash 支持 1M 上下文吗?1M context 是纯输入长度吗?max_tokens 最大可以设多少?max_tokens 包含思考 token 吗?超过 1M 会发生什么?DeepSeek V4 的并发是按 API Key 计算吗?缓存需要手动开启吗?DeepSeek V4 在 reAPI 上怎么收费?参考与下一步References更多文章
AI 图像 API 内容过滤:请求被拒的原因
图像 API 的内容过滤分为多个层级。同一个提示词在某个平台可能通过审核,在另一个平台可能被拒绝,但某些安全底线无论如何配置都不会改变。
Seedance 2.5 状态:API 接入、价格与当前限制
Seedance 2.5 已上线:reAPI 模型 ID、480p/720p 价格、30 秒输出、参考素材上限与源视频计费规则。
Midjourney V8.2 停用的九个功能与参数解析
Midjourney V8.2 停用了九个特性:质量、涡轮模式、多提示词等。哪些还能用,哪些无声后退到 V7,HD 真实成本是多少。