· reAPI Team
Gemini 4 Argon vs Opus 5.5: el test viral cuestionado
Gemini 4 Argon vs Opus 5.5: el test de ositos generó réplicas. Revisamos la demo, reproducciones reportadas y respuestas del autor para valorar las pruebas.
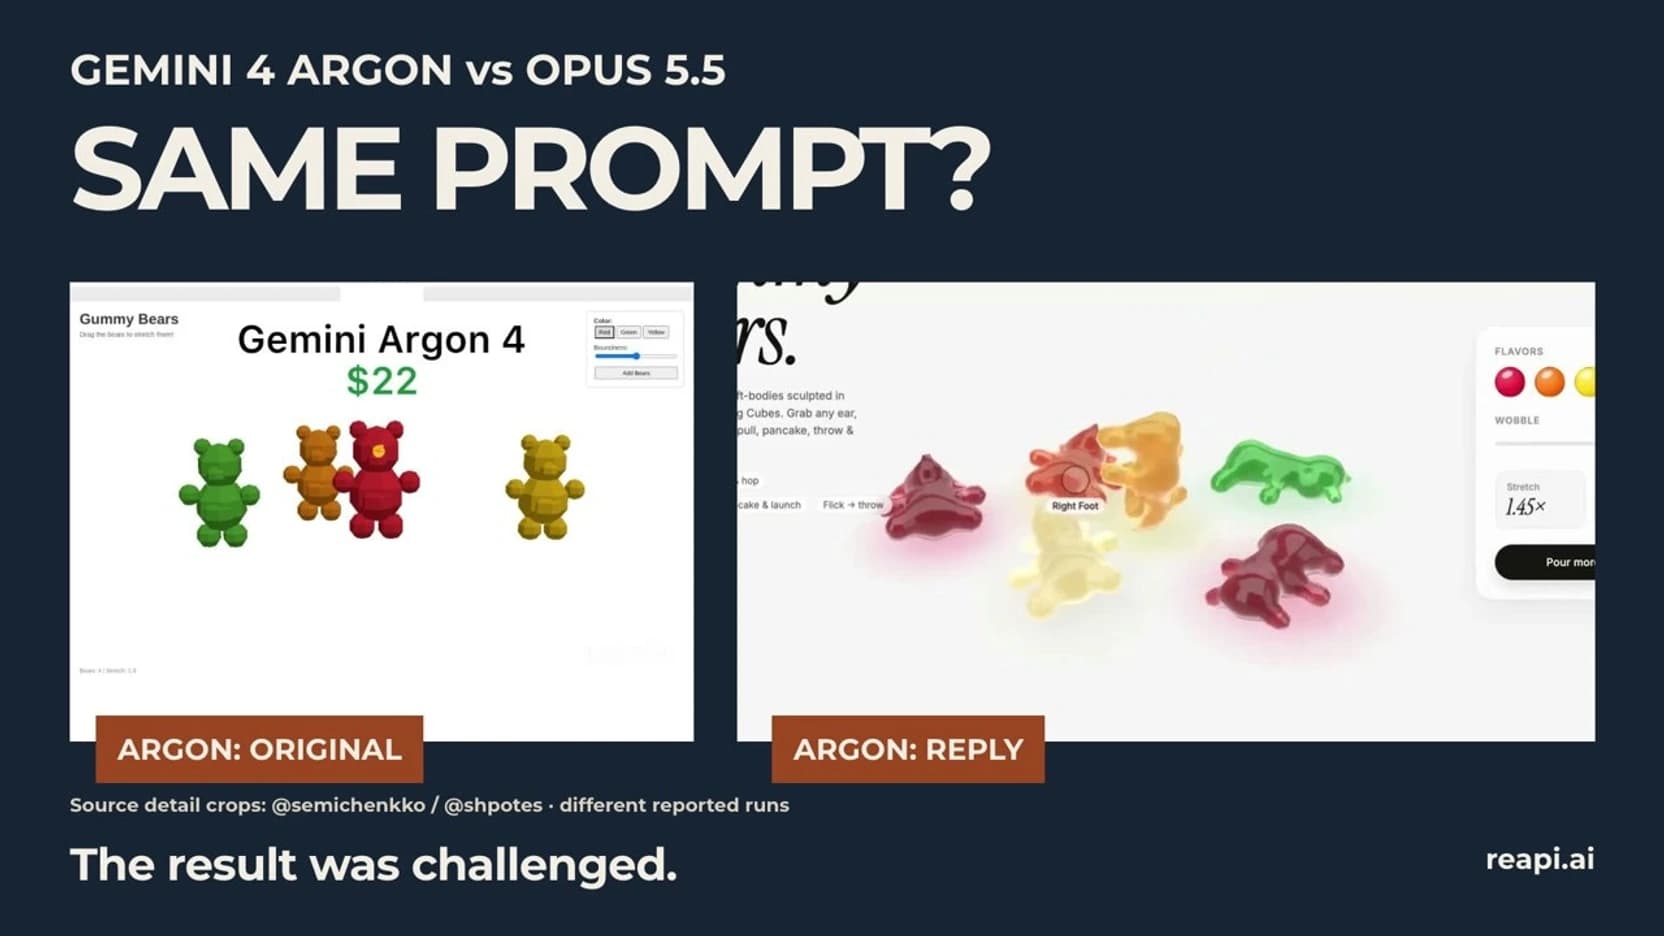
Una simulación de ositos de goma convirtió Gemini 4 Argon vs Opus 5.5 en una discusión sobre cuánto puede demostrar una demo de programación. En una comparación publicada por Semichenko, el resultado identificado como Claude Opus 5.5 se estiraba y comprimía de forma más convincente que el identificado como Gemini 4 Argon. El creador afirmó que ambos recibieron el mismo prompt[1]. Después, otro desarrollador publicó un resultado de Argon visiblemente distinto y también indicó que había usado ese prompt[2].
Lo que ocurrió después importa tanto como el clip original: Semichenko reconoció que la ejecución de Gemini podía haber fallado y dijo que necesitaba hacer más pruebas[3]. Las publicaciones disponibles documentan un desacuerdo sobre resultados concretos. No resuelven la clasificación general de los modelos. Aquí repasamos las pruebas, la respuesta del autor y una forma práctica de evaluar la próxima comparación.
Resumen
- La publicación original de Semichenko presenta dos simulaciones interactivas de ositos de goma e indica que se usó un prompt idéntico. El marcado contraste visual corresponde a esas ejecuciones reportadas[1].
- @shpotes afirma haber obtenido un resultado diferente con Argon en Antigravity. Ese ejemplo cuestiona la inferencia de que el primer clip establece los límites de Argon[2].
- El autor original admitió expresamente la posibilidad de que la ejecución de Gemini hubiera fallado y señaló que hacían falta más pruebas[3].
- En otra respuesta, el autor propuso seleccionar el mejor de tres intentos de cada modelo la próxima vez. Era una propuesta metodológica, no una nueva prueba ya realizada[4].
- Nuestro vídeo complementario revisa estos ejemplos de terceros. reAPI no realizó un nuevo benchmark controlado ni verificó de forma independiente las configuraciones completas y los costes declarados[5].
Mira la comparación y las respuestas
Nuestro vídeo de 2 minutos y 18 segundos recorre la demostración original, la reproducción reportada y las respuestas del autor. Complementa este análisis e incluye los créditos de las fuentes en la descripción[5].
Ve directamente a la demostración original en 0:19, la reproducción reportada en 0:46 o la respuesta del autor en 1:11.
Las imágenes corresponden a código que genera una simulación interactiva. Debe evaluarse como una tarea de programación. Grabar la animación resultante no la convierte en una comparación de modelos de texto a vídeo. La portada de arriba usa la miniatura de nuestro vídeo; consulta el vídeo y las publicaciones enlazadas para examinar los resultados reportados.
Qué mostró la demo de Gemini 4 Argon vs Opus 5.5
La publicación original coloca Opus encima de Argon y describe una secuencia de interacciones: tirar, comprimir, lanzar y añadir más ositos. Su crítica combina la deformación de los objetos, la forma en que interactúan y el aspecto del material[1].
Son aspectos que conviene examinar por separado. Para esta tarea, evaluaríamos si un osito cambia de forma al arrastrarlo, si la recupera al soltarlo, si una escena con muchos objetos sigue siendo utilizable y si la superficie se parece al material solicitado. Son criterios de evaluación propuestos, no mediciones que hayamos realizado en las aplicaciones originales.
Separar los criterios evita que una superficie atractiva decida toda la comparación de programación. Un espectador puede preferir la iluminación y aun así necesitar comprobar las interacciones. A la inversa, un objeto menos pulido visualmente podría cumplir un requisito funcional. Decide qué requisitos importan antes de elegir el clip ganador.
También hay una diferencia entre evaluar el resultado presentado y explicar por qué se produjo. Una grabación puede respaldar una observación limitada a lo que aparece en pantalla. Para establecer la causa harían falta las instrucciones, el proyecto generado, el historial de ejecución y los ajustes. No obtuvimos un registro completo y comparable de ambas ejecuciones originales, por lo que no podemos aislar el modelo como causa de la diferencia.
Cómo cambiaron el debate las reproducciones reportadas
@shpotes describió su resultado así, traducido: «El mismo prompt dio un resultado radicalmente distinto con Argon + Antigravity». La demostración adjunta muestra estiramiento y deformación en el resultado atribuido a Argon[2]. Ofrece un motivo concreto para cuestionar si el primer resultado representa lo que Argon puede producir en esta tarea.
Otra publicación de @Caxvalencia lleva la etiqueta «Argon - Medium» e incluye un ejemplo adicional de interacción[6]. Esa etiqueta refleja el ajuste declarado por el autor. No demuestra de forma independiente que las instrucciones, los archivos iniciales o la secuencia de llamadas a herramientas fueran idénticos.
| Registro público | Qué aporta | Qué no hemos verificado aquí |
|---|---|---|
| Comparación original de Semichenko | Un contraste visible entre dos resultados identificados y la afirmación de que se usó el mismo prompt | Los registros completos y comparables de ambas ejecuciones |
| Publicación posterior de @shpotes | Un resultado de Argon en Antigravity que, según su autor, utiliza el mismo prompt | La igualdad de toda la configuración respecto a la comparación original |
| Ejemplo de @Caxvalencia | Otro ejemplo de interacción identificado como Argon y marcado como Medium | Un protocolo de reproducción completamente equivalente |
| Respuestas de Semichenko | El reconocimiento de la incertidumbre y la propuesta de elegir el mejor de tres intentos | Los resultados de una comparación terminada que aplique esa propuesta |
Fuentes: las publicaciones originales y las respuestas[1][2][3][4][6].
La publicación original también incluye una Nota de la comunidad que dirige a los lectores hacia reproducciones[1]. Sigue esos enlaces y examina sus pruebas. La nota añade contexto, pero sus afirmaciones deben contrastarse con las fuentes originales.
Si se aceptan tal como se presentan, las publicaciones posteriores debilitan una afirmación general de que Argon no puede producir ositos deformables. No establecen con qué frecuencia tiene éxito cada modelo, cuánta intervención necesita ni cuál rendirá mejor en otra tarea de programación. Un contraejemplo sólido puede cuestionar una afirmación absoluta sin establecer una clasificación general.
La respuesta del autor forma parte de la historia
Semichenko escribió, traducido: «Mmm, quizá mi Gemini falló; necesito hacer más pruebas»[3]. En una respuesta anterior agradeció la prueba de otra persona y propuso usar el mejor de tres intentos de cada modelo en una comparación futura[4].
Esa respuesta acota el desacuerdo. No hace falta fingir que desapareció la diferencia visual original, y estas publicaciones no permiten atribuir una intención de engañar. El autor reconoció la incertidumbre sobre la ejecución. Los lectores deberían ver ese reconocimiento junto al clip que se les pide evaluar.
Elegir el mejor de tres intentos respondería a una pregunta concreta: ¿qué calidad puede alcanzar cada modelo en tres intentos con las reglas elegidas? Si solo se mostrara el intento ganador, seguiría sin resolverse la fiabilidad al primer intento. En una prueba futura publicaríamos todos los intentos e indicaríamos cuál se seleccionó, para que tanto el mejor resultado como los fallos quedaran disponibles para su revisión.
Una forma más útil de comparar los resultados de programación
Lo siguiente es una propuesta editorial de evaluación. No la hemos ejecutado ni reconstruye las sesiones privadas de los creadores. Su objetivo es facilitar la interpretación del próximo resultado.
Guarda el punto de partida completo. Conserva el prompt exacto, los archivos adjuntos, el proyecto inicial y las instrucciones adicionales. Si la prueba comienza en un directorio vacío, indícalo. Copiar un prompt en otro proyecto no demuestra por sí solo que los modelos recibieran un contexto equivalente.
Registra el entorno y los ajustes. Identifica el modelo, la aplicación o el agente de programación, las herramientas disponibles y los ajustes que realmente se utilizaron. Conserva el registro de la solicitud o de la sesión cuando sea posible. Anota como desconocido cualquier ajuste que no conozcas; no lo deduzcas de lo bueno que parezca el resultado. La mención de Antigravity en la publicación posterior aporta un detalle útil, pero no completa la información que falta sobre las otras sesiones.
Decide de antemano las reglas de los intentos. Define si la comparación mide primeros intentos, un número fijo de intentos o la finalización dentro de un presupuesto determinado. Aplica las mismas reglas de intervención. Si un resultado necesitó un prompt de corrección, inclúyelo y contabiliza el trabajo extra en vez de presentar la aplicación final como una primera respuesta sin modificaciones.
Realiza las mismas comprobaciones de interacción. Para esta tarea de ositos de goma, define una secuencia repetible: arrastrar una extremidad, soltarla, comprimir el cuerpo, mover un osito contra otro y añadir varios objetos. Registra si funciona cada interacción solicitada, dónde falla y si la aplicación sigue siendo utilizable. Es una lista de comprobación de aceptación propuesta, no una afirmación de que las simulaciones mostradas implementen materiales físicamente precisos.
Separa calidad y gasto hasta evaluar la tarea. El clip original incluye cifras de coste declaradas por su creador. No hemos verificado de forma independiente los registros de facturación ni todo el trabajo que hay detrás[5]. Para tu propia prueba, conserva el consumo y el coste de cada intento incluido y después compara el gasto con los mismos criterios de aceptación. Un intento fallido también forma parte del registro de evaluación.
Si quieres realizar una evaluación a través de reAPI, consulta la página del modelo Gemini 4 Argon y la página del modelo Claude Opus 5.5 para ver la información y los precios actuales. Son puntos de partida para preparar tu propia configuración; no reproducen las herramientas ni las sesiones de las publicaciones en redes sociales.
Para la cuestión distinta de los benchmarks publicados, consulta nuestra comparación de Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5. Trata una tabla de benchmarks de los proveedores correspondiente a una fecha concreta. Este artículo aborda la disputa específica sobre los ositos de goma.
Preguntas frecuentes
¿El test viral demostró que Opus 5.5 programa mejor?
Presenta un resultado favorable a Opus en esa comparación visual concreta. Las publicaciones que revisamos no aportan una evaluación controlada y repetida que establezca una ventaja general en programación[1][3].
¿La reproducción con Argon utilizó el mismo prompt?
@shpotes afirma expresamente que sí. Es una afirmación atribuida a esa fuente. No verificamos de forma independiente todo el contenido del prompt, el contexto, los ajustes y los pasos de ejecución frente a las sesiones originales[2].
¿La reproducción demuestra que gana Argon?
Estos ejemplos no permiten declarar un ganador general. La reproducción reportada cuestiona la inferencia extraída del primer resultado de Argon; no establece una tasa de éxito ni una ventaja en distintas tareas de programación[2].
¿El creador reconoció las críticas?
Sí. Semichenko dijo que la ejecución de Gemini podía haber fallado y que necesitaba más pruebas. También propuso elegir el mejor de tres intentos en una futura comparación[3][4].
¿Fue una prueba de generación de vídeo con IA?
Los ejemplos publicados corresponden a simulaciones interactivas creadas mediante programación. Nuestro vídeo comenta grabaciones de esos resultados. No compara modelos de generación de vídeo a partir de texto[5].
¿reAPI volvió a ejecutar el benchmark?
No. Este artículo y el vídeo enlazado analizan ejecuciones reportadas por terceros. No reprodujimos de forma independiente las configuraciones completas, no examinamos todos sus registros de facturación ni generamos una nueva puntuación de benchmark[5].
Qué pedir antes de elegir un ganador
Empieza por la demostración original y después lee la reproducción y la respuesta del autor. Si necesitas decidir qué modelo usar, pide la configuración completa y todos los intentos realizados bajo unas reglas de evaluación explícitas. Hasta disponer de ello, el test de ositos de goma Gemini 4 Argon vs Opus 5.5 sirve como caso concreto que investigar. Elige un modelo para tu trabajo después de comprobar el comportamiento que necesitas en condiciones que puedas repetir.
Referencias
-
Semichenko (@semichenkko). Comparación original de ositos de goma y Nota de la comunidad adjunta. Consultado el 19 de octubre de 2026 en x.com/semichenkko/status/2110131790136401989
-
@shpotes. Reproducción reportada con el mismo prompt en Argon + Antigravity. Consultado el 19 de octubre de 2026 en x.com/shpotes/status/2110222482632286672
-
Semichenko (@semichenkko). Respuesta que reconoce un posible fallo de la ejecución de Gemini y la necesidad de más pruebas. Consultado el 19 de octubre de 2026 en x.com/semichenkko/status/2110375383686135996
-
Semichenko (@semichenkko). Respuesta que propone elegir el mejor de tres intentos para una futura comparación. Consultado el 19 de octubre de 2026 en x.com/semichenkko/status/2110282000246472931
-
reAPI. Gemini 4 Argon vs Opus 5.5: The Viral Test That Got Challenged. Consultado el 19 de octubre de 2026 en youtu.be/QR9HChbtym0
-
@Caxvalencia. Ejemplo de interacción «Argon - Medium». Consultado el 19 de octubre de 2026 en x.com/Caxvalencia/status/2110170790444269766